- Cachecoherentie zorgt ervoor dat alle kopieën van dezelfde gegevens in verschillende caches en in het RAM-geheugen consistent blijven op systemen met meerdere kernen.
- De cachehiërarchie met een gedeeld laatste niveau vereenvoudigt de consistentiecontrole en vermindert directe toegang tot het hoofdgeheugen.
- Coherentieprotocollen maken gebruik van kopie-invalidatie- of update-strategieën, ondersteund door statussen en besturingsbits per cachelijn.
- De compiler en het besturingssysteem kunnen de hardwareconsistentie aanvullen door instructies in te voegen en het geheugen te configureren voor kritieke perioden.
Als je naar een diagram van een moderne multi-core processor kijkt, zie je altijd hetzelfde patroon: meerdere cores, elk met een eigen cache in de buurt, en een gedeelde cache op het laatste niveau die fungeert als gemeenschappelijk punt voordat het RAM-geheugen wordt bereikt. Deze opstelling is geen toeval of een gril van de ontwerpers, maar een direct antwoord op een cruciaal probleem in parallelle systemen: cachecoherentie.
Zonder een robuust consistentiemechanisme zou elke core met een andere en verouderde versie van dezelfde data in het geheugen kunnen werken . In een praktijktoepassing vertaalt dit zich in subtiele fouten, onvoorspelbare storingen en zelfs systeemcrashes. Daarom is inzicht in hoe deze consistentie wordt gewaarborgd – zowel op hardware- als softwareniveau – cruciaal voor het begrijpen van de prestaties en stabiliteit van moderne multi-core CPU's.
Wat is cachecoherentie: de terminalmetafoor?

Stel je voor dat meerdere mensen achter verschillende terminals zitten en allemaal hetzelfde document bewerken dat op een centrale server is opgeslagen . Elk scherm toont een kopie van het bestand en elke wijziging die één persoon aanbrengt, moet direct op de schermen van alle anderen zichtbaar zijn.
Om dit te laten werken, is een synchronisatiemechanisme nodig dat documentwijzigingen naar alle terminals doorstuurt, zodat iedereen altijd dezelfde versie ziet. Zolang dit systeem werkt, is alles in orde: wie de tekst wijzigt, weet dat iedereen de nieuwe versie vrijwel direct te zien krijgt.
Stel je nu voor dat het synchronisatiesysteem plotseling uitvalt. Iedereen blijft bewerken, ervan overtuigd dat ze aan het gedeelde document werken, maar in werkelijkheid heeft elke computer een eigen, losgekoppelde lokale kopie . Vanaf dat moment bereiken wijzigingen van de ene persoon de anderen niet meer, en begint het document oncontroleerbaar uit elkaar te lopen.
In de computerwereld is dit precies wat er zou gebeuren als de CPU geen betrouwbaar consistentieprotocol zou hebben: één core wijzigt gegevens in het geheugen, maar de andere cores blijven een oudere versie uit hun eigen caches lezen . Dit creëert een vruchtbare bodem voor ernstige logische fouten, beschadigde gegevens en ondebugbaar gedrag.
Cachecoherentie is daarom het geheel van mechanismen dat ervoor zorgt dat in een multicore-systeem alle kopieën van dezelfde data, verdeeld over de verschillende caches en het RAM-geheugen, een consistente toestand behouden . Zelfs als er meerdere kopieën bestaan, moet het systeem zich gedragen "alsof" er maar één kopie is.
Caches en geheugenhiërarchie in een multi-core CPU
CPU-caches zijn kleine, zeer snelle geheugens die kopieën bevatten van veelgebruikte delen van het RAM-geheugen . Wanneer de processor code uitvoert, probeert hij, in plaats van continu toegang te krijgen tot het (relatief trage) RAM-geheugen, te lezen uit en te schrijven naar de cache, waardoor de latentie drastisch wordt verminderd.
De truc is natuurlijk dat caches niet de "officiële versie" van de data opslaan, maar slechts een tijdelijke replica . Om de metafoor van de terminal te gebruiken: RAM zou het document op de server zijn, terwijl caches de lokale schermen zouden zijn die kopieën van bepaalde delen van het bestand weergeven.
Bij een multi-core CPU wordt het ontwerp complexer, omdat elke core doorgaans zijn eigen private Level 1 (L1) en zelfs Level 2 (L2) caches heeft . Daar bovenop komt nog een gedeelde Level 3 cache (bijvoorbeeld), die zich bevindt tussen de cores en de geheugencontroller die toegang tot het RAM-geheugen biedt.
Deze gedeelde cache is geïntroduceerd omdat het toestaan van directe en intensieve toegang tot het RAM-geheugen door alle cores zou leiden tot toegangsconflicten, concurrentie op de geheugenbus en een aanzienlijke prestatievermindering . De cache op het laatste niveau fungeert als een gemeenschappelijke "buffer" die RAM-toegang vermindert en een groot deel van het dataverkeer centraliseert.
Bovendien organiseren veel architecturen caches inclusief: regels die zijn opgeslagen in niveaus dicht bij de processor zijn ook aanwezig in hogere niveaus van de hiërarchie . Dat wil zeggen dat een regel die in L1 voorkomt, ook in L2 en vervolgens in L3 voorkomt. Dit heeft een zeer nuttig gevolg voor de consistentie: het correct bijwerken van de cache op het laagste niveau is voldoende om de status van de andere niveaus te controleren zonder dat er constant toegang tot het RAM-geheugen nodig is.
Waarom gedeelde caching op het laatste niveau essentieel is voor consistentie
Zonder deze globale cache op het laatste niveau zou elke core de consistentie rechtstreeks met het hoofdgeheugen moeten controleren . Telkens wanneer een geheugenregel in een privécache werd gewijzigd, zou het nodig zijn om te controleren of andere cores een kopie van diezelfde regel bewaren en, zo ja, deze overal bij te werken of ongeldig te maken.
In een systeem met veel cores zou deze werklast aan controles resulteren in een enorm aantal transacties naar het RAM-geheugen , waardoor een groot deel van het voordeel van snelle caches teniet wordt gedaan. Door een gedeelde cache tussen de cores en het geheugen te plaatsen, kan de CPU de coherentiecontrole concentreren op één enkele tussenliggende locatie.
In veel implementaties bevatten de caches op hogere niveaus (verder van de processor) kopieën van de regels die aanwezig zijn in de niveaus dichter bij de kern . Met deze organisatie hoeft het coherentieprotocol er alleen voor te zorgen dat het laatste niveau gesynchroniseerd is met het hoofdgeheugen en dat de privéniveaus van elke kern gesynchroniseerd zijn met het niveau direct erboven.
Dit kan worden gezien als een soort Russische matroesjka: de cache op het derde niveau bevat de inhoud van het tweede en eerste niveau , het tweede niveau bevat zijn eigen inhoud en die van het eerste niveau, en het eerste niveau kent alleen zijn eigen regels. Door de "grote pop" (het laatste niveau) te besturen, kan het systeem de rest efficiënter coördineren.
Het resultaat is dat het handhaven van consistentie economischer wordt qua ontwerp en geheugenverkeer . In plaats van elke core te dwingen constant met RAM te werken, werkt het protocol met de gedeelde cache en beheert van daaruit welke regels in de privécaches moeten worden bijgewerkt of ongeldig gemaakt.
Updatemethoden: ongeldig maken en bijwerken van kopieën
Een cruciaal probleem ontstaat wanneer twee of meer cores vrijwel gelijktijdig toegang willen krijgen tot dezelfde regel data die over meerdere caches is gedupliceerd . In deze context hanteren consistentiesystemen doorgaans twee fundamentele strategieën voor het afhandelen van schrijfbewerkingen.
De eerste methode is gebaseerd op invalidatie. Wanneer een kernel naar een specifieke cachelijn moet schrijven, maakt het protocol alle kopieën van diezelfde lijn die mogelijk in de andere caches aanwezig zijn ongeldig . Alleen de kernel die gaat schrijven, houdt de lijn in een lees- en schrijfmodus; de andere kernels moeten, als ze die gegevens opnieuw willen gebruiken, de lijn opnieuw laden vanuit een hoger niveau (of vanuit het geheugen) met de bijgewerkte versie.
De tweede strategie betreft het bijwerken. In dit geval probeert het systeem, wanneer een kernel een regel wijzigt, de nieuwe inhoud automatisch door te geven aan bestaande kopieën in de andere caches . Op deze manier ontvangen alle caches die die regel hebben opgeslagen de bijgewerkte versie zonder dat deze later ongeldig hoeft te worden gemaakt en opnieuw geladen.
Elke aanpak heeft zijn voor- en nadelen. Invalidatie is meestal efficiënter bij frequente schrijfbewerkingen, omdat het voorkomt dat het geheugensysteem overbelast raakt met updates die andere cores mogelijk niet direct nodig hebben. Omgekeerd kan bijwerken voordelig zijn wanneer veel cores frequent dezelfde gegevens lezen die relatief zelden worden gewijzigd , omdat het de latentie vermindert doordat de regel na elke invalidatie niet opnieuw hoeft te worden geladen.
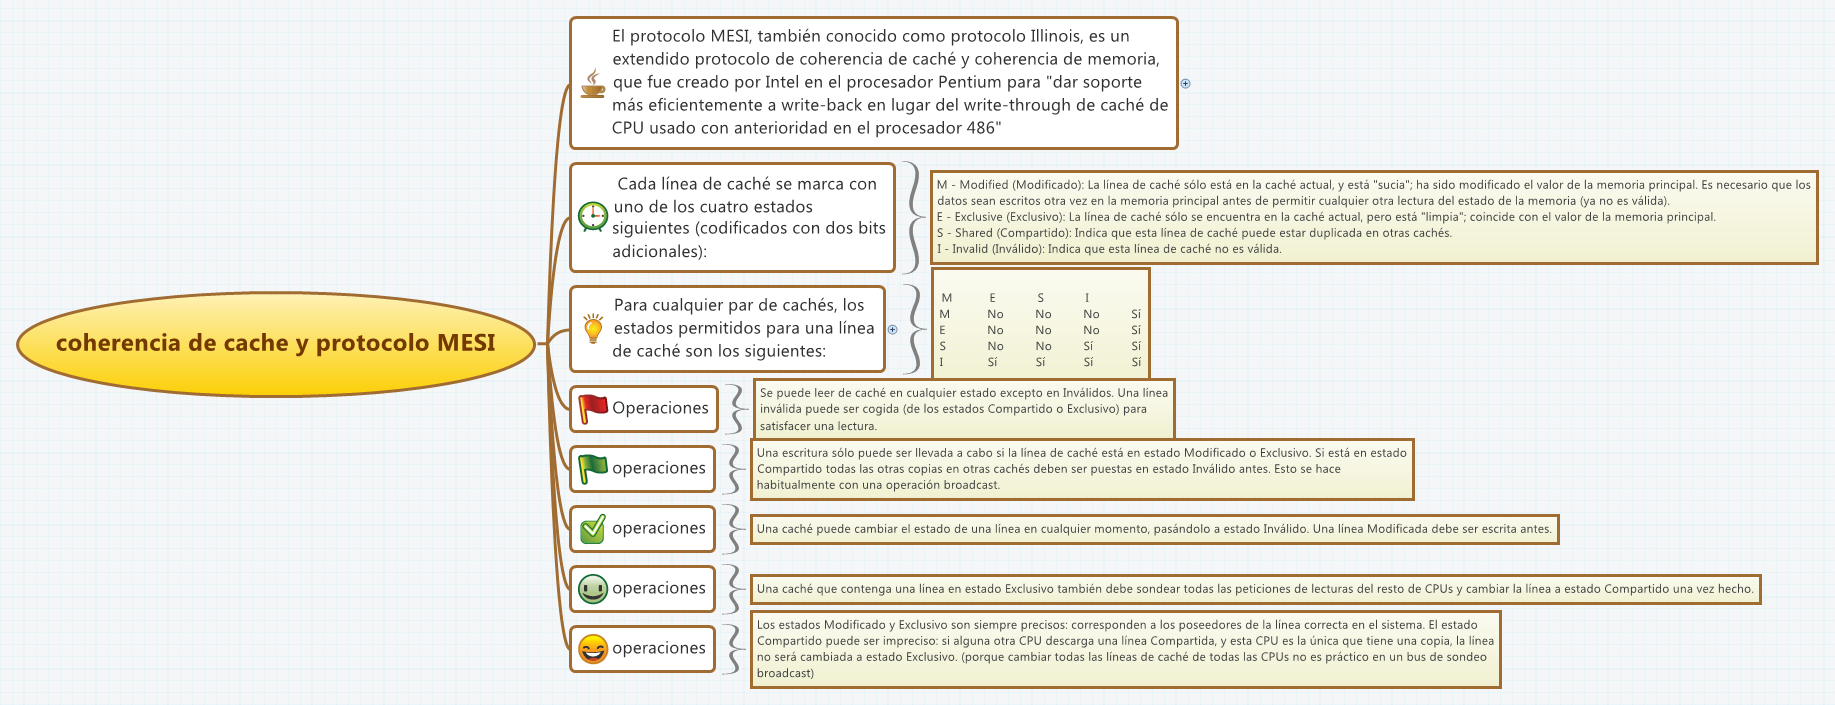
In beide gevallen maken beide methoden gebruik van extra statussen en besturingsbits in de cachelijnen. Elke lijn bevat doorgaans informatie over de vraag of de inhoud overeenkomt met die in het RAM-geheugen , en of deze gedeeld, gewijzigd, exclusief, gereserveerd, enzovoort is, afhankelijk van het specifieke protocol (MESI, MOESI, MSI, enz.). Dit stelt de hardware in staat snel te beslissen wat te doen wanneer een lees- of schrijfbewerking plaatsvindt op een reeds gerepliceerde lijn.
Consistentie controleren tussen caches en geheugen
Het rechtstreeks verifiëren van de consistentie tussen alle cachelagen van een CPU of GPU en het hoofdgeheugen zou een gigantische taak zijn, zowel qua ontwerpcomplexiteit als qua prestatiekosten. Daarom organiseren moderne systemen deze verificatie hiërarchisch.
De caches die zich het dichtst bij de processor bevinden (L1, L2) zijn meestal niet rechtstreeks verbonden met het RAM-geheugen, maar met het volgende cacheniveau. Dit betekent dat de consistentie niet op elk niveau wordt gecontroleerd ten opzichte van het hoofdgeheugen, maar direct ten opzichte van het niveau daarboven . Dit vermindert het aantal RAM-toegangspogingen en vereenvoudigt de logica die op lagere niveaus nodig is.
Uiteindelijk vindt de vergelijking tussen de cache-inhoud en de RAM-inhoud plaats tussen de cache op het laatste niveau en het hoofdgeheugen . Als dit laatste niveau een correcte en consistente status behoudt, en elk lager niveau zijn consistentie met het erboven behoudt, blijft de hele hiërarchie consistent zonder dat elke regel herhaaldelijk hoeft te worden gecontroleerd ten opzichte van het RAM-geheugen.
Wanneer een kernel naar een cachelijn schrijft en de gegevens ervan wijzigt, wordt de status van die lijn gemarkeerd om aan te geven dat deze niet langer exact overeenkomt met de kopie die in het geheugen is opgeslagen . Vervolgens coördineert het protocol de update: het markeert de corresponderende kopieën in andere caches als gereserveerd of ongeldig en schrijft, indien nodig, de nieuwe inhoud naar de bijbehorende hoofdgeheugenlijn.
Deze trapsgewijze organisatie zorgt ervoor dat wijzigingen geleidelijk vanuit de kernel, die de gegevens bijwerkt, naar het hoofdgeheugen worden doorgegeven, waarbij ze op gecontroleerde wijze door elk cacheniveau gaan. Op deze manier wordt het handhaven van consistentie geen onoverkomelijk knelpunt voor de processor.
Hardwarecoherentie versus softwarecoherentie
Tot nu toe hebben we consistentiemechanismen besproken die voornamelijk in hardware zijn geïmplementeerd: protocollen, statusbits, gedeelde caches, enzovoort. Er is echter een andere benadering die een deel van die complexiteit naar software wil verplaatsen , met name naar de compiler en het besturingssysteem.
Softwarematige consistentieschema's proberen de behoefte aan extra on-chip logica te verminderen door code te analyseren en tijdens het compileren beslissingen te nemen . Het idee is dat als de compiler kan afleiden wanneer en hoe bepaalde gedeelde gegevens worden benaderd, deze in veel gevallen kan voorkomen dat die gegevens in de cache worden opgeslagen of de zichtbaarheid ervan expliciet kan beheren.
Deze aanpak heeft een duidelijk voordeel: een deel van de werklast verschuift van runtime naar compileertijd . In plaats van dat de hardware alle conflicten direct detecteert en afhandelt, probeert de compiler ze te anticiperen en code te genereren die gevaarlijke situaties vermijdt.
Het nadeel is dat statische codeanalyse beperkt is, waardoor compilers vaak conservatief te werk gaan . Dit betekent dat ze, om schending van de consistentie te voorkomen, vaak beslissingen nemen die de effectiviteit van caches verminderen. Als ze vermoeden dat bepaalde gegevens problematisch kunnen zijn, voorkomen ze vaak dat deze in de cache worden opgeslagen of dwingen ze synchronisaties vaker af dan strikt noodzakelijk.
Hoewel deze softwarematige oplossingen in theorie aantrekkelijk zijn, met name voor het vereenvoudigen van het hardwareontwerp, vervangen ze in de praktijk de coherentieondersteuning die in de CPU zelf is geïntegreerd niet , maar vullen ze deze juist aan in bepaalde specifieke scenario's.
De rol van de compiler in cacheconsistentie
Een belangrijk element van softwarematige consistentiebenaderingen is de rol van de compiler. De compiler kan een grondige analyse van de code uitvoeren en bepalen welke gedeelde datastructuren mogelijk onveilig zijn voor caching . Op basis hiervan markeert de compiler deze elementen op een speciale manier of past de codegeneratie aan.
De eenvoudigste, en tevens meest conservatieve, aanpak is om te voorkomen dat gedeelde datavariabelen in de cache worden opgeslagen . Dat wil zeggen dat elke toegang tot deze variabelen een toegang tot het hoofdgeheugen of een niet-cachebaar gebied afdwingt. Dit garandeert consistentie, maar mist veel mogelijkheden voor prestatieverbetering, omdat een gedeelde structuur in bepaalde perioden privé kan worden gebruikt en in andere perioden alleen-lezen is.
In werkelijkheid doet het consistentieprobleem zich alleen voor tijdens intervallen waarin ten minste één proces naar de variabele kan schrijven en een ander proces deze kan lezen . Buiten deze kritieke perioden kan de variabele worden beschouwd als exclusief voor gebruik door één enkele thread, of zelfs tijdelijk als een effectieve constante, waardoor deze probleemloos in de cache kan worden opgeslagen.
De meest geavanceerde compilatiestrategieën proberen die "veilige" perioden te identificeren waarin de gedeelde variabele als conflictvrij kan worden beschouwd . Om dit te doen, analyseert de compiler uitvoeringspaden, potentiële gelijktijdige toegangspogingen en synchronisatiepatronen (vergrendelingen, kritieke secties, enz.). Op basis van deze analyse verdeelt de compiler de levensduur van de variabele in fasen: sommige geschikt voor caching, andere vereisen een speciale behandeling.
Tijdens kritieke perioden, wanneer gelijktijdige toegang met schrijfbewerkingen wordt gedetecteerd, voegt de compiler extra instructies toe aan de gegenereerde code om cacheconsistentie af te dwingen . Deze instructies kunnen cache-flushes, geheugenherladingen, geheugenbarrières of toegang tot gebieden die als niet-cachebaar zijn gemarkeerd, afdwingen, afhankelijk van het programmeermodel en de onderliggende architectuur.
Relatie tussen compiler, besturingssysteem en hardware
De zin "de compiler voegt instructies in de gegenereerde code in om cacheconsistentie te waarborgen" zou kunnen doen vermoeden dat het besturingssysteem deze instructies leest alsof het hints op hoog niveau zijn en op basis daarvan besluit hoe het programma moet worden uitgevoerd. In werkelijkheid werkt het mechanisme echter iets anders.
Wanneer de compiler dit soort instructies toevoegt, introduceert hij specifieke bewerkingen in het binaire bestand die worden ondersteund door de architectuur of de runtime-omgeving . Zo kan hij bijvoorbeeld instructies invoegen voor het legen van de cache, geheugenbarrières, speciale instructies om gebieden als niet-cachebaar te markeren, of aanroepen naar besturingssysteemservices die geheugenkenmerken configureren.
Het besturingssysteem interpreteert deze instructies niet als hoogwaardige "commentaren" of "hints" geschreven door de compiler; het voert de machinecode gewoon uit zoals elke andere code . Sommige van deze instructies zijn echter ontworpen om te interageren met het geheugensubsysteem en cachebeheer, waardoor de manier waarop de CPU bepaalde gegevens benadert, verandert.
Met andere woorden, de compiler voert een voorlopige analyse uit en genereert code die, wanneer uitgevoerd, het gewenste cachegedrag produceert . Het besturingssysteem werkt hieraan mee door geheugenkenmerken vast te stellen (cachebare of niet-cachebare gebieden, schrijfbeleid, enz.) en synchronisatieprimitieven aan te bieden, maar het "leest" geen speciale instructies in de zin van semantische interpretatie zoals een compiler dat zou doen.
Het kan ook voorkomen dat de hardware, bij het zien van bepaalde instructies, specifieke coherentie- of synchronisatiemechanismen activeert . Zo garanderen fence- of barrier-instructies de volgorde van geheugentoegang en dwingen ze bepaalde zichtbaarheidseffecten af binnen de cachehiërarchie. In dit geval is er sprake van een drievoudige samenwerking: de compiler bepaalt waar deze instructies geplaatst moeten worden, het besturingssysteem configureert de uitvoeringsomgeving en de hardware implementeert het daadwerkelijke gedrag op cache- en geheugenbusniveau.
Al deze elementen zorgen er samen voor dat, zelfs met meerdere kopieën van dezelfde data verdeeld over verschillende caches en het hoofdgeheugen, parallelle programma's met een consistent geheugenmodel werken . Cachecoherentie is veel meer dan een simpel intern CPU-detail; het is een essentieel onderdeel voor de betrouwbare en efficiënte werking van multicore-systemen.
Inzicht in de wisselwerking tussen cachehiërarchie, hardwarecoherentieprotocollen en softwareondersteuningstechnieken maakt duidelijker waarom moderne CPU-ontwerpen zo'n vergelijkbare structuur hebben en waarom een kleine storing in een van deze mechanismen chaotisch gedrag kan veroorzaken in gelijktijdige applicaties die volledig afhankelijk zijn van het feit dat alle cores dezelfde gegevens op het juiste moment ontvangen.