- Microsoft Fabric centraliseert data, governance, AI en realtime analyses op OneLake en biedt uniforme functionaliteiten.
- Het platform versterkt governance, beveiliging en kostenbeheersing door middel van Purview, OneLake-beveiliging, DLP, DSPM en integratie met Azure Cost Management.
- Met Data Factory, Dataflow Gen2 en migratietools is het eenvoudig om bestaande workloads te verplaatsen en complexe pipelines te orkestreren.
- Copilot, data-agents, MCP en nieuwe workloads zoals Fabric IQ en Real-Time Intelligence stimuleren geavanceerde AI- en automatiseringsscenario's.
Als je al een tijdje met data werkt binnen het Microsoft-ecosysteem, zul je hebben gemerkt dat Microsoft Fabric de centrale hub is geworden voor moderne analyses . Het platform verenigt alles wat voorheen verspreid was over Power BI, Azure Synapse, Data Factory en andere services. In dit artikel bekijken we de nieuwste functies, de roadmap en de praktische implicaties van Fabric voor analyses, governance, AI en realtime analyses.
Het idee is dat u na het lezen een helder beeld hebt van wat Microsoft Fabric vandaag de dag te bieden heeft, waar het naartoe gaat en hoe het de data-architectuur van uw organisatie beïnvloedt: governance-mogelijkheden met Purview, automatisering met API's en Git, nieuwe AI-functies, realtime intelligentie, beveiliging in OneLake, migraties, prestaties en nog veel meer.
Microsoft Fabric en het Cloud Adoption Framework: governance, kosten en automatisering
Binnen het Cloud Adoption Framework (CAF) publiceert Microsoft een reeks handleidingen om het ontwerp van Microsoft Fabric af te stemmen op de ontwerppijlers van landingzones . De nieuwste publicatie in deze reeks behandelt drie belangrijke gebieden: governance, capaciteitsoptimalisatie en automatisering/DevOps.
Wat het beheer betreft, worden de capaciteitskosten van Fabric inzichtelijk gemaakt via Azure Cost Management . Dit maakt een naadloze integratie mogelijk van het Fabric-capaciteitsverbruik (en andere SKU's) in Azure-kostendashboards, waarschuwingen en uitgavenanalyses. Het gaat niet alleen om het bekijken van de factuur: u kunt deze informatie koppelen aan tags, abonnementen of resourcegroepen om te begrijpen wie wat uitgeeft en waarom.
De technische architectuur en het bedrijfsmodel van Fabric stellen klanten in staat het capaciteitsverbruik nauwkeurig te controleren en zo de operationele kosten te optimaliseren . In de praktijk vertaalt dit zich in verschillende mogelijkheden:
- Schaalvergroting van capaciteiten FDe capaciteit verhogen of verlagen op basis van voorspelbare pieken, zoals verkoopcampagnes, deadlines voor boekhoudkundige werkzaamheden of grote hoeveelheden data.
- Pauzeer- en hervatmogelijkhedenFabric-beheerders kunnen een F-capaciteit pauzeren wanneer deze niet nodig is (bijvoorbeeld 's nachts of in het weekend in niet-kritieke omgevingen) om de rekenkosten te verlagen.
- OverspanningsbeveiligingTwee capaciteitsparameters bepalen hoe achtergrondtaken worden beheerd om te voorkomen dat ze de omgeving overbelasten: de drempelwaarde voor het afwijzen van achtergrondtaken en de drempelwaarde voor het herstellen van achtergrondtaken.
- CapaciteitsreserveringenHet is mogelijk om capaciteit voor bepaalde perioden te reserveren om kortingen te verkrijgen, mits het verwachte verbruik nauwkeurig wordt gepland.
Op het gebied van databeheer vertrouwt Fabric op Microsoft Purview als centrale component voor catalogisering, herkomst en classificatie . Purview stelt gebruikers in staat om gevoeligheidslabels toe te passen, de herkomst van gegevens te bekijken over bronnen, transformaties en gebruik, data-assets te certificeren en campagnes voor datakwaliteit te voeren, en dit alles met integratie van Fabric-elementen (Lakehouse, Warehouse, KQL, Power BI, enz.).
De component "Platformautomatisering en DevOps" richt zich voornamelijk op Git-integratie, implementatiepipelines en REST API's . Fabric-werkruimtes kunnen worden gekoppeld aan Git-repositories, waardoor meerdere ontwikkelaars kunnen samenwerken aan hetzelfde data-engineering-, data science- of realtime-analyseproject zonder dat hun werk elkaar overlapt.
Git en implementatiepipelines maken het mogelijk om de ontwikkelings-, test- en productielevenscycli op een gecontroleerde manier te orkestreren : contentpromotie, wijzigingsregistratie, synchronisatie van artefacten en versiebeheer. Sinds maart 2025 ondersteunen deze pipelines (in algemene of preview-status) een breed scala aan elementtypen, waaronder triggers, dashboards, dataflows, datapipelines, datamarts, lakehouses, datawarehouses, KQL, notebooks, gepagineerde rapporten, organisatieapplicaties en meer.
Daarnaast biedt Fabric een zeer uitgebreide set REST API's waarmee vrijwel elke administratieve of implementatietaak geautomatiseerd kan worden: het aanmaken van werkruimtes en mappen, het批量 migreren van items, het beheren van verbindingen en gateways, het extraheren van definities, het activeren van pipelines of notebooks, en nog veel meer.
Belangrijke updates op het gebied van analyses, AI en governance voor Microsoft Fabric.
De evolutie van Fabric wordt gekenmerkt door een enorm aantal preview-functies en nieuwe mogelijkheden die vrijwel elk aspect van het platform raken . Deze worden hieronder op een gestructureerde manier gegroepeerd en besproken om hun volledige reikwijdte te laten zien.
AI-functies in datawarehouses en multimodale functies
Op het gebied van relationele data integreert Fabric Data Warehouse AI-functies direct in T-SQL (preview). Dit maakt het volgende mogelijk:
- Classificeer of categoriseer tekst.
- Analyseer het sentiment.
- Gestructureerde informatie extraheren uit vrije tekst.
- Tekst vertalen tussen talen.
- Correcte grammatica.
Het doel is om de noodzaak om de SQL-context te verlaten voor het verrijken van data met AI te elimineren . Deze functies worden gecombineerd met bredere multimodale ondersteuning in de AI-functies van Fabric, die nu afbeeldingen (JPG/JPEG, PNG, GIF, WebP), PDF's en gangbare tekstformaten kunnen verwerken, evenals bestandspaden.
Hulpprogramma's zoals aifunc.load voor het importeren van mappen in tabellen met prompt- en schema-opties, aifunc.list_file_paths voor het doorlopen van bestandspaden en ai.infer_schema voor het afleiden van schema's die compatibel zijn met ai.extract zijn inbegrepen . Dit alles stelt u in staat om gegevens te transformeren en te verrijken zonder complexe pipelines helemaal zelf te hoeven bouwen.
OneLake, Delta, Apache Iceberg en toegang tot meerdere platformen
Op het opslagniveau blijft OneLake het uniforme data lake waar alle Fabric-componenten zich bevinden. Een van de belangrijkste verbeteringen is de mogelijkheid om Delta Lake-tabellen beschikbaar te stellen als Apache Iceberg-tabellen zonder gegevens te verplaatsen of te dupliceren, zodat Iceberg-compatibele engines direct kunnen lezen wat er in OneLake staat.
Bovendien ondersteunt OneLake nu Apache Iceberg-gegevens die rechtstreeks door Snowflake worden geschreven en via kopieervrije toegang in Fabric worden gebruikt . Deze strategie versterkt de interoperabiliteit: Fabric is niet bedoeld als een geïsoleerde infrastructuur, maar eerder als een datahub die andere engines kunnen gebruiken zonder dubbele opslag.
Op dezelfde manier biedt OneLake ondersteuning voor snelkoppelingen naar Azure Blob Storage , OneDrive en SharePoint, en breidt het de beveiliging uit met toegangsrollen, beveiliging op map-, rij- en kolomniveau, en een beveiligingsmodel dat door derden kan worden gerespecteerd dankzij de uitbreiding van het geautoriseerde engine-model.
Een bijzonder relevante functie is de federatie van de OneLake-catalogus met Azure Databricks, waardoor zero-copy toegang mogelijk is van Unity Catalog tot OneLake-tabellen . Op deze manier blijft OneLake de bron van waarheid, maar kan Databricks de gegevens rechtstreeks opvragen, waarbij alleen de metadata wordt gesynchroniseerd.
SQL-database op Fabric: prestaties, beveiliging en virtualisatie
De SQL-database van Fabric krijgt eigen mogelijkheden: ALTER DATABASE SET-opties , ondersteuning voor sortering en full-text-indexering in de preview. Wat betreft databaseprestaties en -kosten zijn er diverse verbeteringen:
- Automatische indexcompactie Om de opslagruimte en I/O te verminderen en de querytijden te verbeteren zonder dat er onderhoudstaken hoeven te worden ingepland.
- Maximale vCores-limiet Om het gebruik van computerbronnen (4 of 32 vCores) te reguleren, is dit ontworpen om te voorkomen dat een workload te veel gedeelde capaciteit verbruikt.
- Aangepaste SQL-pools die werkruimtebeheerders gedetailleerde controle geven over de toewijzing van resources en de routering van query's op basis van de applicatienaam.
Datavirtualisatie is ook ingeschakeld in SQL-databases , waardoor het mogelijk is om externe gegevens die in OneLake zijn opgeslagen op te vragen met T-SQL en bestanden in gangbare formaten te koppelen aan lokale relationele tabellen met behulp van joins, zonder dat de gegevens fysiek hoeven te worden geïmporteerd.
Wat betreft beveiliging ondersteunt de SQL-database Private Link op tenantniveau (preview) , waardoor het eenvoudiger wordt om dataverkeer privé en gecontroleerd te kanaliseren, in lijn met de algehele beveiligde netwerkconfiguratie van Fabric.
Real-Time Intelligence, Eventhouse, Eventstream en Activator
De Real-Time Intelligence (RTI)-module is uitgegroeid tot een van de belangrijkste onderscheidende kenmerken van Fabric. Eventhouse en Eventstream werken samen om in realtime gebeurtenissen van allerlei bronnen te verzamelen, te verwerken en te activeren, en Activator orkestreert de acties die onder bepaalde voorwaarden worden geactiveerd.
Tot de krachtigste nieuwe functies behoren:
- Anomaliedetectie zonder code met automatische modelselectie, een eenvoudige interface en flexibele waarschuwingen.
- Zakelijke evenementen, die belangrijke zakelijke momenten vastleggen die gegenereerd worden door gebruikersgegevensfuncties en notitieboeken, en waarmee u waarschuwingen, aangepaste logica, workflows, AI-modellen of Spark-taken kunt activeren.
- Integratie van Activator-gebruikersgegevensfunctieszodat functies die in Fabric zijn gemaakt, gebeurtenissen uit elke bron kunnen verwerken, inclusief interne gebeurtenissen van het platform zelf en van OneLake.
- Mogelijkheid om gebeurtenissen te verwerken met SQL (SQL-operator in Eventstream).waardoor de transformatie van realtime datastromen met bekende SQL-syntaxis mogelijk wordt.
Relevante connectoren worden toegevoegd, zoals Cribl (voor het importeren van log- en telemetriegegevens uit meerdere bronnen), een connector met Solace PubSub+ en ondersteuning voor streaming via privénetwerken met behulp van Azure Virtual Network, VPN, ExpressRoute of privé-eindpunten.
Voor dataschema's en contracten introduceert Eventstream een Schema Registry dat gebeurtenisschema's definieert en valideert voor robuustere pipelines, en ondersteuning voor de Confluent Schema Registry om verbinding te maken met Kafka in Confluent Cloud met respect voor bestaande contracten.
Copilot- en AI-functionaliteiten op het hele platform.
Copilot in Fabric is nu wereldwijd beschikbaar, met ondersteuning voor Power BI, Data Factory, Data Science & Data Engineering en het schrijven van KQL-query's . Daarnaast zijn er specifieke functionaliteiten toegevoegd:
- Copilot voor Dataflow Gen2 (Moderne Get Data)Dit helpt bij het verwerken en transformeren van data met instructies in natuurlijke taal.
- Copilot voor datawarehouse (chat), toegankelijk via een knop in het lint om magazijntaken te versnellen door middel van een dialoogvenster.
- Copilot voor SQL-analyse-eindpunt, dat SQL-query's genereert en optimaliseert op basis van bedrijfsbeschrijvingen.
- Copilot op notebooks Met kennis van de werkruimtecontext, Lakehouse, notebookstructuur en uitvoeringsomgeving, in staat om code in meerdere stappen te genereren, te refactoren, complexe notebooks samen te vatten en fouten te diagnosticeren met de optie "Oplossen met Copilot".
- Inline-autocompletie (inline-codeaanvulling) en Notebook Copilot inline-codeaanvulling (preview)Om sneller en met minder fouten Python te schrijven.
Daarnaast wordt de AI-technologiebasis uitgebreid met vooraf geïntegreerde Foundry Tools (Azure OpenAI, Azure Language, Azure Translator), OpenAI-plug-ins voor Eventhouse (ai_embed_text en ai_chat_completion) en een reeks agents en data-agents waarmee andere applicaties, waaronder Copilot Studio, op een georkestreerde manier met Fabric-data kunnen werken.
Fabric Data Agents, MCP en ontwikkelaarstools
Fabric introduceert data-agents die in staat zijn om data-toegang te orkestreren, evenals tools voor AI-agents, met een Python SDK en directe integratie met Microsoft Copilot Studio. Dit maakt het eenvoudig om conversationele assistenten te bouwen die werken met bedrijfsdata die in Fabric worden beheerd.
Tegelijkertijd wordt het Model Context Protocol (MCP) een belangrijk onderdeel van de integratie tussen AI-agenten en Fabric-services. Er zijn speciale MCP-servers voor Activator en Eventhouse, en een ontwikkelingsgerichte Fabric MCP die:
- Het stelt AI-assistenten in staat om code en content te genereren voor Fabric-items.
- Het integreert met ontwikkeltools zoals VS Code en GitHub Codespaces.
- Het biedt tools voor het raadplegen van en handelen op basis van realtime data in Eventhouse.
Voor het dagelijkse werk van de ontwikkelaar zijn er verschillende aspecten die het vermelden waard zijn, waaronder de ontwikkelomgeving : een MSSQL-extensie voor VS Code met ondersteuning voor de SQL-database van Fabric , de Microsoft ADO.NET-driver en de ODBC-driver voor Fabric Data Engineering (verbinding met Spark SQL via Livy), en een Spark-connector voor SQL-databases die geauthenticeerde toegang vanuit Spark tot SQL-databases in Azure en Fabric vereenvoudigt.
Ook inbegrepen is de Fabric CLI , beschikbaar als een geïntegreerde taak in Azure DevOps, waarmee u het beheer van werkruimten, items en implementaties kunt automatiseren zonder handmatig externe tools te hoeven installeren.
Data Factory, datamigraties en orkestratie in Fabric
De data-integratielaag van Fabric is gebaseerd op Data Factory en Dataflow Gen2, die functies krijgen om orchestratie slimmer, beter automatiseerbaar en eenvoudiger te maken om van bestaande platforms te migreren.
Dataflow Gen2: prestaties, openbare API's en diagnostiek
In Dataflow Gen2 vinden we verschillende functies in preview:
- Geavanceerde bewerking van doelquery's om de logica op de bestemming rechtstreeks vanuit de ontwikkelomgeving zelf aan te passen.
- Gepartitioneerde computerwaardoor delen van de dataflow parallel kunnen worden uitgevoerd, wat de totale evaluatietijd verkort.
- Diagnostische gegevens downloaden Op uitvoeringsniveau, met gestructureerde logpakketten voor prestatieanalyse en incidentafhandeling.
- Openbare API's voor het programmatisch creëren, bijwerken, verwijderen, plannen en bewaken van dataflows.
- Openbare parameters met CI/CD-ondersteuningdie het mogelijk maken om datastromen te vernieuwen door waarden door te geven vanuit pijplijnen of andere bronnen.
- Recente gegevens Voor snelle toegang tot recent gebruikte items in het Power Query-lint en in Modern Get Data.
Dit alles wordt aangevuld door de mogelijkheid om Power Query programmatisch te evalueren via REST , wat de weg vrijmaakt voor het uitvoeren van M-scripts als onderdeel van geautomatiseerde processen, het integreren ervan met Spark, pipelines of externe tools, en het benutten van Power Query-connectoren.
Data Factory: adaptieve prestaties, connectiviteit en dbt
In het meer "klassieke" deel van de integratie introduceert Data Factory binnen Fabric het volgende:
- Adaptieve prestatie-afstemming voor kopieeractiviteiten, waarbij de prestatieparameters intelligent worden aangepast aan de configuratie en de uitvoeringscontext.
- Ondersteuning voor Change Data Capture (CDC) in kopieertaken, om alleen wijzigingen (invoegingen, updates, verwijderingen) continu te repliceren.
- Gateways op locatie met handmatige upgrade-optie Beheerd via het Fabric-portaal, API of scripts.
- recente connectieDit voegt eigenschappen van het laatste gebruik toe aan verbindingen om auditing en levenscyclusbeheer te vergemakkelijken.
- native dbt JobDit maakt het mogelijk om dbt-projecten binnen Fabric uit te voeren met geïntegreerde orchestratie, testen, documentatie en governance.
- De activiteit 'SSIS-pakket aanroepen' uitvoeren in pipelines, om SSIS-pakketten vanuit de orchestratie zelf in Fabric uit te voeren.
De gebruikerservaring wordt ook verbeterd door een SharePoint-sitekiezer die het handmatig typen van URL's overbodig maakt, en door MCP-ondersteuning voor Data Factory, waardoor AI-assistenten Dataflow Gen2 eenvoudig kunnen creëren en implementeren op basis van instructies in natuurlijke taal.
Hulpmiddelen voor gegevensmigratie en -replicatie
Microsoft stimuleert de migratie naar Fabric sterk via verschillende specifieke tools:
- Fabric-migratiebeoordeling voor Data Factory, dat de voorbereiding van ADF-pipelines analyseert en de ondersteunde pipelines migreert naar een Fabric-werkruimte met verbindingsmapping.
- Migratieassistent voor datawarehousedie nu rechtstreeks verbinding kan maken met het brondatawarehouse om de gegevens naar Fabric Data Warehouse te verplaatsen.
- Migratieassistent voor SQL-databases, gericht op het migreren van on-premises SQL Server-workloads, met schema-import via DACPAC, detectie van incompatibiliteit en aanbevelingen.
Wat betreft replicatie, wordt ondersteuning geboden voor het spiegelen van gegevens vanuit diverse operationele bronnen (Azure Database for MySQL, Google BigQuery, SQL Server, enz.) naar Fabric. Hierbij is het mogelijk om te bepalen welke tabellen worden gerepliceerd, spiegelprocessen via REST opnieuw te starten en, in het geval van Databricks, Unity Catalog-beleid te koppelen aan OneLake-beveiliging.
Ook inbegrepen is een replicatieconnector van Lakehouse die gebruikmaakt van Delta Change Data Feed . Deze connector maakt wijzigingen uit Lakehouse Delta-tabellen beschikbaar voor compatibele bestemmingen, zonder dat er zelf CDC-oplossingen ontwikkeld hoeven te worden.
Beveiliging, geavanceerd beheer en monitoring in Fabric
Een van de grootste uitdagingen voor elk analyseplatform is het beveiligen van gegevens, het reguleren van het gebruik en het monitoren van het resourceverbruik . Fabric ontwikkelt zich snel op deze gebieden.
Beveiliging en gegevensbescherming bij OneLake
OneLake voegt een compleet beveiligingsmodel voor gegevenstoegang toe met:
- Toegangsrollen voor Lakehouse met configureerbare machtigingen via een mapgebaseerde beveiligingsinterface.
- Beveiligingsondersteuning voor snelkoppelingen, zodat derden de vastgestelde beleidsregels kunnen respecteren.
- De OneLake API voor gegevensbeveiliging maakt geautomatiseerd toegangsbeheer mogelijk.
- Uitbreiding van het model naar externe engines (OneLake-beveiligingsautorisatie voor derden).
Parallel daaraan wordt de beveiliging uitgebreid met DLP, dat de toegang tot alle gestructureerde data in OneLake (SQL, KQL, datawarehouses) beperkt. Daarnaast wordt DSPM voor AI geïntroduceerd voor Fabric Copilots en data agents , dat AI-interacties monitort op gevoelige informatie en risicovol gedrag, met integratie met Purview Audit en eDiscovery.
In het identiteitsvlak verschijnen functies zoals aan items gekoppelde identiteiten (bijv. Lakehouse en Eventstream) via REST API's, die de afhankelijkheid van de eigenaar voor bepaalde bewerkingen elimineren, en de authenticatie van OneDrive- en SharePoint-snelkoppelingen via werkruimte- of serviceprincipalidentiteiten.
Gecentraliseerd beheer en OneLake-catalogus
De ervaring met gegevensbeheer wordt verbeterd met een nieuw gecentraliseerd dashboard in de OneLake-catalogus . Hier kunnen gegevenseigenaren een geaggregeerd overzicht zien van de items die ze hebben aangemaakt, aanbevelingen voor beheeracties ontvangen en toegang krijgen tot alle beschikbare tools om de beveiliging en naleving te verbeteren.
Daarnaast is er een OneLake cataloguszoek-API beschikbaar, samen met een MCP-tool, waarmee items in de gehele Fabric-omgeving kunnen worden gevonden vanuit code of AI-agents, met één enkele aanroep, waarbij catalogusrechten en metadata worden gerespecteerd.
Monitoring van capaciteit, verbruik en werk
Stof biedt meerdere lagen van zichtbaarheid:
- WerkruimtebewakingDit creëert een database in Fabric waarin logboeken en statistieken van meerdere items worden samengevoegd (inclusief kopieertaken met gedetailleerde monitoring).
- Werkruimtebewaking voor kopieertakenmet meetwaarden zoals doorvoer, datavolume, foutcodes en tijden, allemaal gericht op gecentraliseerde analyse.
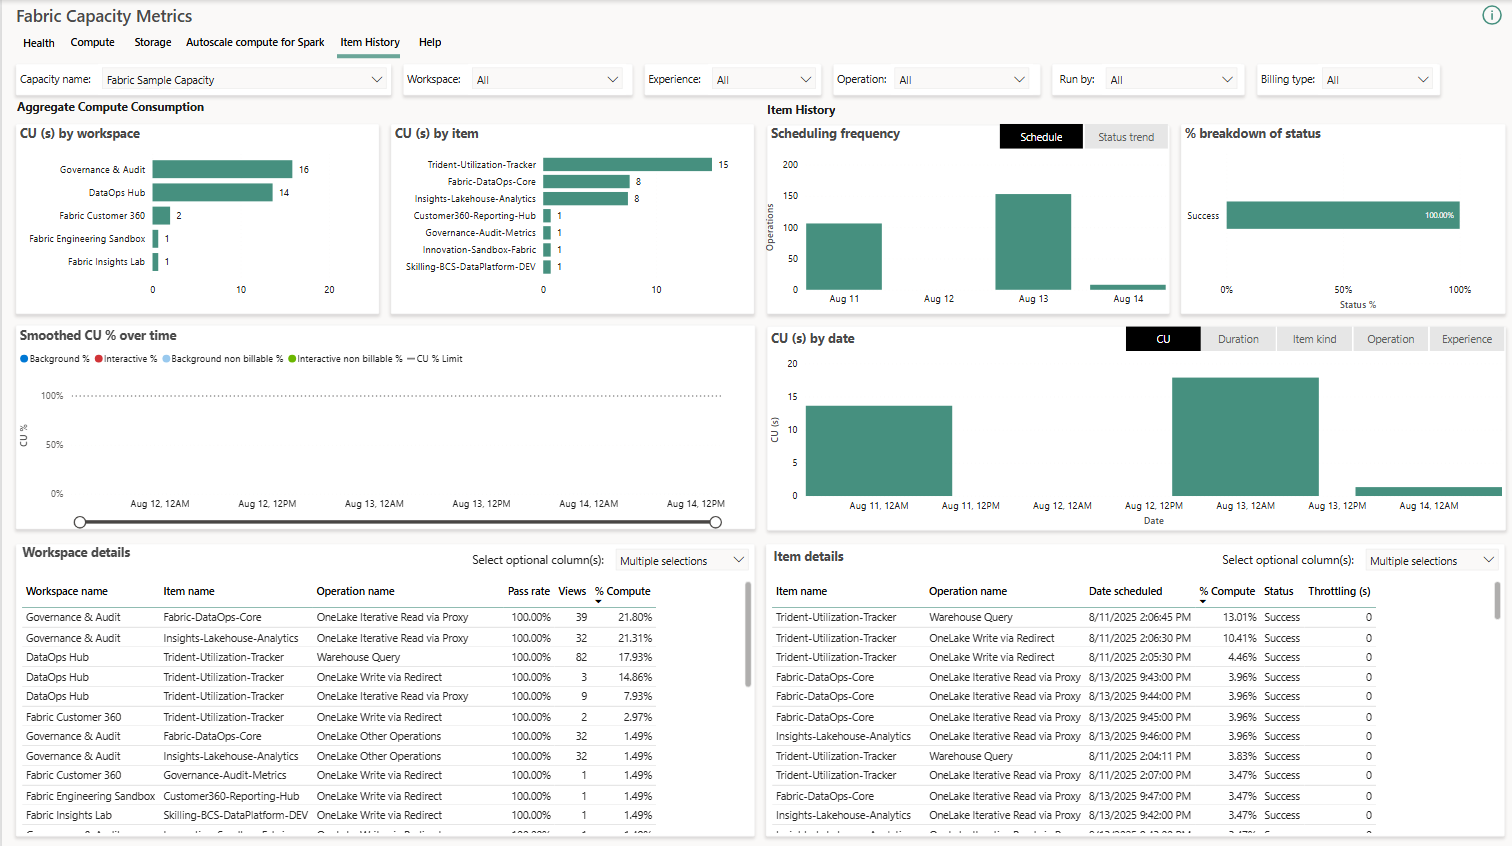
- Artikelgeschiedenis bij de toepassing van capaciteitsmetrieken, met een overzicht van 30 dagen van het CU-verbruik voor elk item, filterbaar op werkruimte en type.
- Overspanningsbeveiliging op werkplekniveauDit maakt het mogelijk om verbruiksdrempels per werkruimte in te stellen binnen een periode van 24 uur, werkruimtes die deze drempels overschrijden automatisch te blokkeren en werkruimtes als 'cruciaal' te markeren om ze van de beperkingen uit te sluiten.
Als aanvulling hierop wordt een eerste set Fabric Admin API's uitgebracht , gericht op het ontdekken van werkruimtes, items en gebruikersgegevens, waardoor dynamische inventarissen en periodieke toegangscontroles mogelijk worden.
Bedrijfsmodellering, planning en nieuwe werkzaamheden
Naast de technische laag introduceert Microsoft nieuwe, bedrijfsgerichte workloads bovenop Fabric. Een van de meest opvallende is Fabric IQ, dat tot doel heeft bedrijfssemantiek, data en modellen te verenigen voor intelligente agents die beslissingen nemen op basis van een holistisch beeld van de organisatie.
Binnen Fabric IQ vindt u het volgende:
- Ontologie (voorbeeld)Een type item waarbij entiteiten, relaties, eigenschappen en beperkingen worden gedefinieerd volgens de bedrijfstaal van het bedrijf.
- Plan (voorbeeld)Een platform zonder code voor planning, rapportage, analyses, integratie en gezamenlijk beheer.
Binnen realtime-intelligentie komt ook de digitale tweelingbouwer naar voren , een tool die gespecialiseerd is in het modelleren van digitale tweelingen op basis van realtime-gegevens, met als doel fysieke processen te optimaliseren, toestanden te bewaken en scenario's te simuleren.
Aan de andere kant wordt de Fabric IQ-workload geïntroduceerd als een aparte workload, en de ondersteunende tools voor governance en semantische afstemming worden steeds verder uitgebreid, waardoor de cirkel tussen datamodellen, bedrijfslogica en AI/analyse-applicaties rond wordt.
Prestatie-, gebruikerservaring- en productiviteitsverbeteringen
Ter afsluiting van de evaluatie is het de moeite waard om een aantal overkoepelende verbeteringen te benadrukken die niet altijd in het nieuws komen, maar wel een grote invloed hebben op de dagelijkse werkzaamheden van de teams.
In het onderdeel Spark en gedistribueerde computing introduceert Fabric het volgende:
- Fabric Runtime 2.0 (preview) met Apache Spark 4.0, Delta Lake 4.0, Java 21, Scala 2.13 en Python 3.12 op Azure Linux 3.0.
- Spark app-vergelijkingstoolwaarmee u tot vier Spark-uitvoeringen parallel kunt selecteren en vergelijken.
- Vonkdiagnose-emitter, dat logboeken, statistieken en gebeurtenissen van Spark-applicaties verzamelt en deze naar bestemmingen zoals Event Hubs, opslag of Log Analytics verzendt.
- JobInsight-diagnosebibliotheek, een bibliotheek voor het analyseren van voltooide Spark-uitvoeringen via API's (query's, jobs, stages, taken, executors, gebeurtenislogboeken).
In de datawarehouse-laag wordt data-clustering toegevoegd om de prestaties te verbeteren en de toegangskosten te verlagen, IDENTITY-kolommen voor surrogaatsleutels, en versiebeheer en CI/CD-ondersteuning via SQL Database-projecten in VS Code (Warehouse-broncodebeheer).
De gebruikerservaring van het Fabric-portaal evolueert ook met tabbladen en een objectverkenner , waardoor gebruikers meerdere items tegelijk kunnen openen en er snel tussen kunnen schakelen. Dit, samen met verbeteringen zoals de automatische koppeling van Lakehouse met Git en de suite met hulpprogramma's voor Lakehouse-onderhoud (onderhoudsactiviteiten en het vernieuwen van SQL-eindpunten), draagt bij aan een gebruiksvriendelijker en flexibeler platform.
Tot slot maken functies zoals het批量 importeren/exporteren van itemdefinities (voor migraties, sjablonen en metadata-backups), REST voor mappen, parameterondersteuning bij itemactivaties vanuit Activator en het laden van OneLake-gegevens in Excel met een geïntegreerde catalogus, het ecosysteem compleet. Dit dekt vrijwel alle gebruikelijke behoeften van een modern datateam.
Met deze complete set aan mogelijkheden – van gecentraliseerd beheer, gedetailleerde beveiliging en intelligente orkestratie tot AI geïntegreerd in SQL, realtime analyses, digitale tweelingen en MCP-agents – profileert Microsoft Fabric zich als een compleet dataplatform waar het niet langer alleen draait om het opslaan en visualiseren van data, maar ook om het beheren, automatiseren en inzetten van AI om elk onderdeel van de datalevenscyclus aan te drijven . Dit stelt organisaties in staat hun architecturen geleidelijk te ontwikkelen, bestaande systemen te migreren en nieuwe oplossingen veel sneller te implementeren dan met traditionele methoden.