- Algoritmen zijn instructies die ontworpen zijn om specifieke problemen in het digitale leven op te lossen.
- Er zijn verschillende typen, elk geoptimaliseerd voor verschillende taken, zoals zoeken, sorteren en versleutelen.
- Met algoritmen voor machinaal leren kunnen machines van gegevens leren en beslissingen nemen.
- De online gegevensbeveiliging wordt gewaarborgd door encryptie-algoritmen, die cruciaal zijn voor cyberbeveiliging.

De belangrijkste soorten algoritmen op een eenvoudige manier uitgelegd
Het belang van algoritmen in het digitale tijdperk
Algoritmen vormen de kern van de digitale revolutie die wij doormaken. Deze wiskundige en logische processen zijn de onzichtbare tandwielen die alles aandrijven, van onze smartphones tot de meest complexe kunstmatige intelligentiesystemen. Maar wat zijn algoritmes precies en waarom zijn ze zo belangrijk in ons dagelijks leven?
Een algoritme is in essentie een reeks stapsgewijze instructies die zijn ontworpen om een probleem op te lossen of een specifieke taak uit te voeren. Stel je voor dat het een kookrecept is, maar in plaats van een heerlijk gerecht te maken, bedenken we oplossingen voor computerproblemen. En net zoals er verschillende soorten recepten zijn voor verschillende gerechten, zijn er ook verschillende soorten algoritmen om verschillende uitdagingen in de digitale wereld aan te pakken.
Soorten algoritmen: basisprincipes en classificatie
Wanneer we spreken over soorten algoritmen , verwijzen we naar verschillende categorieën van rekenkundige procedures, elk ontworpen om specifieke problemen op te lossen. Deze algoritmen vormen de ruggengraat van de moderne computertechnologie en worden gebruikt in een breed scala aan toepassingen, van informatieopvraging tot complexe besluitvorming.
Het classificeren van algoritmen is geen eenvoudige taak, omdat veel ervan in meerdere categorieën kunnen vallen, afhankelijk van hun gebruik en kenmerken. Om het begrip te vereenvoudigen, kunnen we ze in zeven hoofdtypen verdelen. Deze typen bestrijken de meest voorkomende toepassingen in de wereld van de technologie.
Elk van deze algoritmetypen heeft zijn eigen sterke en zwakke punten en wordt gekozen op basis van de aard van het op te lossen probleem. Sommige zijn geoptimaliseerd voor snelheid, andere voor geheugenefficiëntie en weer andere voor de nauwkeurigheid van de resultaten. Inzicht in deze verschillende typen helpt ons beter te begrijpen hoe de technologieën die we dagelijks gebruiken werken en hoe uitdagingen in de digitale wereld worden aangepakt.
In de volgende paragrafen gaan we dieper in op elk van deze typen algoritmen, van de meest basale tot de meest geavanceerde. We geven concrete voorbeelden en leggen op een eenvoudige manier uit hoe ze werken.
Zoekalgoritmen: de naald in de digitale hooiberg vinden
Zoekalgoritmes behoren ongetwijfeld tot de meest gebruikte algoritmes in ons dagelijks leven. Elke keer dat we een zoekopdracht intypen in een zoekmachine zoals Google, zetten we complexe algoritmes in werking die ontworpen zijn om de meest relevante informatie te vinden tussen miljoenen webpagina's.
Maar hoe werken deze algoritmes precies? Stel je voor dat je in een grote bibliotheek op zoek bent naar een specifiek boek. Een efficiënt zoekalgoritme zou vergelijkbaar zijn met een supersonische bibliothecaris die binnen enkele seconden alle boeken kan scannen en u precies het boek kan aanbieden dat u nodig hebt.
Een van de bekendste zoekalgoritmes is het binaire zoekalgoritme . Dit algoritme is ongelooflijk efficiënt bij het doorzoeken van een gesorteerde lijst. Het werkt door de lijst herhaaldelijk in tweeën te delen en de helft die het gezochte item niet bevat, te negeren. Het is vergelijkbaar met het zoeken naar een specifieke pagina in een boek: eerst open je het boek in tweeën, vervolgens bepaal je of de pagina die je zoekt zich in de eerste of tweede helft bevindt, en dit proces herhaal je totdat je de juiste pagina hebt gevonden.
Algoritmetype: Diepte eerst zoeken
Een ander fundamenteel zoekalgoritme is dieptezoeking (DFS). Dit algoritme is vooral nuttig bij het verkennen van datastructuren zoals bomen of grafieken. Stel je voor dat je een doolhof verkent: dieptezoeking is dan alsof je één pad volgt tot het einde, waarna je terugkeert en een ander pad probeert.
Moderne zoekmachines gebruiken echter veel complexere algoritmen die meerdere technieken combineren. Het PageRank-algoritme van Google zoekt bijvoorbeeld niet alleen naar trefwoorden, maar evalueert ook het belang van webpagina's op basis van het aantal andere pagina's dat naar die pagina's linkt.
De efficiëntie van deze zoekalgoritmen is cruciaal. In een wereld waarin elke seconde enorme hoeveelheden data worden gegenereerd, is het belangrijker dan ooit om snel relevante informatie te kunnen vinden. Zonder deze algoritmes zou surfen op het internet vergelijkbaar zijn met het zoeken naar een speld in een hooiberg ter grootte van een planeet.
Sorteeralgoritmen: orde scheppen in chaos
Sorteeralgoritmen zijn een ander fundamenteel type algoritme dat een cruciale rol speelt bij gegevensverwerking. Deze algoritmen zijn verantwoordelijk voor het ordenen van elementen in een specifieke volgorde, hetzij numeriek, alfabetisch of volgens een ander gedefinieerd criterium. Hoewel het misschien een eenvoudige taak lijkt, is het efficiënt sorteren van grote hoeveelheden data een behoorlijke rekenuitdaging.
Een van de eenvoudigste en bekendste sorteeralgoritmen is het bubble sort-algoritme . Deze methode vergelijkt paren van aangrenzende elementen en verwisselt ze als ze in de verkeerde volgorde staan. Dit proces wordt herhaald totdat er geen verwisselingen meer nodig zijn, wat aangeeft dat de lijst gesorteerd is. Hoewel het bubble sort-algoritme gemakkelijk te begrijpen en te implementeren is, is het niet erg efficiënt voor grote datasets.
Voor grotere datasets worden meer geavanceerde algoritmen zoals quicksort gebruikt . Dit algoritme maakt gebruik van een "verdeel en heers"-strategie. Het kiest één element als "spil" en herschikt de andere elementen in de lijst zodanig dat elementen kleiner dan de spil links ervan komen te staan en grotere elementen rechts ervan. Vervolgens past het hetzelfde proces recursief toe op de resulterende sublijsten. Quicksort is over het algemeen sneller dan veel andere sorteeralgoritmen en wordt in de praktijk veelvuldig gebruikt.
Algoritme type: samenvoegen
Een ander belangrijk sorteeralgoritme is mergesort . Dit algoritme gebruikt ook de "verdeel en heers"-strategie, maar op een andere manier. Het verdeelt de lijst in tweeën, sorteert elke helft recursief en combineert vervolgens de gesorteerde helften. Mergesort is vooral handig bij het werken met gekoppelde datastructuren, zoals gekoppelde lijsten.
De keuze van het juiste sorteeralgoritme hangt af van verschillende factoren, zoals de grootte van de dataset, het type gegevens dat gesorteerd moet worden en de beschikbare computerbronnen. Voor zeer grote datasets kunnen bijvoorbeeld externe sorteeralgoritmen worden gebruikt die gegevens kunnen verwerken die niet in het hoofdgeheugen van de computer passen.
Sorteeralgoritmen zijn in veel praktische toepassingen van fundamenteel belang. Ze worden gebruikt in databases om gegevens te ordenen, in data-analysetoepassingen om informatie voor te bereiden op verwerking en zelfs in besturingssystemen om processen en bronnen te beheren.
Optimalisatiealgoritmen: de beste oplossing vinden
Optimalisatiealgoritmen vormen een fascinerende categorie algoritmen die zijn ontworpen om de best mogelijke oplossing voor een probleem te vinden binnen een gegeven reeks beperkingen. Deze algoritmen zijn cruciaal in uiteenlopende vakgebieden zoals techniek, economie, logistiek en kunstmatige intelligentie.
Stel je voor dat je een reis plant waarbij je meerdere steden aandoet. Wij willen de kortste route vinden, zodat we alle steden in één keer kunnen bezoeken en weer terug kunnen keren naar het beginpunt. Dit is het bekende "handelsreizigersprobleem", een klassiek voorbeeld van een optimalisatieprobleem. Hoewel het eenvoudig lijkt, groeit het aantal mogelijke routes exponentieel naarmate het aantal steden toeneemt. Hierdoor is het onmogelijk om alle opties te controleren.
Hier komen optimalisatiealgoritmen in beeld. Een van de bekendste benaderingen is het genetisch algoritme , geïnspireerd op biologische evolutie. Dit algoritme begint met een reeks willekeurige oplossingen en "evolueert" deze door generaties heen, waarbij bewerkingen worden toegepast die analoog zijn aan natuurlijke selectie, voortplanting en mutatie. De "fitste" oplossingen (in dit geval de kortste paden) hebben een grotere kans om zich voort te planten en hun eigenschappen door te geven aan de volgende generatie.
Algoritme type: gesimuleerd gloeialgoritme
Een andere populaire aanpak is het gesimuleerde gloeiproces (simulated annealing) , geïnspireerd op het metallurgische proces van gloeien. Dit algoritme begint met een willekeurige oplossing en onderzoekt vervolgens naburige oplossingen. Naarmate het vordert, neemt de kans op het accepteren van een slechtere oplossing geleidelijk af, vergelijkbaar met hoe een metaal langzaam afkoelt om een optimale kristalstructuur te vormen.
Optimalisatiealgoritmen zijn ook fundamenteel in machine learning. Gradient descent is bijvoorbeeld een veelgebruikt optimalisatiealgoritme voor het trainen van neurale netwerken. Dit algoritme past iteratief de parameters van het model aan om een foutfunctie te minimaliseren, waarbij het geleidelijk "afdaalt" naar het minimum van deze functie.
In de echte wereld worden optimalisatiealgoritmen gebruikt om een breed scala aan problemen op te lossen. Bedrijven gebruiken ze om hun toeleveringsketens te optimaliseren, luchtvaartmaatschappijen om efficiënte routes te plannen en zoekmachines om resultaten te rangschikken. Zelfs als we navigatie-apps gebruiken om de snelste route naar onze bestemming te vinden, maken we gebruik van optimalisatiealgoritmen.

Machine learning-algoritmen: kunstmatige intelligentie in actie
Machine learning-algoritmen behoren tot de meest opwindende en snelst ontwikkelende algoritmen van dit moment. Deze algoritmen vormen de kern van kunstmatige intelligentie (AI) en hebben het unieke vermogen om te "leren" van data zonder expliciet geprogrammeerd te worden voor elke specifieke taak.
Machine learning is gebaseerd op het idee dat systemen van informatie kunnen leren, patronen kunnen identificeren en beslissingen kunnen nemen met minimale menselijke tussenkomst. Dit is met name nuttig voor taken die te complex zijn om handmatig te programmeren of die aanpassing aan veranderende invoer vereisen.
Een van de meest basale, maar tegelijkertijd krachtige machine learning-algoritmen is lineaire regressie . Dit algoritme probeert de relatie tussen variabelen te modelleren door een rechte lijn te tekenen die het beste bij de data past. Het kan bijvoorbeeld worden gebruikt om de prijs van een huis te voorspellen op basis van de grootte, aan de hand van historische verkoopgegevens.
Beslissingsbomen
Een ander belangrijk type zijn beslissingsbomen , die beslissingen modelleren op basis van voorwaarden. Stel je een boom voor waarin elk knooppunt een vraag vertegenwoordigt (bijvoorbeeld: "Is de klant ouder dan 30 jaar?") en elke tak een mogelijk antwoord. Door de takken te volgen op basis van de kenmerken van een nieuw gegeven, komen we aan de bladeren van de boom tot een voorspelling.
Neurale netwerken zijn een geavanceerder type machine learning-algoritme, geïnspireerd op de structuur van het menselijk brein. Ze bestaan uit lagen van onderling verbonden "neuronen" die informatie verwerken en doorgeven. Diepe neurale netwerken, met veel lagen, vormen de basis van deep learning, dat een revolutie teweeg heeft gebracht in vakgebieden zoals computervisie en natuurlijke taalverwerking.
Reinforcement learning is een andere fascinerende benadering. In dit geval leert het algoritme beslissingen te nemen door interactie met zijn omgeving. Het ontvangt beloningen of straffen op basis van zijn acties en leert na verloop van tijd de beloningen te maximaliseren. Deze aanpak is gebruikt om AI te trainen die complexe spellen kan spelen of robots kan besturen.
Algoritmetype: Machine Learning-algoritmen
Machine learning-algoritmen veranderen veel vakgebieden. In de geneeskunde worden ze gebruikt om medische beelden te analyseren en bij het stellen van diagnoses. In de financiële wereld voorspellen ze markttrends en sporen ze fraude op. In e-commerce worden gepersonaliseerde aanbevelingssystemen aangestuurd. Zelfs op onze telefoons zijn spraakherkenning en voorspellende tekstvoorstellen voorbeelden van machine learning in actie.
Het is echter belangrijk om op te merken dat deze algoritmen niet onfeilbaar zijn. Hun prestaties zijn sterk afhankelijk van de kwaliteit en kwantiteit van de trainingsgegevens en kunnen vooroordelen in deze gegevens in stand houden. Bovendien werken veel algoritmen voor machinaal leren als ‘black boxes’, waardoor het moeilijk te begrijpen is hoe ze tot hun beslissingen komen.

Encryptie-algoritmen: informatie beschermen in het digitale tijdperk
In het informatietijdperk is gegevensbeveiliging een topprioriteit geworden. Hier komen encryptiealgoritmen om de hoek kijken – een cruciaal type algoritme dat is ontworpen om gevoelige informatie te beschermen tegen nieuwsgierige blikken. Deze algoritmen vormen de ruggengraat van moderne cyberbeveiliging en zorgen ervoor dat onze gegevens vertrouwelijk blijven wanneer ze via digitale netwerken worden verzonden.
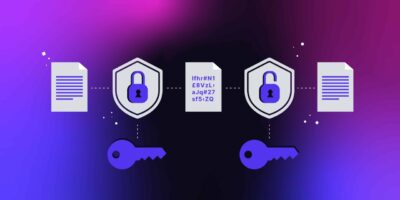
Versleutelingsalgoritmen werken door leesbare informatie (ook wel platte tekst genoemd) om te zetten in een onleesbare vorm (ook wel ciphertext genoemd) met behulp van een sleutel. Alleen degenen die over de juiste sleutel beschikken, kunnen het proces terugdraaien en toegang krijgen tot de oorspronkelijke informatie. Het is alsof u een digitale kluis heeft: alleen degenen met de juiste combinatie kunnen de kluis openen en de inhoud bekijken.
Een van de bekendste encryptiealgoritmen is AES (Advanced Encryption Standard) . Dit algoritme gebruikt één sleutel om datablokken van een vaste grootte te versleutelen. Het is zo veilig dat de Amerikaanse overheid het heeft goedgekeurd voor de bescherming van vertrouwelijke informatie. Elke keer dat u online iets koopt of uw internetbankiert, is de kans groot dat AES uw gegevens beveiligt.
Een ander belangrijk type is publieke-sleutelversleuteling , ook wel asymmetrische versleuteling genoemd. Dit systeem maakt gebruik van twee wiskundig verwante sleutels: een publieke sleutel en een privésleutel. De publieke sleutel kan vrij gedeeld worden en wordt gebruikt om berichten te versleutelen, terwijl de privésleutel geheim blijft en gebruikt wordt om ze te ontsleutelen. Het RSA-algoritme is een bekend voorbeeld van dit type versleuteling, dat veelvuldig gebruikt wordt in e-mailbeveiliging en in de digitale certificaten die HTTPS mogelijk maken.
End-to-end-versleuteling
End-to-end-encryptie is een bijzonder belangrijke toepassing voor de bescherming van digitale communicatie. Bij deze methode worden berichten versleuteld op het apparaat van de afzender en pas ontsleuteld op het apparaat van de ontvanger. Dit betekent dat zelfs de serviceprovider de inhoud niet kan lezen. Berichtenapps zoals WhatsApp en Signal gebruiken dit type encryptie om de privacy van de gesprekken van hun gebruikers te beschermen.
Het is belangrijk om te weten dat de sterkte van een encryptiealgoritme niet alleen afhangt van het wiskundige ontwerp, maar ook van de lengte van de gebruikte sleutel. Naarmate de rekenkracht toeneemt, worden kortere sleutels kwetsbaar voor brute force-aanvallen. Daarom worden beveiligingsnormen voortdurend verder ontwikkeld, waarbij langere sleutels en robuustere algoritmen worden aanbevolen.
Compressie-algoritmen: meer doen met minder
In een wereld waarin data exponentieel groeit, zijn compressiealgoritmen de onbezongen helden van het digitale tijdperk geworden. Deze algoritmen zijn essentieel voor het optimaliseren van dataopslag en -overdracht, waardoor we meer kunnen doen met minder ruimte en bandbreedte.
Gegevenscompressie wordt over het algemeen onderverdeeld in twee categorieën: verliesloze compressie en verliesgevende compressie. Met verliesloze compressie kunt u exact de originele gegevens herstellen, terwijl verliesgevende compressie een deel van de betrouwbaarheid opoffert om een grotere bestandsgrootte te bereiken.
Een van de bekendste verliesvrije compressiealgoritmen is het Huffman-algoritme . Deze methode kent kortere codes toe aan de symbolen die het vaakst in de data voorkomen. Stel je voor dat je een bericht schrijft en je kunt een enkele letter gebruiken om de meest voorkomende woorden, zoals 'de', weer te geven. Dat is in wezen het principe achter het Huffman-algoritme.
Soorten algoritmen: LZW (Lempel-Ziv-Welch)
Een ander populair lossless compressiealgoritme is LZW (Lempel-Ziv-Welch) . Dit algoritme zoekt naar herhalende patronen in de data en vervangt deze door kortere codes. Het is alsof je een aangepast woordenboek voor je dataset maakt. LZW wordt gebruikt in bestandsformaten zoals GIF en vormt de basis van veel compressieprogramma's zoals ZIP.
Op het gebied van verliesgevende compressie is het JPEG-algoritme waarschijnlijk het bekendste. JPEG wordt gebruikt om afbeeldingen te comprimeren en maakt gebruik van de beperkingen van het menselijk oog door minder waarneembare details te verwijderen. Het verdeelt de afbeelding in blokken, past een wiskundige transformatie toe (de discrete cosinustransformatie) en kwantificeert vervolgens de resultaten, waarbij de minst belangrijke informatie wordt weggegooid.
Voor audiocompressie is het MP3-algoritme revolutionair gebleken. Het maakt gebruik van een psychoakoestisch model om frequenties te elimineren die het menselijk oor niet kan waarnemen of die zouden worden gemaskeerd door luidere geluiden. Dit maakt een aanzienlijke reductie van de bestandsgrootte mogelijk met minimaal merkbaar kwaliteitsverlies.
In de videowereld zijn algoritmen zoals H.264 en zijn opvolger H.265 (HEVC) van fundamenteel belang. Deze algoritmen maken gebruik van geavanceerde technieken zoals bewegingsvoorspelling en blokcodering om videobeelden efficiënt te comprimeren. Zonder deze algoritmen zouden streamingdiensten zoals Netflix of YouTube vrijwel onmogelijk wereldwijd te implementeren zijn.
Compressiealgoritmen spelen ook een cruciale rol bij databaseoptimalisatie . Technieken zoals kolomcompressie stellen analytische databases in staat om grote hoeveelheden data sneller te verwerken, waardoor de hoeveelheid informatie die van de schijf moet worden gelezen, wordt verminderd.

Grafiekalgoritmen: de punten verbinden
Grafiekalgoritmen zijn een fascinerend type algoritme dat zich richt op de analyse en manipulatie van gegevensstructuren die grafieken worden genoemd. Een grafiek is eenvoudigweg een verzameling punten (ook wel knooppunten of hoekpunten genoemd) die met elkaar verbonden zijn door lijnen (ook wel randen genoemd). Hoewel het misschien een eenvoudig concept lijkt, zijn grafieken ontzettend veelzijdig en kunnen ze een breed scala aan relaties en systemen in de echte wereld modelleren.
Een van de bekendste grafenalgoritmen is het algoritme van Dijkstra , dat wordt gebruikt om het kortste pad tussen twee willekeurige punten in een graaf te vinden. Stel je voor dat je een roadtrip plant en de snelste route tussen twee steden wilt vinden. Het algoritme van Dijkstra kan je helpen die route te vinden, rekening houdend met de afstand tussen elk paar rechtstreeks verbonden steden.
Algoritme type: breedte-eerst-zoekalgoritme (BFS)
Een ander belangrijk algoritme is het breedte-eerst-zoekalgoritme (BFS) . Dit algoritme verkent een graaf niveau per niveau en bezoekt eerst alle aangrenzende knooppunten voordat het naar het volgende niveau gaat. Het is vergelijkbaar met het verkennen van een stamboom, waarbij je eerst al je broers en zussen bekijkt, dan al je neven en nichten, enzovoort. BFS is nuttig voor het vinden van het kortste pad in ongewogen grafen en wordt gebruikt in toepassingen zoals het vinden van verbindingen in sociale netwerken.
Het algoritme van Kruskal is essentieel voor het vinden van de minimale opspannende boom van een graaf. Dit is nuttig bij problemen zoals het ontwerpen van telecommunicatienetwerken, waarbij we alle punten met de laagst mogelijke totale kosten willen verbinden. Het algoritme werkt door iteratief de goedkoopste randen te selecteren die geen cyclus vormen.
In de wereld van sociale netwerken en netwerkanalyse is het PageRank-algoritme (oorspronkelijk ontwikkeld door Google) van groot belang. Dit algoritme kent aan elk knooppunt in een grafiek een belangrijkheidsscore toe op basis van de structuur van de verbindingen. In de context van het web helpt dit bij het bepalen van de relevantie van webpagina's voor zoekopdrachten.
Grafenalgoritmen zijn ook cruciaal in GPS-navigatiesystemen. Het A*-algoritme is een verbeterde versie van het algoritme van Dijkstra dat heuristieken gebruikt om sneller routes te vinden. Dit algoritme wordt veel gebruikt in kaartapplicaties en strategiespellen.
Grafiek-traversalalgoritmen
In de kunstmatige intelligentie zijn algoritmen voor het doorlopen van grafieken fundamenteel voor planning en probleemoplossing. Een schaakprogramma kan bijvoorbeeld grafiekalgoritmen gebruiken om mogelijke reeksen zetten te onderzoeken en de beste strategie te kiezen.
Grafiekalgoritmen hebben ook belangrijke toepassingen in de biologie en scheikunde. Ze worden bijvoorbeeld gebruikt om eiwitinteractienetwerken te analyseren, moleculaire structuren te modelleren en de verspreiding van ziekten in sociale netwerken te bestuderen.
In de zakenwereld worden grafiekalgoritmen gebruikt om leveringsnetwerken te analyseren, bezorgroutes te optimaliseren en financiële fraude op te sporen door transactiepatronen te analyseren.
Naarmate onze wereld steeds meer met elkaar verbonden raakt, wordt het belang van grafiekalgoritmen alleen maar groter. Deze algoritmen helpen ons bij het navigeren door en begrijpen van de complexe netwerken om ons heen, van het optimaliseren van transportnetwerken tot het analyseren van grote, onderling verbonden datasets.
Het is echter belangrijk om te beseffen dat veel grafiekgerelateerde problemen rekenkundig gezien moeilijk zijn. Naarmate de grafiek groter wordt, kan de tijd die nodig is om bepaalde problemen op te lossen exponentieel toenemen. Daarom wordt er nog steeds onderzoek gedaan naar de ontwikkeling van efficiëntere algoritmen en benaderingstechnieken die binnen een redelijke tijd ‘goed genoeg’ oplossingen kunnen bieden.

Samenvattend kunnen we zeggen dat grafiekalgoritmen een krachtig hulpmiddel zijn voor het modelleren en oplossen van problemen in een steeds meer verbonden wereld. Of we nu door een stad navigeren, sociale media analyseren of complexe biologische systemen bestuderen, deze algoritmen helpen ons de complexe relaties te begrijpen die onze wereld vormgeven.
Praktische toepassingen van verschillende soorten algoritmen
De verschillende soorten algoritmen die we hebben onderzocht, zijn niet zomaar wiskundige abstracties; het zijn krachtige instrumenten die ten grondslag liggen aan veel van de technologieën die we dagelijks gebruiken. Laten we eens kijken naar enkele praktische toepassingen van deze algoritmen in diverse vakgebieden:
- zoekmachines:Zoek- en rangschikkingsalgoritmen zijn essentieel voor zoekmachines zoals Google. Ze gebruiken indexeringsalgoritmen om informatie op het web te ordenen, zoekalgoritmen om relevante pagina's te vinden en rangschikkingsalgoritmen (zoals PageRank) om de resultaten te ordenen.
- Sociale netwerkenPlatforms als Facebook en Instagram gebruiken aanbevelingsalgoritmen (een soort machine learning-algoritme) om vrienden, content en zelfs advertenties voor te stellen. Ze gebruiken ook grafische algoritmen om verbindingen tussen gebruikers te analyseren.
- GPS navigatieKaartapplicaties zoals Google Maps gebruiken grafische algoritmen (zoals het algoritme van Dijkstra of A*) om de kortste of snelste route tussen twee punten te vinden.
- Data compressieCompressie-algoritmen zijn cruciaal bij gegevensoverdracht. Zo maken de afbeeldingsformaten JPEG en PNG, MP3-audioformaten en videoformaten zoals H.264 allemaal gebruik van geavanceerde compressiealgoritmen.
- cybersecurity:Encryptie-algoritmen vormen de ruggengraat van online beveiliging. Ze worden gebruikt bij banktransacties, beveiligde communicatie, wachtwoordopslag en nog veel meer.
- Spraak- en tekstherkenningVirtuele assistenten zoals Siri en Alexa gebruiken machine learning-algoritmen om menselijke spraak te herkennen en te verwerken.
- Medische diagnostiekMachine learning-algoritmen worden steeds vaker in de geneeskunde gebruikt om medische beelden te analyseren en te helpen bij de diagnose van ziekten.
- FinanzasHigh-frequency trading-algoritmen maken gebruik van verschillende soorten algoritmen om in fracties van een seconde koop- en verkoopbeslissingen te nemen. Machine learning-algoritmen worden ook gebruikt om fraude op te sporen en kredietrisico's te beoordelen.
- Games:Zoek- en optimalisatiealgoritmen zijn essentieel voor kunstmatige intelligentie in games, van schaken tot complexe real-time strategiespellen.
- Logistiek en transportLogistieke bedrijven gebruiken optimalisatiealgoritmen om efficiënte bezorgroutes te plannen en voorraden te beheren.
- Ontwerp en fabricageOptimalisatiealgoritmen worden bij productontwerp gebruikt om de meest efficiënte of aerodynamische vorm te vinden. Ze worden ook gebruikt bij de productieplanning om de efficiëntie te maximaliseren.
- WeersvoorspellingWeermodellen maken gebruik van complexe algoritmen om het weer te voorspellen. Daarbij worden enorme hoeveelheden data gecombineerd met simulaties op basis van natuurkundige principes.
- inhoud streamenPlatforms als Netflix en Spotify gebruiken aanbevelingsalgoritmen om hun gebruikers content voor te stellen, en compressiealgoritmen om audio en video efficiënt te streamen.
- Natuurlijke taalverwerkingMachinevertalers, zoals Google Translate, gebruiken algoritmen voor machinaal leren om hun vertalingen voortdurend te verbeteren.
- RoboticaRobots gebruiken bewegingsalgoritmen (gebaseerd op grafische algoritmen) om door hun omgeving te navigeren en taken uit te voeren.
Deze toepassingen laten zien hoe verschillende soorten algoritmen samenwerken in complexe systemen. Een smartphone gebruikt bijvoorbeeld encryptiealgoritmen om je gegevens te beschermen, compressiealgoritmen om afbeeldingen en video's op te slaan en te verzenden, machine learning-algoritmen voor spraak- en gezichtsherkenning en grafalgoritmen voor GPS-navigatie.
De alomtegenwoordigheid van deze algoritmes in ons dagelijks leven onderstreept hoe belangrijk het is om hun basisprincipes te begrijpen. Naarmate de technologie zich verder ontwikkelt, is de kans groot dat we steeds meer innovatieve en verrassende toepassingen van deze fundamentele algoritmen zullen zien.
De toekomst van algoritmen: trends en uitdagingen
Het vakgebied algoritmen ontwikkelt zich voortdurend, gedreven door technologische vooruitgang en de groeiende eisen van onze digitale samenleving. Hieronder volgen enkele van de belangrijkste trends en uitdagingen voor de toekomst van algoritmen.
- Kwantumalgoritmen:Met de ontwikkeling van quantum computing worden nieuwe typen algoritmen ontworpen die bepaalde problemen veel sneller kunnen oplossen dan klassieke algoritmen. Dit kan belangrijke gevolgen hebben op gebieden als cryptografie en optimalisatie.
- Deep learning-algoritmen:Er wordt verwacht dat de al krachtige deep learning-algoritmen nog geavanceerder worden, waardoor vooruitgang mogelijk wordt op het gebied van bijvoorbeeld computer vision, natuurlijke taalverwerking en robotica.
- Uitlegbare algoritmen:Naarmate AI-algoritmen complexer worden, is er een groeiende vraag naar “verklaarbare AI” – algoritmen die niet alleen beslissingen kunnen nemen, maar ook kunnen uitleggen hoe ze tot die beslissingen zijn gekomen.
- Ethische algoritmen:Nu algoritmen steeds meer invloed hebben op de maatschappij, ligt de nadruk op het ontwikkelen van algoritmen die eerlijk, transparant en respectvol zijn voor de privacy.
- Laagvermogenalgoritmen:Door de toename van het aantal IoT-apparaten en de zorgen over energieverbruik, is er een groeiende interesse in het ontwikkelen van energiezuinige algoritmen.
- Gefedereerde algoritmen:Deze algoritmen maken machinaal leren op gedecentraliseerde data mogelijk, wat kan helpen bij het aanpakken van privacyproblemen en het mogelijk maken van samenwerkend leren binnen organisaties.
- Zelf-adaptieve algoritmenEr worden algoritmen ontwikkeld die zich automatisch kunnen aanpassen aan verschillende omstandigheden of datasets, waardoor ze flexibeler en robuuster worden.
- Algoritmen geïnspireerd door biologie:We blijven leren van de natuur, met algoritmes die zijn geïnspireerd op biologische processen zoals evolutie, het gedrag van mierenkolonies en de werking van het menselijk brein.

Toekomstige uitdagingen zijn onder meer de behoefte aan efficiëntere algoritmen om exponentiële datagroei te verwerken, de zoektocht naar algoritmen die kunnen werken met beperkte of ruisende data en de ontwikkeling van algoritmen die in realtime kunnen werken op complexe systemen.
Naarmate we verder gaan, zullen we waarschijnlijk een toenemende convergentie zien van verschillende soorten algoritmen , waardoor hybride systemen ontstaan die de sterke punten van meerdere benaderingen combineren. Zo zouden we bijvoorbeeld algoritmen kunnen zien die deep learning combineren met symbolisch redeneren, of optimalisatiealgoritmen die technieken voor reinforcement learning integreren.
Uiteindelijk is de toekomst van algoritmen onlosmakelijk verbonden met de toekomst van computers en de maatschappij als geheel. Naarmate onze wereld complexer en meer met elkaar verbonden wordt, blijven algoritmen een cruciale rol spelen bij het navigeren en begrijpen van dit voortdurend veranderende landschap.