- AI forvandler filhåndtering ved å automatisere klassifisering, utvinne strategiske data og verifisere autentisitet.
- Teknologier som IDP, datasyn og NLP gjør det mulig å redusere menneskelige feil og optimalisere samsvar med regelverk i kritiske sektorer.
- Evnen til å analysere komplekse mønstre og oppdage sofistikerte svindelforsøk gjør dokumenthåndtering til et konkurransefortrinn og et sikkerhetsfortrinn.
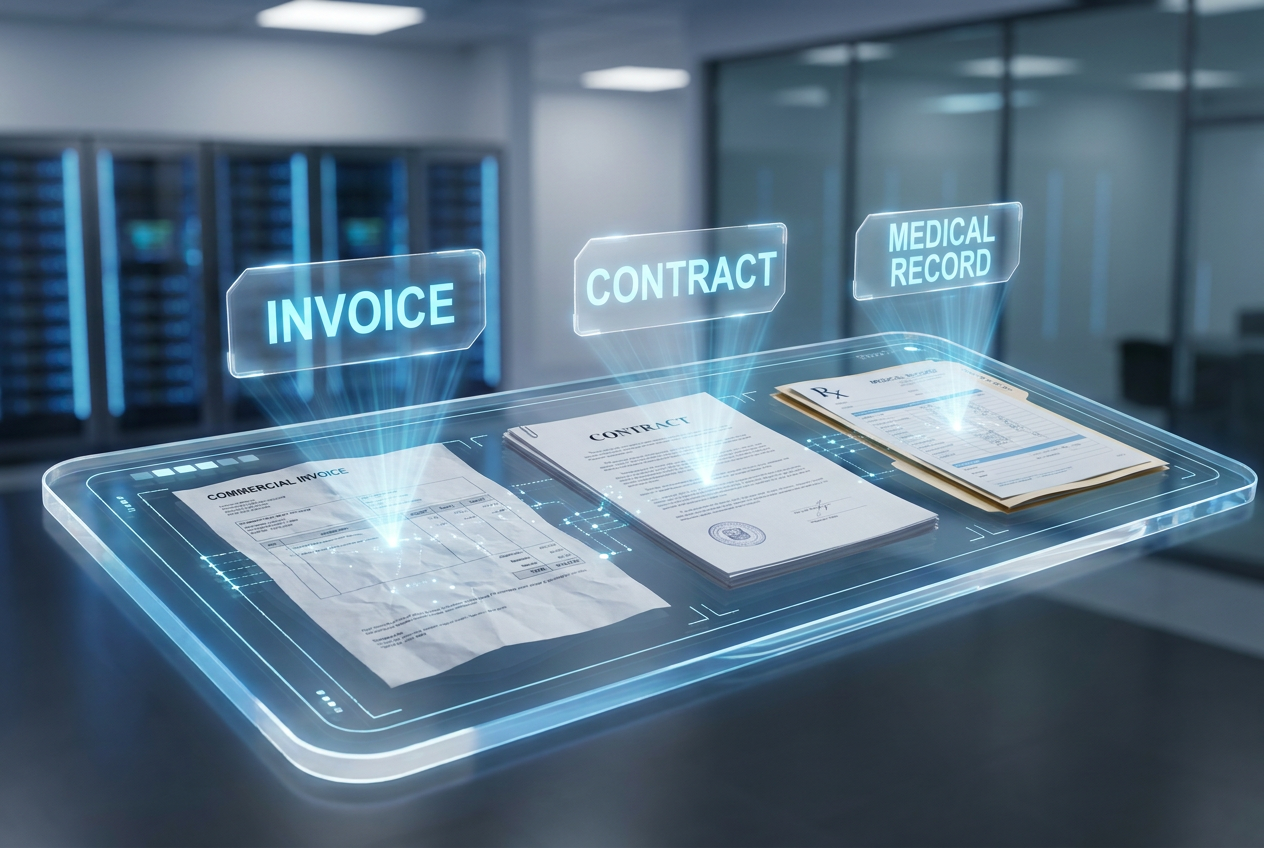
Informasjonshåndtering i bedrifter handler ikke lenger bare om å arkivere dokumenter eller lagre PDF-er i en delt mappe. Med dataeksplosjonen vi opplever, sitter organisasjoner fast i et hav av ustrukturerte filer , hvor det å finne spesifikk informasjon kan bli en skikkelig odyssé. Det er her kunstig intelligens innen arkivering og dokumenthåndtering kommer inn i bildet , og ikke bare hjelper til, men endrer spillereglene fullstendig ved å forvandle dokumentkaos til en strategisk ressurs.
Implementering av intelligente deteksjons- og analysesystemer gjør at bedrifter kan slutte å kaste bort tid på repeterende og kjedelige oppgaver. Det er ikke lenger behov for en ekspert til å manuelt lese hver kontrakt eller gjennomgå hver faktura. Nå, takket være maskinlæringsalgoritmer og datasyn , kan maskiner forstå hva som står i et dokument, dets formål og risikoene det kan medføre – alt på en brøkdel av et sekund og med en nøyaktighet som setter det menneskelige øyet i skam.

Intelligent dokumentklassifisering
Klassifisering av filer er mer enn bare å merke dem; det handler om å automatisk kategorisere forretningsdokumenter for å optimalisere ressurser og forhindre kritiske feil. Tidligere var denne prosessen en flaskehals som krevde kompleks programmering eller kjedelig manuell innsats. I dag skanner AI alle innkommende filer og plasserer dem i forhåndsdefinerte kategorier, og sender dem direkte til riktig arbeidsflyt for sømløs behandling.
For at dette skal fungere, bruker AI grunnleggende konsepter som enhetsidentifikasjon (navn, datoer eller numre), tildeling av risikokategorier (som offentlige eller konfidensielle dokumenter) og permanent merking. Sistnevnte er viktig for at andre sikkerhetsverktøy skal vite hvordan de skal håndtere filen. Videre lar kontekstualisering AI forstå dokumentet innenfor dets livssyklus, og oppnår over 95 % nøyaktighet ved å ikke bare stole på nøkkelord, men også på den faktiske betydningen av teksten.

Identitetsverifisering og svindelforebygging
Innen sikkerhetssektoren har AI tatt et kvantesprang innen verifisering av identitetsdokumenter, og blitt sentralt i KYC (Know Your Customer) og AML (Anti-hvitvaskings) prosesser. Ved hjelp av datasyn og bildeanalyse kan systemer oppdage nesten usynlige endringer, for eksempel manipulerte hologrammer, forfalskede vannmerker eller inkonsekvenser i mikrotrykk som ville gå ubemerket hen av folk flest.
Et av dens sterkeste sider er dens evne til å bekjempe digital svindel. AI analyserer avvik på pikselnivå for å oppdage Photoshop-retusjering eller ansiktsendringer (deepfakes). Videre sammenligner biometrisk ansiktsmatching dokumentbildet med en livevideo av brukeren, ved hjelp av passiv eller aktiv liveness-deteksjon for å sikre at personen som presenterer dokumentet er fysisk til stede og ikke bare en maske eller et fotografi.

Kjøreteknologier: IDP, NLP og OCR
Drivkraften bak alt dette er intelligent dokumentbehandling (IDP), som slår sammen flere teknologier for å utvinne reell verdi fra data. Avansert OCR leser ikke lenger bare bokstaver; den tolker kontekst for å sikre nøyaktighet , og konverterer bilder eller fysiske dokumenter til strukturerte data. Samtidig lar naturlig språkbehandling (NLP) maskinen forstå semantikken i teksten, noe som letter deteksjon av mønstre og avvik.
- Azure AI-søk: En tjeneste som muliggjør dype semantiske søk i enorme mengder ustrukturert data, ideell for juridiske eller HR-avdelinger.
- Språkmodeller (LLM-er): Verktøy som GPT-4, Claude eller Gemini kan oppsummere flere filer samtidig og svare på komplekse spørsmål om kildeinnholdet.
- Atferdsanalyse: Systemer som overvåker hvordan brukeren samhandler med dokumentet for å identifisere potensielle indikatorer på svindel.
Virkelige applikasjoner i ulike sektorer
Allsidigheten til disse verktøyene gjør at nesten alle sektorer kan dra nytte av dette. Innen finans automatiseres betalinger og lånevalidering gjennom datautvinning i sanntid. I juridisk sektor analyserer AI kontrakter for å fremheve risikable klausuler eller brudd, noe som effektiviserer eDiscovery-prosessen ved å filtrere tusenvis av dokumenter på sekunder.
Helsesektoren bruker kunstig intelligens til å digitalisere medisinske journaler og automatisere forsikringskrav , noe som forhindrer tap av sensitive data. I mellomtiden muliggjør integreringen av ERP- og HR-programvare automatisk klassifisering av CV-er etter ferdigheter innen HR for å finne den ideelle kandidaten uten å måtte gjennomgå hundrevis av profiler. Innen logistikk reduserer gjenkjenning av leveringssedler og fakturaer driftsfeil drastisk og optimaliserer forsyningskjeden.

Systemimplementering og utfordringer
For å implementere et slikt system er det ikke nok å bare installere programvare; du må identifisere smertepunkter, som tidkrevende prosesser. Det er avgjørende å definere målbare mål og sørge for at løsningen er skalerbar og overholder forskrifter som GDPR og CCPA, ettersom håndtering av personopplysninger er et sensitivt område.
Det går ikke helt knirkefritt, ettersom det finnes betydelige utfordringer. Skjevhet i treningsdata kan føre til urettferdige resultater for visse demografiske grupper, noe som gjør bruk av ulike datasett avgjørende. Videre utvikler svindlere stadig taktikkene sine, noe som tvinger AI-modeller til å gjennomgå kontinuerlig omskolering for å unngå å bli foreldet.
Integrering av disse funksjonene gjør at verktøy for forebygging av datatap (DLP) kan operere med kirurgisk presisjon. Hvis AI merker en fil som høyrisikokonfidensiell , kan sikkerhetssystemet automatisk blokkere at den kommer ut av bedriftsnettverket. Dette forvandler dokumenthåndtering til et ekte cybersikkerhetsskjold som garanterer fullstendig sporbarhet av sensitiv informasjon.
Konvergensen av semantisk analyse, datasyn og generative modeller skaper et økosystem der informasjon ikke lenger bare lagres, men aktivt administreres. Ved å automatisere filtypedeteksjon og validering reduserer organisasjoner ikke bare kostnader og tid, men beskytter også infrastrukturen sin mot svindel og styrker beslutningstaking basert på reelle, strukturerte data.
