- En kritisk sårbarhet i NLTK (CVE-2026-0848) tillater ekstern kjøring av kode og påvirker AI og systemer for behandling av naturlig språk.
- Vanlige Python-installasjons- og konfigurasjonsfeil (PATH, versjoner, miljøer) forårsaker importfeil og bibliotekproblemer.
- PyPI-økosystemet har blitt utsatt for utgivelsen av tusenvis av ondsinnede pakker, noe som fremhever risikoene i programvareforsyningskjeden.
- Kombinasjonen av gode sikkerhetsrutiner, bibliotekoppdateringer og grundig avhengighetshåndtering er avgjørende for å redusere disse risikoene.
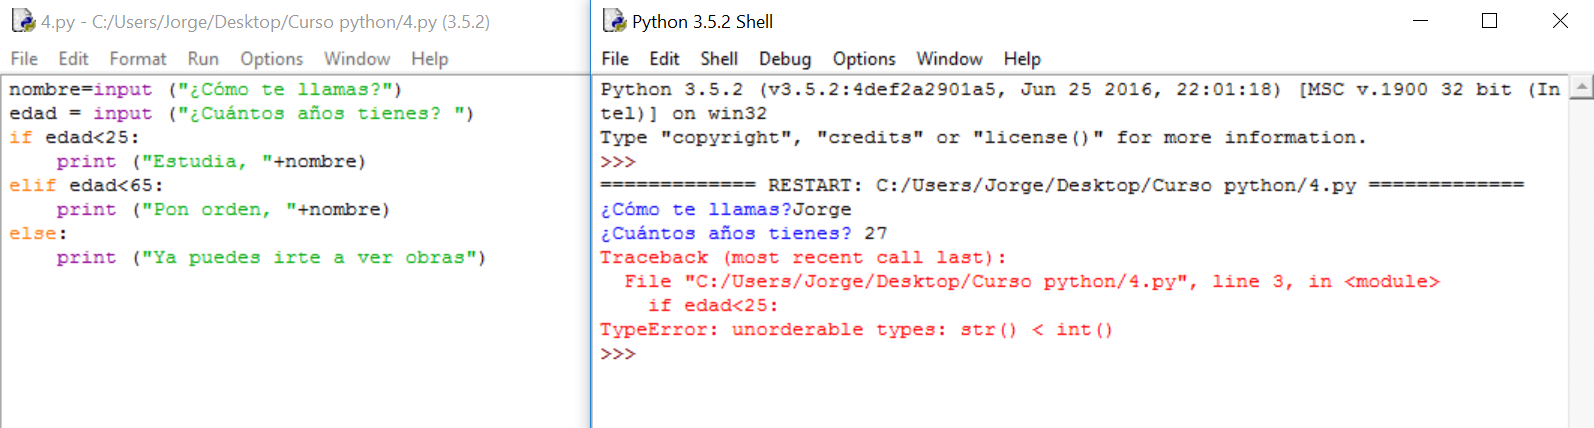
Når vi snakker om en feil i et Python-bibliotek , refererer vi ikke bare til en enkelt feil som ødelegger et skript: i mange tilfeller kan det bli et direkte inngangspunkt for angrep, frustrerende installasjonsproblemer eller til og med en stor hodepine på grunn av en enkel, dårlig skrevet avhengighet. Python er praktisk og allestedsnærværende, noe som betyr at enhver feil, uansett hvor liten den kan virke, kan ha en enorm innvirkning på AI, naturlig språkbehandling og webutviklingsprosjekter.
Nylig har det kommet frem tilfeller som spenner fra kritiske sårbarheter som involverer ekstern kodekjøring til ondsinnede pakker skjult i den offisielle Python-indeksen, og tilsynelatende absurde feil i biblioteker så uskyldige som en lysstyrkekontroller for skjermen. Alt dette tegner et bilde der det ikke er nok å bare installere en avhengighet og glemme den: vi må forstå hva som skjer under panseret, hvordan biblioteker er distribuert, og hvilke beste praksiser som kan redde oss fra alvorlige problemer.
Kritisk feil i NLTK: sårbarhet CVE-2026-0848
Et av de mest slående tilfellene er en kritisk feil i NLTK-biblioteket , velkjent i Python-økosystemet for bruk i oppgaver med naturlig språkbehandling . Under identifikatoren CVE-2026-0848 er det beskrevet en sårbarhet som direkte påvirker miljøer der tekstanalysesystemer brukes, og generelt applikasjoner basert på kunstig intelligens og NLP.
Denne sårbarheten tillater ekstern kodekjøring (RCE) , som betyr at en angriper kan tvinge sin egen kode til å kjøre vilkårlig på maskinen som kjører NLTK. Fra et cybersikkerhetsperspektiv er dette et av de mest alvorlige scenariene som kan oppstå i mye brukt programvare fordi det ikke bare lekker data: det kan gi effektiv kontroll over det kompromitterte systemet.
Det bekymringsfulle er at NLTK fortsatt er en standardavhengighet i utallige prosjekter, spesielt i en kontekst der AI har blitt integrert i alle slags tjenester. Dette betyr at mange produksjonsmiljøer, bærbare datamaskiner, API-er og maskinlæringsprosesser kan bli eksponert uten at utviklerne deres er fullt klar over den reelle risikoen denne sårbarheten utgjør.
Fremveksten av naturlig språkbehandling har ført til at vi er omgitt av applikasjoner som konstant forbruker tekst: virtuelle assistenter, klassifiseringssystemer, meningsanalyse og mye mer. I alle disse tilfellene kan en sårbarhet i et mye brukt Python-bibliotek bli et nøkkelelement i et angrep på forsyningskjeden eller et bredere infrastrukturbrudd.
Til syvende og sist er den eksplosive kombinasjonen av en RCE med et populært bibliotek som NLTK ikke bare et teknisk problem; det er også en påminnelse om at blind tillit til avhengigheter kan komme til en veldig høy pris hvis det ikke håndteres forsiktig.
Hvor ligger feilen, og hvordan utnyttes den?
Problemet i CVE-2026-0848 stammer fra hvordan NLTK håndterer visse eksterne ressurser . Under visse forhold kan biblioteket laste inn filer uten å validere opprinnelsen eller innholdet på riktig måte, noe som skaper en farlig sårbarhet i programmets dataflyt.
I praksis betyr dette at en fil som er manipulert av en angriper kan behandles som en legitim ressurs av NLTK. Hvis applikasjonen stoler på disse eksterne ressursene uten ekstra filtre, kan den skadelige koden som er innebygd i den filen, kjøres direkte på systemet som forbruker dataene.
Dette scenariet krever ikke noe dramatisk oppsett: i mange nåværende miljøer – som API-er, interaktive notatbøker, automatiserte analysetjenester eller maskinlæringsrørledninger – blir data innhentet og behandlet automatisk. Hvis en av kildene til disse dataene blir kompromittert, kan en angriper utnytte denne sårbarheten i Python-biblioteket til å injisere nyttelasten sin uten at noen trenger å trykke på en knapp eller utføre noe manuelt.
Videre er mange av disse systemene distribuert på servere med brede tillatelser og tilgang til sensitive ressurser . Dette betyr at en utnyttet RCE (Real-Time Enterprise) sårbarhet via NLTK (Network Linked Key) er mer enn bare en skrekk: den kan føre til datatyveri, modellmodifisering, sabotasje av interne prosesser eller implementering av bakdører for påfølgende angrep.
Kjernen i problemet er at ekstern ressursvalidering ofte overses når man jobber med biblioteker som «gjør alt for oss». Hvis vi antar at en avhengighet er trygg uten å revidere hvordan den håndterer ressursene vi mater den, risikerer vi å gjøre en nyttig funksjon om til en ideell angrepsvektor.
Hvorfor denne sårbarheten er så relevant i dag
Konteksten som CVE-2026-0848 opptrer i, gjør dens potensielle innvirkning spesielt sensitiv. Bruken av NLP- og kunstig intelligens-biblioteker har skutt i været, og NLTK, til tross for fremveksten av mer moderne alternativer, er fortsatt forankret i en rekke prosjekter, veiledninger, utdanningsdatabaser og produksjonssystemer.
Denne typen sårbarhet representerer en svært spesifikk risiko: at et klarert bibliotek kan bli et svakt ledd i et angrep i forsyningskjeden. Med andre ord kan angriperen ikke målrette applikasjonen vår direkte, men snarere en mellomliggende komponent som alle bruker, og som nesten ingen legger merke til før noe går galt.
Vi har sett dette før med andre økosystemer: JavaScript og npm, Ruby og RubyGems, og selvfølgelig PyPI i Python-økosystemet . Mønsteret gjentar seg: jo mer vi stoler på et repository og jo mer vi automatiserer pakkeinstallasjon, desto mer attraktivt blir det for de som ønsker å distribuere systemer i stor skala.
Det faktum at NLTK-sårbarheten tillater ekstern kjøring av kode mangedobler alvorlighetsgraden. Vi snakker ikke om en feil som «bare» lekker informasjon eller forårsaker krasj; vi har å gjøre med en vektor som kan gi full kontroll over den berørte maskinen , med alle implikasjonene det har i produksjonsmiljøer, datainfrastruktur eller bedriftsnettverk.
Derfor, selv om den umiddelbare løsningen innebærer oppdater NLTK til en korrigert versjonDen underliggende debatten har mer å gjøre med sikkerhetskultur og hvordan vi behandler avhengigheter: revisjon, isolering, begrensning av tillatelser og gjennomgang utover det enkle. pip install skifte.
Tiltak og beste praksis for feil i Python-biblioteket
Det første trinnet for å redusere et sikkerhetsproblem som CVE-2026-0848 er ganske enkelt: installer versjonen av NLTK som inkluderer oppdateringen , eller hvis det ikke fungerer, slutt å bruke berørte versjoner. Å holde bibliotekene oppdaterte er minimumstiltaket for å unngå å unødvendig eksponere deg for allerede dokumenterte sårbarheter.
Det er imidlertid ikke nok å stoppe der. Denne typen hendelser understreker behovet for å gjennomgå hvordan vi håndterer eksterne ressurser i applikasjonene våre. Når filer, modeller, korpus eller andre typer data utenfra lastes inn, er det viktig å validere opprinnelsen, formatet og innholdet deres, slik at angriperens handlingsrom minimeres.
Et annet anbefalt beskyttelseslag er å kjøre de mest sensitive prosessene i isolerte miljøer, for eksempel containere eller virtuelle maskiner . Hvis koden som behandler tekst og NLP-modeller kjører i et miljø med svært begrensede tillatelser, vil selv et RCE-angrep ha en mye mer kontrollert innvirkning, uten direkte tilgang til resten av infrastrukturen.
Det bidrar også til å strengt begrense gyldige datakilder og kanalene som data når systemene våre gjennom. Jo tydeligere det er hvilke API-er, ruter eller databaser som er autorisert, desto vanskeligere vil det være for en ondsinnet ressurs å infiltrere dataflyten uten å vekke mistanke eller utløse sikkerhetsvarsler.
Til slutt er det lurt å integrere disse tiltakene i en bredere sikkerhetstilnærming gjennom hele utviklingssyklusen : statisk kodeanalyse, avhengighetskontroller, regelmessige pakkerevisjoner og overvåking av kjente sårbarheter i bibliotekene vi bruker daglig. Målet er ikke å bli besatt, men heller å unngå å operere blindt.
Typiske feil når du arbeider med Python-biblioteker: tilfellet med screen_brightness_control
Ikke alle problemer relatert til en python bibliotek Dette er kritiske sårbarheter. Vi støter ofte på mye mer trivielle feil som likevel kan stoppe et prosjekt eller føre til at vi kaster bort timer unødvendig. Et enkelt eksempel er tilfellet med biblioteket. screen_brightness_control, brukt til å administrere skjermens lysstyrke fra Python.
En utvikler som jobber med et analyseprogram på datamaskinen sin, ved hjelp av Visual Studio Code, kom han over Pylances melding: "Import av «screen_brightness_control» kunne ikke løses" rett på linjen import screen_brightness_control as sbcDette ble kopiert ordrett fra den offisielle dokumentasjonen. Python og selve biblioteket var oppdatert, men utviklingsmiljøet insisterte på at modulen ikke eksisterte.
Denne typen feil er vanligvis relatert til problemer som feilkonfigurerte virtuelle miljøer , installasjoner i stier som er forskjellige fra de som brukes av tolken, eller avvik mellom Python-versjonen som kjører koden og versjonen som ble brukt til å installere pakken. Selv om dette tilfellet endte opp med å løse seg "magisk" uten at noen visste hva som hadde endret seg, skyldtes det mest sannsynlig en innstilling for miljø eller sti.
Når du står overfor et slikt problem, er det lurt å sjekke grunnleggende aspekter som hvilken Python-tolk Visual Studio Code bruker, og om pakken faktisk er installert i det spesifikke miljøet ved hjelp av pip show screen_brightness_controleller hvis det finnes flere versjoner av Python samtidig på samme system.
Utover anekdoten illustrerer disse feilene at selv om Python er lett å lære , kan samspillet mellom IDE-er, virtuelle miljøer og pakkebehandlere generere forvirrende feil. Og fremfor alt, at problemet ofte verken ligger i koden eller biblioteket, men i miljøkonfigurasjonen.
Vanlige Python-installasjonsfeil som påvirker biblioteker
Selv før de når punktet med å installere et bibliotek, støter mange brukere på problemer med selve Python-installasjonen , som deretter påvirker bruken av eventuelle tilleggspakker. Disse feilene er spesielt vanlige blant de som begynner å programmere, og de møtes med kryptiske meldinger så snart de åpner terminalen.
Python.exe ble ikke funnet
En av de vanligste feilene i Windows er meldingen om at «python.exe» ikke finnes når man prøver å kjøre Python fra kommandolinjen. Dette skyldes vanligvis at systemet ikke har den kjørbare banen inkludert i PATH-miljøvariabelen, slik at det ikke vet hvor det skal lete etter tolken.
Løsningen er gjennom legg til Python-installasjonsstien manuelt til systemets miljøvariabler. For å gjøre dette, gå til systemets avanserte innstillinger, åpne delen «Miljøvariabler», finn PATH-variabelen i systemvariabeldelen og rediger den for å inkludere katalogen der den er plassert. python.exe (for eksempel C:\\PythonXX\\, og erstatter «XX» med den tilsvarende versjonen).
Når endringene er lagret, er det viktig å lukke og åpne kommandolinjen på nytt for at den nye PATH-verdien skal tre i kraft. Fra da av skal systemet kunne finne den kjørbare Python-filen når den tilsvarende kommandoen kjøres.
Forvirrende feilmeldinger under installasjon
Et annet vanlig problem er de vage feilmeldingene som vises under Python-installasjon eller når du prøver å konfigurere bestemte komponenter. Noen ganger skyldes disse avhengigheter i operativsystemet, andre ganger utilstrekkelige tillatelser eller konflikter med feil avinstallerte tidligere versjoner.
Når feilen ikke er åpenbar, er det klokeste å konsultere den offisielle Python-dokumentasjonen , som dekker en rekke vanlige tilfeller, ofte stilte spørsmål og trinnvise løsninger. Å gå direkte til forum uten først å gjennomgå denne informasjonen kan komplisere diagnosen ytterligere.
Det er også viktig å bekrefte at du laster ned riktig installasjonsprogram fra det offisielle Python-nettstedet og ikke fra tredjepartskilder, da bruk av uoffisielle installasjonsprogrammer kan føre til kompatibilitetsproblemer, merkelige versjoner eller til og med sikkerhetsrisikoer.
Upassende Python-versjon
Det er ganske vanlig at man trenger en bestemt versjon av Python når man følger en veiledning eller jobber med et spesifikt prosjekt , og uten at man er klar over det, installeres en annen versjon. Dette kan føre til inkompatibiliteter med visse biblioteker eller skript som bruker funksjoner eller syntaks som er introdusert eller fjernet mellom versjoner.
For å minimere disse problemene er det lurt spesifiser den nøyaktige versjonen som du vil bruke når du oppretter miljøer eller kjører kommandoer. Hvis du for eksempel trenger å jobbe med Python 3.8, kan du opprette et virtuelt miljø med noe sånt som python3.8 -m venv mi_entornodermed sikres at bibliotekene er installert og kjører på riktig versjon.
I miljøer der flere versjoner eksisterer samtidig (for eksempel Python 3.8 og 3.11), er det viktig å være tydelig på hvilken binærfil som brukes til enhver tid, enten det er gjennom aliaser, versjonsbehandlere eller verktøy som er spesifikke for distribusjonen som brukes.
Feil konfigurert sti
Riktig konfigurasjon av banen (PATH) påvirker ikke bare den viktigste kjørbare Python-filen, men også hvordan systemet finner skript, tilleggsverktøy og binærfiler som er installert med bibliotekene.
Hvis PATH-variabelen endres uforsiktig, eller Python installeres på ukonvensjonelle steder uten å oppdatere den, kan det oppstå tilsynelatende uforklarlige problemer: kommandoer som slutter å virke, biblioteker som «forsvinner», eller skript som kjører med andre versjoner enn de forventede.
For å sjekke den aktive banen kan du i Windows starte en echo %PATH% Fra kommandolinjen, sjekk om Python-installasjonsmappen er inkludert. På andre systemer, for eksempel Linux eller macOS, bruk echo $PATHDet er viktig å justere disse stiene konsekvent for å sikre at Python og bibliotekene oppfører seg som de skal.
I et profesjonelt miljø er det også ofte lurt å stole på virtuelle miljøer og versjonshåndteringsverktøy for å innkapsle avhengigheter og ikke avhenge så mye av den globale systemkonfigurasjonen.
Ondsinnede pakker i PyPI og angrep i forsyningskjeden
Utover installasjonsfeil og isolerte sårbarheter, finnes det et grunnleggende problem som påvirker hele økosystemet: tilliten til pakkebehandlere som PyPI, npm og RubyGems. Python er intet unntak, og de siste årene har tusenvis av ondsinnede pakker blitt lagt til i den offisielle indeksen.
I én bestemt hendelse ble Python Package Index (PyPI) tvunget til å fjerne omtrent 3.653 skadelige pakker kort tid etter at et sikkerhetsproblem knyttet til dem ble identifisert. Disse pakkene inkluderte uautoriserte versjoner av biblioteker som CuPy og andre legitime prosjekter som hadde blitt kopiert eller etterlignet.
Problemet stammer fra det faktum at mange utviklere bruker PyPI som en direkte kilde for å integrere tredjepartsbiblioteker i prosjektene sine, ofte uten å sjekke koden de importerer grundig. Systemet er i stor grad avhengig av tillit til bibliotekforfatterne og selve depotet, og denne tilliten kan utnyttes av ondsinnede aktører.
Denne typen angrep er ofte avhengig av teknikker som TyposquattingDette innebærer å laste opp pakker med navn som ligner veldig på navnene til populære biblioteker, og utnytte skrivefeil eller forvirring i navnene. Hvis en utvikler skriver identifikatoren feil i pip installDu kan ende opp med å installere en ødelagt versjon uten å være klar over det.
Blant de skadelige pakkene som ble oppdaget i den operasjonen ble funnet falske versjoner av CupySom cupy-cuda112 (CuPy for CUDA 11.2), som ble lastet opp 25. februar 2021 og fjernet dagen etter takket være responspolicyen etablert i PEP 541. I dette tilfellet slo en av de offisielle prosjektlederne, Kenichi Maehashi, alarm da problemet ble oppdaget.
Motivasjoner og reelle effekter av disse angrepene
Det interessante med denne hendelsen er at kontoen som var ansvarlig for å laste opp de mistenkelige pakkene brukte navnet «RemindSupplyChainRisks» , noe som tyder på at målet kan være mer å rette oppmerksomheten mot sikkerhetsrisikoer i utviklingskjeden enn å utføre et storstilt, skadelig angrep.
Kommentarene til noen av disse pakkene inneholdt til og med en melding som advarte om at formålet var å øke bevisstheten om den høye risikoen ved å blindt stole på programvarens forsyningskjede. Likevel var de sanne intensjonene ikke helt klare, delvis fordi forfatteren forble anonym og la igjen en inaktiv e-postadresse.
Ee W. Durbin III, infrastrukturdirektøren i Python Software Foundation, uttrykte noen tvil om nytten av å suspendere den problematiske kontoen, og bemerket at det er trivielt å opprette en ny profil og fortsette å laste opp pakker under en annen identitet. Dette fremhever en av de største utfordringene med offentlige arkiver: den begrensede kontrollen over hvem som publiserer hva.
Den ondsinnede kodens egen oppførsel i pakken cupy-cuda112 Det var heller ikke spesielt sofistikert: i utgangspunktet sendte en GET-forespørsel til en IP-adresse i Tokyo (101.32.99.28) inkludert pakkenavnet. Den utførte ikke destruktive handlinger eller distribuerte mer forseggjorte nyttelaster, noe som forsterker hypotesen om at det kan være mer et "konseptbevis" enn et fullstendig ondsinnet angrep.
Likevel gjør det faktum at noen kan laste opp tusenvis av pakker samtidig, at disse pakkene kan lastes ned av legitime brukere, og at koden kan kjøres på systemene deres, det klart at Python-økosystemets angrepsflate er svært bred. Og at enhver feil, enten det er i design, tilsyn eller sikkerhetskultur, kan ha betydelige konsekvenser.
Praktiske leksjoner for utviklere og tekniske team
Både kritiske sårbarheter som CVE-2026-0848 i NLTK, samt skadelige pakker oppdaget i PyPI eller tilsynelatende harmløse installasjonsfeil, peker i samme retning: det er ikke nok å vite hvordan man programmerer i Python , man må også forstå hvordan koden er distribuert, hvordan avhengigheter er installert og hvilke implikasjoner hver designbeslutning har.
For ethvert team som jobber profesjonelt med Python, er det viktig å etablere klare retningslinjer for avhengighetshåndtering : gjennomgå hvilke biblioteker som er tillatt, sjekk opprinnelsen deres, overvåk for kjente sårbarheter og unngå å innlemme pakker fra ukjente forfattere uten en minimumskoderevisjon.
Det er også viktig å integrere sikkerhet i programvareutviklingens livssyklus : fra designfasen til distribusjon, inkludert automatisert testing for å oppdage usikre versjoner, analyse av programvaresammensetning (SCA) og periodiske gjennomganger av kjøretidsmiljøer.
På et individuelt nivå er det verdt å ta seg tid til å forstå grundig hvordan pip, virtuelle miljøer og miljøvariabler fungerer . Dette grunnlaget reduserer sannsynligheten for å støte på frustrerende feil som uløste importer, versjonskonflikter eller fantominstallasjoner som ingen kan identifisere.
I et landskap der Python brukes til alt fra små personlige skript til forretningskritiske AI-systemer, produksjonsbackends og forretningsanalyseverktøy, er det å anta at biblioteker «bare fungerer» uten å tenke på sikkerhet i økende grad en luksus vi ikke lenger har råd til. En mer forsiktig og bevisst tilnærming til installasjon, oppdatering og kontroll av avhengigheter kan være forskjellen mellom et robust miljø og et system fullt av bakdører som ingen vet om.

Å ta i bruk denne tankegangen bidrar ikke bare til å unngå sårbarheter eller skadelig programvare, men forbedrer også den generelle kvaliteten på prosjekter: færre merkelige feil, mindre tid kastet bort på ødelagte installasjoner og mer trygghet for at koden som kjører på serverne våre gjør akkurat det den skal gjøre, og ikke noe mer.