- Cache-koherens sikrer at alle kopier av de samme dataene i forskjellige cacher og i RAM forblir konsistente på flerkjernesystemer.
- Hurtigbufferhierarkiet med et delt siste nivå forenkler konsistenskontroll og reduserer direkte tilgang til hovedminnet.
- Koherensprotokoller bruker strategier for ugyldiggjøring av kopier eller oppdatering, støttet av tilstander og kontrollbiter per hurtigbufferlinje.
- Kompilatoren og operativsystemet kan supplere maskinvarekonsistens ved å sette inn instruksjoner og konfigurere minne for kritiske perioder.
Når du ser på et diagram over en hvilken som helst moderne flerkjerneprosessor, vises alltid det samme mønsteret: flere kjerner, hver med sine egne nærliggende cacher, og en delt siste-nivå-cache som fungerer som et fellespunkt før den når RAM. Denne ordningen er ikke tilfeldig eller et innfall fra designerne, men en direkte respons på et kritisk problem i parallelle systemer: cache-koherens.
Uten en robust konsistensmekanisme kan hver kjerne ende opp med å jobbe med en annen og utdatert versjon av de samme dataene i minnet , noe som i et virkelig program fører til subtile feil, uforutsigbare feil og til og med systemkrasj. Derfor er det viktig å forstå hvordan denne konsistensen opprettholdes – både på maskinvare- og programvarenivå – for å forstå ytelsen og stabiliteten til moderne flerkjerne-CPUer.
Hva er cache-koherens: terminalmetaforen

Tenk deg flere personer som sitter foran forskjellige terminaler, og alle redigerer det samme dokumentet som er lagret på en sentral server . Hver skjerm viser en kopi av filen, og eventuelle endringer én person gjør forventes å gjenspeiles umiddelbart på alle andres skjermer.
For at dette skal fungere, må det finnes en synkroniseringsmekanisme som formidler dokumentendringer til alle terminaler, slik at alle alltid ser den samme versjonen. Så lenge dette systemet fungerer, er alt i orden: den som endrer teksten vet at alle andre vil se den nye versjonen nesten umiddelbart.
Tenk deg nå at synkroniseringssystemet plutselig svikter. Hver person fortsetter å redigere, overbevist om at de jobber med det delte dokumentet, men i virkeligheten sitter hver terminal igjen med sin egen frakoblede lokale kopi . Fra det øyeblikket når ikke endringer gjort av én person de andre, og dokumentet begynner å divergere ukontrollert.
Innen databehandling er det nettopp dette som ville skjedd hvis CPU-en manglet en pålitelig konsistensprotokoll: én kjerne endrer data i minnet, men de andre kjernene fortsetter å lese en eldre versjon fra sine private hurtigbuffere . Dette skaper grobunn for alvorlige logiske feil, ødelagte data og feilsøkingsatferd.
Cache-koherens er derfor settet med mekanismer som sikrer at alle kopier av de samme dataene fordelt på tvers av de forskjellige cachene og RAM-en opprettholder en konsistent tilstand i et flerkjernesystem . Selv om det finnes flere kopier, må systemet oppføre seg "som om" det bare fantes én.
Hurtigbuffere og minnehierarki i en flerkjerners CPU
CPU-cacher er små, veldig raske minner som inneholder kopier av ofte brukte RAM-biter . Når prosessoren kjører kode, prøver den å lese fra og skrive til cachen i stedet for kontinuerlig å få tilgang til (relativt treg) RAM, noe som reduserer latensen drastisk.
Trikset er selvfølgelig at mellombuffere ikke lagrer den "offisielle versjonen" av dataene, men bare en midlertidig kopi . I følge terminalmetaforen ville RAM være dokumentet på serveren, mens mellombuffere ville være de lokale skjermbildene som viser kopier av bestemte deler av filen.
I en flerkjerne-CPU blir designet mer komplekst fordi hver kjerne vanligvis har sine egne private nivå 1 (L1) og til og med nivå 2 (L2) cacher . Over disse legges det til en delt nivå 3-cache (for eksempel), plassert mellom kjernene og minnekontrolleren som gir tilgang til RAM.
Denne delte hurtigbufferen introduseres fordi det å la alle kjerner få direkte og intensiv tilgang til RAM ville føre til tilgangskonflikter, strid på minnebussen og et betydelig ytelsesfall . Siste-nivå-hurtigbufferen fungerer som en felles "buffer" som reduserer RAM-tilgang og sentraliserer mye av datatrafikken.
Videre organiserer mange arkitekturer hurtigbuffere inkluderende: linjer lagret i nivåer nær prosessoren finnes også i høyere nivåer i hierarkiet . Det vil si at en linje som vises i L1 også finnes i L2 og dermed i L3. Dette har en svært nyttig konsekvens for konsistens: det er nok å bare oppdatere hurtigbufferen på laveste nivå riktig for å kontrollere tilstanden til de andre nivåene uten å måtte bruke RAM hele tiden.
Hvorfor delt mellomlagring på siste nivå er nøkkelen til konsistens
Uten denne globale hurtigbufferen på siste nivå, måtte hver kjerne sjekke konsistens direkte mot hovedminnet . Hver gang en minnelinje i en privat hurtigbuffer ble endret, ville det være nødvendig å sjekke om andre kjerner har en kopi av den samme linjen, og i så fall oppdatere eller ugyldiggjøre den overalt.
I et system med mange kjerner ville denne arbeidsmengden med kontroller resultere i et stort antall transaksjoner til RAM , noe som ville oppheve mye av fordelen med å ha raske hurtigbuffere. Ved å plassere en delt hurtigbuffer mellom kjernene og minnet, kan CPU-en konsentrere koherenskontrollen på ett mellomliggende sted.
I mange implementeringer inneholder hurtigbufferne på høyere nivåer (lenger fra prosessoren) kopier av linjene som finnes i nivåene nærmere kjernen . Med denne organiseringen trenger koherensprotokollen bare å sørge for at det siste nivået er synkronisert med hovedminnet, og at de private nivåene til hver kjerne er synkronisert med nivået rett over det.
Dette kan visualiseres som en slags russisk hekkende dukke: den tredje nivå-cachen inneholder innholdet fra det andre og første nivået , det andre nivået inneholder sitt eget innhold og innholdet fra det første nivået, og det første nivået kjenner bare sine egne linjer. Ved å kontrollere den "store dukken" (det siste nivået) kan systemet dermed koordinere resten mer effektivt.
Resultatet er at det blir mer økonomisk å opprettholde konsistens når det gjelder design og minnetrafikk . I stedet for å tvinge hver kjerne til å stadig håndtere RAM, opererer protokollen på den delte hurtigbufferen og derfra styrer hvilke linjer som skal oppdateres eller ugyldiggjøres i de private hurtigbufferne.
Oppdateringsmetoder: ugyldiggjøring og oppdatering av kopier
Et kritisk problem oppstår når to eller flere kjerner nesten samtidig ønsker å få tilgang til den samme datalinjen som replikeres på tvers av flere hurtigbuffere . I denne sammenhengen bruker konsistenssystemer vanligvis to grunnleggende strategier når de håndterer skrivinger.
Den første metoden er basert på ugyldiggjøring. Når en kjerne trenger å skrive til en spesifikk hurtigbufferlinje, ugyldiggjør protokollen eventuelle kopier av den samme linjen som kan finnes i de andre hurtigbufferne . Bare kjernen som skal skrive, holder linjen i en lese- og skriveaktivert tilstand; de andre, hvis de vil bruke disse dataene igjen, må laste linjen på nytt fra det høyere nivået (eller fra minnet) med den oppdaterte versjonen.
Den andre strategien innebærer oppdatering. I dette tilfellet, når en kjerne endrer en linje, prøver systemet å automatisk overføre det nye innholdet til eksisterende kopier i de andre mellombufferne . På denne måten mottar alle mellombufferne som lagret den linjen den oppdaterte versjonen uten å måtte ugyldiggjøre den og laste den inn på nytt senere.
Hver tilnærming har sine fordeler og ulemper. Ugyldiggjøring er vanligvis mer effektivt når skrivingen skjer ofte, fordi det unngår å mette minnesystemet med oppdateringer som andre kjerner kanskje ikke trenger umiddelbart. Omvendt kan oppdatering være fordelaktig når mange kjerner ofte leser de samme dataene som endres relativt sjelden , ettersom det reduserer ventetiden ved at man ikke trenger å laste inn linjen på nytt etter hver ugyldiggjøring.
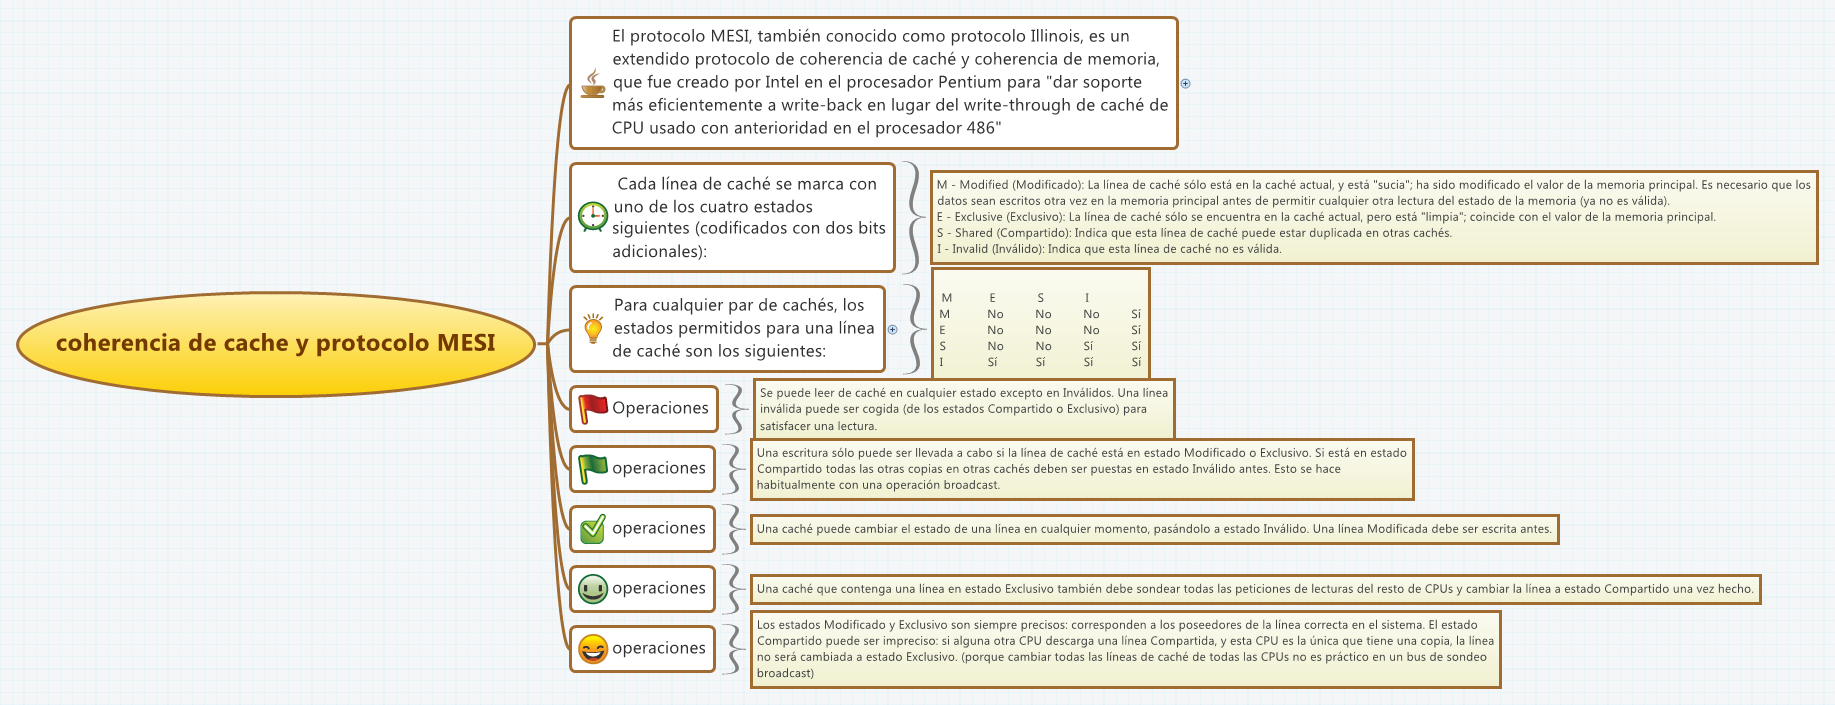
I begge tilfeller bruker begge metodene tilleggstilstander og kontrollbiter i hurtigbufferlinjene. Hver linje inneholder vanligvis informasjon om hvorvidt innholdet samsvarer med innholdet i RAM , og om den er delt, modifisert, eksklusiv, reservert osv., avhengig av den spesifikke protokollen (MESI, MOESI, MSI osv.). Dette lar maskinvaren ta raske avgjørelser om hva den skal gjøre når en lese- eller skriveoperasjon skjer på en allerede replikert linje.
Sjekker konsistens mellom hurtigbuffer og minne
Å direkte verifisere konsistensen mellom alle hurtigbuffernivåene til en CPU eller GPU og hovedminnet ville være en enorm oppgave, både når det gjelder designkompleksitet og ytelseskostnader. Derfor organiserer moderne systemer denne verifiseringen hierarkisk.
Cachene nærmest prosessoren (L1, L2) er vanligvis ikke koblet direkte til RAM, men til neste nivå av cachen. Dette betyr at konsistensen ikke valideres mot hovedminnet på hvert nivå, men snarere mot det umiddelbart høyere nivået . Dette reduserer antall RAM-tilganger og forenkler logikken som kreves på lavere nivåer.
Til syvende og sist utføres sammenligningen mellom hurtigbufferinnhold og RAM-innhold mellom hurtigbufferen på siste nivå og hovedminnet . Hvis dette siste nivået opprettholder en korrekt og konsistent tilstand, og hvert lavere nivå opprettholder sin konsistens med det over, forblir hele hierarkiet konsistent uten at man må sjekke hver linje mot RAM gjentatte ganger.
Når en kjerne skriver til en hurtigbufferlinje og endrer dataene sine, markeres tilstanden til den linjen for å indikere at den ikke lenger samsvarer nøyaktig med kopien som er lagret i minnet . Derfra koordinerer protokollen oppdateringen: den markerer de tilsvarende kopiene i andre hurtigbuffere som reservert eller ugyldig, og når det er aktuelt, skriver den det nye innholdet til den tilhørende hovedminnelinjen.
Denne kaskadeorganiseringen lar endringer forplante seg gradvis fra kjernen, som oppdaterer dataene, til hovedminnet, og passerer gjennom hvert hurtigbuffernivå på en kontrollert måte. På denne måten blir ikke det å opprettholde konsistens en uoverstigelig flaskehals for prosessoren.
Maskinvarekoherens kontra programvarekoherens
Så langt har vi diskutert konsistensmekanismer som hovedsakelig implementeres i maskinvare: protokoller, statusbiter, delte hurtigbuffere osv. Det finnes imidlertid en annen tilnærming som søker å flytte noe av denne kompleksiteten til programvare , nærmere bestemt til kompilatoren og operativsystemet.
Programvarebaserte konsistensordninger forsøker å redusere behovet for ytterligere logikk på brikken ved å analysere kode og ta kompileringstidsbeslutninger . Tanken er at hvis kompilatoren kan utlede når og hvordan visse delte data blir tilgjengelige, kan den i mange tilfeller forhindre at dataene blir mellomlagret eller eksplisitt administrere synligheten deres.
Denne tilnærmingen har en klar fordel: deler av arbeidsmengden skifter fra løsning under kjøring til løsning under kompilering . I stedet for at maskinvaren oppdager og håndterer alle konflikter underveis, prøver kompilatoren å forutse dem og generere kode som unngår farlige situasjoner.
Ulempen er at statisk kodeanalyse er begrenset, og derfor har kompilatorer en tendens til å være konservative . Dette betyr at de, for å unngå å bryte konsistensen, ofte tar avgjørelser som reduserer effektiviteten til mellomlagring. Hvis de mistenker at noen data kan være problematiske, forhindrer de ofte at de mellomlagres eller tvinger frem synkroniseringer oftere enn strengt nødvendig.
Selv om disse programvareskjemaene er attraktive i teorien, spesielt for å forenkle maskinvaredesign, erstatter de i praksis ikke koherensstøtten som er integrert i selve CPU-en , men komplementerer den heller i noen spesifikke scenarier.
Kompilatorens rolle i hurtigbufferkonsistens
Et sentralt element i programvarebaserte konsistensbaserte tilnærminger er kompilatorens rolle. Kompilatoren kan utføre en grundig analyse av koden og bestemme hvilke delte datastrukturer som kan være usikre for mellomlagring . Basert på dette markerer den disse elementene på en spesiell måte eller tilpasser kodegenereringen.
Den enkleste, og også den mest konservative, tilnærmingen er å forhindre at delte datavariabler blir mellomlagret . Det vil si at hver tilgang til disse variablene tvinger frem tilgang til hovedminnet eller et ikke-mellomlagrbart område. Dette garanterer konsistens, men går glipp av mange ytelsesmuligheter, fordi en delt struktur faktisk kan brukes privat i visse perioder, eller skrivebeskyttet i andre.
I virkeligheten oppstår konsistensproblemet bare i intervaller når minst én prosess kan skrive til variabelen og en annen prosess kan lese den . Utenom disse kritiske periodene kan variabelen behandles som om den utelukkende er til bruk i en enkelt tråd eller til og med som en effektiv konstant en stund, slik at den kan mellomlagres uten problemer.
De mest avanserte kompileringsstrategiene forsøker å identifisere de "sikre" periodene der den delte variabelen kan anses som ikke-konfliktfylt . For å gjøre dette analyserer kompilatoren utførelsesstier, potensielle samtidige tilganger og synkroniseringsmønstre (låser, kritiske seksjoner osv.). Basert på denne analysen deler den variabelens levetid inn i faser: noen er egnet for mellomlagring, andre krever spesiell håndtering.
I kritiske perioder, når samtidig tilgang med skriving oppdages, setter kompilatoren inn tilleggsinstruksjoner i den genererte koden for å håndheve hurtigbufferkonsistens . Disse instruksjonene kan tvinge frem hurtigbuffertømming, minnepåfylling, minnebarrierer eller tilgang til regioner merket som ikke-hurtigbufre, avhengig av programmeringsmodellen og den underliggende arkitekturen.
Forholdet mellom kompilator, operativsystem og maskinvare
Uttrykket «kompilatoren setter inn instruksjoner i den genererte koden for å håndheve hurtigbufferkonsistens» kan få en til å tro at operativsystemet leser disse instruksjonene som om de var hint på høyt nivå , og basert på det bestemmer hvordan programmet skal kjøres. I virkeligheten er mekanismen noe annerledes.
Når kompilatoren legger til denne typen instruksjoner, introduserer den i binærfilen spesifikke operasjoner som støttes av arkitekturen eller kjøretidsmiljøet . For eksempel kan den sette inn instruksjoner for tømming av hurtigbuffer, minnebarrierer, spesielle instruksjoner for å markere regioner som ikke-bufresbare, eller kall til operativsystemtjenester som konfigurerer minneattributter.
Operativsystemet tolker ikke disse instruksjonene som overordnede «kommentarer» eller «hint» skrevet av kompilatoren; det kjører ganske enkelt maskinkoden som alle andre . Noen av disse instruksjonene er imidlertid utformet for å samhandle med minnesubsystemet og hurtigbufferadministrasjon, og dermed endre hvordan CPU-en får tilgang til visse data.
Med andre ord utfører kompilatoren en foreløpig analyse og genererer kode som, når den kjøres, produserer ønsket hurtigbufferoppførsel . Operativsystemet samarbeider ved å etablere minneattributter (bufrebare eller ikke-bufrebare områder, skrivepolicyer osv.) og tilby synkroniseringsprimitiver, men det "leser" ikke spesielle instruksjoner i den forstand at det tolker dem semantisk slik en kompilator ville gjort.
Det kan også skje at maskinvaren, når den ser visse instruksjoner, aktiverer spesifikke koherens- eller synkroniseringsmekanismer . For eksempel garanterer gjerde- eller barriereinstruksjoner rekkefølgen på minnetilgang og håndhever visse synlighetseffekter på tvers av hurtigbufferhierarkiet. I dette tilfellet er det et treveis samarbeid: kompilatoren bestemmer hvor disse instruksjonene skal plasseres, operativsystemet konfigurerer utførelsesmiljøet, og maskinvaren implementerer den faktiske oppførselen på hurtigbuffer- og minnebussnivå.
Sammen sikrer alle disse elementene at parallelle programmer kjører med en konsistent minnemodell, selv med flere kopier av de samme dataene fordelt på tvers av forskjellige hurtigbuffere og hovedminne . Hurtigbufferkoherens er langt fra en enkel intern CPU-detalj, og blir en sentral komponent for at flerkjernesystemer skal fungere pålitelig og effektivt.
Å forstå hvordan hurtigbufferhierarki, maskinvarekoherensprotokoller og programvarestøtteteknikker kombineres, gjør det tydeligere hvorfor moderne CPU-design deler en så lik struktur, og hvorfor en liten feil i noen av disse mekanismene kan utløse kaotisk oppførsel i samtidige applikasjoner som er helt avhengige av at alle kjerner ser de samme dataene til rett tid.