- Fundamental differensiering mellom modelltreningsfasen og inferensfasen for å generere kommersiell verdi.
- Analyse av distribusjonsarkitekturer: fra sentralisert skybehandling til edge computing (Edge AI).
- Evaluering av de tekniske maskinvarekravene, spesielt viktigheten av VRAM i GPU-er for modellutførelse.
- Optimaliseringsstrategier som kvantisering og bruk av små språkmodeller (SLM) for å forbedre driftseffektiviteten.

Når vi snakker om kunstig intelligens, ser de fleste for seg massive læringsprosesser og superdatamaskiner som behandler billioner av datapunkter. Det er imidlertid en del av prosessen der den virkelige magien for næringslivet skjer: inferens. I hovedsak er det når AI slutter å lære og begynner å jobbe, og bruker alt den har lært til å løse problemer i den virkelige verden og ta beslutninger basert på data den aldri har sett før.
I dagens samfunn har selskaper gått lenger enn å se på AI som et laboratorieeksperiment og har gjort det til en grunnleggende del av sin daglige drift. Det handler ikke lenger bare om å lage den kraftigste modellen, men om hvordan man kjører den pålitelig, sikkert og fremfor alt lønnsomt, ved å flytte arbeidsmengden fra teori til aktiv produksjon i hybridmiljøer.

Trening vs. inferens: De er ikke det samme
For å unngå forvirring er det viktig å skille tydelig mellom disse to stadiene. Opplæring er som skoleårene for AI; det er en intensiv prosess der modellen analyserer historiske data og etiketter for å finne mønstre. Kraftige maskinvareakseleratorer som GPU-er eller TPU-er brukes i store datasentre , og responstid er ikke prioritert, da prosessen kan ta dager eller uker.
Inferens, derimot, er den siste testen som utføres i sanntid. Det er utførelsesprosessen der modellen mottar input (et bilde, tekst eller sensoravlesning) og returnerer et umiddelbart resultat. I denne fasen blir latens kritisk , og effektivitet er nøkkelen. Mens trening legger grunnlaget, er inferens det som genererer direkte økonomisk verdi for organisasjonen.
Distribusjonsstrategier: Sky, lokalt og kant
Det finnes ingen enkelt måte å utføre inferens på. Avhengig av hvor presserende og volum dataene er, velger bedrifter mellom flere tilnærminger. Batch-inferens er ideelt for massive, ikke-presserende oppgaver, for eksempel økonomisk analyse over natten eller storskala dokumentkategorisering, der data behandles i skyen og resultatene returneres senere.

Så har vi sanntidsinferens , som er essensielt for chatboter eller svindeldeteksjonssystemer, der svaret må komme innen millisekunder. Selv om skyen fortsatt er det dominerende alternativet på grunn av skalerbarheten, begynner den å vise sine begrensninger på grunn av nettverkslatens og høye båndbreddekostnader når man håndterer terabyte med data.
Det er her kantinferens, eller Edge AI, kommer inn i bildet . Ved å behandle data direkte på enheten (en IoT-sensor, en robot eller en smarttelefon), oppnås ekstremt lav latens og betydelig større personvern, ettersom sensitiv informasjon ikke trenger å reise til en ekstern server. Dette er viktig i sektorer der en forsinkelse på millisekunder kan være kritisk, for eksempel autonom kjøring eller telekirurgi.
Planteinnledning og Industri 4.0
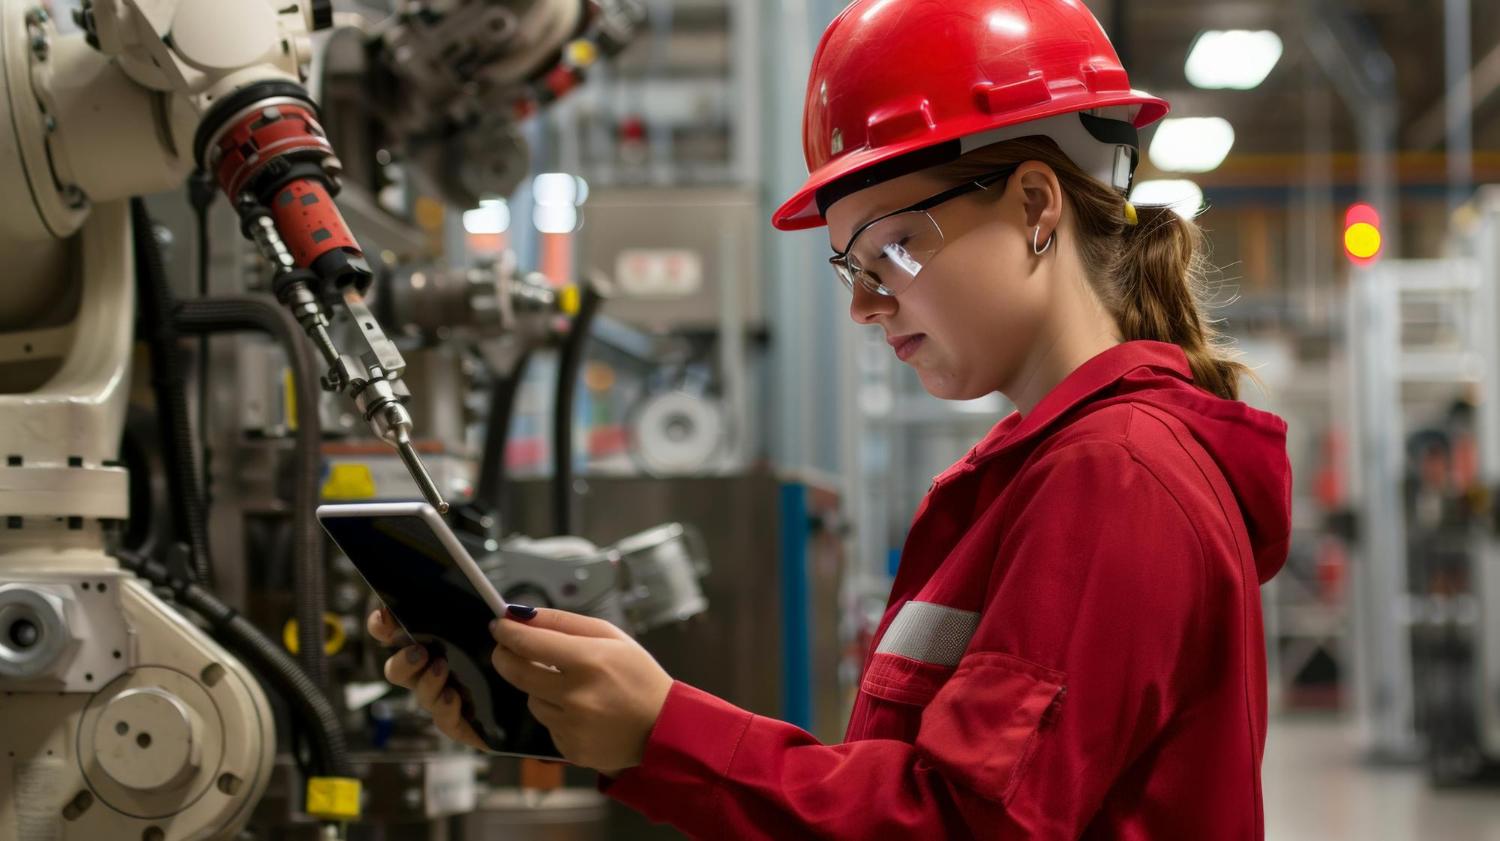
I produksjonssektoren er inferensteknologi en sann perle. Den lar maskiner ta intelligente beslutninger umiddelbart uten å være avhengige av en internettforbindelse. Dette omsettes til kvalitetskontroll i sanntid , som oppdager defekte deler på samlebåndet før de blir en unødvendig utgift.

Videre danner det grunnlaget for prediktivt vedlikehold . AI-modeller analyserer utstyrets tilstand i sanntid og gir tidlige advarsler før noe går i stykker, noe som forhindrer produksjonsstans som ville kostet tusenvis av euro. I næringsmiddel- og elektronikkindustrien sikrer dette at sluttproduktet alltid oppfyller de strengeste kvalitetsstandardene.
Tekniske krav og modelloptimalisering
Hvis et selskap bestemmer seg for å kjøre inferens lokalt, er maskinvaren nøkkelen. GPU-er er essensielle på grunn av deres parallelle arkitektur. Den viktigste faktoren er ikke bare rå kraft, men VRAM (videominne). Hvis modellen passer fullstendig i VRAM, skyter responstiden i været. Ellers er systemet avhengig av konvensjonell RAM, noe som bremser alt betraktelig.
For å få disse modellene til å fungere på et begrenset antall enheter, brukes optimaliseringsteknikker. Kvantisering reduserer presisjonen til modellvektene (for eksempel fra 32 til 4 bits), noe som gjør filen mye mindre og raskere uten at det går på bekostning av for mye nøyaktighet. På den annen side tillater LoRA (Low-Rank Adaptation) at store modeller tilpasses spesifikke oppgaver uten å måtte trene hele modellen på nytt, noe som er mye billigere og raskere.

Små språkmodeller (SLM-er) vinner også terreng . I motsetning til massive LLM-er er SLM-er designet for å være effektive og lette, noe som gjør dem til en perfekt match for kantmaskinvare. For å håndtere maskinvarefragmentering brukes WebAssembly (Wasm) , som lar AI kjøre med nesten naturlig hastighet på enhver enhet, uavhengig av prosessor.
Styrings-, sikkerhets- og driftsverktøy
Å flytte AI til produksjon betyr at det ikke lenger bare er et spill, men en forretningskritisk arbeidsmengde. Mange selskaper opererer allerede i hybrid- eller multiskymiljøer , noe som nødvendiggjør implementering av strenge ruting- og sikkerhetskontroller. Styring fokuserer nå på prompt-, token- og API-lagene, der håndtering av sikkerhet i AI-utviklingsmiljøer er avgjørende for å forhindre datalekkasjer.
For de som ønsker å eksperimentere med lokal inferens, finnes det noen svært kraftige verktøy tilgjengelig. LM Studio er et utmerket alternativ for brukere som ønsker et enkelt grafisk grensesnitt og kompatibilitet med Hugging Face-modeller. For utviklere er Ollama stjerneverktøyet, ettersom det er åpen kildekode og lar deg bruke lokal AI på datamaskinen din svært effektivt gjennom Docker-containere.

Det finnes andre interessante alternativer som Llama.cpp for bred maskinvarestøtte, eller Jan for de som prioriterer et 100 % offline-miljø. Det finnes til og med smarttelefonapper som PocketPal som bringer inferens direkte til lommen din, noe som viser at kunstig intelligens ikke lenger nødvendigvis trenger en superdatamaskin for å være nyttig.
Trenden er tydelig: kunstig intelligens beveger seg mot en distribuert modell. Fremtiden ligger ikke i en enkelt, sentralisert hjerne i skyen, men i et intelligent inferensnettverk spredt på tvers av datasentre og lokale enheter. Denne hybridarkitekturen gir en balanse mellom datakraft, behovet for umiddelbare responser og beskyttelse av bedriftens datapersonvern.
