- Arkitektoniske forskjeller mellom CPU og GPU som muliggjør massiv parallell databehandling.
- Strategier for skydistribusjon ved bruk av standard-, punkt- og fleksible provisjoneringsmodeller.
- Kritiske tekniske kriterier for valg av maskinvare basert på VRAM, båndbredde og latens.
- Avansert programmering og globale orkestreringssystemer for å optimalisere bruken av AI-klynger.

Når vi snakker om rå kraft for å flytte fjell av data, er det umulig å ikke nevne den grunnleggende rollen grafikkprosessorer spiller. Selv om de opprinnelig ble designet for å få videospill til å se utrolige ut, er de i dag hovedmotoren for kunstig intelligens og massiv dataanalyse, slik at oppgaver som tidligere tok uker kan fullføres på bare noen få timer.
Å flytte disse arbeidsbelastningene til skyen har vært banebrytende for utviklere og dataforskere. Det er ikke lenger nødvendig å bruke en formue på maskinvare som raskt blir foreldet; i stedet kan vi leie datakraft skreddersydd til våre faktiske behov, skalere ressurser i henhold til prosjektet og optimalisere hver krone som investeres i infrastruktur.

CPU vs GPU: Hva er den virkelige forskjellen?
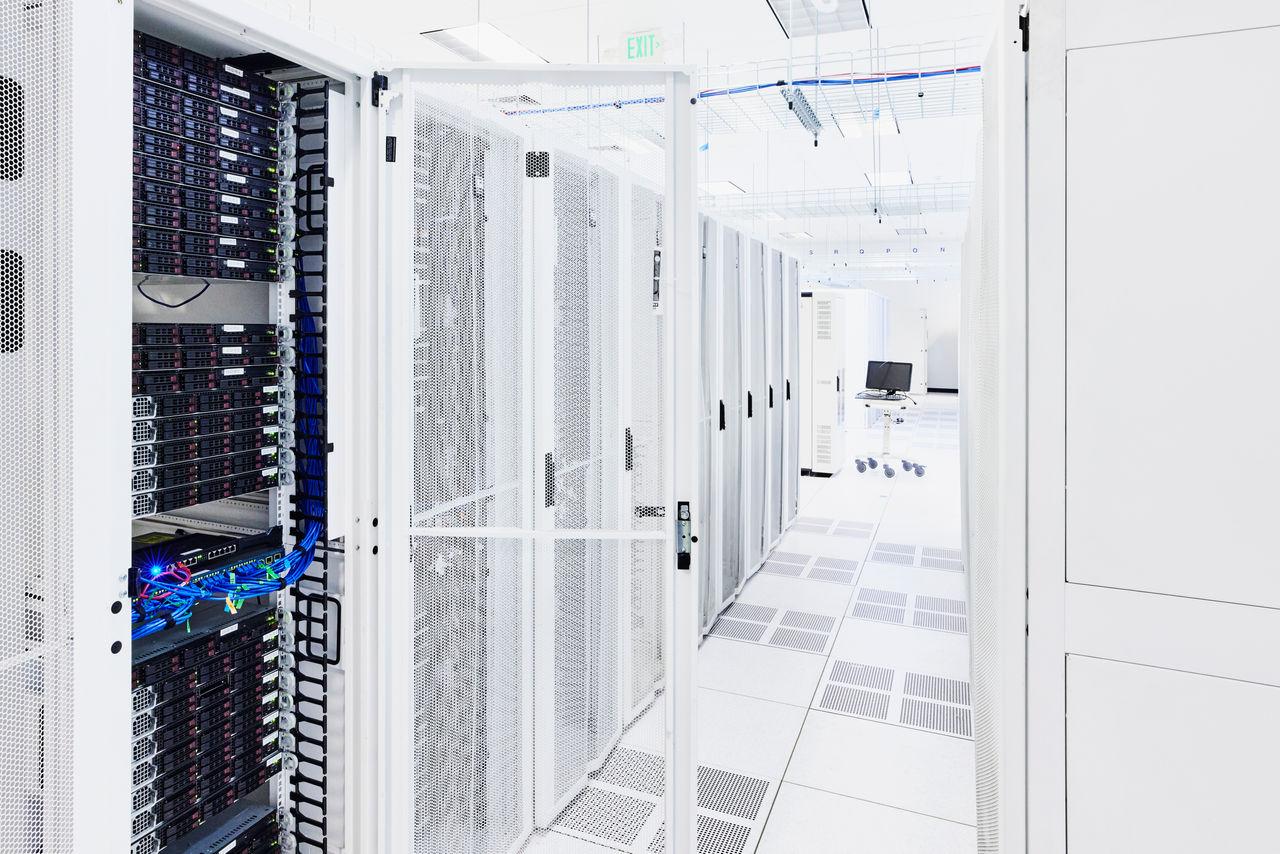
Enkelt sagt er CPU-en som en svært intelligent leder som kan gjøre alt, men behandler oppgaver etter hverandre. I motsetning til dette er GPU-en som en hær av tusenvis av arbeidere som er spesialisert i å utføre den samme matematiske operasjonen om og om igjen, men samtidig. Dette er grunnlaget for det vi kaller parallell databehandling.
Mens CPU-en håndterer kompleks logikk og systemkontroll, utmerker GPU-en seg på matrisebehandling og bildegjengivelse. Takket være hundrevis eller tusenvis av kjerner , som ligner på en flerkjernet CPU-arkitektur , men i massiv skala, kan den utføre flere delsett av en oppgave samtidig – viktig for å trene nevrale nettverk eller behandle terabyte med data uten at systemet krasjer.
Batch- og sanntidsjobbhåndtering
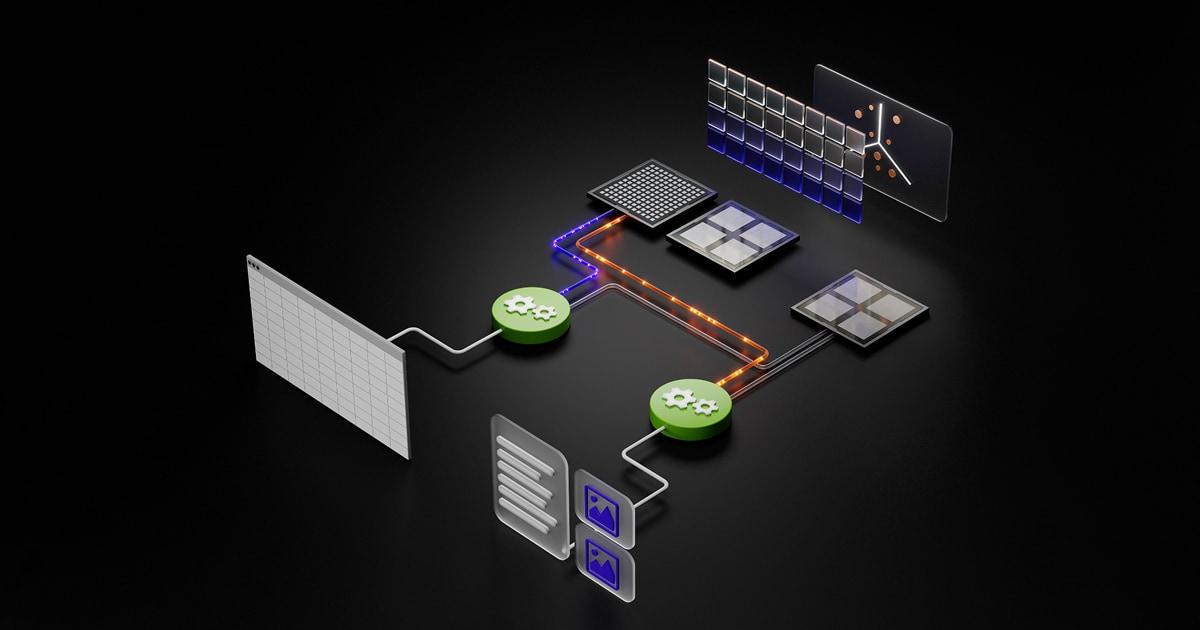
I skyøkosystemet finnes det to hovedmåter å utføre disse oppgavene på. Batchbehandling er ideelt for jobber som ikke krever en umiddelbar respons, for eksempel dataforbehandling eller massiv inferens. Her er målet å maksimere effektiviteten og den generelle systemytelsen ved å la jobber akkumuleres og kjøres når ressurser er tilgjengelige.
På den annen side er sanntidsprosessering avgjørende for applikasjoner som må reagere umiddelbart, for eksempel generative AI-chatboter eller ansiktsgjenkjenning. I disse tilfellene er den absolutte prioriteten lav latens og høy tilgjengelighet, slik at sluttbrukeren ikke merker noen forsinkelser mens modellen behandler informasjonen.
For å sette opp et prosjekt som dette er det viktig å planlegge kravene. Fra å velge riktig maskin til å installere drivere (som kan være automatisk eller manuell ved hjelp av tilpassede bilder), påvirker hvert trinn om prosessen går knirkefritt eller blir et teknisk hodebry.
Forbruksmodeller og kostnadsoptimalisering
Ikke alle virtuelle maskiner er skapt like, og de koster heller ikke alle det samme. For de som ønsker å spare penger, er Spot VM- er et fristende alternativ, og tilbyr massive rabatter, selv om de kommer med risikoen for at skyen tar dem tilbake når som helst. De er perfekte for feiltolerante oppgaver der kostnad er prioriteten.
Hvis du trenger noe mer stabilt, men til en rabattert pris, finnes det fleksible oppstarts-VM-er , som gir tilgang til GPU-ressurser til reduserte priser i bytte mot noen dagers forsinkelse før arbeidet kan starte. For forretningskritiske prosjekter er alternativene standard klargjøring på forespørsel eller planlagte reservasjoner , som garanterer at maskinvaren er der akkurat når du trenger den.

En avansert teknikk for å maksimere budsjettet er regional kostnadsarbitrasje . Ved å dra nytte av prisvariasjoner på tvers av geografiske områder eller bruke «følg solen»-planlegging, kan team i Asia, Europa og Amerika bruke klyngene etter tur, og dermed oppnå nesten 100 % maskinvareutnyttelse.
Slik velger du riktig GPU for ditt bruksområde

Det handler ikke om å velge det dyreste kortet, men det som passer best til oppgaven. I trening av store språkmodeller (LLM) er videominne (VRAM) den største flaskehalsen. Hvis du går tom for VRAM, må du redusere batchstørrelsene, noe som vil øke utførelsestiden og de totale kostnadene betydelig.
- AI-opplæring: Den krever høy kraft i blandet presisjon (FP16/BF16) og en sjenerøs VRAM for å håndtere gradienter og optimaliseringstilstander.
- Sanntidsinferens: Her er nettverkslatens og stabilitet i programvarestakken nøkkelen til å forhindre produksjonsavbrudd.
- Datavitenskap: Det søkes en balanse mellom CPU, RAM og GPU, siden mye av datarensingen fortsatt er en sekvensiell oppgave.
- 3D-rendering og visuelle effekter: De er kritisk avhengige av minnebåndbredde for å flytte komplekse teksturer og geometrier raskt.
- Vitenskapelige beregninger: De prioriterer FP32- eller FP64-nøyaktighet og eksakt reproduserbarhet av resultater gjennom faste driverversjoner.
Det er viktig å overvåke systemets dataflyt . Det er ubrukelig å ha en ultrakraftig GPU hvis CPU-en eller lagringsplassen er treg. I så fall vil GPU-en bruke mesteparten av tiden sin på inaktivitet og vente på data, noe som kalles ressursunderutnyttelse.
Avansert orkestrering og fremtidens databehandling
Etter hvert som klynger vokser, fungerer ikke lenger enkel «først inn, først ut»-planlegging. Ledende selskaper implementerer planleggingshierarkier på flere nivåer som fordeler jobber basert på dataplassering, forretningsprioritet og regionens karbonavtrykk.

Innovasjoner som sanntids CPU/GPU-bytting lar systemet bestemme hvilken prosessor som er mest effektiv for hver tråd. Dette løser den globale maskinvaremangelen ved å optimalisere hver tilgjengelige klokkesyklus, slik at generativ AI og digitale tvillinger kan utvikle seg uten å bli blokkert av mangel på brikker.
Bruken av Kubernetes med Dynamic Resource Allocation (DRA) og Multi-Instance GPU (MIG)-teknologi gjør det mulig å dele et enkelt fysisk grafikkort inn i flere virtuelle instanser. Dette demokratiserer tilgangen til høyytelsesdatabehandling, slik at flere brukere kan dele samme GPU uten å forstyrre hverandre.
Å ha en klar strategi som kombinerer riktig maskinvare, en smart betalingsmodell og fleksibel orkestrering er den eneste måten å unngå å kaste bort penger på skytjenester. Fra valg av VRAM til utrulling av Spot-instanser påvirker hver tekniske beslutning direkte innovasjonshastigheten og lønnsomheten til ethvert avansert databehandlingsprosjekt.
