- Kjerneminnedumper registrerer systemtilstanden ved kritiske feil og er avgjørende for feilsøking og sikkerhetsrevisjon.
- I Windows analyseres de med WinDbg eller KD, ved hjelp av symboler og kommandoer som !analyze -vy .bugcheck for å finne drivere og årsaker til feilen.
- I Linux lar verktøy som crash, LiME og gcore deg trekke ut og studere kjerne- og prosessdumper, med spesiell vekt på å beskytte sensitive data.
- FreeBSD og andre Unix-systemer krever kjerner kompilert med symboler og bruk av kgdb, og er alltid avhengige av dokumentasjon og kildekode for å tolke resultater.
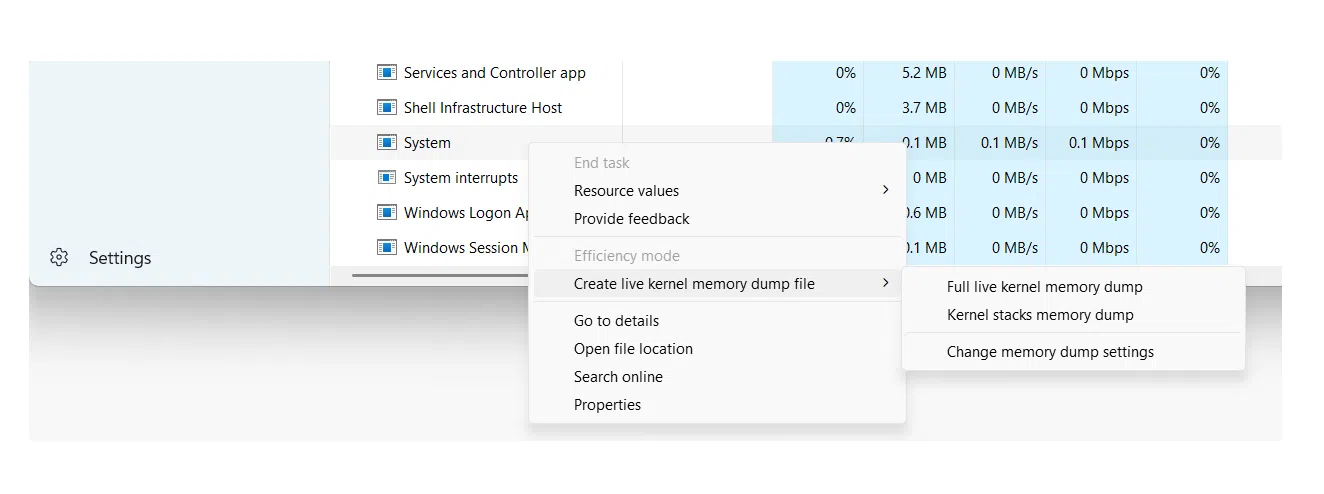
Når et operativsystem får panikk eller krasjer, er den eneste måten å forstå hva som skjedde å ta en kjerneminnedump og analysere den . Disse dumpene fanger opp systemets interne tilstand i feiløyeblikket og er viktige for å feilsøke komplekse feil, undersøke sikkerhetshendelser eller utføre rettsmedisinske undersøkelser.
Selv om det kan høres veldig "lavnivå", er ikke minnedumpanalyse eksklusivt for kjerneutviklere. Systemadministratorer, supportingeniører og til og med sikkerhetsrevisorer kan dra nytte av det hvis de kjenner til de riktige verktøyene, de forskjellige typene dumps og grunnleggende tolkningsteknikker . Vi vil veilede deg gjennom alt dette på Windows, Unix/Linux og BSD, ved hjelp av verktøy som WinDbg, crash, kgdb og LiME.
Hva er en kjerneminnedump, og hvorfor er det verdt å analysere det?
En kjerneminnedump (ofte kalt en Kernel Crash Dump eller bare en crash dump ) er en fil som inneholder en kopi, enten fullstendig eller delvis, av minnet på det tidspunktet systemet opplever en kritisk feil, for eksempel en kernel panic i Unix/Linux eller en blåskjerm (BSOD) i Windows.
I praksis lagrer en dump av denne typen interne kjernestrukturer, kallstabler, prosesskontekst og lastede drivere . Takket være dette kan man etter katastrofen utføre en post mortem-analyse som ligner veldig på feilsøking av et live-system, men uten presset med å måtte berøre en produksjonsmaskin mens den svikter.
Årsakene til å fordype seg i kerneldumps er varierte: fra feilsøking av tilsynelatende tilfeldige feil og periodiske krasj , til å undersøke om et system har blitt ondsinnet manipulert eller om et krasj kan ha etterlatt spor av sensitiv informasjon på disken.
I tillegg til fullstendige kjernedumper er det mulighet for å ta dumper av individuelle prosesser (de klassiske kjernedumpene ), som er veldig nyttige når vi ønsker å begrense et problem til et bestemt program eller sjekke virkningen på konfidensialiteten til en tjeneste som en e-post- eller meldingsklient.
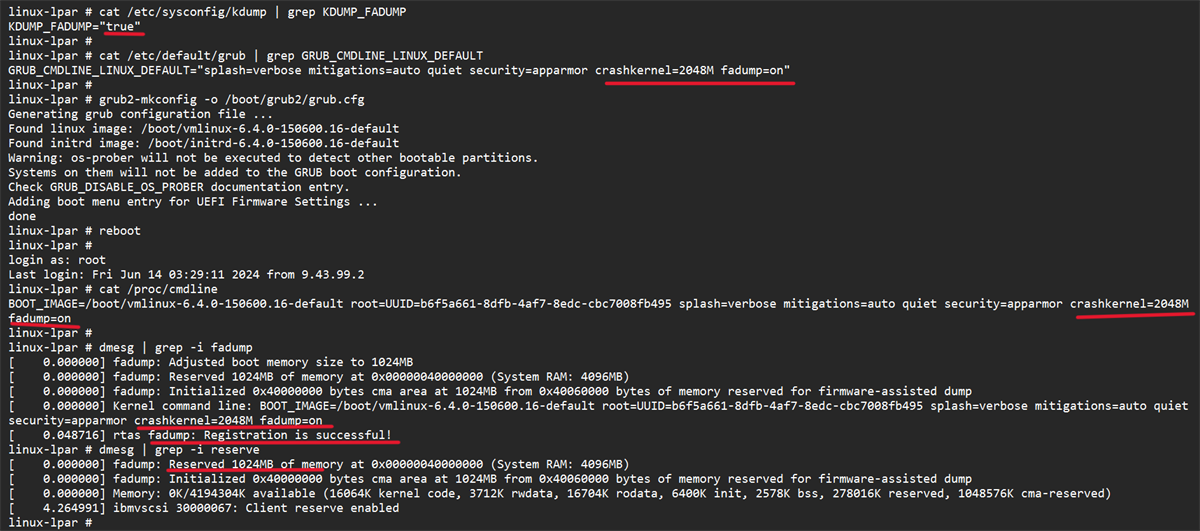
Typer minnedumper i Windows og deres nytteverdi
På Windows-systemer kan operativsystemet selv generere forskjellige typer dumpfiler når en STOP-feil oppstår. Hver type har et ulikt detaljnivå, så det er viktig å vite hvilken type dump du trenger avhengig av problemet og begrensninger på diskplass.
Et av de vanligste formatene i brukermiljøer og på mange servere er liten minnedump (minidump)Det er den som bruker minst plass og vanligvis er plassert i %SystemRoot%\Minidump, med filer av stilen MiniMMDDÅÅ-01.dmp.
Denne minidumpen inneholder svært spesifikk, men viktig informasjon: STOP-feilkoden og dens parametere , listen over drivere som ble lastet inn da feilen oppstod, konteksten til prosessoren som stoppet (PRCB), konteksten til prosessen og tråden som var involvert (EPROCESS- og ETHREAD-strukturer) og kjernemoduskallstakken til den tråden.
Takket være disse grunnleggende strukturene er det ofte mulig å identifisere hvilken driver eller modul som forårsaker krasjene, selv med en minidump. Det vil imidlertid ikke alltid være mulig å følge hele sporet hvis problemet stammer langt fra tråden som kjørte på tidspunktet for krasjen, og den tilgjengelige kontekstinformasjonen er begrenset.
Windows kan også generere kjerneminnedumper og mye større fullstendige dumper som inneholder deler av eller alt det fysiske minnet. Disse er spesielt nyttige for lavnivåanalyse, rettsmedisinske undersøkelser og avansert feilsøking av drivere eller selve systemet.
Konfigurer og åpne minnedumper i Windows med WinDbg og KD
For å dra nytte av systemdumper i Windows, er det første trinnet å konfigurere oppstarts- og gjenopprettingsalternativer riktig . Fra Kontrollpanel, i de avanserte systemegenskapene, kan du velge hvilken type dump du vil generere i tilfelle en feil: for eksempel en "Liten minnedump (256 KB)" og banen der den skal lagres.
Systemet krever også en sidevekslingsfil på oppstartsvolumet på minst noen få megabyte for å skrive dumpen. I moderne versjoner av Windows oppretter hver krasj en ny fil, og en historikk vedlikeholdes i den konfigurerte mappen, noe som gir enkel gjennomgang av tidligere hendelser.
Når de er generert, finnes det flere måter å validere at dumpene er riktige. Et klassisk verktøy er Dumpchk.exe , som lar deg sjekke den grunnleggende integriteten til filen og skrive ut sammendragsinformasjon. For mer avansert analyse brukes Windows Debugging Tools , inkludert WinDbg (grafisk grensesnitt) og KD (kommandolinjeversjon).
Etter at du har installert feilsøkingspakken fra Microsofts nettsted, vil verktøyene vanligvis være plassert i en mappe som C:\Program Files\Debugging Tools for Windows . Derfra kan du åpne en ledetekst og laste inn en dumpfil ved hjelp av WinDbg eller KD, og spesifisere filen med -z-parameteren .
windbg -y <RutaSimbolos> -i <RutaBinarios> -z <RutaDump>
Symbolbanen kan peke til en symbolserver med lokal mellomlagring , for eksempel:
srv*C:\Symbols*https://msdl.microsoft.com/download/symbols
Selv om den binære banen vanligvis er noe sånt som C:\Windows\I386 eller mappen der vi har kopiert systemkjørbare filer som tilsvarer versjonen som genererte dumpen. Dette er viktig fordi Minidumper inkluderer ikke alle binærfiler, bare referanser til dem, så feilsøkingsprogrammet må kunne finne dem.
Grunnleggende analyse av en kjernekrasjdump i Windows
Når dumpen er lastet inn med WinDbg eller KD, er det å analysere en kjernekrasjdump ganske likt en feilsøking etter døden. Den første kommandoen nesten alle kjører er `!analyze` , som starter en automatisert analyse og genererer en innledende rapport.
Kommandoen !analyze -show vis feilsjekkkode og dens parametereMens !analyze -v Den produserer mye mer detaljert utdata: mistenkelig modul, kallstabel, kontekstuell informasjon og i mange tilfeller forslag til mulige årsaker eller diagnostiske trinn.
For å utfylle denne analysen skriver .bugcheck- kommandoen ut feilkoden og tilhørende parametere på nytt, som kan sammenlignes med Microsofts feilsjekkkodereferanse for å finne ut den nøyaktige betydningen av hver verdi og typiske årsaker.
Kommandoen lm N T (listemoduler) lar deg se Liste over lastede moduler med sti, adresser og statusDette bidrar til å bekrefte om driveren som identifiseres av den automatiserte analysen faktisk finnes i minnet, og hvilken versjon den er. Denne listen er spesielt nyttig når vi mistenker tredjepartsdrivere eller sikkerhetskomponenter som samhandler med kjernen.
Om ønskelig kan vi forenkle lasting av dumpfiler ved å opprette en batchfil som mottar banen til dumpfilen og starter KD eller WinDbg med de riktige parameterne. På denne måten trenger vi bare å skrive en kort kommando som kun inkluderer filplasseringen, og skriptet tar seg av alt annet.
Bruk av WinDbg for dype kerneldumps
For minnedumper i kjernemodus tilbyr WinDbg også muligheten til å jobbe med flere filer og økter. Dumper kan åpnes fra kommandolinjen med -z , eller fra det grafiske grensesnittet ved å bruke Fil > Åpne minnedump-menyen eller hurtigtasten Ctrl+D.
Hvis WinDbg allerede er åpen i passiv modus, velger du ganske enkelt filen i dialogboksen «Åpne krasjdump», angir banen eller blar gjennom disken. Når den er lastet inn, kan du starte økten med en «g» (Go) -kommando i visse scenarier, eller kjøre de første analysekommandoene direkte.
I tillegg til den klassiske !analyzeDet er lurt å bli kjent med referansedelen for feilsøkingskommandoenDette beskriver alle tilgjengelige kommandoer for å lese interne strukturer, undersøke minne, tolke stabler og mye mer. Mange av disse teknikkene kan brukes på både live-økter og offline-dumper.
WinDbg lar deg også jobbe med flere parallelle dumperVi kan legge til flere -z-parametere på kommandolinjen, hver etterfulgt av et annet filnavn, eller legge til nye mål ved hjelp av kommandoen .opendumpFeilsøking av flere destinasjoner er nyttig for å sammenligne gjentakende feil eller sammenhengende hendelser.
I noen miljøer pakkes minnedumper inn i CAB-filer for å spare plass eller forenkle overføring. WinDbg kan åpne en .cab med en dump inni, både ved bruk av -z og med .opendumpselv om han vil lese Den vil bare pakke ut én av de dumpede filene og ikke pakke ut andre filer. som kunne gått i samme pakke.
Krasjdumper i Unix og Linux: verktøy, verktøy og krav
I Unix- og GNU/Linux-systemer er filosofien lik, men økosystemet av verktøy er betydelig forskjellig. De fleste Unix-lignende kjerner tilbyr muligheten til å lagre en kopi av minnet når en katastrofal hendelse inntreffer , noe som er kjent som en kjernedump eller kjernekrasjdump.
Selv om deres primære bruk fortsatt er kjerne- og driverutvikling, har disse dumpene et klart sikkerhetsaspekt. En krasj kan være forårsaket av programmeringsfeil, men også av mislykkede ondsinnede handlinger, forsøk på å manipulere systemkomponenter eller klønete utnyttelser av kappløpsforhold.
I et godt konfigurert Unix-system er daglige krasj uvanlige, men når de inntreffer, er det lurt å ha en dumpinfrastruktur på plass, for eksempel Kdump, LKCD eller andre løsninger som lar deg fange systemminne. Det er imidlertid avgjørende å veie både den diagnostiske verdien av dumpen mot risikoen for at den inneholder svært sensitive data.
Et av de mest omfattende og brukte verktøyene for denne typen analyse i Linux er crash , opprinnelig utviklet av Red Hat. Dette verktøyet har praktisk talt blitt en de facto standard for å undersøke kerneldumps og også for å analysere kjørende systemer.
Krasj kan virke mot systemets liveminne gjennom /dev/mem eller, i Red Hat og derivatdistribusjoner, ved å bruke den spesifikke enheten /dev/crashLikevel er det vanlig praksis å mate verktøyet med en dumpfil generert av mekanismer som Kdump, makedumpfile, Diskdump eller arkitekturspesifikke dumpfiler som s390/s390x eller xendump i virtualiserte miljøer.
Krasjs rolle og viktigheten av vmlinux i Linux
Krasjverktøyet ble delvis laget for å overvinne begrensningene ved bruk av gdb direkte på /proc/kcoreBlant annet kan tilgangen til det minnepseudobildet være begrenset, og i tillegg gjør visse kjernekompileringsalternativer det vanskelig å tolke de interne strukturene riktig hvis vi bare har den komprimerte kjørbare binærfilen.
For at krasj skal fungere riktig, kreves to nøkkelelementer: en kompilert vmlinux-fil med feilsøkingssymboler (vanligvis med flagg som -g) og selve kernel-dumpen. Denne kombinasjonen lar verktøyet tilordne minneadresser til funksjoner, strukturer og kodelinjer.
Det er viktig å skille mellom vmlinux og vmlinuzPå de fleste systemer er bare vmlinux synlig, som er en komprimert, oppstartbar versjon av kjernen. Krasj krever den symbolsk dekomprimerte vmlinux; uten den, når du prøver å laste inn en dump eller /dev/mem Vi vil støte på feil av typen Finner ikke den oppstartede kjernen – vennligst skriv inn navnelisteargumentet.
Selv om det er mulig å pakke ut vmlinuz manuelt, er ikke prosessen alltid enkel, og i praksis er det ofte mye mer praktisk å kompilere kjernen på nytt for å få tak i både vmlinux og vmlinuz samtidig. I seriøse administrasjonsmiljøer er det god praksis å opprettholde en separat vmlinuz-pakke for hver distribuerte kjerneversjon spesielt for disse situasjonene.
Når kravene er oppfylt, er det relativt enkelt å kjøre krasj mot en dump: du spesifiserer riktig vmlinux- og dump-fil, og verktøyet åpner en interaktiv økt der du kan utforske kjernestrukturer, liste opp prosesser, vise kallstabler og trekke ut rettsmedisinsk informasjon . De som ønsker å gå dypere inn i dette, kan konsultere spesialisert dokumentasjon, for eksempel den velkjente tekniske rapporten om krasj.
Begrensninger ved /dev/mem og første tilnærminger i Linux
Før de tyr til spesifikke verktøy, har mange administratorer historisk sett forsøkt å skaffe seg en minnedump. leser direkte fra enheten /dev/memDenne tilnærmingen virket enkel: bruk et verktøy som memdump (som dumper den enheten til STDOUT) eller henter fra dd if=/dev/mem of=volcado.mem.
Moderne kjerner tilbyr imidlertid kompileringsalternativer som CONFIG_STRICT_DEVMEMsom i stor grad begrenser tilgangen fra brukerområdet til /dev/memDet typiske resultatet er at lesingen blir avbrutt etter en liten blokk (f.eks. 1 MB), eller i verste fall kan en feil i den interaksjonen ende med en kjerne panikk øyeblikkelig omstart av maskinen.
Denne beskyttelsen gir perfekt mening fra et sikkerhetssynspunkt, men den tvinger oss til å se etter andre måter å få en pålitelig og fullstendig dump uten å stole helt på generiske enheter som ikke lenger er like tilgjengelige som før.
Derfor er den nåværende trenden å stole på spesifikke moduler eller integrerte krasjdumpinfrastrukturer, i stedet for bare å prøve å "skrape minne" med brukerplassverktøy som ikke er designet for å sameksistere med moderne kjernebeskyttelsespolicyer.
LiME Forensics: Minneutvinning i Linux og Android
Et svært kraftig alternativ i den rettsmedisinske verdenen er LiME (Linux Memory Extractor) , en kjernemodul som er designet nettopp for å fange opp flyktig minne på en kontrollert måte og uten restriksjonene som påvirker /dev/mem. LiME kjører i kjerneområdet, slik at den kan få tilgang til RAM mye mer direkte.
LiME distribueres med kildekoden og kompileres mot kjerneoverskrifter i brukKompileringsprosessen genererer en modul .ko spesifikk for kjerneversjonen den skal lastes inn i. Når den er kompilert, kan vi bekrefte den med verktøy som file for å sikre at ELF-modulen som tilsvarer arkitekturen vår er generert riktig.
For å bruke LiME, laster du ganske enkelt inn modulen med insmod fra roten og gi den de riktige alternativene, for eksempel ved å spesifisere en nettverksdumpdestinasjon ved hjelp av TCP og et råformat:
insmod lime-3.x.y.ko "path=tcp:4444 format=raw"
Parallelt, på maskinen som skal motta dumpen, lytter vi på den konfigurerte porten ved hjelp av et verktøy som ncomdirigere utdataene til en fil:
nc <IP_origen> 4444 > volcado.mem
Etter noen minutter, avhengig av mengden RAM og nettverksytelse, vil vi ha en fil med en størrelse som samsvarer med det fysiske minnet til kildesystemet. Dette er en komplett RAM-dump som vi kan analysere med rettsmedisinske verktøy eller til og med med strenger eller andre verktøy som et første skritt for å finne interessante strenger.
Prosessdumper og risikoer for dataeksponering
En fullstendig kerneldump er ekstremt informativ, men den kan også være overdreven når vi bare er interessert i en spesifikk prosess. I så fall er det veldig fornuftig å ty til... individuelle prosessdumper ved hjelp av verktøy som gcore i Unix/Linux.
Disse dumpene per prosess er mye mindre og mer håndterbare, og lar deg fokusere analysen din på spesifikke applikasjoner som en meldingsklient (f.eks. Skype) eller en e-postklient (f.eks. Thunderbird), hvor det er relativt enkelt å finne passord i ren tekst, økttokener eller kontaktdata ved å utforske minnestrenger.
Fra et utviklingsperspektiv hjelper disse kjernedumpene med å finne programmeringsfeil, minnelekkasjer eller inkonsistente tilstander i en tjeneste. Fra et sikkerhetsperspektiv oppstår imidlertid problemet når disse dumpene genereres rutinemessig og lagres på steder som er tilgjengelige for andre brukere , enten på selve systemet eller på delte nettverksressurser.
Hvis en bruker planlegger for eksempel en oppgave cron Ved å periodisk fange opp dumpfiler av sensitive prosesser og legge dem i en globalt lesbar katalog, åpner en angriper en stor dør for eksponering av kritisk informasjon. I mange revisjonsscenarier lar analyse av disse filene en angriper gjenopprette legitimasjon, kontaktlister, kommunikasjonshistorikk og andre private data med relativt lav innsats.
Derfor er det lurt å bruke noen minutter på å sjekke om det genereres dumpfiler (fullstendige eller delvise), hvor de lagres, hvilke tillatelser de har, og om det finnes noen automatiserte prosesser som etterlater minnekopier innen rekkevidde for uautoriserte brukere , i enhver seriøs revisjon av et Unix-system.
Post-mortem-analyse av dumpfiler i FreeBSD med kgdb
I BSD-verdenen, og spesielt i FreeBSD, involverer tilnærmingen til post mortem-analyse Aktiver krasjdumper på systemet og få en kjerne kompilert med feilsøkingssymbolerDette styres fra kjernekonfigurasjonskatalogen, vanligvis i /usr/src/sys/<arq>/conf.
I den tilhørende konfigurasjonsfilen kan symbolgenerering aktiveres med en linje som denne:
makeoptions DEBUG=-g # Build kernel with gdb(1) debug symbols
Etter at konfigurasjonen er endret, må kjernen kompileres på nytt. Noen objekter vil bli generert på nytt (som for eksempel trap.o) på grunn av endringen i byggefilene. Målet er å få tak i en kjerne med samme kode som den som har problemer, men legger til nødvendig feilsøkingsinformasjonDet anbefales å sammenligne de gamle og nye størrelsene ved hjelp av kommandoen size for å sikre at det ikke har vært noen uventede endringer i binærfilen.
Når kjernen med symboler er installert, kan vi undersøke dumpene med kgdb som beskrevet i den offisielle dokumentasjonen. Ikke alle symbolene er nødvendigvis komplette, og noen funksjoner kan vises uten linjenumre eller argumentinformasjon, men i de fleste tilfeller er detaljnivået tilstrekkelig til å spore problemet.
Det er ingen absolutt garanti for at analysen vil løse alle hendelser, men i praksis fungerer denne strategien ganske bra i en høy andel av scenarier , spesielt når krasjdumper kombineres med en god gjennomgang av nylige endringer i systemet.
Beste fremgangsmåter for å analysere og dokumentere kjernefeil
Uansett operativsystem ender kernel dump-analyse vanligvis opp med å referere til teknisk dokumentasjon, kunnskapsbaser, spesialiserte fora eller til og med selve kjernekildekoden for å tolke meldinger, feilkoder og ukjente symboler.
I Linux er det veldig nyttig å stole på det offisielle kildekodetreet, den innebygde dokumentasjonen og fellesskapsressurser. Mange kjernefeilmeldinger kan spores tilbake til den nøyaktige filen der de kommer fra, noe som hjelper med å forstå konteksten der en bestemt BUG() eller WARN() utløses.
I Windows gir Microsofts dokumentasjon, kunnskapsbase (KB) og tekniske forum detaljerte forklaringer av feilsøkingskoder, feilsøkingsanbefalinger og kjente feilmønstre . Ved å kombinere denne informasjonen med rapportene fra !analyze -v er det mulig å utvikle en rimelig plan for å redusere problemet.
Den sanne verdien av en krasjdump fremkommer når all denne informasjonen kryssrefereres med en solid forståelse av operativsystemet og det spesifikke miljøet der feilen oppsto . Først da kan varige løsninger utvikles, og fremfor alt kan det samme problemet forhindres i å oppstå igjen i fremtiden med mer alvorlige konsekvenser.
Kjernedumpanalyse er til syvende og sist en blanding av vitenskap og håndverk: det krever passende verktøy, forhåndskonfigurasjon (symboler, dumpalternativer, sikker lagring) og mye erfaring med å lese stabler, strukturer og feilkoder. Å mestre disse teknikkene lar oss ikke bare feilsøke komplekse hendelser, men også øke sikkerheten og robustheten til systemene vi administrerer dramatisk.
Indeks
- 1 Hva er en kjerneminnedump, og hvorfor er det verdt å analysere det?
- 2 Typer minnedumper i Windows og deres nytteverdi
- 3 Konfigurer og åpne minnedumper i Windows med WinDbg og KD
- 4 Grunnleggende analyse av en kjernekrasjdump i Windows
- 5 Bruk av WinDbg for dype kerneldumps
- 6 Krasjdumper i Unix og Linux: verktøy, verktøy og krav
- 7 Krasjs rolle og viktigheten av vmlinux i Linux
- 8 Begrensninger ved /dev/mem og første tilnærminger i Linux
- 9 LiME Forensics: Minneutvinning i Linux og Android
- 10 Prosessdumper og risikoer for dataeksponering
- 11 Post-mortem-analyse av dumpfiler i FreeBSD med kgdb
- 12 Beste fremgangsmåter for å analysere og dokumentere kjernefeil