- VibeVoice to model syntezy mowy firmy Microsoft umożliwiający generowanie długich, ekspresyjnych dźwięków dla wielu głośników, idealnych do podcastów i audiobooków.
- Jej architektura łączy w sobie tokenizatory mowy, rozbudowany model językowy i dyfuzję, co pozwala uzyskać naturalne głosy nawet w nagraniach audio trwających do 90 minut.
- Umożliwia ona udzielanie odpowiedzi niemal w czasie rzeczywistym z niewielkimi odchyleniami, ale wymaga odpowiedzialnego korzystania z niej ze względu na ryzyko klonowania głosu i deepfake'ów.
- Został on udostępniony jako otwarte oprogramowanie badawcze, jednak Microsoft tymczasowo ograniczył repozytorium z obawy przed niewłaściwym wykorzystaniem.

Pojawienie się VibeVoice firmy Microsoft rewolucjonizuje sposób tworzenia podcastów i długich materiałów audio z wykorzystaniem sztucznej inteligencji. Ten model TTS (syntezy mowy) o otwartym kodzie źródłowym nie tylko generuje hiperrealistyczne głosy, ale także umożliwia produkcję rozmów z wieloma mówcami o długości do 90 minut bez uciążliwych cięć i spadków jakości.
Celem VibeVoice jest zapewnienie każdemu wirtualnej kabiny nagraniowej, która umożliwi profesjonalną produkcję podcastów, audiobooków lub narracji z poziomu komputera. Wystarczy skrypt i podstawowa wiedza techniczna, aby skonfigurować model, a sztuczna inteligencja zajmie się resztą: intonacją, naturalnością, zmianami głosu i ciągłością dźwięku.
Czym jest VibeVoice i dlaczego jest tak ważny dla podcastów?
Model ten opiera się na technologii TTS (Text-to-Speech), co oznacza, że bezpośrednio przekształca tekst w mowę , ale z poziomem płynności i niuansów zbliżonym do ludzkiej mowy. VibeVoice został pierwotnie wydany w wersjach z parametrami 1.5B i 7B , zaprojektowanych w celu zrównoważenia jakości i możliwości generowania długich strumieni audio bez nadmiernego zużycia zasobów.
Jedną z jego największych zalet jest możliwość ciągłego nagrywania do 90 minut materiału audio , zachowując spójność głosu i intonację. Dzięki temu jest szczególnie przydatny w przypadku całych podcastów, rozdziałów audiobooków lub długich odcinków materiałów edukacyjnych, gdzie wcześniej wymagane były liczne sesje nagraniowe z udziałem aktorów głosowych.
Co więcej, VibeVoice został zaprojektowany do obsługi do czterech różnych głosów w jednym nagraniu audio , umożliwiając symulowanie wywiadów, dyskusji panelowych, dialogów między postaciami lub odcinków z narracją różnych aktorów głosowych. Ta obsługa wielu głośników jest kluczowa dla zwiększenia dynamiki i wciągających podcastów opartych na sztucznej inteligencji.
Jak działa VibeVoice: zaawansowana synteza mowy i niskie opóźnienie
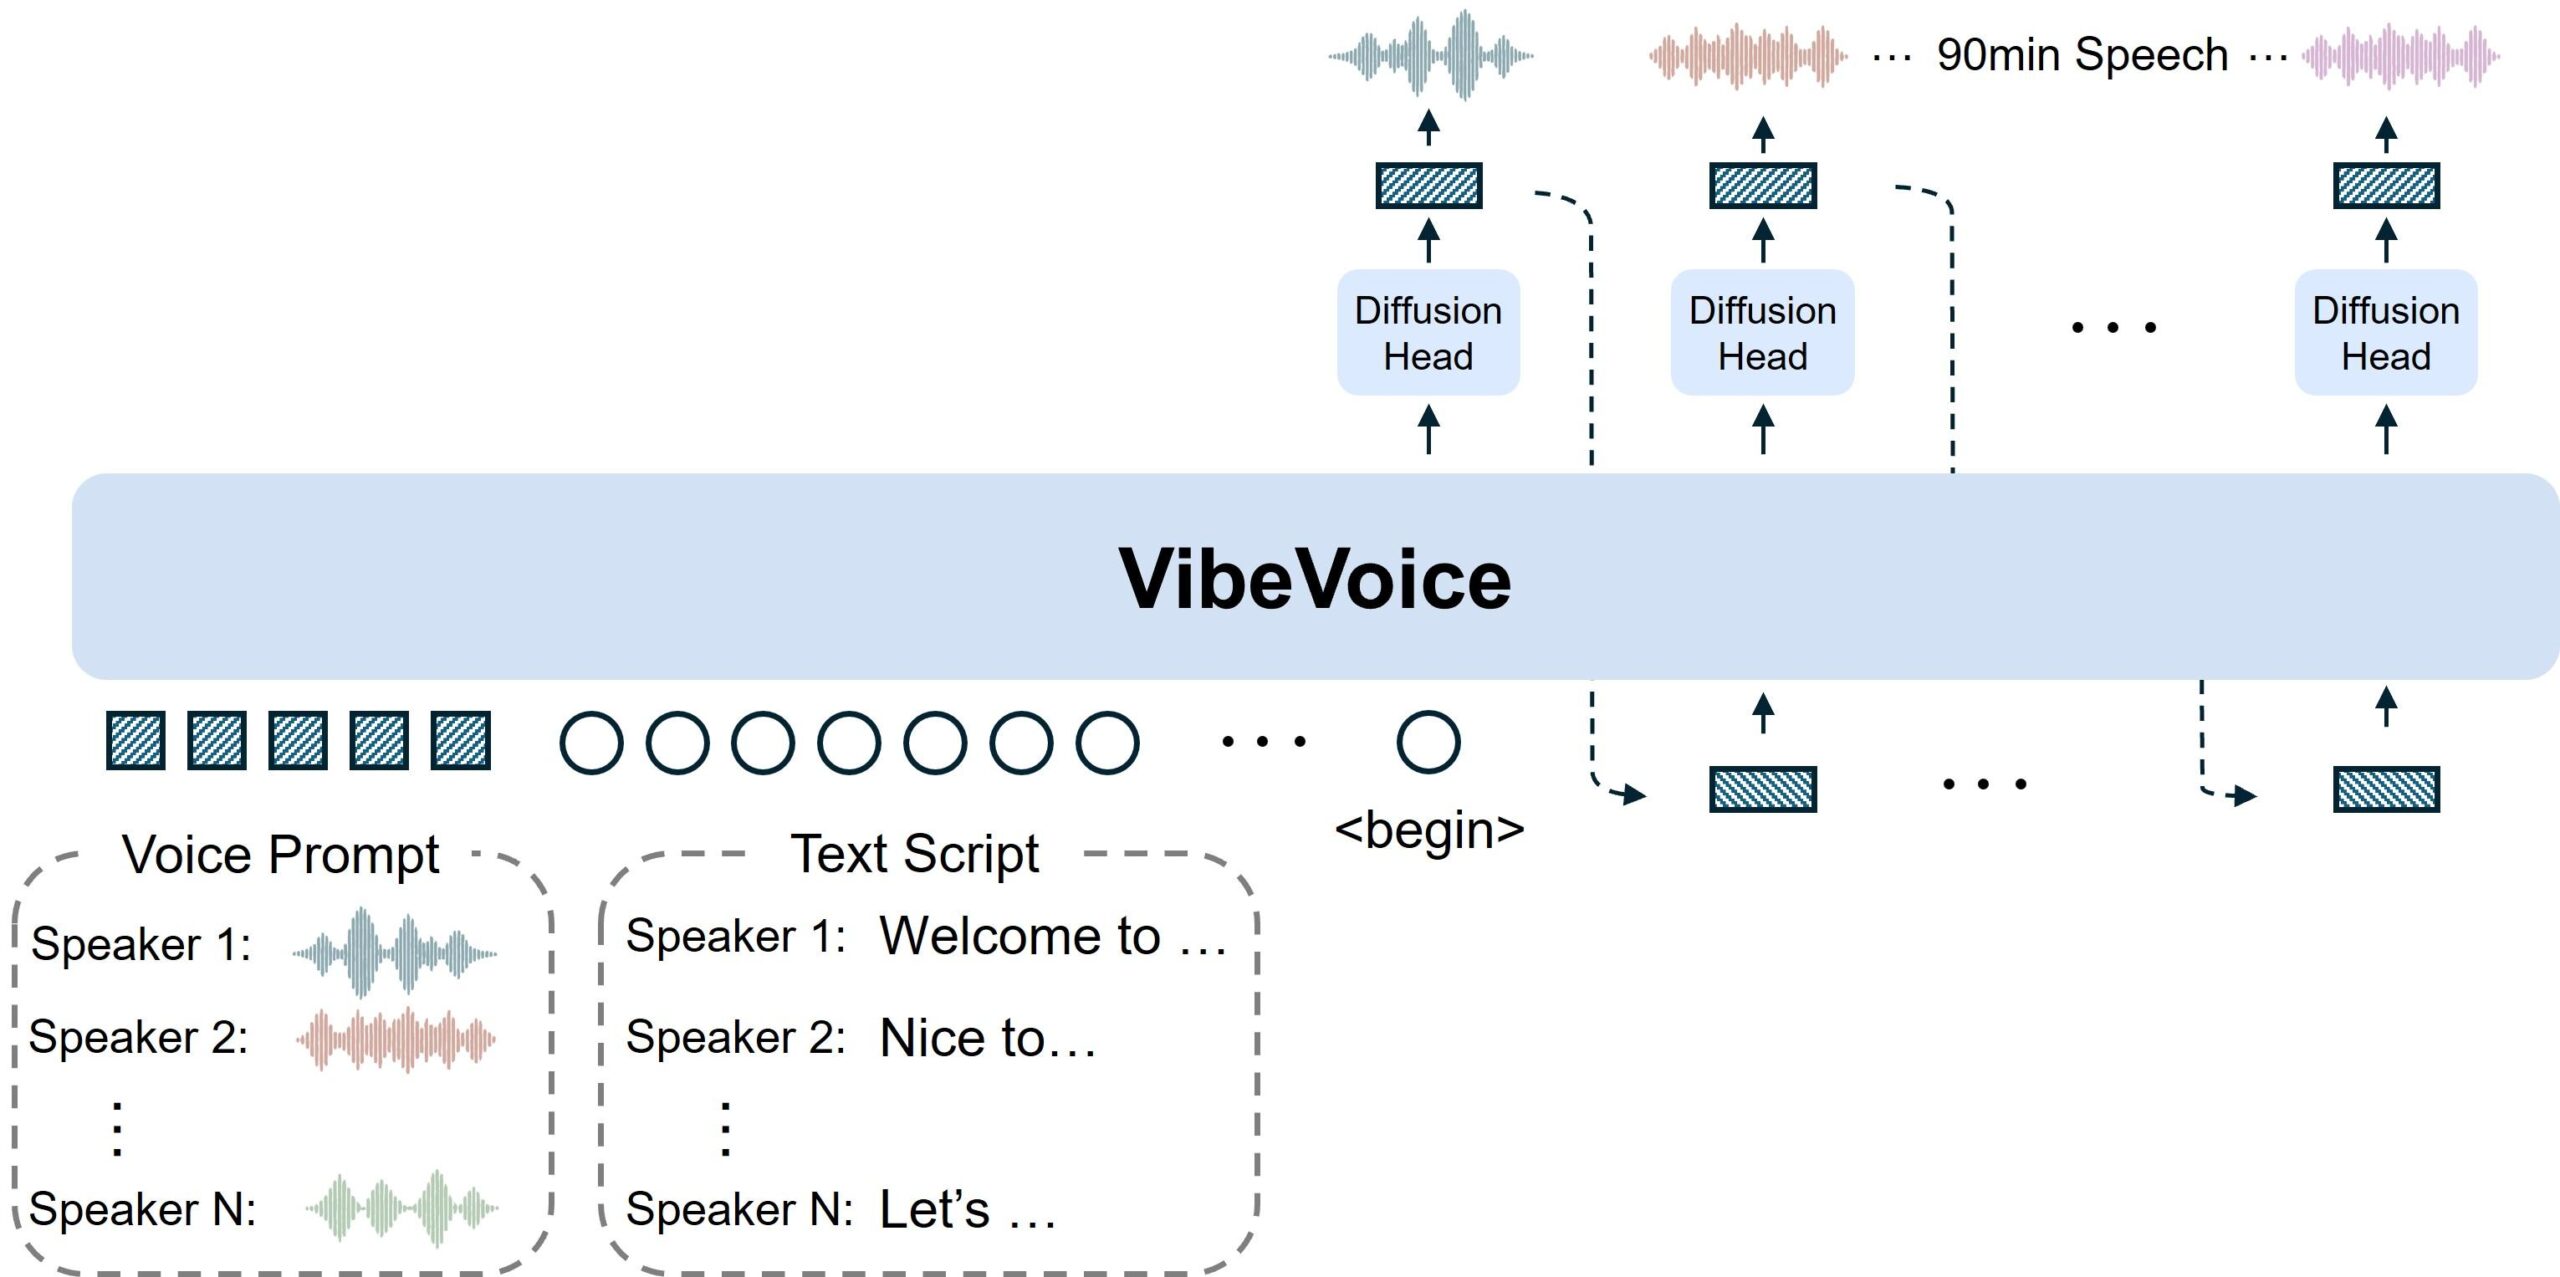
Poza przyciągającym wzrok nagłówkiem, to, co wyróżnia VibeVoice, to jego architektura techniczna zaprojektowana z myślą o długich nagraniach audio i rozmowach . Microsoft łączy kilka komponentów, aby głos brzmiał naturalnie, dostosowywał się do tekstu i był generowany w czasie rzeczywistym lub niemal rzeczywistym.
System wykorzystuje ciągłe tokenizery mowy akustycznej i semantycznej , które działają na bardzo niskiej częstotliwości, około 7,5 Hz. Oznacza to, że kondensuje informacje audio do mniejszej liczby „kroków” na sekundę niż inne modele, zachowując wierność dźwięku i jednocześnie znacznie redukując koszty obliczeniowe podczas pracy z długimi sekwencjami.
Oprócz tej skompresowanej reprezentacji, do gry wchodzi model dużego języka (LLM) , który odpowiada za interpretację treści skryptu, przebiegu rozmowy i tego, kto w danym momencie mówi. W ten sposób rozpoznaje, czy jest to pytanie, odpowiedź, ironiczny komentarz, czy zmiana tematu, i odpowiednio dostosowuje ton głosu.
Na koniec głowica dyfuzyjna rekonstruuje wysokiej jakości detale akustyczne: barwę dźwięku, fakturę wokalu, subtelne oddechy i inne niuanse. To połączenie LLM i dyfuzji gwarantuje, że uzyskany dźwięk jest spójny, ekspresyjny i przyjemny w odbiorze przez dłuższy czas.
Równocześnie Microsoft wprowadził na rynek specjalną wersję o nazwie VibeVoice-Realtime-0.5B , zaprojektowaną z myślą o wyjątkowo szybkich odpowiedziach: model ten może rozpocząć emisję głosu około 300 milisekund po odebraniu tekstu. Oznacza to, że praktycznie w czasie rzeczywistym, idealnie nadaje się dla agentów głosowych, asystentów konwersacyjnych lub aplikacji, w których wymagane jest minimalne opóźnienie.
Dostępne wersje: modele, parametry i zalecane zastosowania
W ekosystemie VibeVoice wprowadzono kilka wersji o różnych rozmiarach i orientacjach , przeznaczonych zarówno do długich nagrań audio, jak i aplikacji interaktywnych.
Z jednej strony mamy główne warianty z parametrami 1.5B i 7B , zaprojektowane do obsługi rozbudowanych treści, takich jak pełne podcasty, symulowane audycje radiowe, rozdziały audiobooków czy kursy audio. Większa liczba parametrów pozwala na większą przepustowość w zakresie wychwytywania niuansów i zarządzania złożonymi dialogami, choć jednocześnie zwiększa wymagania sprzętowe.
Z drugiej strony, wersja VibeVoice-Realtime-0.5B stawia na szybkość reakcji, a nie na rozmiar modelu. Chociaż ma „tylko” 0,5B parametrów , czyli niewiele w porównaniu z takimi gigantami jak ChatGPT czy Gemini, to właśnie to pozwala jej na generowanie do 90 minut ciągłego dźwięku, zachowując jednocześnie czysty głos i stabilną intonację.
Ta wersja w czasie rzeczywistym jest szczególnie atrakcyjna dla konsultantów głosowych, chatbotów, asystentów wirtualnych i wszelkich aplikacji, w których użytkownik oczekuje natychmiastowej odpowiedzi AI za pomocą głosu, a nie tylko tekstu. Z opóźnieniami bliskimi 300 ms, doświadczenie jest bardzo zbliżone do rozmowy z osobą po drugiej stronie.
We wszystkich przypadkach model jest przeznaczony do użytku w środowiskach lokalnych lub badawczych , ponieważ Microsoft początkowo zdecydował się udostępnić go jako projekt typu open source, dostępny w serwisie GitHub oraz na platformach takich jak Hugging Face, dzięki czemu społeczność może łatwo go testować, dostosowywać i tworzyć na jego podstawie narzędzia.
Praktyczne zastosowania: jak stworzyć podcast za pomocą VibeVoice
Jedną z flagowych aplikacji VibeVoice jest niewątpliwie tworzenie podcastów bez udziału aktorów głosowych . Dla każdego, kto ma pomysły, scenariusze lub tekst, ale nie odważy się stanąć przed mikrofonem, ten model otwiera ogromne możliwości.
Ogólny proces tworzenia podcastu w VibeVoice zazwyczaj obejmuje przygotowanie dobrze ustrukturyzowanego scenariusza : wstępu, bloków treści, potencjalnych wywiadów (prawdziwych lub fikcyjnych), przejść i zakończenia. Im bardziej przejrzysty tekst, tym lepiej model może uchwycić zmiany tonu, pauzy i role każdej „osoby” w rozmowie.
Następnie, korzystając z narzędzi opartych na tym modelu (skryptów, interfejsów graficznych lub integracji z innymi aplikacjami), każda część tekstu jest przypisywana do jednego z dostępnych mówców . Możemy na przykład użyć jednego głosu dla prezentera, innego dla powracającego gościa, innego do pytań czytanych przez publiczność, a czwartego do notatek informacyjnych lub sponsorowanych segmentów.
Model generuje ciągły dźwięk , zachowując kolejność skryptu, przejścia głosowe i rytm rozmowy. Następnie wynik można dopracować w tradycyjnym edytorze audio, dodając muzykę w tle, efekty dźwiękowe, przejścia lub wprowadzając drobne zmiany w głośności i korekcji dźwięku.
Dzięki możliwości generowania do 90 minut materiału bez utraty spójności możemy stworzyć cały odcinek na raz: nie ma potrzeby nagrywania w małych blokach ani martwienia się o zmęczenie głosu, błędy dykcyjne czy hałas w tle, co w fizycznej kabinie jest stałym bólem głowy.
Klonowanie głosu za pomocą sztucznej inteligencji i personalizacja głosu
Jednym z najdelikatniejszych, a zarazem najpotężniejszych postępów w tej technologii jest „klonowanie głosu”, czyli klonowanie głosu wspomagane sztuczną inteligencją . Polega ono na technikach syntezy opartych na uczeniu głębokim, które pozwalają na replikację barwy, wzorców mowy i niuansów konkretnego głosu.
W praktyce systemy te analizują unikalne cechy głosu docelowego, takie jak barwa, formanty, rytm mowy i wzorce prozodyki (pauzy, akcenty, intonacja pytająca itp.). Na podstawie zaledwie kilku sekund próbki są w stanie wygenerować syntetyczny głos, który jest bardzo zbliżony do oryginału.
W przypadku VibeVoice wspomniano, że możliwe jest uzyskanie bardzo dokładnych symulacji przy użyciu zaledwie 10 sekund oryginalnego dźwięku , co pozwala na doskonałe uchwycenie emocjonalnego wpływu i faktury głosu. W przypadku podcastów otwiera to możliwości, takie jak utrzymanie „głosu marki” nawet po zakończeniu nagrywania przez osobę mówiącą, czy tworzenie powtarzających się postaci o spójnej tożsamości głosowej.
Jednakże taka możliwość wiąże się z bardzo poważnym ryzykiem etycznym i koniecznością wykrywania syntetycznego dźwięku :
Z tego powodu Microsoft podkreśla, że VibeVoice jest udostępniany w ramach badań i z wyraźnymi ostrzeżeniami: nie należy go używać do kradzieży tożsamości, oszustw, manipulacji ani kampanii dezinformacyjnych. Odpowiedzialne korzystanie z niego jest kluczowym elementem całego ekosystemu.
Korzyści dla twórców treści i małych projektów
Dysponując komputerem zdolnym do uruchomienia modelu i dysponując czasem na pisanie skryptów, można w ciągu kilku minut przekonwertować długie teksty na profesjonalne audio . Dotyczy to podcastów informacyjnych, serwisów informacyjnych, opowiadań fikcyjnych, powieści w odcinkach, a nawet instrukcji technicznych z narracją.
Jest to również świetna pomoc w recyklingu istniejących treści pisanych : artykuły blogowe, newslettery, wątki w mediach społecznościowych czy raporty można przekształcić w nagrania audio, które poszerzają zasięg przekazu i oferują wygodniejszy sposób przekazu dla tych, którzy wolą słuchać niż czytać.
Kolejną zaletą jest spójność jakości w czasie . Podczas gdy ludzki aktor głosowy może zmieniać swoją energię, intonację i klarowność w zależności od dnia, sztuczna inteligencja utrzymuje stały poziom, co ułatwia produkcję seriali: kilka odcinków nagranych w jednym ujęciu zachowa tę samą obecność i styl głosu.
W sektorze edukacyjnym VibeVoice doskonale sprawdza się w przypadku kursów audio, czytań z przewodnikiem oraz materiałów dostępnych dla osób z dysfunkcją wzroku lub tych, którzy po prostu wolą uczyć się poprzez słuchanie, wykonując jednocześnie inne zadania. Możliwość generowania wersji mówionych lekcji lub obszernych dokumentów oferuje bogactwo możliwości.
Ryzyko, ograniczenia i decyzja firmy Microsoft dotycząca repozytorium
Drugą stroną medalu jest to, że sztuczna inteligencja zdolna do naśladowania ludzkiego głosu i generowania realistycznej mowy budzi poważne obawy etyczne i związane z bezpieczeństwem. Ryzyko złośliwego wykorzystania jest realne, a duże firmy technologiczne są tego coraz bardziej świadome.
W samym tekście startowym Microsoft wyraźnie stwierdza, że VibeVoice nie powinien być używany do deepfake'ów, kradzieży tożsamości ani działań niezgodnych z prawem . Firma wyraźnie zabrania również jego używania w kontekście dezinformacji lub oszustw, właśnie dlatego, że jego poziom realizmu może łatwo wprowadzić w błąd niczego niepodejrzewających słuchaczy.
Chociaż generowany głos jest bardzo przekonujący, twórcy modelu podkreślają, że wciąż nie oddaje on wszystkich subtelności prawdziwego głosu ludzkiego : oddechy, mikrowariacje emocjonalne, pewne naturalne pauzy i zmiany rytmu są nadal bogatsze u człowieka niż w sztucznej inteligencji. Ta „niedoskonałość” może częściowo pomóc w wykryciu, że mamy do czynienia z głosem syntetycznym, ale granica ta staje się coraz bardziej niewyraźna.
Po udostępnieniu projektu jako otwartego frameworka badawczego , Microsoft wykrył przypadki, w których model był wykorzystywany w sposób niezgodny z jego pierwotnym przeznaczeniem i zasadami odpowiedzialnego użytkowania. W odpowiedzi firma ogłosiła, że została zmuszona do tymczasowego wyłączenia repozytorium do czasu zapewnienia, że takie przypadki użycia wykraczające poza zakres nie będą już miały miejsca.
W oświadczeniu podkreślono, że odpowiedzialne korzystanie ze sztucznej inteligencji jest podstawową zasadą firmy Microsoft i że firma woli wstrzymywać się z jej wdrażaniem i weryfikować je, niż utrzymywać narzędzie, które mogłoby sprzyjać poważnym nadużyciom. Mimo to dokumentacja, dema i materiały techniczne już zainspirowały społeczność i przyczyniły się do dalszego rozwoju dziedziny syntezy mowy.
Inne zastosowania poza podcastingiem
Chociaż uwaga mediów skupiła się głównie na podcastach, VibeVoice otwiera dość szeroki wachlarz zastosowań w świecie dźwięku generowanego przez sztuczną inteligencję. Wiele z nich wpisuje się również w strategie tworzenia treści cyfrowych i automatyzacji.
Jednym z najbardziej oczywistych przykładów są audiobooki i opowiadania , w których ekspresyjne głosy, zdolne utrzymać uwagę słuchacza przez dziesiątki minut, są kluczowe. Obsługa wielu lektorów pozwala każdej postaci mówić własnym głosem, co znacznie poprawia wrażenia słuchowe w porównaniu z pojedynczym narratorem.
W obszarze agentów głosowych i asystentów konwersacyjnych, wersja VibeVoice działająca w czasie rzeczywistym sprawdza się idealnie. Bot, który odpowiada z opóźnieniem zaledwie 300 ms, brzmi znacznie bardziej naturalnie niż ten, którego mówienie zajmuje kilka sekund, co sprawia, że interakcje z obsługą klienta, chatbotami i interfejsami głosowymi są znacznie płynniejsze.
Kolejnym bardzo ciekawym obszarem jest automatyzacja treści : podsumowania wiadomości, aktualizacje rynkowe, raporty okresowe, a nawet odczyty i powiadomienia e-mailowe można generować bez ingerencji człowieka, zachowując spójność przekazu z wizerunkiem marki.
Wreszcie, istnieją bardziej eksperymentalne zastosowania, takie jak tworzenie fikcyjnych dialogów, symulowanych wywiadów czy programów rozrywkowych tworzonych w całości przez sztuczną inteligencję . W tym przypadku modele językowe do pisania scenariuszy łączą się z VibeVoice do podkładania głosu, tworząc formaty, które do niedawna wydawały się science fiction.
Patrząc całościowo, VibeVoice wyróżnia się jako kluczowy gracz w nowej fali dźwięku generowanego przez sztuczną inteligencję , zdolny do łączenia naturalnych głosów, rozmów wieloosobowych, bardzo długich klipów audio i niemal natychmiastowych odpowiedzi. Używany odpowiedzialnie i zgodnie z ustalonymi normami etycznymi, może stać się niezwykle potężnym narzędziem dla każdego, kto chce uruchomić lub rozwinąć podcast, produkować audiobooki lub dodać profesjonalne podkłady głosowe do swoich projektów cyfrowych, bez konieczności korzystania z tradycyjnego studia nagraniowego.

Wskaźnik
- 1 Czym jest VibeVoice i dlaczego jest tak ważny dla podcastów?
- 2 Jak działa VibeVoice: zaawansowana synteza mowy i niskie opóźnienie
- 3 Dostępne wersje: modele, parametry i zalecane zastosowania
- 4 Praktyczne zastosowania: jak stworzyć podcast za pomocą VibeVoice
- 5 Klonowanie głosu za pomocą sztucznej inteligencji i personalizacja głosu
- 6 Korzyści dla twórców treści i małych projektów
- 7 Ryzyko, ograniczenia i decyzja firmy Microsoft dotycząca repozytorium
- 8 Inne zastosowania poza podcastingiem