- Różnice architektoniczne pomiędzy procesorami CPU i GPU umożliwiające wykonywanie obliczeń równoległych na dużą skalę.
- Strategie wdrażania w chmurze wykorzystujące standardowe, punktowe i elastyczne modele provisionowania.
- Kryteria techniczne przy wyborze sprzętu oparte na pamięci VRAM, przepustowości i opóźnieniu.
- Zaawansowane systemy programowania i globalnej orkiestracji w celu optymalizacji wykorzystania klastrów AI.

Mówiąc o surowej mocy obliczeniowej do przetwarzania gór danych, nie sposób nie wspomnieć o fundamentalnej roli, jaką odgrywają jednostki przetwarzania grafiki. Choć pierwotnie zostały zaprojektowane z myślą o tym, by gry wideo wyglądały niesamowicie, dziś stanowią główny silnik sztucznej inteligencji i analizy ogromnych ilości danych, umożliwiając wykonanie zadań, które wcześniej zajmowały tygodnie, w zaledwie kilka godzin.
Przeniesienie tych obciążeń do chmury zmieniło zasady gry dla deweloperów i analityków danych. Nie trzeba już wydawać fortuny na sprzęt, który szybko się starzeje; zamiast tego możemy wynająć moc obliczeniową dostosowaną do naszych rzeczywistych potrzeb, skalując zasoby zgodnie z projektem i optymalizując każdą złotówkę zainwestowaną w infrastrukturę.

CPU kontra GPU: jaka jest prawdziwa różnica?
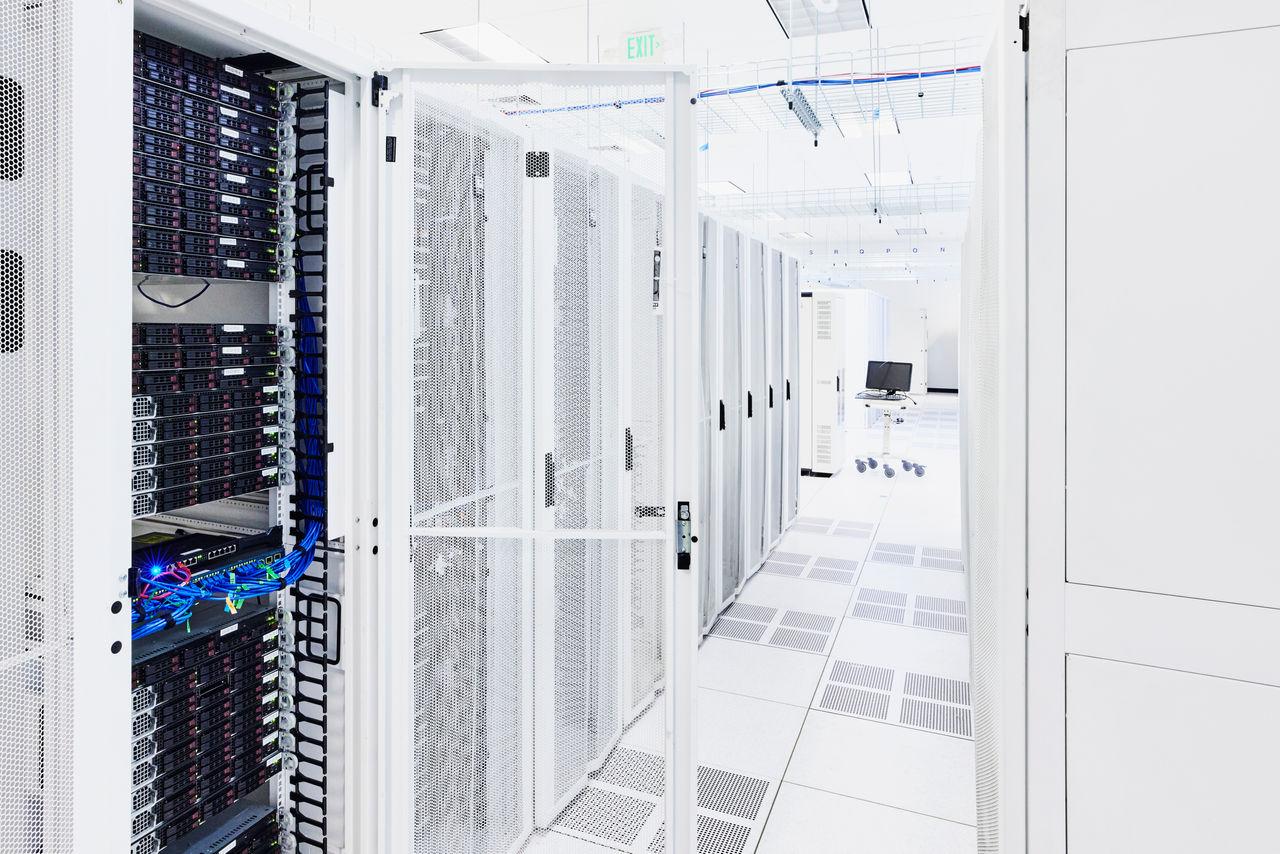
Mówiąc prościej, procesor jest jak wysoce inteligentny dyrygent, który potrafi wszystko, ale przetwarza zadania jedno po drugim. Natomiast procesor graficzny (GPU) jest jak armia tysięcy pracowników specjalizujących się w wykonywaniu tej samej operacji matematycznej w kółko, ale jednocześnie. To jest podstawa tego, co nazywamy obliczeniami równoległymi.
Podczas gdy procesor (CPU) obsługuje złożoną logikę i sterowanie systemem, GPU doskonale radzi sobie z przetwarzaniem matryc i renderowaniem obrazu. Dzięki setkom, a nawet tysiącom rdzeni , podobnym do architektury procesorów wielordzeniowych , ale na ogromną skalę, może wykonywać wiele podzbiorów zadań jednocześnie – co jest kluczowe dla szkolenia sieci neuronowych lub przetwarzania terabajtów danych bez awarii systemu.
Zarządzanie zadaniami wsadowymi i w czasie rzeczywistym
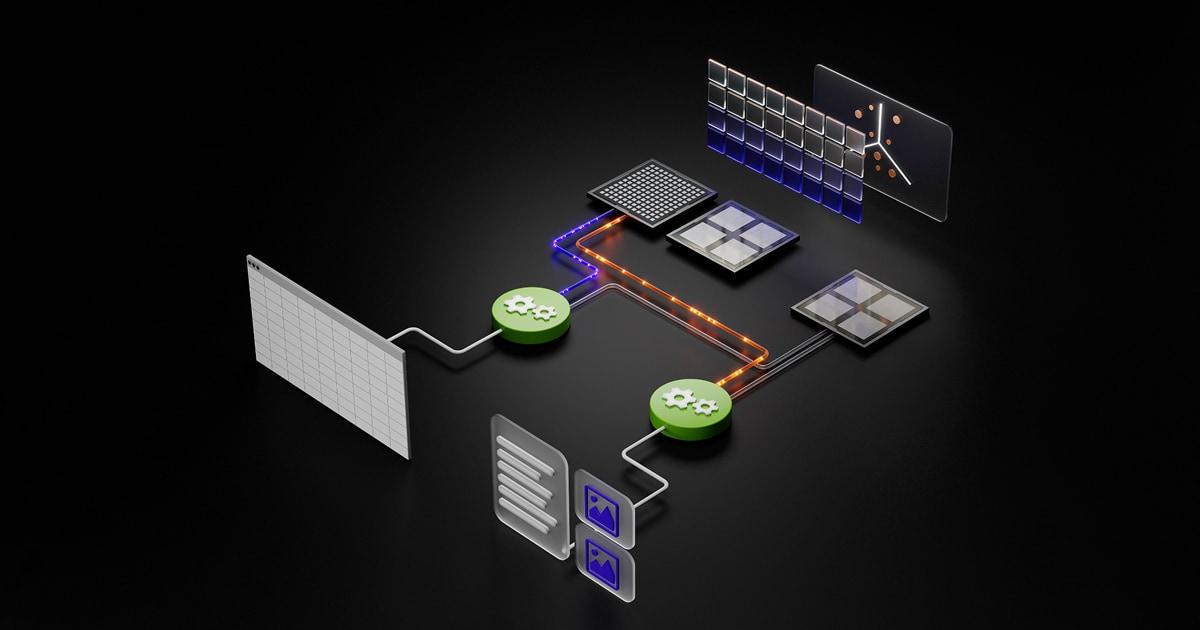
W ekosystemie chmury istnieją dwa główne sposoby wykonywania tych zadań. Przetwarzanie wsadowe idealnie sprawdza się w przypadku zadań, które nie wymagają natychmiastowej reakcji, takich jak wstępne przetwarzanie danych czy masowe wnioskowanie. Celem jest maksymalizacja efektywności i ogólnej wydajności systemu poprzez umożliwienie akumulacji i uruchamiania zadań, gdy zasoby są dostępne.
Z drugiej strony, przetwarzanie w czasie rzeczywistym ma kluczowe znaczenie dla aplikacji, które muszą reagować natychmiast, takich jak generatywne chatboty oparte na sztucznej inteligencji (AI) czy systemy rozpoznawania twarzy. W takich przypadkach priorytetem jest niskie opóźnienie i wysoka dostępność, aby użytkownik końcowy nie odczuł żadnych opóźnień podczas przetwarzania informacji przez model.
Aby skonfigurować taki projekt, kluczowe jest zaplanowanie wymagań. Od wyboru odpowiedniej maszyny po instalację sterowników (która może odbywać się automatycznie lub ręcznie z wykorzystaniem niestandardowych obrazów), każdy krok wpływa na to, czy proces przebiegnie sprawnie, czy będzie stanowił problem techniczny.
Modele konsumpcji i optymalizacja kosztów
Nie wszystkie maszyny wirtualne są sobie równe i nie wszystkie kosztują tyle samo. Dla tych, którzy chcą zaoszczędzić, maszyny wirtualne Spot są kuszącą opcją, oferującą ogromne rabaty, choć wiążą się z ryzykiem odzyskania ich przez chmurę w dowolnym momencie. Idealnie nadają się do zadań odpornych na błędy, gdzie priorytetem jest koszt.
Jeśli potrzebujesz czegoś bardziej stabilnego, ale w niższej cenie, dostępne są elastyczne maszyny wirtualne dla start-upów , które umożliwiają dostęp do zasobów GPU po obniżonych cenach w zamian za kilkudniowe opóźnienie przed rozpoczęciem prac. W przypadku projektów o znaczeniu krytycznym dostępne są standardowe usługi provisioningu na żądanie lub rezerwacje zaplanowane , które gwarantują, że sprzęt będzie dostępny dokładnie wtedy, gdy go potrzebujesz.

Zaawansowaną techniką maksymalizacji budżetu jest regionalny arbitraż kosztów . Wykorzystanie wahań cen w różnych obszarach geograficznych lub harmonogramowanie „podążające za słońcem” pozwala zespołom w Azji, Europie i obu Amerykach na zmianę korzystać z klastrów, osiągając niemal 100% wykorzystanie sprzętu.
Jak wybrać odpowiedni procesor graficzny do swojego zastosowania

Nie chodzi o wybór najdroższej karty, ale o taką, która najlepiej sprawdzi się w danym zadaniu. W trenowaniu dużych modeli językowych (LLM) pamięć wideo (VRAM) jest głównym wąskim gardłem. Jeśli zabraknie pamięci VRAM, konieczne będzie zmniejszenie rozmiarów wsadów, co znacznie wydłuży czas wykonywania i ogólne koszty.
- Szkolenie AI: Wymaga dużej mocy w trybie mieszanej precyzji (FP16/BF16) i dużej pamięci VRAM do obsługi gradientów i stanów optymalizatora.
- Wnioskowanie w czasie rzeczywistym: W tym przypadku opóźnienia sieciowe i stabilność stosu oprogramowania są kluczowe dla zapobiegania przerwom w produkcji.
- Nauka o danych: Dąży się do zachowania równowagi między procesorem, pamięcią RAM i kartą graficzną, ponieważ czyszczenie danych w dużej mierze nadal odbywa się sekwencyjnie.
- Renderowanie 3D i efekty wizualne: Ich działanie jest w dużym stopniu uzależnione od przepustowości pamięci, co umożliwia szybkie przenoszenie złożonych tekstur i obiektów geometrycznych.
- Obliczenia naukowe: Priorytetem jest dokładność FP32 lub FP64 i pełna powtarzalność wyników dzięki stałym wersjom sterowników.
Monitorowanie przepływu danych w systemie jest kluczowe . Posiadanie ultrawydajnego procesora graficznego (GPU) jest bezużyteczne, jeśli procesor lub pamięć masowa działają wolno; w takim przypadku procesor graficzny będzie spędzał większość czasu w stanie bezczynności, oczekując na dane, co jest znane jako niedostateczne wykorzystanie zasobów.
Zaawansowana orkiestracja i przyszłość informatyki
Wraz z rozwojem klastrów, proste planowanie „pierwszy wszedł, pierwszy wyszedł” przestaje działać. Wiodące firmy wdrażają wielopoziomowe hierarchie planowania , które dystrybuują zadania w oparciu o lokalizację danych, priorytety biznesowe i ślad węglowy regionu.

Innowacje, takie jak przełączanie procesora/karty graficznej w czasie rzeczywistym, pozwalają systemowi na bieżąco decydować, który procesor jest najwydajniejszy dla każdego wątku. Rozwiązuje to problem globalnego niedoboru sprzętu poprzez optymalizację każdego dostępnego cyklu zegara, umożliwiając rozwój generatywnej sztucznej inteligencji i cyfrowych bliźniaków bez blokowania ich przez brak układów scalonych.
Wykorzystanie Kubernetesa z technologią dynamicznej alokacji zasobów (DRA) i wieloinstancyjnymi procesorami graficznymi (MIG) umożliwia podzielenie jednej fizycznej karty graficznej na wiele wirtualnych instancji. To demokratyzuje dostęp do obliczeń o wysokiej wydajności, umożliwiając wielu użytkownikom współdzielenie tego samego procesora graficznego bez wzajemnego zakłócania się.
Jasna strategia łącząca odpowiedni sprzęt, inteligentny model płatności i elastyczną organizację to jedyny sposób na uniknięcie marnowania pieniędzy na przetwarzanie w chmurze. Od wyboru pamięci VRAM po wdrożenie instancji Spot, każda decyzja techniczna ma bezpośredni wpływ na szybkość innowacji i rentowność każdego zaawansowanego projektu obliczeniowego.
