- Spójność pamięci podręcznej zapewnia, że wszystkie kopie tych samych danych w różnych pamięciach podręcznych i pamięci RAM pozostają spójne w systemach wielordzeniowych.
- Hierarchia pamięci podręcznej ze współdzielonym ostatnim poziomem ułatwia kontrolę spójności i ogranicza bezpośredni dostęp do pamięci głównej.
- Protokoły spójności wykorzystują strategie unieważniania lub aktualizacji kopii, obsługiwane przez stany i bity kontrolne na linię pamięci podręcznej.
- Kompilator i system operacyjny mogą zapewnić spójność sprzętową poprzez wstawianie instrukcji i konfigurowanie pamięci na krytyczne okresy.
Patrząc na schemat dowolnego współczesnego procesora wielordzeniowego, zawsze pojawia się ten sam schemat: wiele rdzeni, każdy z własną, pobliską pamięcią podręczną, oraz współdzielona pamięć podręczna ostatniego poziomu, która działa jak punkt wspólny przed dotarciem do pamięci RAM. Ten układ nie jest przypadkowy ani kaprysem projektantów, lecz bezpośrednią odpowiedzią na krytyczny problem w systemach równoległych: spójność pamięci podręcznej.
Bez solidnego mechanizmu spójności każdy rdzeń mógłby pracować z inną i nieaktualną wersją tych samych danych w pamięci , co w rzeczywistym programie przekłada się na drobne błędy, nieprzewidywalne awarie, a nawet awarie systemu. Dlatego zrozumienie, w jaki sposób ta spójność jest utrzymywana – zarówno na poziomie sprzętowym, jak i programowym – jest kluczowe dla zrozumienia wydajności i stabilności nowoczesnych procesorów wielordzeniowych.
Czym jest spójność pamięci podręcznej: metafora terminalna

Wyobraź sobie kilka osób siedzących przed różnymi terminalami, edytujących ten sam dokument przechowywany na centralnym serwerze . Każdy ekran wyświetla kopię pliku, a wszelkie zmiany wprowadzone przez jedną osobę mają być natychmiast widoczne na ekranach wszystkich pozostałych.
Aby to zadziałało, potrzebny jest mechanizm synchronizacji, który rozsyła zmiany w dokumencie do wszystkich terminali, tak aby wszyscy zawsze widzieli tę samą wersję. Dopóki ten system działa, wszystko jest w porządku: ktokolwiek modyfikuje tekst, wie, że wszyscy inni zobaczą nową wersję niemal natychmiast.
Wyobraź sobie, że system synchronizacji nagle zawodzi. Każda osoba kontynuuje edycję, przekonana, że pracuje nad współdzielonym dokumentem, ale w rzeczywistości każdy terminal ma swoją własną, odłączoną kopię lokalną . Od tego momentu zmiany wprowadzone przez jedną osobę nie docierają do pozostałych, a dokument zaczyna się niekontrolowanie rozchodzić.
W świecie informatyki dokładnie tak by się stało, gdyby procesor nie dysponował niezawodnym protokołem spójności: jeden rdzeń modyfikuje dane w pamięci, a pozostałe rdzenie kontynuują odczytywanie starszych wersji z prywatnych pamięci podręcznych . To stwarza podatny grunt dla poważnych błędów logicznych, uszkodzonych danych i problemów z debugowaniem.
Spójność pamięci podręcznej to zatem zbiór mechanizmów zapewniających, że w systemie wielordzeniowym wszystkie kopie tych samych danych, rozproszone w różnych pamięciach podręcznych i pamięci RAM, zachowują spójny stan . Nawet jeśli istnieje wiele kopii, system musi zachowywać się „tak, jakby” była tylko jedna.
Pamięci podręczne i hierarchia pamięci w procesorze wielordzeniowym
Pamięć podręczna procesora to mała, bardzo szybka pamięć, która przechowuje kopie często używanych fragmentów pamięci RAM . Kiedy procesor wykonuje kod, zamiast ciągłego dostępu do (stosunkowo wolnej) pamięci RAM, próbuje odczytywać dane z pamięci podręcznej i zapisywać je do niej, co znacznie zmniejsza opóźnienie.
Sztuczka polega oczywiście na tym, że pamięci podręczne nie przechowują „oficjalnej wersji” danych, a jedynie ich tymczasową replikę . Zgodnie z metaforą terminala, pamięć RAM byłaby dokumentem na serwerze, a pamięci podręczne – ekranami lokalnymi, które wyświetlają kopie niektórych fragmentów pliku.
W procesorach wielordzeniowych konstrukcja staje się bardziej złożona, ponieważ każdy rdzeń zazwyczaj ma własną, prywatną pamięć podręczną poziomu 1 (L1), a nawet poziomu 2 (L2) . Dodatkowo dodawana jest współdzielona pamięć podręczna poziomu 3 (na przykład), zlokalizowana między rdzeniami a kontrolerem pamięci, który zapewnia dostęp do pamięci RAM.
Wprowadzono tę współdzieloną pamięć podręczną, ponieważ umożliwienie wszystkim rdzeniom bezpośredniego i intensywnego dostępu do pamięci RAM powodowałoby konflikty dostępu, rywalizację na magistrali pamięci i znaczny spadek wydajności . Pamięć podręczna ostatniego poziomu działa jak wspólny „bufor”, który ogranicza dostęp do pamięci RAM i centralizuje znaczną część ruchu danych.
Co więcej, wiele architektur organizuje pamięć podręczną inkluzywnie: linie przechowywane na poziomach bliskich procesorowi są obecne również na wyższych poziomach hierarchii . Oznacza to, że linia, która pojawia się w L1, znajduje się również w L2, a tym samym w L3. Ma to bardzo pożyteczne konsekwencje dla spójności: samo prawidłowe zaktualizowanie pamięci podręcznej najniższego poziomu wystarcza do kontrolowania stanu pozostałych poziomów bez konieczności ciągłego dostępu do pamięci RAM.
Dlaczego współdzielone buforowanie ostatniego poziomu jest kluczowe dla spójności
Bez tej globalnej pamięci podręcznej ostatniego poziomu, każdy rdzeń musiałby sprawdzać spójność bezpośrednio z pamięcią główną . Za każdym razem, gdy linia pamięci w prywatnej pamięci podręcznej zostałaby zmodyfikowana, konieczne byłoby sprawdzenie, czy inne rdzenie przechowują kopię tej samej linii, a jeśli tak, zaktualizowanie jej lub unieważnienie wszędzie.
W systemie z wieloma rdzeniami, takie obciążenie sprawdzaniem skutkowałoby ogromną liczbą transakcji w pamięci RAM , niwecząc znaczną część korzyści płynących z szybkich pamięci podręcznych. Umieszczając współdzieloną pamięć podręczną między rdzeniami a pamięcią, procesor może skoncentrować kontrolę spójności w jednym, pośrednim miejscu.
W wielu implementacjach pamięci podręczne na wyższych poziomach (dalej od procesora) zawierają kopie wierszy obecnych na poziomach bliższych rdzeniowi . Dzięki takiej organizacji protokół spójności musi jedynie zapewnić synchronizację ostatniego poziomu z pamięcią główną oraz synchronizację poziomów prywatnych każdego rdzenia z poziomem bezpośrednio nad nim.
Można to zwizualizować jako rodzaj rosyjskiej matrioszki: pamięć podręczna trzeciego poziomu zawiera zawartość drugiego i pierwszego poziomu , drugi poziom zawiera swoją własną zawartość i zawartość pierwszego poziomu, a pierwszy poziom zna tylko własne linie. W ten sposób, kontrolując „dużą lalkę” (ostatni poziom), system może wydajniej koordynować pozostałe.
W rezultacie utrzymanie spójności staje się bardziej ekonomiczne pod względem projektu i ruchu pamięci . Zamiast zmuszać każdy rdzeń do ciągłego przetwarzania danych z pamięci RAM, protokół działa na współdzielonej pamięci podręcznej i stamtąd zarządza, które linie powinny zostać zaktualizowane lub unieważnione w prywatnych pamięciach podręcznych.
Metody aktualizacji: unieważnianie i aktualizacja kopii
Krytyczny problem pojawia się, gdy dwa lub więcej rdzeni chce uzyskać dostęp, niemal jednocześnie, do tej samej linii danych, która jest replikowana w wielu pamięciach podręcznych . W tym kontekście systemy spójności zazwyczaj stosują dwie podstawowe strategie obsługi zapisów.
Pierwsza metoda opiera się na unieważnianiu. Gdy jądro musi zapisać dane do określonej linii pamięci podręcznej, protokół unieważnia wszelkie kopie tej samej linii, które mogą istnieć w innych pamięciach podręcznych . Tylko jądro, które ma zamiar zapisać dane, utrzymuje linię w stanie umożliwiającym odczyt i zapis; pozostałe, aby ponownie wykorzystać te dane, będą musiały ponownie załadować linię z wyższego poziomu (lub z pamięci) z zaktualizowaną wersją.
Druga strategia polega na aktualizacji. W tym przypadku, gdy jądro modyfikuje wiersz, system próbuje automatycznie rozpowszechnić nową zawartość do istniejących kopii w pozostałych pamięciach podręcznych . W ten sposób wszystkie pamięci podręczne, które przechowywały dany wiersz, otrzymują zaktualizowaną wersję bez konieczności jej późniejszego unieważniania i ponownego ładowania.
Każde podejście ma swoje wady i zalety. Unieważnianie jest zazwyczaj bardziej wydajne, gdy zapisy są częste, ponieważ pozwala uniknąć przeciążenia systemu pamięci aktualizacjami, których inne rdzenie mogą nie potrzebować natychmiast. Z drugiej strony, aktualizacja może być korzystna, gdy wiele rdzeni często odczytuje te same dane, które są modyfikowane stosunkowo rzadko , ponieważ zmniejsza opóźnienie, ponieważ nie wymaga przeładowywania wiersza po każdym unieważnieniu.
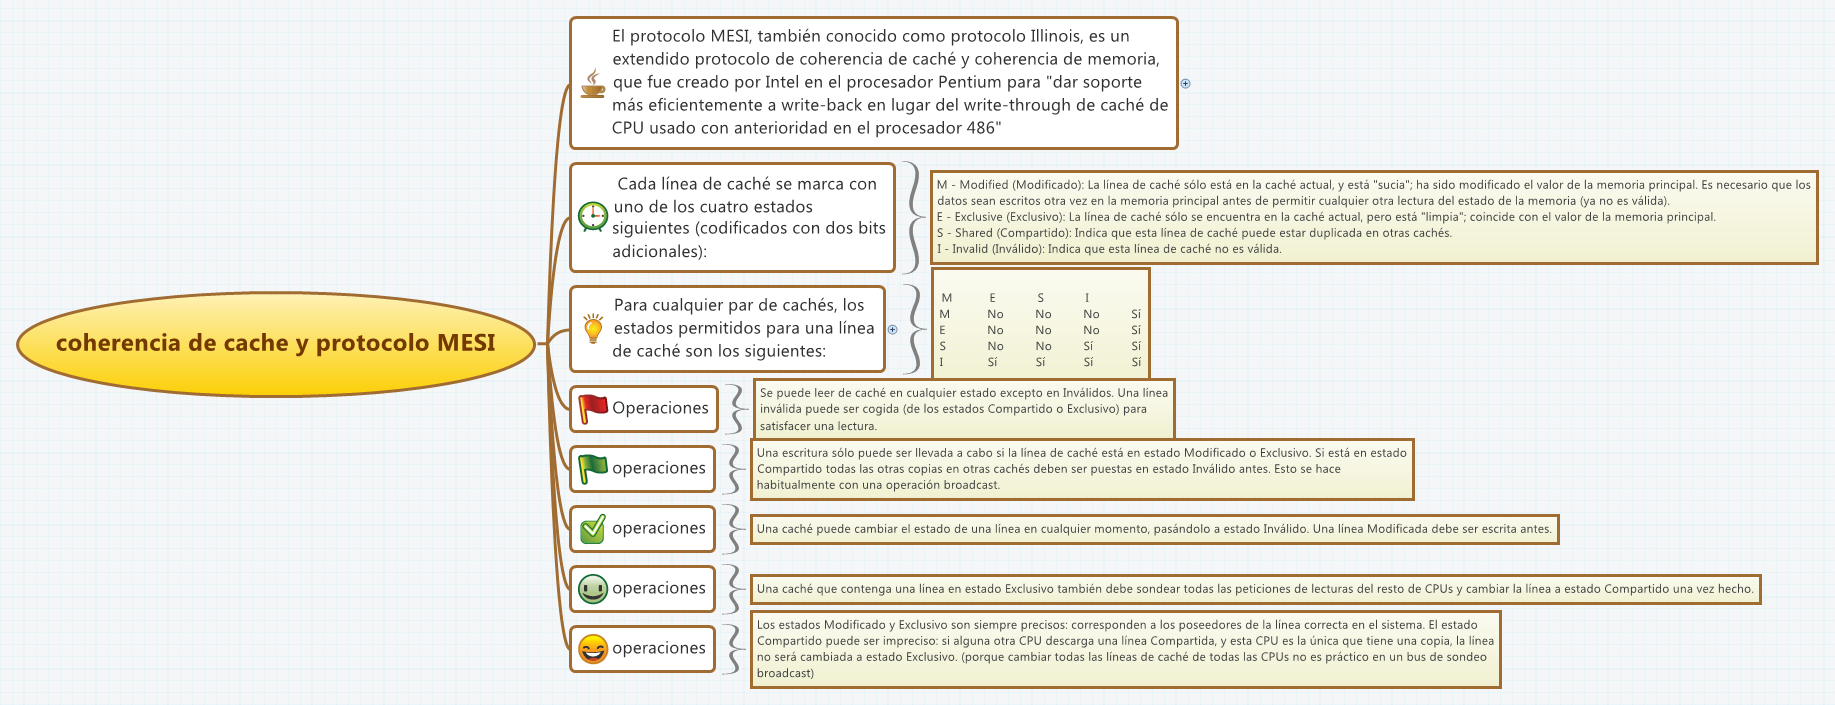
W obu przypadkach obie metody wykorzystują dodatkowe stany i bity sterujące w liniach pamięci podręcznej. Każda linia zazwyczaj zawiera informacje o tym, czy jej zawartość jest zgodna z zawartością pamięci RAM oraz czy jest współdzielona, modyfikowana, wyłączna, zarezerwowana itd., w zależności od konkretnego protokołu (MESI, MOESI, MSI itd.). Pozwala to sprzętowi na szybkie podejmowanie decyzji o tym, co zrobić, gdy operacja odczytu lub zapisu wystąpi na już zreplikowanej linii.
Sprawdzanie spójności między pamięcią podręczną a pamięcią operacyjną
Bezpośrednia weryfikacja spójności między wszystkimi poziomami pamięci podręcznej procesora CPU lub GPU a pamięcią główną byłaby gigantycznym zadaniem, zarówno pod względem złożoności projektu, jak i kosztów wydajności. Dlatego współczesne systemy organizują tę weryfikację hierarchicznie.
Pamięci podręczne najbliżej procesora (L1, L2) zazwyczaj nie są połączone bezpośrednio z pamięcią RAM, lecz z kolejnym poziomem pamięci podręcznej. Oznacza to, że spójność nie jest weryfikowana względem pamięci głównej na każdym poziomie, lecz względem poziomu bezpośrednio wyższego . Zmniejsza to liczbę dostępów do pamięci RAM i upraszcza logikę wymaganą na niższych poziomach.
Ostatecznie porównanie zawartości pamięci podręcznej z zawartością pamięci RAM odbywa się między pamięcią podręczną ostatniego poziomu a pamięcią główną . Jeśli ten ostatni poziom utrzymuje poprawny i spójny stan, a każdy niższy poziom zachowuje spójność z poziomem powyżej, cała hierarchia pozostaje spójna bez konieczności wielokrotnego sprawdzania każdego wiersza w pamięci RAM.
Gdy jądro zapisuje dane do wiersza pamięci podręcznej i zmienia jego stan, stan tego wiersza jest oznaczany, wskazując, że nie jest on już dokładnie zgodny z kopią przechowywaną w pamięci . Następnie protokół koordynuje aktualizację: oznacza odpowiadające mu kopie w innych pamięciach podręcznych jako zarezerwowane lub nieprawidłowe i, w razie potrzeby, zapisuje nową zawartość do odpowiedniego wiersza pamięci głównej.
Taka kaskadowa organizacja pozwala na progresywną propagację zmian z jądra, które aktualizuje dane, do pamięci głównej, przechodząc przez każdy poziom pamięci podręcznej w kontrolowany sposób. W ten sposób utrzymanie spójności nie staje się niemożliwym do pokonania wąskim gardłem dla procesora.
Spójność sprzętowa kontra spójność programowa
Do tej pory omawialiśmy mechanizmy spójności implementowane głównie sprzętowo: protokoły, bity stanu, współdzielone pamięci podręczne itd. Istnieje jednak inne podejście, którego celem jest przeniesienie części tej złożoności na oprogramowanie , a konkretnie na kompilator i system operacyjny.
Schematy spójności oparte na oprogramowaniu dążą do ograniczenia zapotrzebowania na dodatkową logikę na chipie poprzez analizę kodu i podejmowanie decyzji w czasie kompilacji . Idea polega na tym, że jeśli kompilator potrafi wywnioskować, kiedy i jak następuje dostęp do określonych współdzielonych danych, w wielu przypadkach może zapobiec ich buforowaniu lub jawnie zarządzać ich widocznością.
To podejście ma wyraźną zaletę: część obciążenia przenosi się z czasu wykonania na rozwiązywanie konfliktów w czasie kompilacji . Zamiast, aby sprzęt wykrywał i obsługiwał wszystkie konflikty „w locie”, kompilator próbuje je przewidzieć i wygenerować kod, który unika niebezpiecznych sytuacji.
Wadą jest to, że statyczna analiza kodu jest ograniczona, przez co kompilatory są zazwyczaj konserwatywne . Oznacza to, że aby uniknąć naruszenia spójności, często podejmują decyzje, które zmniejszają efektywność pamięci podręcznej. Jeśli podejrzewają, że jakieś dane mogą być problematyczne, często uniemożliwiają ich buforowanie lub wymuszają synchronizację częściej niż jest to absolutnie konieczne.
Dlatego też, chociaż te schematy oprogramowania są atrakcyjne w teorii, zwłaszcza jeśli chodzi o uproszczenie projektowania sprzętu, w praktyce nie zastępują one obsługi spójności zintegrowanej z samym procesorem , lecz raczej uzupełniają ją w niektórych konkretnych scenariuszach.
Rola kompilatora w spójności pamięci podręcznej
Kluczowym elementem podejścia do spójności opartego na oprogramowaniu jest rola kompilatora. Kompilator może przeprowadzić dogłębną analizę kodu i określić, które współdzielone struktury danych mogą być niebezpieczne dla buforowania . Na tej podstawie oznacza te elementy w specjalny sposób lub dostosowuje generowanie kodu.
Najprostszym, a zarazem najbardziej konserwatywnym, podejściem jest zapobieganie buforowaniu współdzielonych zmiennych danych . Oznacza to, że każdy dostęp do tych zmiennych wymusza dostęp do pamięci głównej lub obszaru niebuforowanego. Gwarantuje to spójność, ale traci wiele możliwości wydajnościowych, ponieważ współdzielona struktura może być w rzeczywistości używana prywatnie w pewnych okresach lub tylko do odczytu w innych.
W rzeczywistości problem spójności pojawia się tylko w okresach, w których co najmniej jeden proces może zapisywać do zmiennej, a inny może ją odczytać . Poza tymi krytycznymi okresami zmienna może być traktowana jako przeznaczona wyłącznie do użytku pojedynczego wątku lub nawet jako stała efektywna przez pewien czas, co pozwala na jej buforowanie bez problemów.
Najbardziej zaawansowane strategie kompilacji próbują zidentyfikować te „bezpieczne” okresy, w których zmienna współdzielona może być uznana za niekonfliktową . W tym celu kompilator analizuje ścieżki wykonywania, potencjalne współbieżne dostępy oraz wzorce synchronizacji (blokady, sekcje krytyczne itp.). Na podstawie tej analizy dzieli czas życia zmiennej na fazy: niektóre nadają się do buforowania, inne wymagają specjalnego traktowania.
W okresach krytycznych, gdy wykryty zostanie współbieżny dostęp z zapisem, kompilator wstawia do wygenerowanego kodu dodatkowe instrukcje, aby wymusić spójność pamięci podręcznej . Instrukcje te mogą wymusić opróżnianie pamięci podręcznej, przeładowywanie pamięci, bariery pamięci lub dostęp do regionów oznaczonych jako niebuforowalne, w zależności od modelu programowania i architektury bazowej.
Związek między kompilatorem, systemem operacyjnym i sprzętem
Sformułowanie „kompilator wstawia instrukcje do wygenerowanego kodu w celu wymuszenia spójności pamięci podręcznej” może sugerować, że system operacyjny odczytuje te instrukcje tak, jakby były wskazówkami wysokiego poziomu i na tej podstawie decyduje, jak uruchomić program. W rzeczywistości mechanizm jest nieco inny.
Gdy kompilator dodaje te typy instrukcji, wprowadza do pliku binarnego określone operacje obsługiwane przez architekturę lub środowisko wykonawcze . Na przykład, może wstawiać instrukcje opróżniania pamięci podręcznej, bariery pamięci, specjalne instrukcje oznaczające regiony jako niebuforowalne lub wywołania usług systemu operacyjnego, które konfigurują atrybuty pamięci.
System operacyjny nie interpretuje tych instrukcji jako „komentarzy” wysokiego poziomu ani „wskazówek” pisanych przez kompilator; po prostu wykonuje kod maszynowy jak każdy inny . Jednak niektóre z tych instrukcji są zaprojektowane do interakcji z podsystemem pamięci i zarządzaniem pamięcią podręczną, zmieniając w ten sposób sposób, w jaki procesor uzyskuje dostęp do określonych danych.
Innymi słowy, kompilator przeprowadza wstępną analizę i generuje kod, który po uruchomieniu zapewnia pożądane zachowanie pamięci podręcznej . System operacyjny współpracuje, ustalając atrybuty pamięci (obszary buforowalne lub niebuforowalne, zasady zapisu itp.) i dostarczając prymitywy synchronizacji, ale nie „odczytuje” specjalnych instrukcji w sensie ich semantycznej interpretacji, tak jak zrobiłby to kompilator.
Może się również zdarzyć, że sprzęt, po wykryciu określonych instrukcji, aktywuje określone mechanizmy spójności lub synchronizacji . Na przykład instrukcje „fence” lub „barrier” gwarantują kolejność dostępu do pamięci i wymuszają określone efekty widoczności w hierarchii pamięci podręcznej. W takim przypadku występuje trójstronna współpraca: kompilator decyduje, gdzie umieścić te instrukcje, system operacyjny konfiguruje środowisko wykonawcze, a sprzęt implementuje faktyczne zachowanie na poziomie pamięci podręcznej i magistrali pamięci.
Wszystkie te elementy razem zapewniają, że nawet w przypadku wielu kopii tych samych danych rozproszonych w różnych pamięciach podręcznych i głównej, programy równoległe działają w oparciu o spójny model pamięci . Spójność pamięci podręcznej, daleka od prostego szczegółu wewnętrznego procesora, staje się centralnym elementem niezawodnego i wydajnego działania systemów wielordzeniowych.
Zrozumienie, w jaki sposób hierarchia pamięci podręcznej, protokoły spójności sprzętowej i techniki wsparcia oprogramowania są ze sobą powiązane, pozwala lepiej zrozumieć, dlaczego współczesne konstrukcje procesorów mają tak podobną strukturę i dlaczego niewielka awaria dowolnego z tych mechanizmów może wywołać chaotyczne zachowanie w aplikacjach współbieżnych, które w całości zależą od tego, czy wszystkie rdzenie widzą te same dane we właściwym czasie.