- Sztuczna inteligencja zmienia sposób zarządzania plikami poprzez automatyzację klasyfikacji, wyodrębnianie strategicznych danych i weryfikację autentyczności.
- Technologie takie jak IDP, przetwarzanie języka naturalnego i komputerowe rozpoznawanie obrazu pozwalają ograniczyć liczbę błędów ludzkich i zoptymalizować zgodność z przepisami w kluczowych sektorach.
- Możliwość analizowania złożonych wzorców i wykrywania wyrafinowanych oszustw sprawia, że zarządzanie dokumentami staje się przewagą konkurencyjną i poprawia bezpieczeństwo.
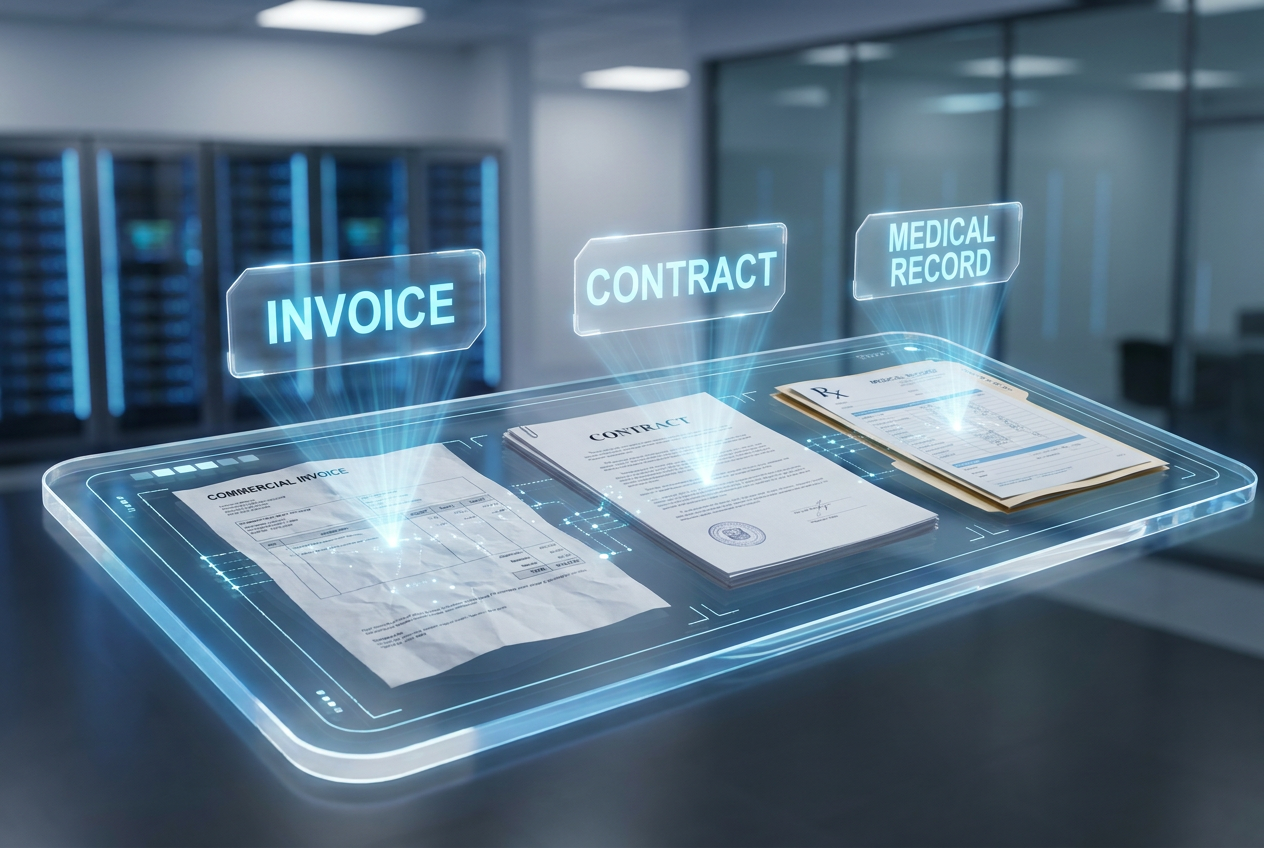
Zarządzanie informacją w firmach nie ogranicza się już tylko do archiwizacji dokumentów czy zapisywania plików PDF w folderze współdzielonym. Wraz z eksplozją danych, której doświadczamy, organizacje pogrążają się w morzu nieustrukturyzowanych plików , w których znalezienie konkretnej informacji może być prawdziwą odyseją. Właśnie tutaj wkracza sztuczna inteligencja w archiwizacji i zarządzaniu dokumentami , nie tylko pomagając, ale całkowicie zmieniając zasady gry, przekształcając chaos dokumentów w strategiczny atut.
Wdrożenie inteligentnych systemów wykrywania i analizy pozwala firmom przestać marnować czas na powtarzalne i żmudne zadania. Nie ma już potrzeby, aby ekspert ręcznie czytał każdą umowę lub weryfikował każdą fakturę; teraz, dzięki algorytmom uczenia maszynowego i wizji komputerowej , maszyny potrafią zrozumieć, co zawiera dokument, jaki jest jego cel i jakie ryzyko może się z nim wiązać – wszystko w ułamku sekundy i z dokładnością, która przewyższa ludzkie oko.

Inteligentna klasyfikacja dokumentów
Klasyfikowanie plików to coś więcej niż tylko ich etykietowanie; chodzi o automatyczne kategoryzowanie dokumentów biznesowych w celu optymalizacji zasobów i zapobiegania krytycznym błędom. Wcześniej proces ten stanowił wąskie gardło, wymagające skomplikowanego programowania lub żmudnej pracy ręcznej. Dziś sztuczna inteligencja skanuje każdy przychodzący plik i przypisuje go do predefiniowanych kategorii, kierując go bezpośrednio do odpowiedniego przepływu pracy, aby zapewnić płynne przetwarzanie.
Aby to zadziałało, sztuczna inteligencja wykorzystuje fundamentalne koncepcje, takie jak identyfikacja podmiotu (nazwy, daty lub liczby), przypisanie kategorii ryzyka (np. dokumenty publiczne lub poufne) oraz trwałe etykietowanie. To ostatnie jest niezbędne, aby inne narzędzia bezpieczeństwa mogły obsługiwać plik. Co więcej, kontekstualizacja pozwala sztucznej inteligencji zrozumieć dokument w całym jego cyklu życia, osiągając ponad 95% dokładności, opierając się nie tylko na słowach kluczowych, ale także na rzeczywistym znaczeniu tekstu.

Weryfikacja tożsamości i zapobieganie oszustwom
W sektorze bezpieczeństwa sztuczna inteligencja dokonała ogromnego skoku w weryfikacji dokumentów tożsamości, stając się centralnym elementem procesów KYC (Know Your Customer – Poznaj Swojego Klienta) i AML (Anti-Money Laundering – Przeciwdziałanie Praniu Pieniędzy). Wykorzystując wizję komputerową i analizę obrazu , systemy mogą wykrywać niemal niewidoczne zmiany, takie jak zmanipulowane hologramy, fałszywe znaki wodne czy nieścisłości w mikrodruku, które większość ludzi mogłaby nie zauważyć.
Jedną z jego najmocniejszych stron jest zdolność do zwalczania oszustw cyfrowych. Sztuczna inteligencja analizuje anomalie na poziomie pikseli, aby wykryć retusz w Photoshopie lub modyfikacje twarzy (deepfake). Co więcej, biometryczne dopasowanie twarzy porównuje zdjęcie dokumentu z transmisją wideo na żywo użytkownika, wykorzystując pasywną lub aktywną detekcję żywotności, aby upewnić się, że osoba prezentująca dokument jest fizycznie obecna, a nie tylko maseczką lub fotografią.

Technologie napędowe: IDP, NLP i OCR
Siłą napędową tego wszystkiego jest Inteligentne Przetwarzanie Dokumentów (IDP), które łączy kilka technologii, aby wydobyć rzeczywistą wartość z danych. Zaawansowane OCR nie tylko odczytuje litery, ale interpretuje kontekst, aby zapewnić dokładność , konwertując obrazy lub dokumenty fizyczne na ustrukturyzowane dane. Z kolei Przetwarzanie Języka Naturalnego (NLP) pozwala maszynie zrozumieć semantykę tekstu, ułatwiając wykrywanie wzorców i anomalii.
- Wyszukiwanie w Azure AI: Usługa umożliwiająca głębokie przeszukiwanie semantyczne ogromnych zbiorów nieustrukturyzowanych danych, idealna dla działów prawnych i kadrowych.
- Modele językowe (LLM): Narzędzia takie jak GPT-4, Claude czy Gemini potrafią podsumować wiele plików jednocześnie i odpowiedzieć na złożone pytania dotyczące zawartości źródłowej.
- Analiza zachowań: Systemy monitorujące interakcję użytkownika z dokumentem w celu identyfikacji potencjalne wskaźniki oszustwa.
Zastosowania w świecie rzeczywistym w różnych sektorach
Wszechstronność tych narzędzi pozwala na korzyści niemal każdemu sektorowi. W finansach płatności i walidacja kredytów są automatyzowane dzięki ekstrakcji danych w czasie rzeczywistym. W sektorze prawnym sztuczna inteligencja analizuje umowy, aby zidentyfikować ryzykowne klauzule lub naruszenia, usprawniając proces eDiscovery poprzez filtrowanie tysięcy dokumentów w ciągu kilku sekund.
Sektor opieki zdrowotnej wykorzystuje sztuczną inteligencję do digitalizacji dokumentacji medycznej i automatyzacji rozpatrywania roszczeń ubezpieczeniowych , zapobiegając utracie poufnych danych. Z kolei w dziale kadr integracja systemów planowania zasobów przedsiębiorstwa (ERP) i oprogramowania do zarządzania zasobami ludzkimi umożliwia automatyczną klasyfikację CV według umiejętności, co pozwala znaleźć idealnego kandydata bez konieczności przeglądania setek profili. W logistyce rozpoznawanie dowodów dostawy i faktur znacząco redukuje błędy operacyjne i optymalizuje łańcuch dostaw.

Wdrażanie systemu i wyzwania
Aby wdrożyć taki system, sama instalacja oprogramowania nie wystarczy; trzeba zidentyfikować problemy, takie jak czasochłonne procesy. Kluczowe jest zdefiniowanie mierzalnych celów i upewnienie się, że rozwiązanie jest skalowalne i zgodne z przepisami takimi jak RODO i CCPA, ponieważ przetwarzanie danych osobowych jest obszarem wrażliwym.
Nie wszystko jest takie proste, ponieważ pojawiają się poważne wyzwania. Błąd w danych szkoleniowych może prowadzić do niesprawiedliwych wyników dla niektórych grup demograficznych, dlatego kluczowe jest korzystanie z różnorodnych zestawów danych. Co więcej, oszuści stale udoskonalają swoje taktyki, zmuszając modele sztucznej inteligencji do ciągłego przeszkolenia, aby nie stały się przestarzałe.
Integracja tych możliwości pozwala narzędziom zapobiegania utracie danych (DLP) działać z chirurgiczną precyzją. Jeśli sztuczna inteligencja oznaczy plik jako poufny wysokiego ryzyka , system bezpieczeństwa może automatycznie zablokować jego wyjście z sieci firmowej. To przekształca zarządzanie dokumentami w prawdziwą tarczę cyberbezpieczeństwa, gwarantującą pełną identyfikowalność poufnych informacji.
Połączenie analizy semantycznej, wizji komputerowej i modeli generatywnych tworzy ekosystem, w którym informacje nie są już tylko przechowywane, ale aktywnie zarządzane. Automatyzując wykrywanie i walidację typów plików, organizacje nie tylko redukują koszty i czas, ale także chronią swoją infrastrukturę przed oszustwami i umożliwiają podejmowanie decyzji w oparciu o rzeczywiste, ustrukturyzowane dane.
