- Monitorowanie ruchu sieciowego w czasie rzeczywistym pozwala przewidywać awarie, zwiększać wydajność i wzmacniać bezpieczeństwo infrastruktury IT.
- Narzędzia typu open source, takie jak Nagios, Zabbix, Prometheus, Cacti, OpenNMS, Icinga, Netdata, LibreNMS czy Observium, oferują zaawansowane funkcje bez konieczności ponoszenia kosztów licencji.
- Połączenie kolektorów metryk, baz danych szeregów czasowych i warstw wizualizacji, takich jak Grafana i Graphite, pozwala tworzyć niezwykle elastyczne i skalowalne rozwiązania.
- Określenie wymagań, zastosowanie najlepszych praktyk i przeprowadzenie dowodu koncepcji są kluczem do wyboru i wdrożenia najodpowiedniejszej platformy monitorującej.
Gdy sieć firmowa zaczyna zwalniać, Wi-Fi zanika lub krytyczny serwer ulega awarii w najmniej odpowiednim momencie, samo „zrestartowanie routera i trzymanie kciuków” już nie wystarczy. Dziś kluczowe jest posiadanie narzędzi do monitorowania ruchu sieciowego typu open source , które pozwalają śledzić sytuację w czasie rzeczywistym, przewidywać problemy i unikać kosztownych przestojów.
Jeśli pracujesz w IT, sieciach lub kiedykolwiek byłeś liderem technicznym w swojej firmie, prawdopodobnie słyszałeś o rozwiązaniach takich jak PRTG czy SolarWinds… i ich licencjach. Dobra wiadomość jest taka, że istnieje bardzo dojrzały ekosystem platform open source do monitorowania urządzeń, usług i ruchu sieciowego (routerów, przełączników, punktów dostępu Wi-Fi, serwerów, kontenerów, chmur publicznych i wielu innych) bez wygórowanych opłat i z niesamowitą elastycznością.
Czym jest monitorowanie ruchu sieciowego w czasie rzeczywistym i dlaczego jest tak ważne?
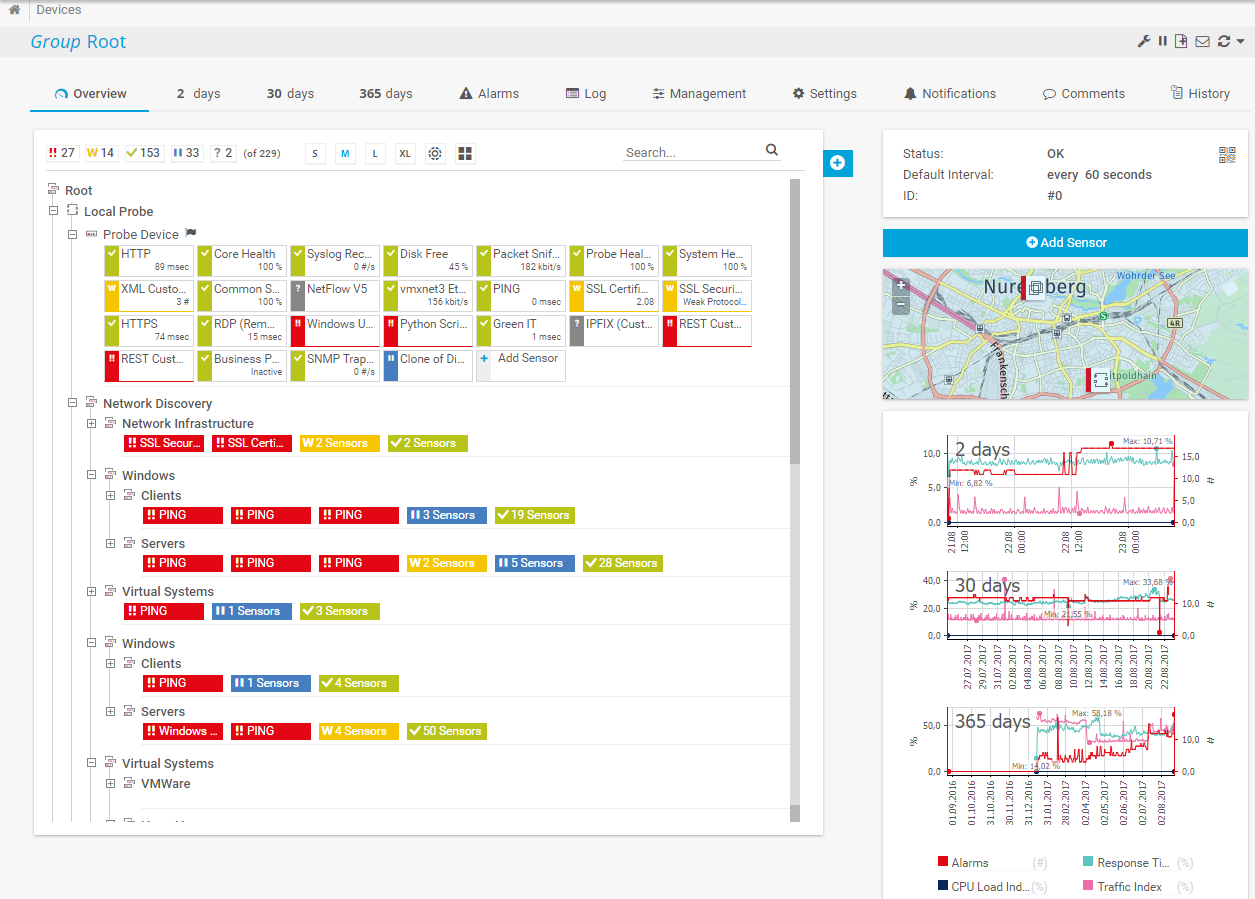
Mówiąc o monitorowaniu sieci w czasie rzeczywistym, mamy na myśli ciągły nadzór nad stanem, wydajnością i bezpieczeństwem infrastruktury IT i komunikacyjnej , wykrywający incydenty w momencie ich wystąpienia. Oprogramowanie stale gromadzi i analizuje dane z urządzeń, systemów i aplikacji, aby zespół IT mógł zareagować, zanim problem wpłynie na działalność firmy.
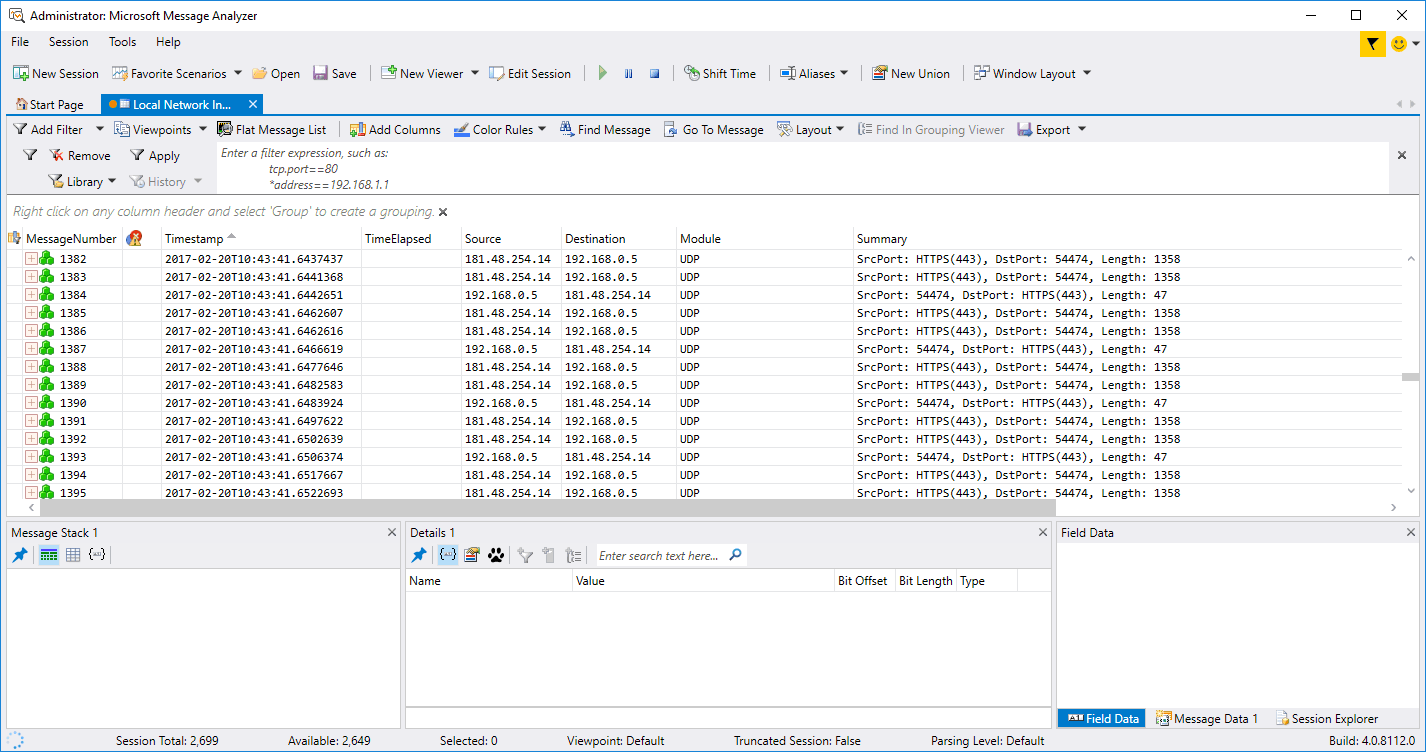
Rozwiązania tego typu opierają się na protokołach, takich jak SNMP, NetFlow/sFlow, ICMP , interfejsach API i specjalnych agentach, umożliwiających zbieranie danych z routerów, przełączników, zapór sieciowych, punktów dostępu, serwerów fizycznych i wirtualnych, kontenerów, usług w chmurze, aplikacji internetowych, baz danych i praktycznie każdego elementu infrastruktury.
Głównym celem jest uzyskanie pełnego wglądu w ruch, wykorzystanie przepustowości, dostępność i stan każdego komponentu . Pozwala to na wykrywanie wąskich gardeł , ataków, awarii sprzętu lub przeciążeń usług, zanim doprowadzą one do przerw w działaniu, znacznego spowolnienia lub utraty danych.
Oprócz danych na żywo wiele narzędzi umożliwia przechowywanie historycznych metryk do analizy trendów , planowania pojemności, weryfikacji zgodności z SLA/OLA, audytów bezpieczeństwa i wsparcia decyzji inwestycyjnych w nowy sprzęt lub łącza.
Główne zastosowania i korzyści monitorowania w czasie rzeczywistym
Jedną z największych korzyści jest prewencyjna konserwacja infrastruktury IT i sieci . Ciągłe pomiary dotyczące procesora, pamięci, temperatury, stanu zasilania, błędów interfejsu i utraty pakietów pomagają wykryć wczesne oznaki awarii, zanim dojdzie do poważnej awarii lub przerwy w działaniu usług.
Wczesne reagowanie na incydenty to kolejny kluczowy filar. Platformy monitorujące generują konfigurowalne alerty (e-mail, SMS, Slack, Teams, webhooki itp.), gdy wartość przekroczy określony próg, usługa przestanie odpowiadać lub pojawi się podejrzany wzorzec ruchu. To radykalnie skraca przestoje i zmniejsza wpływ incydentów bezpieczeństwa lub przerw w działaniu.
W codziennej działalności monitorowanie przyczynia się do optymalizacji ogólnej wydajności sieci, serwerów i aplikacji. Możliwość śledzenia, które łącza są przeciążone, które usługi zużywają najwięcej zasobów lub które strefy czasowe powodują szczytowe obciążenia, pomaga dostosować konfiguracje, zrównoważyć obciążenia, na nowo zdefiniować zasady QoS i, ogólnie rzecz biorąc, uzyskać lepszą wydajność zainstalowanej technologii.
Kolejnym, coraz ważniejszym aspektem jest zgodność z przepisami. Dobry system monitorowania ułatwia kontrolę dostępu, śledzenie poufnych danych i wykrywanie nieautoryzowanego dostępu , dostarczając logi i metryki przydatne w audytach oraz do wykazywania zgodności z wymogami regulacyjnymi lub umownymi.
Wreszcie, z perspektywy biznesowej, rozwiązania te stają się narzędziami wspomagającymi podejmowanie decyzji : okresowe raporty, panele zarządzania, analiza historyczna incydentów i dostępności, porównania między lokalizacjami lub dostawcami usług w chmurze… wszystko to pomaga uzasadnić inwestycje, negocjować z podmiotami zewnętrznymi i ustalać priorytety projektów informatycznych.
Konkretne zalety oprogramowania monitorującego typu open source
Pierwszą oczywistą zaletą narzędzi open source jest ich opłacalność: nie ma zamkniętych licencji ani agresywnych kosztów jednostkowych, jak na wielu platformach komercyjnych. Nie oznacza to, że wszystko jest darmowe (zawsze występują koszty infrastruktury, wsparcia i szkoleń), ale oszczędności na licencjach zwalniają przestrzeń na inwestycje w inne kluczowe obszary.
Drugą ważną zaletą jest wsparcie społeczności i innowacyjność . Projekty takie jak Nagios, Zabbix, Prometheus, LibreNMS i Netdata mają bardzo aktywne społeczności, które opracowują wtyczki, integracje, panele sterowania i stale wprowadzają ulepszenia, a także szybko naprawiają błędy i eliminują luki w zabezpieczeniach.
Wyróżnia się również przejrzystością kodu i wiarygodnością : jako oprogramowanie open source, każdy może kontrolować sposób przetwarzania i przechowywania danych, sprawdzać bezpieczeństwo systemu i dostosowywać kod źródłowy do konkretnych potrzeb. Zmniejsza to ryzyko ukrytych luk w zabezpieczeniach i ułatwia przestrzeganie wewnętrznych zasad bezpieczeństwa.
Kolejnym kluczowym punktem jest unikanie uzależnienia od jednego dostawcy. Dzięki otwartym rozwiązaniom łatwiej jest migrować między narzędziami lub je łączyć (na przykład używając Prometheusa do metryk aplikacji, Zabbixa do urządzeń sieciowych i Grafany jako ujednoliconej warstwy wizualizacji), bez konieczności przywiązywania się na stałe do planu działania jednej firmy.
Oczywiste jest, że narzędzia typu open source zazwyczaj wymagają pewnego poziomu umiejętności technicznych w zakresie instalacji, konfiguracji i konserwacji , ale w zamian oferują elastyczność i wydajność, które mogą bezpośrednio konkurować z wieloma rozwiązaniami komercyjnymi, zwłaszcza w środowiskach, w których ceniona jest możliwość dostosowywania i integracji z istniejącymi systemami.
Najlepsze narzędzia open-source do monitorowania sieci i infrastruktury
Istnieją dziesiątki dojrzałych projektów skoncentrowanych na monitorowaniu sieci, serwerów, aplikacji i środowisk chmurowych. Poniżej znajduje się przegląd najistotniejszych narzędzi open source do monitorowania ruchu sieciowego i obserwowalności , oparty na różnorodnych analizach technicznych i specjalistycznych porównaniach.
Jednym z klasycznych przykładów jest Nagios Core , niezwykle solidny moduł monitorowania i alertów. Stanowi on podstawę dla wielu projektów Nagios i obsługuje harmonogramowanie kontroli, przetwarzanie wyników, zarządzanie zdarzeniami i generowanie alertów. Jego modułowa architektura pozwala na rozszerzanie możliwości za pomocą niestandardowych interfejsów API i wtyczek, a jego ekosystem jest rozległy i oferuje integrację z niemal każdym typem urządzenia lub usługi.
Kolejnym gigantem w świecie open source jest Zabbix , który koncentruje się na monitorowaniu rozległych infrastruktur IT. Jest on szczególnie wydajny w zbieraniu i analizowaniu metryk urządzeń sieciowych (użycie przepustowości, stan interfejsów, łącza, utrata pakietów, temperatura, użycie procesora, pamięć itp.), zarówno poprzez SNMP, jak i za pomocą własnych agentów. Pozwala użytkownikom definiować progi, przepływy eskalacji alertów, harmonogramy, kanały powiadomień oraz bardzo szczegółową logikę zdarzeń.
W obszarze aplikacji chmurowych i danych szeregów czasowych Prometheus wyróżnia się . To rozwiązanie wykorzystuje wielowymiarowy model danych, identyfikowany za pomocą nazw metryk i tagów klucz-wartość, i wykorzystuje język zapytań PromQL do tworzenia wykresów, tabel, reguł alertów i złożonych zapytań. Dane są efektywnie przechowywane w pamięci operacyjnej i na dysku lokalnym, co zapewnia dużą autonomię poszczególnych instancji, a także płynnie integruje się z Grafaną w celu wizualizacji.
Dla tych, którzy szukają lekkiego rozwiązania skoncentrowanego na bardzo krótkich czasach rzeczywistych i minimalnych opóźnieniach, Netdata jest bardzo interesującą opcją. Instaluje się jako agent na każdym serwerze lub urządzeniu z systemem Linux, zbiera metryki systemowe i aplikacyjne, przechowuje dane bezpośrednio na węźle (bez konieczności korzystania z zewnętrznych baz danych w krótkim okresie) oraz oferuje zautomatyzowane pulpity nawigacyjne z bardzo szczegółowymi wizualizacjami wydajności, wykorzystując nawet modele uczenia maszynowego do wykrywania anomalii.
Specjalistyczne narzędzia do wizualizacji sieci i ruchu
Oprócz platform ogólnego przeznaczenia dostępne są również narzędzia typu open source, które bezpośrednio służą do monitorowania ruchu sieciowego i tworzenia wykresów wydajności . Są one szczególnie przydatne, gdy zależy nam na monitorowaniu przepustowości, przepływów i stanu łącza.
Jednym z najpopularniejszych jest Cacti , który koncentruje się na tworzeniu grafów sieciowych i zarządzaniu awariami w celu monitorowania operacyjnego. Wykorzystuje narzędzie RRDTool do przechowywania danych i generowania grafów, oferuje szablony do automatyzacji rejestracji urządzeń i obsługuje wiele metod akwizycji danych. Jego wtyczki (m.in. THold, SysLog, MacTrack) umożliwiają wyznaczanie progów, integrację z syslog, śledzenie adresów MAC i monitorowanie urządzeń w czasie rzeczywistym.
Kolejną niezwykle wydajną platformą jest OpenNMS Horizon , uważany za jedno z pierwszych w pełni otwartych rozwiązań do monitorowania usług sieciowych klasy enterprise. Obsługuje ono monitorowanie sieci lokalnych i rozproszonych, oferując inwentaryzację, zarządzanie awariami, zdalne gromadzenie danych, korelację alarmów, monitorowanie usług biznesowych i monitorowanie ruchu. Wszystkim zarządza się za pomocą intuicyjnego interfejsu webowego z konfigurowalnymi pulpitami nawigacyjnymi.
Podobnie, Icinga pozycjonuje się jako nowoczesna ewolucja modelu Nagios, z dopracowanym interfejsem webowym i silnym naciskiem na monitorowanie sieci, wydajność interfejsu, wykorzystanie przepustowości, błędy, obciążenie procesora i pamięci oraz kondycję sprzętu. Icinga obsługuje sprawdzanie SNMP, metryki specyficzne dla dostawcy oraz odbiór pułapek SNMP, integrując się z Logstash w celu zarządzania zdarzeniami z wielu urządzeń.
Dla tych, którzy potrzebują szczegółowego wglądu w urządzenia sieciowe, interfejsy i ruch, projekty takie jak LibreNMS i Observium są szczególnie przydatne. Oba w dużym stopniu opierają się na SNMP i protokołach wykrywania (CDP, LLDP, OSPF, BGP, ARP itp.), aby automatycznie wykrywać sieć, generować mapy i prezentować metryki wydajności za pomocą przejrzystych wykresów , konfigurowalnych progów i elastycznych systemów alertów.
Zaawansowana wizualizacja z Grafaną i Graphite
W wielu złożonych wdrożeniach warstwa gromadzenia metryk jest oddzielona od warstwy wizualizacji. Dwa kluczowe projekty w tym podejściu to Grafana i Graphite , oba o otwartym kodzie źródłowym i szeroko stosowane w środowiskach korporacyjnych.
Grafana to wieloplatformowe narzędzie z obsługą wtyczek, przeznaczone do tworzenia w pełni spersonalizowanych pulpitów wizualizacji danych. Umożliwia łączenie wielu źródeł danych (Prometheus, Graphite, InfluxDB, MySQL, dostawców usług chmurowych itp.) oraz wyświetlanie metryk w postaci histogramów, map geograficznych, map cieplnych, wykresów liniowych, tabel i wielu innych typów wizualizacji. Obsługuje adnotacje w czasie rzeczywistym, dynamiczne pulpity oraz definiowanie alertów z powiadomieniami do różnych kanałów.
Graphite koncentruje się na rejestrowaniu i graficznym przedstawianiu metryk szeregów czasowych. Można go wdrożyć na prostym sprzęcie lub w chmurze i idealnie nadaje się do monitorowania wydajności stron internetowych, usług korporacyjnych, serwerów i metryk sieciowych . Wiele zespołów decyduje się na zarządzane usługi oparte na Graphite (takie jak MetricFire), które dodają klastrową pamięć masową, etykietowanie danych, dodatkowe integracje i alerty wielokanałowe, jednocześnie wykorzystując moc Graphite, a często również Grafany, jako front-endu.
W przypadku typowego wdrożenia systemy sieciowe i serwery wysyłają metryki do Graphite lub zgodnego kolektora (np. przy użyciu protokołów takich jak StatsD), a następnie w Grafana tworzone są pulpity nawigacyjne zapewniające ujednolicony widok stanu całej infrastruktury: od ruchu na każdym interfejsie po opóźnienia zapytań lub wykorzystanie procesora przez usługę.
Inne istotne rozwiązania do monitorowania typu open source
Ekosystem monitorowania typu open source jest bardzo szeroki i zaspokaja określone potrzeby, takie jak automatyczne wykrywanie, monitorowanie procesów, potoki obserwacji czy zbieranie metryk z bardzo heterogenicznych środowisk.
Na przykład Checkmk to wysoce skalowalna platforma, która umożliwia monitorowanie wszystkiego, od małych środowisk po duże przedsiębiorstwa. Oferuje zaawansowane zarządzanie agentami, automatyczne wykrywanie sieci, interaktywne wizualizacje, wydajne systemy alertów, raportowanie SLA, analizę logów i zdarzeń oraz interfejsy API rozszerzające jej funkcjonalność. Jest oferowana w różnych edycjach (bezpłatna RAW, Enterprise, Cloud i MSP), dostosowując się do różnych rozmiarów i modeli usług.
M/Monit koncentruje się na monitorowaniu i samonaprawianiu systemów Unix i Linux. Monitoruje procesy, wykorzystanie procesora i pamięci oraz interfejsy sieciowe i może automatycznie reagować na błędy, podejmując działania naprawcze. Umożliwia również monitorowanie uruchamiania usług, skanowanie plików i katalogów w poszukiwaniu nieautoryzowanych zmian oraz sprawdzanie połączeń sieciowych z serwerami lokalnymi lub zdalnymi.
W dziedzinie analizy topologii sieci i metryk, Pandora FMS wyróżnia się jako kompleksowe rozwiązanie, oferujące monitorowanie sieci, UX, chmury, serwerów i aplikacji, inwentaryzację, zarządzanie logami oraz konfigurowalne pulpity nawigacyjne. Potrafi automatycznie wykrywać interfejsy sieciowe, tworzyć mapy, wyświetlać statystyki dotyczące wąskich gardeł w czasie rzeczywistym oraz generować kompleksowe raporty.
W przypadku nowoczesnych mikrousług i architektur wielochmurowych, Sensu działa jak scentralizowany system obserwacji , który łączy różne narzędzia do monitorowania. Oferuje on kontrolę stanu, niestandardowe metryki wydajności, zarządzanie logami, zarządzanie problemami sieciowymi oraz wielokanałowe alerty z deduplikacją. Ponadto, obsługuje samonaprawianie poprzez ponowne uruchomienie usług lub wykonanie niestandardowych skryptów w przypadku wykrycia problemów.
Agenci, kolekcjonerzy i narzędzia pomocnicze
Oprócz dużych platform istnieją lżejsze narzędzia, których główną funkcją jest zbieranie i przesyłanie danych pomiarowych z systemów, czujników i aplikacji do baz danych lub głównych systemów monitorujących.
Doskonałym przykładem jest Telegraf , agent oparty na języku Go, bez zewnętrznych zależności, działający za pośrednictwem rozbudowanego systemu wtyczek. Dzięki ponad 300 wtyczkom wejścia/wyjścia, Telegraf może wyodrębniać metryki i zdarzenia z różnych stosów technologicznych i przesyłać dane do systemów takich jak InfluxDB, Graphite, OpenTSDB, Datadog, Librato i innych. Bufory w pamięci zapewniają, że metryki nie zostaną utracone, nawet jeśli główny backend zostanie tymczasowo wyłączony.
Innym ważnym elementem wielu architektur jest wykorzystanie specjalnych eksporterów i kolektorów (na przykład w ekosystemie Prometheus są to eksportery dla baz danych, serwerów WWW, systemów kolejkowych itd.), które umożliwiają udostępnianie metryk w standardowym formacie bez konieczności ponownego pisania każdej aplikacji.
Łącząc agentów, takich jak Telegraf, wyspecjalizowanych eksporterów, a także platformy szeregów czasowych i wizualizacji, możliwe jest zbudowanie kompletnych rozwiązań do monitorowania sieci, serwerów, aplikacji i chmur , w całości opartych na darmowym oprogramowaniu lub z minimalną liczbą komponentów komercyjnych, gdy wymagane jest oficjalne wsparcie.
Takie modułowe podejście ma tę zaletę, że każda organizacja może wybrać tylko te elementy, których potrzebuje , zintegrować je z istniejącymi systemami (biletami, CMDB, SIEM itp.) i rozwijać architekturę w miarę rozwoju środowiska lub zmiany w kierunku kontenerów, Kubernetes lub usług bezserwerowych.
Jak wybrać najlepsze narzędzie do monitorowania sieci typu open source
Przed zainstalowaniem pierwszego popularnego narzędzia, ważne jest , aby jasno określić, co chcesz monitorować : tylko sieć fizyczną (routery, przełączniki, punkty dostępu), czy też serwery, maszyny wirtualne, kontenery, aplikacje, a nawet środowisko użytkownika i usługi chmurowe. Ta priorytetyzacja pozwala zawęzić zakres opcji i wybrać rozwiązania, które najlepiej pasują do Twojego głównego zastosowania.
Ważne jest, aby ocenić kluczowe funkcjonalności, których potrzebujesz: raporty, alerty, wizualizację danych, przechowywanie danych historycznych, integrację z systemami zewnętrznymi, interfejsy API oraz obsługę określonych protokołów (SNMP, NetFlow, WMI, API chmurowe itp.). Na przykład Prometheus idealnie sprawdza się, gdy wymagane są niestandardowe metryki i złożone reguły alertów; Cacti doskonale wyświetla wykresy ruchu sieciowego; a Checkmk oferuje interaktywną wizualizację i kompleksowe raporty SLA.
Łatwość obsługi i konfiguracji to kolejny kluczowy czynnik. Narzędzia takie jak Zabbix, Netdata czy Checkmk zazwyczaj oferują przyjazne dla użytkownika kreatory konfiguracji i pulpity nawigacyjne, podczas gdy wysoce elastyczne rozwiązania mogą wymagać bardziej złożonej konfiguracji początkowej. Przed podjęciem decyzji zaleca się przetestowanie interfejsu wykrywania sieci, tworzenia hostów i usług oraz konfiguracji alertów.
Z punktu widzenia bezpieczeństwa kluczowe jest, aby platforma obsługiwała szyfrowanie, silne uwierzytelnianie i kontrolę dostępu opartą na rolach . Niektóre platformy, takie jak OpenNMS, Icinga czy Prometheus, umożliwiają dodawanie zaawansowanych modułów lub konfiguracji w celu wzmocnienia bezpieczeństwa, segmentacji dostępu do danych i zapewnienia zgodności z wewnętrznymi lub regulacyjnymi standardami; ponadto zaleca się uzupełnienie tego o najlepsze praktyki dotyczące zaawansowanej konfiguracji zapory sieciowej na serwerach.
Na koniec zdecydowanie zaleca się przeprowadzenie dowodu koncepcji (POC) przy użyciu 2 lub 3 narzędzi finalistów , wdrożenie ich w kontrolowanym środowisku, monitorowanie reprezentatywnego podzbioru infrastruktury i ocenę wydajności, łatwości użytkowania, jakości alertów i możliwości integracji z istniejącymi narzędziami (systemy zgłoszeń, CI/CD, wiadomości itp.).
Najlepsze praktyki efektywnego monitorowania sieci
Po wybraniu platformy, sukces w dużej mierze zależy od sposobu zaprojektowania wdrożenia. Kluczowym pierwszym krokiem jest udokumentowanie i zmapowanie sieci : jakie urządzenia są obecne, gdzie się znajdują, z jakich łączy korzystają, jakie kluczowe usługi obsługują oraz jakie zależności między nimi istnieją. Ułatwi to zdefiniowanie, co i jak monitorować. Aby lepiej zrozumieć topologie i typy sieci, zobacz artykuł „ Sieci komputerowe: typy i przykłady”.
Wskazane jest wybranie jednego lub więcej standardowych protokołów komunikacyjnych dla urządzeń przesyłających informacje do narzędzia: SNMP dla sprzętu sieciowego, agentów dla serwerów, eksporterów Prometheus dla określonych usług, syslog dla zdarzeń itd. Im bardziej jednorodne podejście, tym łatwiej będzie je utrzymać w dłuższej perspektywie.
Ważne jest również określenie zachowań bazowych : normalnych wartości dla opóźnień, przepustowości, procesora, pamięci, równoczesnych połączeń itp. Pozwala to na konfigurację realistycznych progów i dokładniejsze wykrywanie anomalii, unikając fałszywych alarmów i pominiętych alertów dotyczących rzeczywistych zdarzeń.
Skonfigurowanie przejrzystych, dedykowanych dla danej roli pulpitów nawigacyjnych (operacje 24/7, sieć, systemy, zarządzanie itp.) pomaga skrócić czas diagnostyki. Centrum operacyjne (NOC) będzie potrzebowało widoków podsumowujących i alertów w czasie rzeczywistym; administratora sieci, szczegółowych interfejsów, błędów i kolejek; a także dyrektora ds. informatyki (CIO), dostępności i umów SLA dla kluczowych usług.
Na koniec, kluczowe jest zdefiniowanie polityki eskalacji alertów : kto otrzymuje jaki rodzaj alertu, jakim kanałem i z jakim priorytetem; co jest robione poza godzinami pracy; co stanowi poważny incydent; oraz jak reakcja jest koordynowana między zespołami. Nawet najlepsze narzędzia na świecie tracą skuteczność, jeśli nikt nie reaguje na alerty lub jeśli nie ma jasnego planu działania.
Biorąc pod uwagę wszystkie te elementy, rozwiązania do monitorowania ruchu sieciowego typu open source umożliwiają budowę niezwykle wytrzymałych środowisk z pełną widocznością, wsparciem decyzyjnym i solidną podstawą do poprawy bezpieczeństwa, dostępności i wydajności dowolnej infrastruktury, od małej firmy po dużą, rozproszoną korporację.