- Diferențiere fundamentală între faza de antrenament a modelului și faza de inferență pentru generarea de valoare comercială.
- Analiza arhitecturilor de implementare: de la procesarea centralizată în cloud la edge computing (Edge AI).
- Evaluarea cerințelor tehnice hardware, în special a importanței memoriei VRAM în GPU-uri pentru execuția modelului.
- Strategii de optimizare precum cuantizarea și utilizarea Modelelor de Limbaj Mici (SLM) pentru îmbunătățirea eficienței operaționale.

Când vorbim despre inteligența artificială, majoritatea oamenilor își imaginează procese masive de învățare și supercomputere care procesează trilioane de date. Cu toate acestea, există o parte a procesului în care se întâmplă adevărata magie pentru afaceri: inferența. În esență, acesta este momentul în care inteligența artificială se oprește din învățat și începe să funcționeze, aplicând tot ce a învățat pentru a rezolva probleme din lumea reală și a lua decizii bazate pe date pe care nu le-a mai văzut până acum.
În peisajul actual, companiile au depășit simpla percepție a inteligenței artificiale ca pe un experiment de laborator și au transformat-o într-o parte fundamentală a operațiunilor lor zilnice. Nu mai este vorba doar de crearea celui mai puternic model, ci de modul în care să îl ruleze în mod fiabil, sigur și, mai presus de toate, profitabil, mutând volumul de muncă de la teorie la producția activă în medii hibride.

Antrenament vs. Inferență: Nu sunt același lucru
Pentru a evita confuziile, este important să se facă o distincție clară între aceste două etape. Antrenamentul este ca anii de școală pentru inteligența artificială; este un proces intensiv în care modelul analizează datele istorice și etichetele pentru a găsi tipare. Acceleratoarele hardware puternice, precum GPU-urile sau TPU-urile, sunt utilizate în centrele de date mari , iar timpul de răspuns nu este prioritatea, deoarece procesul poate dura zile sau săptămâni.
Inferența, pe de altă parte, este testul final aplicat în timp real. Este procesul de execuție în care modelul primește o intrare (o fotografie, text sau citire de la senzor) și returnează un rezultat imediat. În această fază, latența devine critică , iar eficiența este esențială. În timp ce instruirea pune bazele, inferența este cea care generează valoare economică directă pentru organizație.
Strategii de implementare: Cloud, On-premises și Edge
Nu există o singură modalitate de a efectua inferența. În funcție de urgența și volumul datelor, companiile aleg dintre mai multe abordări. Inferența în loturi este ideală pentru sarcini masive, non-urgente, cum ar fi analiza financiară peste noapte sau categorizarea documentelor la scară largă, unde datele sunt procesate în cloud, iar rezultatele sunt returnate ulterior.

Apoi avem inferența în timp real , esențială pentru chatbots sau sistemele de detectare a fraudelor, unde răspunsul trebuie să sosească în milisecunde. Deși cloud-ul rămâne opțiunea dominantă datorită scalabilității sale, începe să-și arate limitele din cauza latenței rețelei și a costurilor ridicate ale lățimii de bandă atunci când gestionează terabytes de date.
Aici intervine edge inference, sau Edge AI . Prin procesarea datelor direct pe dispozitiv (un senzor IoT, un robot sau un smartphone), se obține o latență extrem de scăzută și o confidențialitate semnificativ mai mare, deoarece informațiile sensibile nu trebuie să călătorească către un server la distanță. Acest lucru este vital în sectoarele în care o întârziere de milisecunde poate fi critică, cum ar fi conducerea autonomă sau telechirurgia.
Inferența plantelor și Industria 4.0
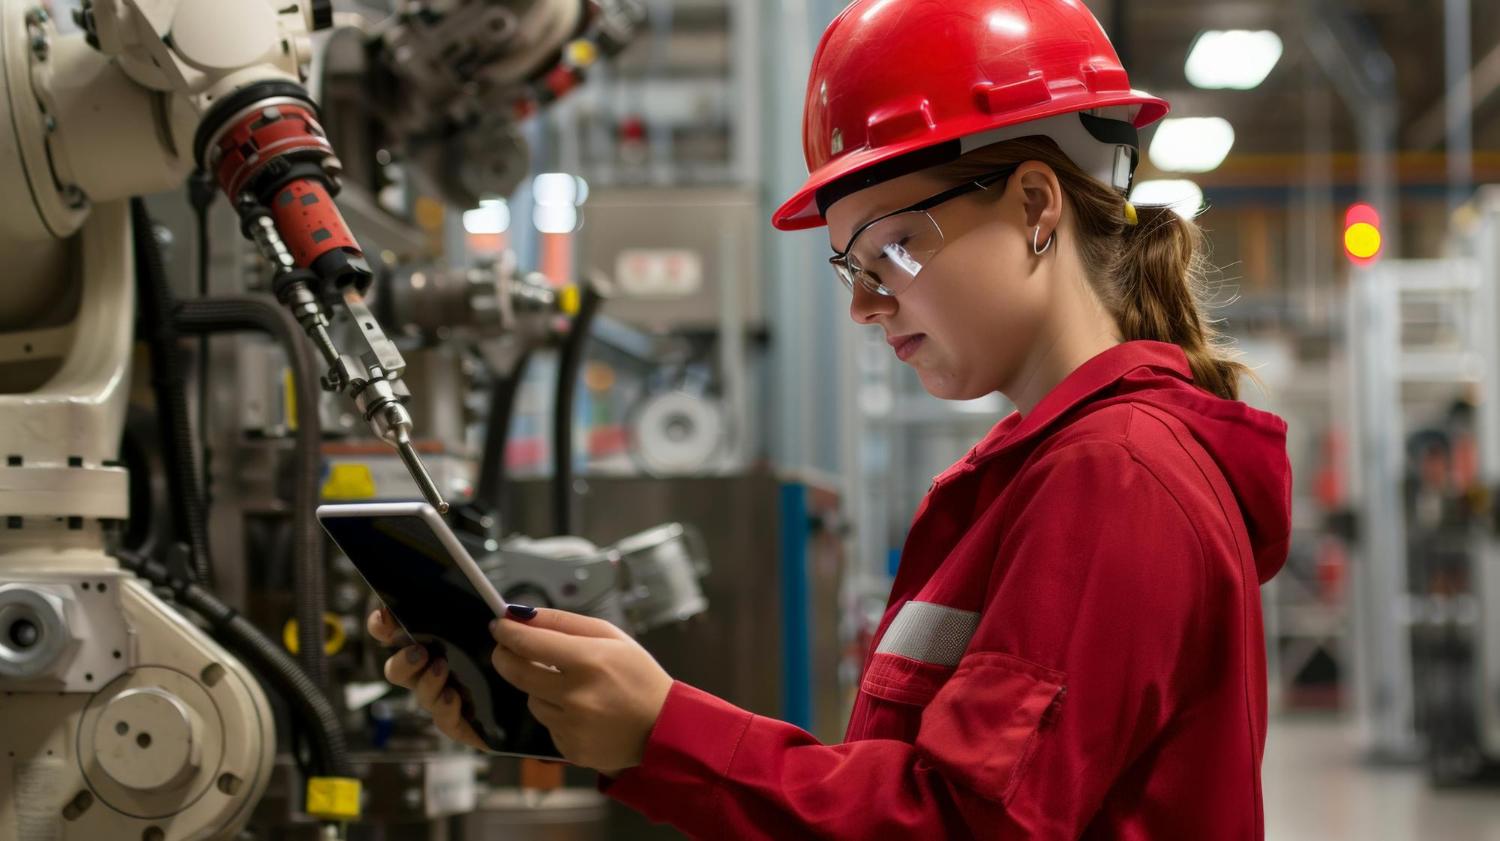
În sectorul de producție, tehnologia de inferență este o adevărată bijuterie. Permite mașinilor să ia decizii inteligente instantaneu, fără a se baza pe o conexiune la internet. Acest lucru se traduce prin controlul calității în timp real , detectând piesele defecte de pe linia de asamblare înainte ca acestea să devină o cheltuială inutilă.

În plus, aceasta stă la baza mentenanței predictive . Modelele de inteligență artificială analizează starea echipamentelor în timp real și oferă avertizări timpurii înainte ca ceva să se defecteze, prevenind opririle producției care ar costa mii de euro. În industria alimentară și electronică, acest lucru asigură că produsul final îndeplinește întotdeauna cele mai stricte standarde de calitate.
Cerințe tehnice și optimizarea modelului
Dacă o companie decide să ruleze inferența local, hardware-ul este esențial. GPU-urile sunt esențiale datorită arhitecturii lor paralele. Cel mai critic factor nu este doar puterea brută, ci și VRAM-ul (memoria video); dacă modelul se încadrează în întregime în VRAM, timpul de răspuns crește vertiginos. În caz contrar, sistemul se bazează pe RAM-ul convențional, ceea ce încetinește considerabil totul.
Pentru ca aceste modele să funcționeze pe dispozitive cu dimensiuni limitate, se utilizează tehnici de optimizare. Cuantizarea reduce precizia ponderilor modelului (de exemplu, de la 32 la 4 biți), făcând fișierul mult mai mic și mai rapid, fără a sacrifica prea multă precizie. Pe de altă parte, LoRA (Low-Rank Adaptation) permite adaptarea modelelor mari la sarcini specifice fără a fi nevoie să reantrenați întregul model, ceea ce este mult mai ieftin și mai rapid.

Modelele de limbaj mic (SLM) câștigă și ele teren . Spre deosebire de LLM-urile masive, SLM-urile sunt concepute pentru a fi eficiente și ușoare, ceea ce le face potrivite pentru hardware-ul edge. Pentru a aborda fragmentarea hardware-ului, se utilizează WebAssembly (Wasm) , care permite inteligenței artificiale să ruleze la o viteză aproape nativă pe orice dispozitiv, indiferent de procesorul său.
Guvernanță, Securitate și Instrumente Operaționale
Trecerea inteligenței artificiale în mediul de producție înseamnă că nu mai este vorba doar de un joc, ci de o sarcină de lucru critică pentru misiune. Multe companii operează deja în medii hibride sau multicloud , ceea ce necesită implementarea unor controale stricte de rutare și securitate. Guvernanța se concentrează acum pe nivelurile de prompt, token și API, unde gestionarea securității în mediile de dezvoltare a inteligenței artificiale este crucială pentru prevenirea scurgerilor de date.
Pentru cei care doresc să experimenteze cu inferența locală, există câteva instrumente foarte puternice disponibile. LM Studio este o opțiune excelentă pentru utilizatorii care caută o interfață grafică simplă și compatibilitate cu modelele Hugging Face. Pentru dezvoltatori, Ollama este instrumentul vedetă, deoarece este open source și vă permite să utilizați inteligența artificială locală pe computer foarte eficient prin containere Docker.

Există și alte alternative interesante, cum ar fi Llama.cpp pentru suport hardware larg sau Jan pentru cei care prioritizează un mediu 100% offline. Există chiar și aplicații pentru smartphone-uri precum PocketPal, care aduc inferența direct în buzunar, demonstrând că inteligența artificială nu mai are nevoie neapărat de un supercomputer pentru a fi utilă.
Tendința este clară: inteligența artificială se îndreaptă către un model distribuit. Viitorul nu se află într-un singur creier centralizat în cloud, ci într-o rețea inteligentă de inferență răspândită în centre de date și dispozitive locale. Această arhitectură hibridă permite un echilibru între puterea de calcul, nevoia de răspunsuri instantanee și protejarea confidențialității datelor corporative.
