- Diferențe arhitecturale dintre CPU și GPU care permit calculul paralel masiv.
- Strategii de implementare în cloud utilizând modele de aprovizionare standard, spot și flexibile.
- Criterii tehnice critice pentru selecția hardware-ului bazate pe VRAM, lățime de bandă și latență.
- Programare avansată și sisteme de orchestrare globală pentru optimizarea utilizării clusterelor de inteligență artificială.

Când vorbim despre puterea brută pentru mutarea munților de date, este imposibil să nu menționăm rolul fundamental jucat de unitățile de procesare grafică. Deși inițial au fost concepute pentru a face jocurile video să arate incredibil, astăzi acestea sunt principalul motor al inteligenței artificiale și al analizei masive de date, permițând finalizarea sarcinilor care anterior durau săptămâni în doar câteva ore.
Mutarea acestor sarcini de lucru în cloud a schimbat complet regulile jocului pentru dezvoltatori și specialiștii în date. Nu mai este necesar să cheltuim o avere pe hardware care devine rapid învechit; în schimb, putem închiria putere de calcul adaptată nevoilor noastre reale, scalând resursele în funcție de proiect și optimizând fiecare bănuț investit în infrastructură.

CPU vs. GPU: Care este diferența reală?
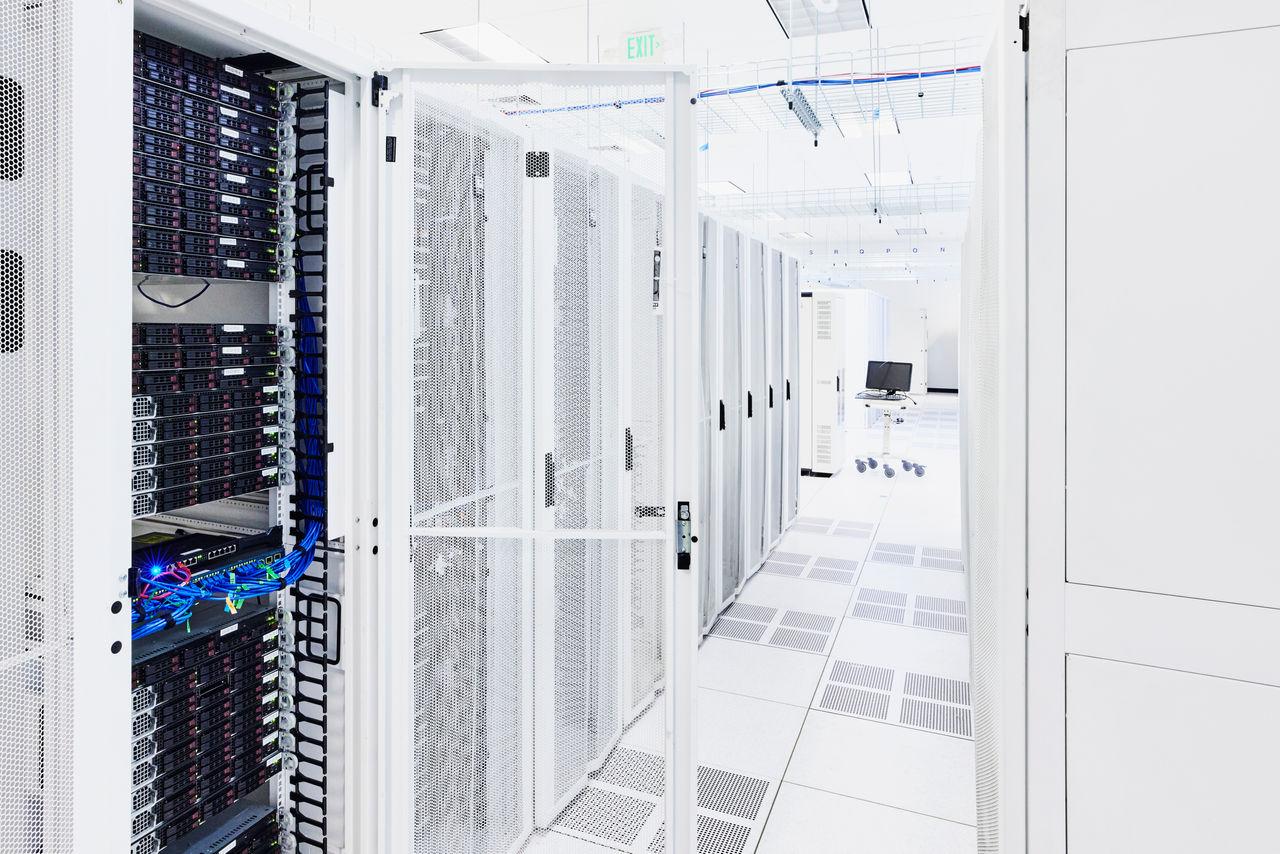
Simplu spus, procesorul (CPU) este ca un conductor extrem de inteligent, care poate face totul, dar procesează sarcinile una după alta. În schimb, GPU-ul este ca o armată de mii de muncitori specializați în efectuarea aceleiași operații matematice iar și iar, dar simultan. Aceasta este baza a ceea ce numim calcul paralel.
În timp ce procesorul gestionează logica complexă și controlul sistemului, GPU-ul excelează la procesarea matriceală și redarea imaginilor. Datorită sutelor sau miilor de nuclee , similar cu o arhitectură CPU multi-core , dar la scară largă, poate executa simultan mai multe subseturi ale unei sarcini - vital pentru antrenarea rețelelor neuronale sau procesarea terabyților de date fără ca sistemul să se blocheze.
Gestionarea lucrărilor în lot și în timp real
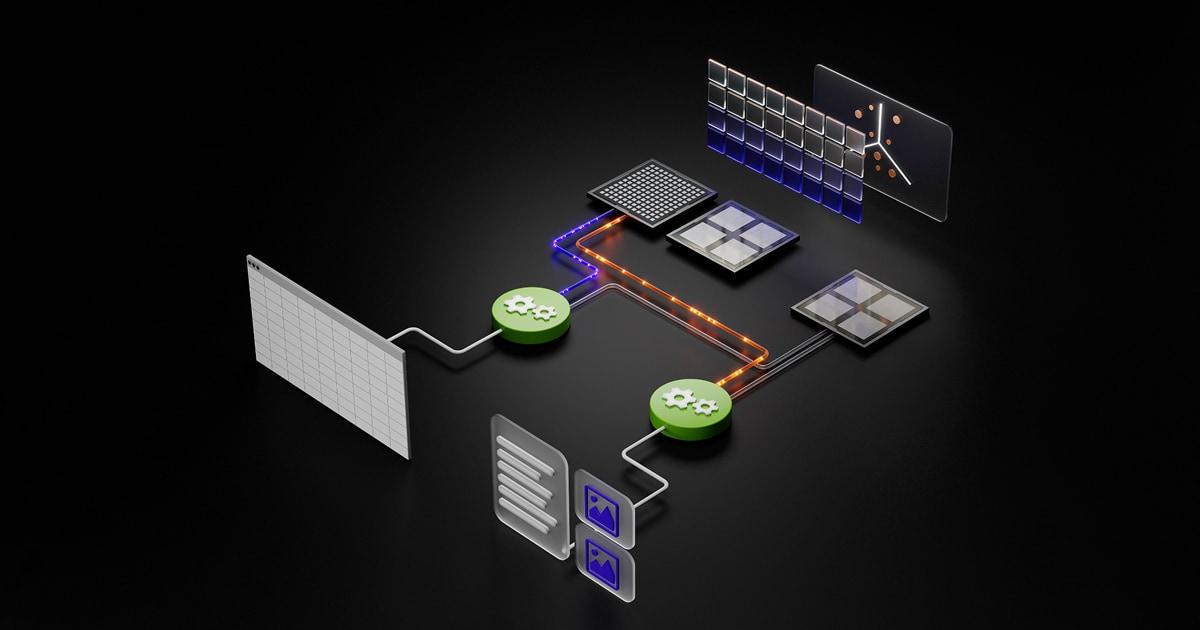
În ecosistemul cloud, există două modalități principale de a efectua aceste sarcini. Procesarea în loturi este ideală pentru joburi care nu necesită un răspuns imediat, cum ar fi preprocesarea datelor sau inferența masivă. Aici, scopul este de a maximiza eficiența și performanța generală a sistemului , permițând acumularea și rularea joburilor atunci când resursele sunt disponibile.
Pe de altă parte, procesarea în timp real este esențială pentru aplicațiile care trebuie să răspundă instantaneu, cum ar fi chatboții generativi cu inteligență artificială sau recunoașterea facială. În aceste cazuri, prioritatea absolută este latența scăzută și disponibilitatea ridicată, asigurându-se că utilizatorul final nu observă nicio întârziere în timp ce modelul procesează informațiile.
Pentru a configura un proiect de acest gen, planificarea cerințelor este esențială. De la selectarea mașinii potrivite până la instalarea driverelor (care poate fi automată sau manuală folosind imagini personalizate), fiecare pas influențează dacă procesul este fluent sau o bătaie de cap tehnică.
Modele de consum și optimizarea costurilor
Nu toate mașinile virtuale sunt create la fel și nici nu costă la fel. Pentru cei care doresc să economisească bani, mașinile virtuale Spot sunt o opțiune tentantă, oferind reduceri masive, deși prezintă riscul ca cloud-ul să le revendice oricând. Sunt perfecte pentru sarcini tolerante la erori în care costul este prioritatea.
Dacă aveți nevoie de ceva mai stabil, dar la un preț redus, există mașini virtuale flexibile pentru startup , care permit accesul la resursele GPU la prețuri reduse în schimbul unei întârzieri de câteva zile înainte de începerea lucrărilor. Pentru proiectele critice, opțiunile sunt furnizarea standard la cerere sau rezervările programate , care garantează că hardware-ul este acolo exact atunci când aveți nevoie de el.

O tehnică avansată pentru maximizarea bugetului este arbitrajul costurilor regionale . Profitând de variațiile de preț între zonele geografice sau utilizând programarea „urmăriți soarele” permite echipelor din Asia, Europa și cele două Americi să utilizeze pe rând clusterele, atingând o utilizare a hardware-ului de aproape 100%.
Cum să alegi GPU-ul potrivit pentru cazul tău de utilizare

Nu este vorba despre alegerea celei mai scumpe plăci, ci despre cea care se potrivește cel mai bine sarcinii. În antrenamentul cu model de limbaj mare (LLM) , memoria video (VRAM) este principalul blocaj. Dacă rămâneți fără VRAM, va trebui să reduceți dimensiunile loturilor, ceea ce va crește semnificativ timpii de execuție și costurile generale.
- Antrenament AI: Necesită putere mare în precizie mixtă (FP16/BF16) și o memorie VRAM generoasă pentru a gestiona gradienții și stările optimizatorului.
- Inferență în timp real: Aici, latența rețelei și stabilitatea stivei de software sunt esențiale pentru prevenirea întreruperilor de producție.
- Știința datelor: Se caută un echilibru între CPU, RAM și GPU, deoarece o mare parte din curățarea datelor este încă o sarcină secvențială.
- Randare 3D și efecte vizuale: Acestea depind în mod critic de lățimea de bandă a memoriei pentru a muta rapid texturi și geometrii complexe.
- Calcule științifice: Acestea prioritizează precizia FP32 sau FP64 și reproductibilitatea exactă a rezultatelor prin versiuni de drivere fixe.
Este vital să monitorizați fluxul de date al sistemului . A avea un GPU ultra-puternic este inutil dacă procesorul sau stocarea sunt lente; în acest caz, GPU-ul își va petrece cea mai mare parte a timpului inactiv, așteptând date, ceea ce este cunoscut sub numele de subutilizare a resurselor.
Orchestrarea avansată și viitorul informaticii
Pe măsură ce clusterele cresc, programarea simplă de tip „primul intrat, primul ieșit” nu mai funcționează. Companiile de top implementează ierarhii de programare pe mai multe niveluri care distribuie locurile de muncă în funcție de locația datelor, prioritatea afacerii și amprenta de carbon a regiunii.

Inovații precum comutarea CPU/GPU în timp real permit sistemului să decidă din mers care procesor este cel mai eficient pentru fiecare fir de execuție. Acest lucru abordează deficitul global de hardware prin optimizarea fiecărui ciclu de ceas disponibil, permițând inteligenței artificiale generative și gemenilor digitali să avanseze fără a fi blocate de lipsa cipurilor.
Utilizarea Kubernetes cu tehnologia Dynamic Resource Allocation (DRA) și Multi-Instance GPU (MIG) permite împărțirea unei singure plăci grafice fizice în mai multe instanțe virtuale. Acest lucru democratizează accesul la calcul de înaltă performanță, permițând mai multor utilizatori să partajeze aceeași GPU fără a interfera unii cu alții.
O strategie clară care combină hardware-ul potrivit, un model de plată inteligent și o orchestrare flexibilă este singura modalitate de a evita risipa de bani pe cloud computing. De la selecția VRAM până la implementarea instanțelor Spot, fiecare decizie tehnică are un impact direct asupra vitezei de inovare și a profitabilității oricărui proiect de calcul avansat.
