- Искусственный интеллект преобразует управление файлами, автоматизируя классификацию, извлечение стратегически важных данных и проверку подлинности.
- Такие технологии, как обработка внутренней информации, компьютерное зрение и обработка естественного языка, позволяют сократить количество человеческих ошибок и оптимизировать соблюдение нормативных требований в критически важных секторах.
- Способность анализировать сложные схемы и выявлять изощренные мошеннические действия превращает управление документами в конкурентное преимущество и преимущество в области безопасности.
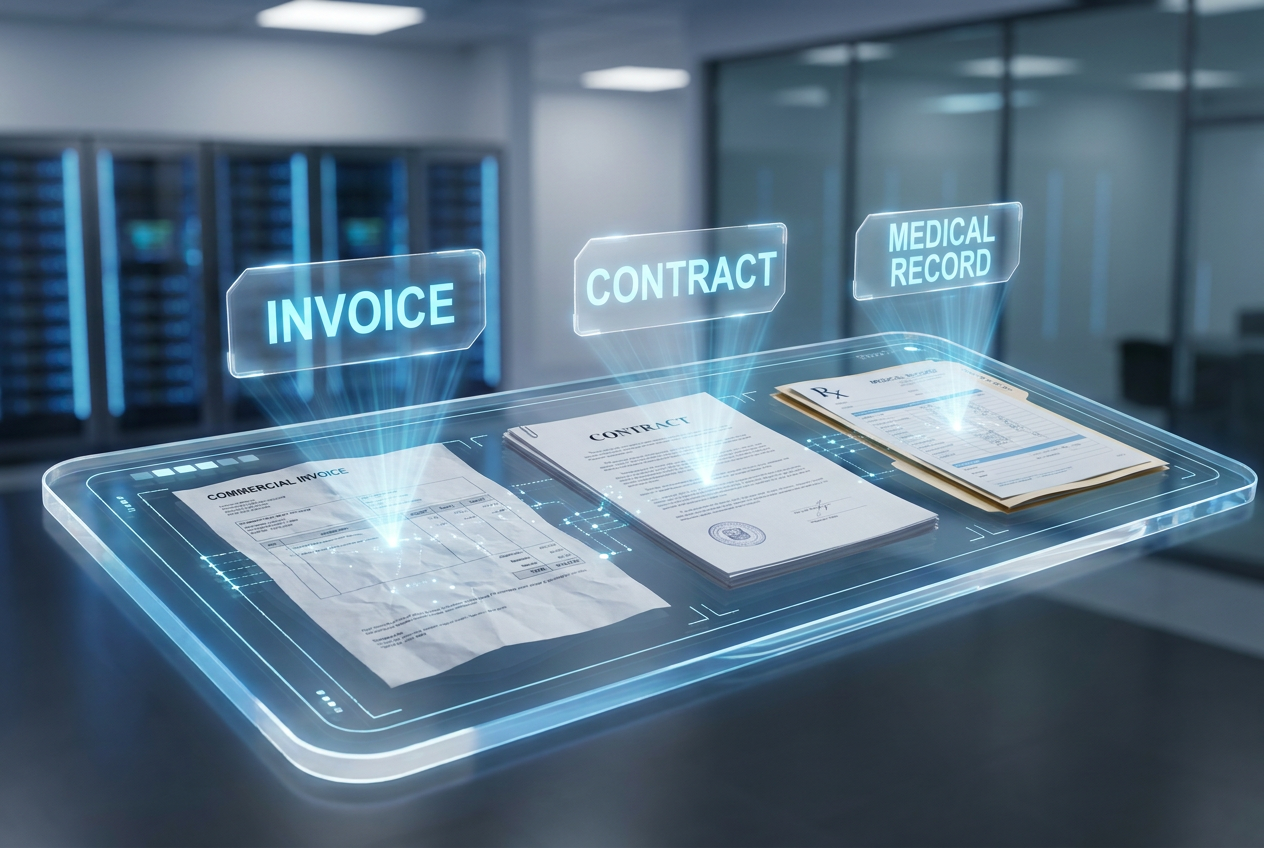
Управление информацией в компаниях уже не сводится к простому архивированию документов или сохранению PDF-файлов в общей папке. В условиях стремительного роста объёма данных организации погрязли в море неструктурированных файлов , где поиск нужной информации может превратиться в настоящую одиссею. Именно здесь на помощь приходит искусственный интеллект в архивировании и управлении документами , не просто помогая, а полностью меняя правила игры, превращая документальный хаос в стратегический актив.
Внедрение интеллектуальных систем обнаружения и анализа позволяет компаниям прекратить тратить время на повторяющиеся и утомительные задачи. Больше нет необходимости в том, чтобы эксперт вручную читал каждый контракт или проверял каждый счет-фактуру; теперь, благодаря алгоритмам машинного обучения и компьютерному зрению , машины могут понимать содержание документа, его назначение и потенциальные риски — и все это за доли секунды и с точностью, которая превосходит возможности человеческого глаза.

Интеллектуальная классификация документов
Классификация файлов — это не просто их маркировка; это автоматическая категоризация деловых документов для оптимизации ресурсов и предотвращения критических ошибок. Ранее этот процесс представлял собой узкое место, требующее сложного программирования или утомительной ручной работы. Сегодня искусственный интеллект сканирует каждый входящий файл и помещает его в предопределенные категории, направляя непосредственно в соответствующий рабочий процесс для бесперебойной обработки.
Для этого ИИ использует такие фундаментальные понятия, как идентификация объектов (имена, даты или числа), присвоение категории риска (например, общедоступные или конфиденциальные документы) и постоянная маркировка. Последняя крайне важна для того, чтобы другие инструменты безопасности знали, как обрабатывать файл. Кроме того, контекстуализация позволяет ИИ понимать документ на протяжении всего его жизненного цикла, достигая точности более 95% , опираясь не только на ключевые слова, но и на фактическое значение текста.

Проверка личности и предотвращение мошенничества
В сфере безопасности искусственный интеллект совершил качественный скачок в проверке документов, удостоверяющих личность, став центральным элементом процессов KYC (Know Your Customer — «Знай своего клиента») и AML (Anti-Money Laundering — противодействие отмыванию денег). Используя компьютерное зрение и анализ изображений , системы могут обнаруживать практически невидимые изменения, такие как поддельные голограммы, фальсифицированные водяные знаки или несоответствия в микропечати, которые остались бы незамеченными большинством людей.
Одно из его главных преимуществ — способность бороться с цифровым мошенничеством. Искусственный интеллект анализирует аномалии на уровне пикселей для обнаружения ретуши в Photoshop или изменения лица (дипфейки). Кроме того, биометрическое сопоставление лиц сравнивает фотографию документа с видеозаписью пользователя в реальном времени, используя пассивное или активное определение присутствия, чтобы убедиться, что человек, предъявляющий документ, действительно присутствует, а не просто маска или фотография.

Технологии управления: IDP, NLP и OCR.
Движущей силой всего этого является интеллектуальная обработка документов (IDP), которая объединяет несколько технологий для извлечения реальной ценности из данных. Усовершенствованное оптическое распознавание символов (OCR) больше не просто читает буквы; оно интерпретирует контекст для обеспечения точности , преобразуя изображения или физические документы в структурированные данные. В то же время обработка естественного языка (NLP) позволяет машине понимать семантику текста, облегчая обнаружение закономерностей и аномалий.
- Поиск с использованием искусственного интеллекта Azure: Сервис, позволяющий проводить углубленный семантический поиск в огромных объемах неструктурированных данных, идеально подходящий для юридических или кадровых отделов.
- Языковые модели (LLM): Такие инструменты, как GPT-4, Claude или Gemini, позволяют одновременно суммировать данные из нескольких файлов и отвечать на сложные вопросы о содержимом исходного файла.
- Анализ поведения: Системы, отслеживающие взаимодействие пользователя с документом для идентификации потенциальные признаки мошенничества.
Практическое применение в различных секторах
Универсальность этих инструментов позволяет извлечь выгоду практически из любой отрасли. В финансовой сфере платежи и проверка кредитов автоматизируются за счет извлечения данных в режиме реального времени. В юридической сфере ИИ анализирует контракты, чтобы выявить рискованные пункты или нарушения, оптимизируя процесс электронного поиска доказательств путем фильтрации тысяч документов за считанные секунды.
В сфере здравоохранения ИИ используется для оцифровки медицинских записей и автоматизации обработки страховых случаев , что предотвращает потерю конфиденциальных данных. В то же время, в сфере управления персоналом интеграция систем планирования ресурсов предприятия (ERP) и программного обеспечения для управления человеческими ресурсами позволяет автоматически классифицировать резюме по навыкам, чтобы найти идеального кандидата без необходимости просматривать сотни профилей. В логистике распознавание накладных и счетов-фактур значительно сокращает операционные ошибки и оптимизирует цепочку поставок.

Внедрение системы и связанные с этим проблемы
Для внедрения подобной системы недостаточно просто установить программное обеспечение; необходимо выявить проблемные места, такие как трудоемкие процессы. Крайне важно определить измеримые цели и обеспечить масштабируемость решения , а также его соответствие таким нормативным требованиям, как GDPR и CCPA, поскольку обработка персональных данных — это деликатная область.
Не всё так гладко, существуют серьёзные проблемы. Предвзятость в обучающих данных может привести к несправедливым результатам для определённых демографических групп, поэтому использование разнообразных наборов данных имеет жизненно важное значение. Кроме того, мошенники постоянно совершенствуют свою тактику, вынуждая модели ИИ постоянно переобучаться, чтобы не устаревать.
Интеграция этих возможностей позволяет инструментам предотвращения потери данных (DLP) работать с хирургической точностью. Если ИИ помечает файл как конфиденциальный, представляющий высокий риск , система безопасности может автоматически заблокировать его выход из корпоративной сети. Это превращает управление документами в настоящий щит кибербезопасности, гарантирующий полную отслеживаемость конфиденциальной информации.
Слияние семантического анализа, компьютерного зрения и генеративных моделей создает экосистему, в которой информация не просто хранится, а активно управляется. Автоматизируя определение и проверку типов файлов, организации не только сокращают затраты и время, но и защищают свою инфраструктуру от мошенничества , а также принимают решения на основе реальных, структурированных данных.
