- В Linux каналы связи позволяют объединять процессы путем соединения стандартного вывода и стандартного ввода, при этом ядро поддерживает их использование, а такие инструменты, как tee, xargs и cpio, позволяют создавать сложные потоки данных.
- Эффективный конвейер CI/CD в Linux основан на грамотном проектировании этапов, интенсивном использовании кэша, неизменяемых артефактах и параллельном тестировании.
- Оптимизация Linux-сервера (процессор, оперативная память, ввод-вывод, Docker) и исполнителей Jenkins, GitHub Actions или GitLab Runner является ключевым фактором сокращения времени.
- Интеграция безопасности, наблюдаемости и контроля затрат в конвейер обработки данных обеспечивает надежное, отслеживаемое и устойчивое развертывание в производственных средах.
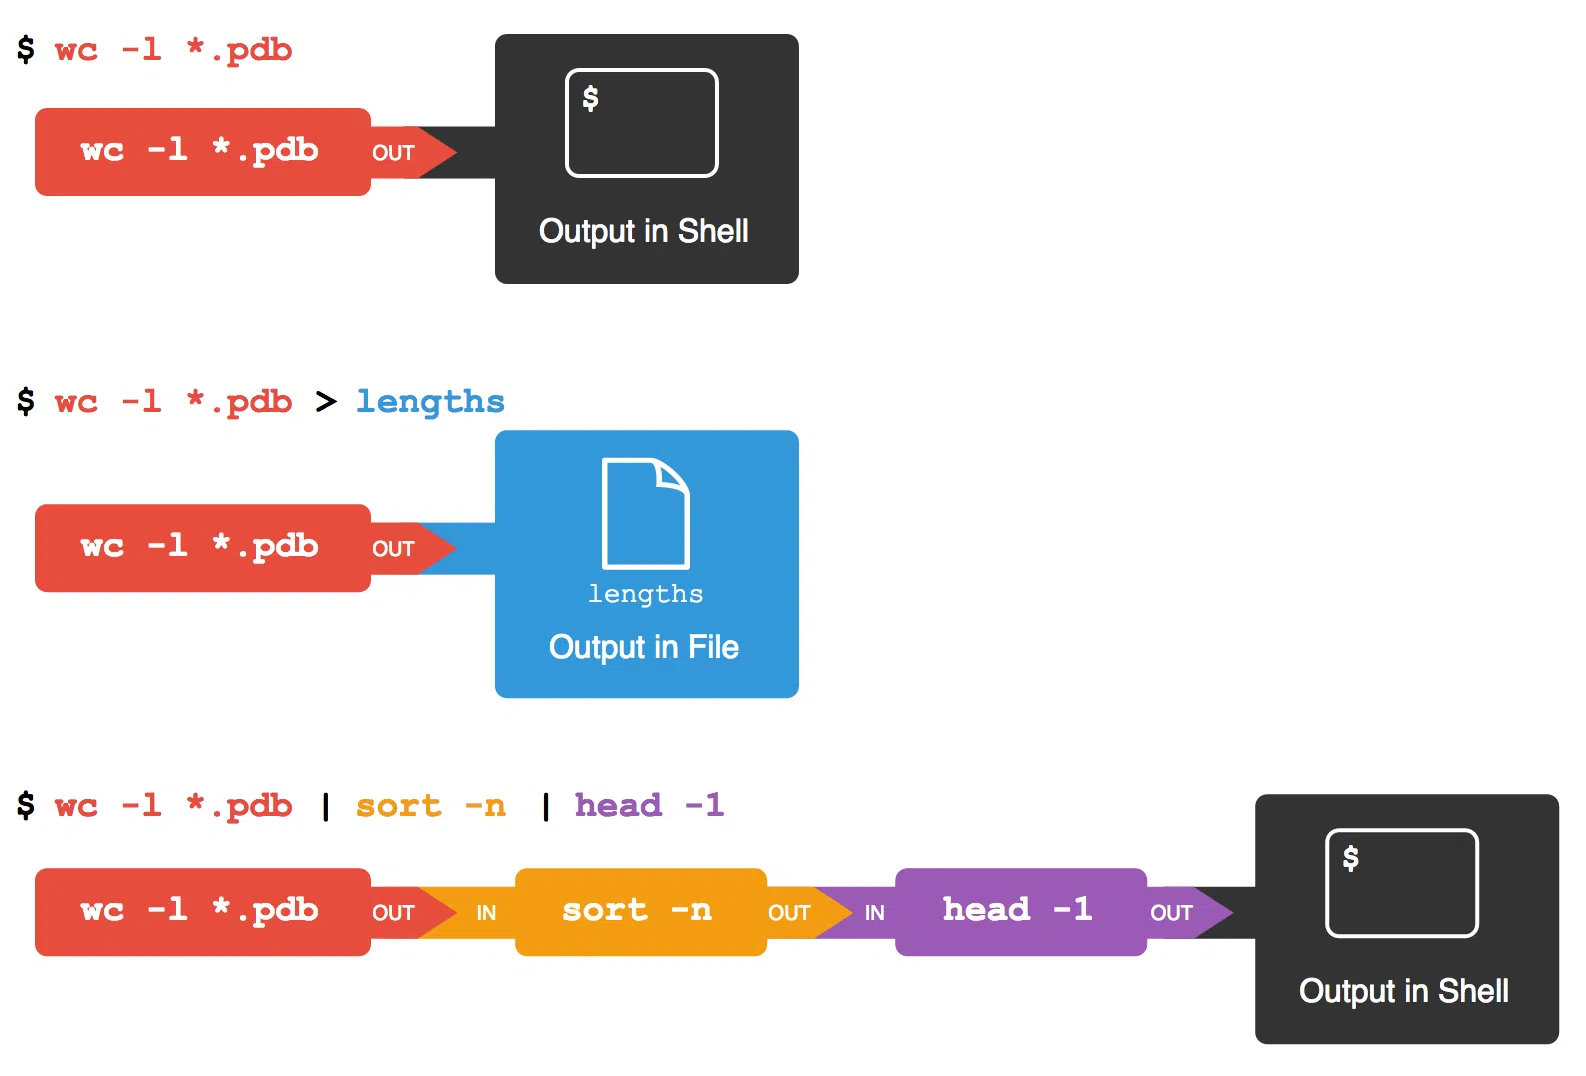
Оптимизация конвейеров в Linux Речь идёт не только о формировании цепочек команд с помощью символа. |За всем этим скрывается целый мир. оптимизация производительностиПроектирование рабочих процессов, CI/CD, безопасность и настройка операционной системы — всё это имеет решающее значение для того, чтобы конвейер работал быстро, надёжно и недорого в обслуживании. Если вы работаете с серверами Linux, будь то автоматизация задач в терминале или запуск конвейеров непрерывной интеграции, понимание этих деталей сэкономит вам много времени и избавит от головной боли.
В этой статье мы объединим две взаимодополняющие точки зрения: с одной стороны, Классическое использование конвейеров в командной строке Linux. (каналы, перенаправления, команды типа tee, xargs o cpio); с другой стороны, Оптимизация конвейера CI/CD на серверах LinuxЭто включает в себя кэширование, распараллеливание тестов, настройку Docker, безопасность цепочки поставок и расширенные метрики рабочих процессов. Все объяснено на испанском языке (из Испании) с наглядными примерами и очень практическим подходом.
Что такое конвейер и как конвейеры вписываются в Linux?
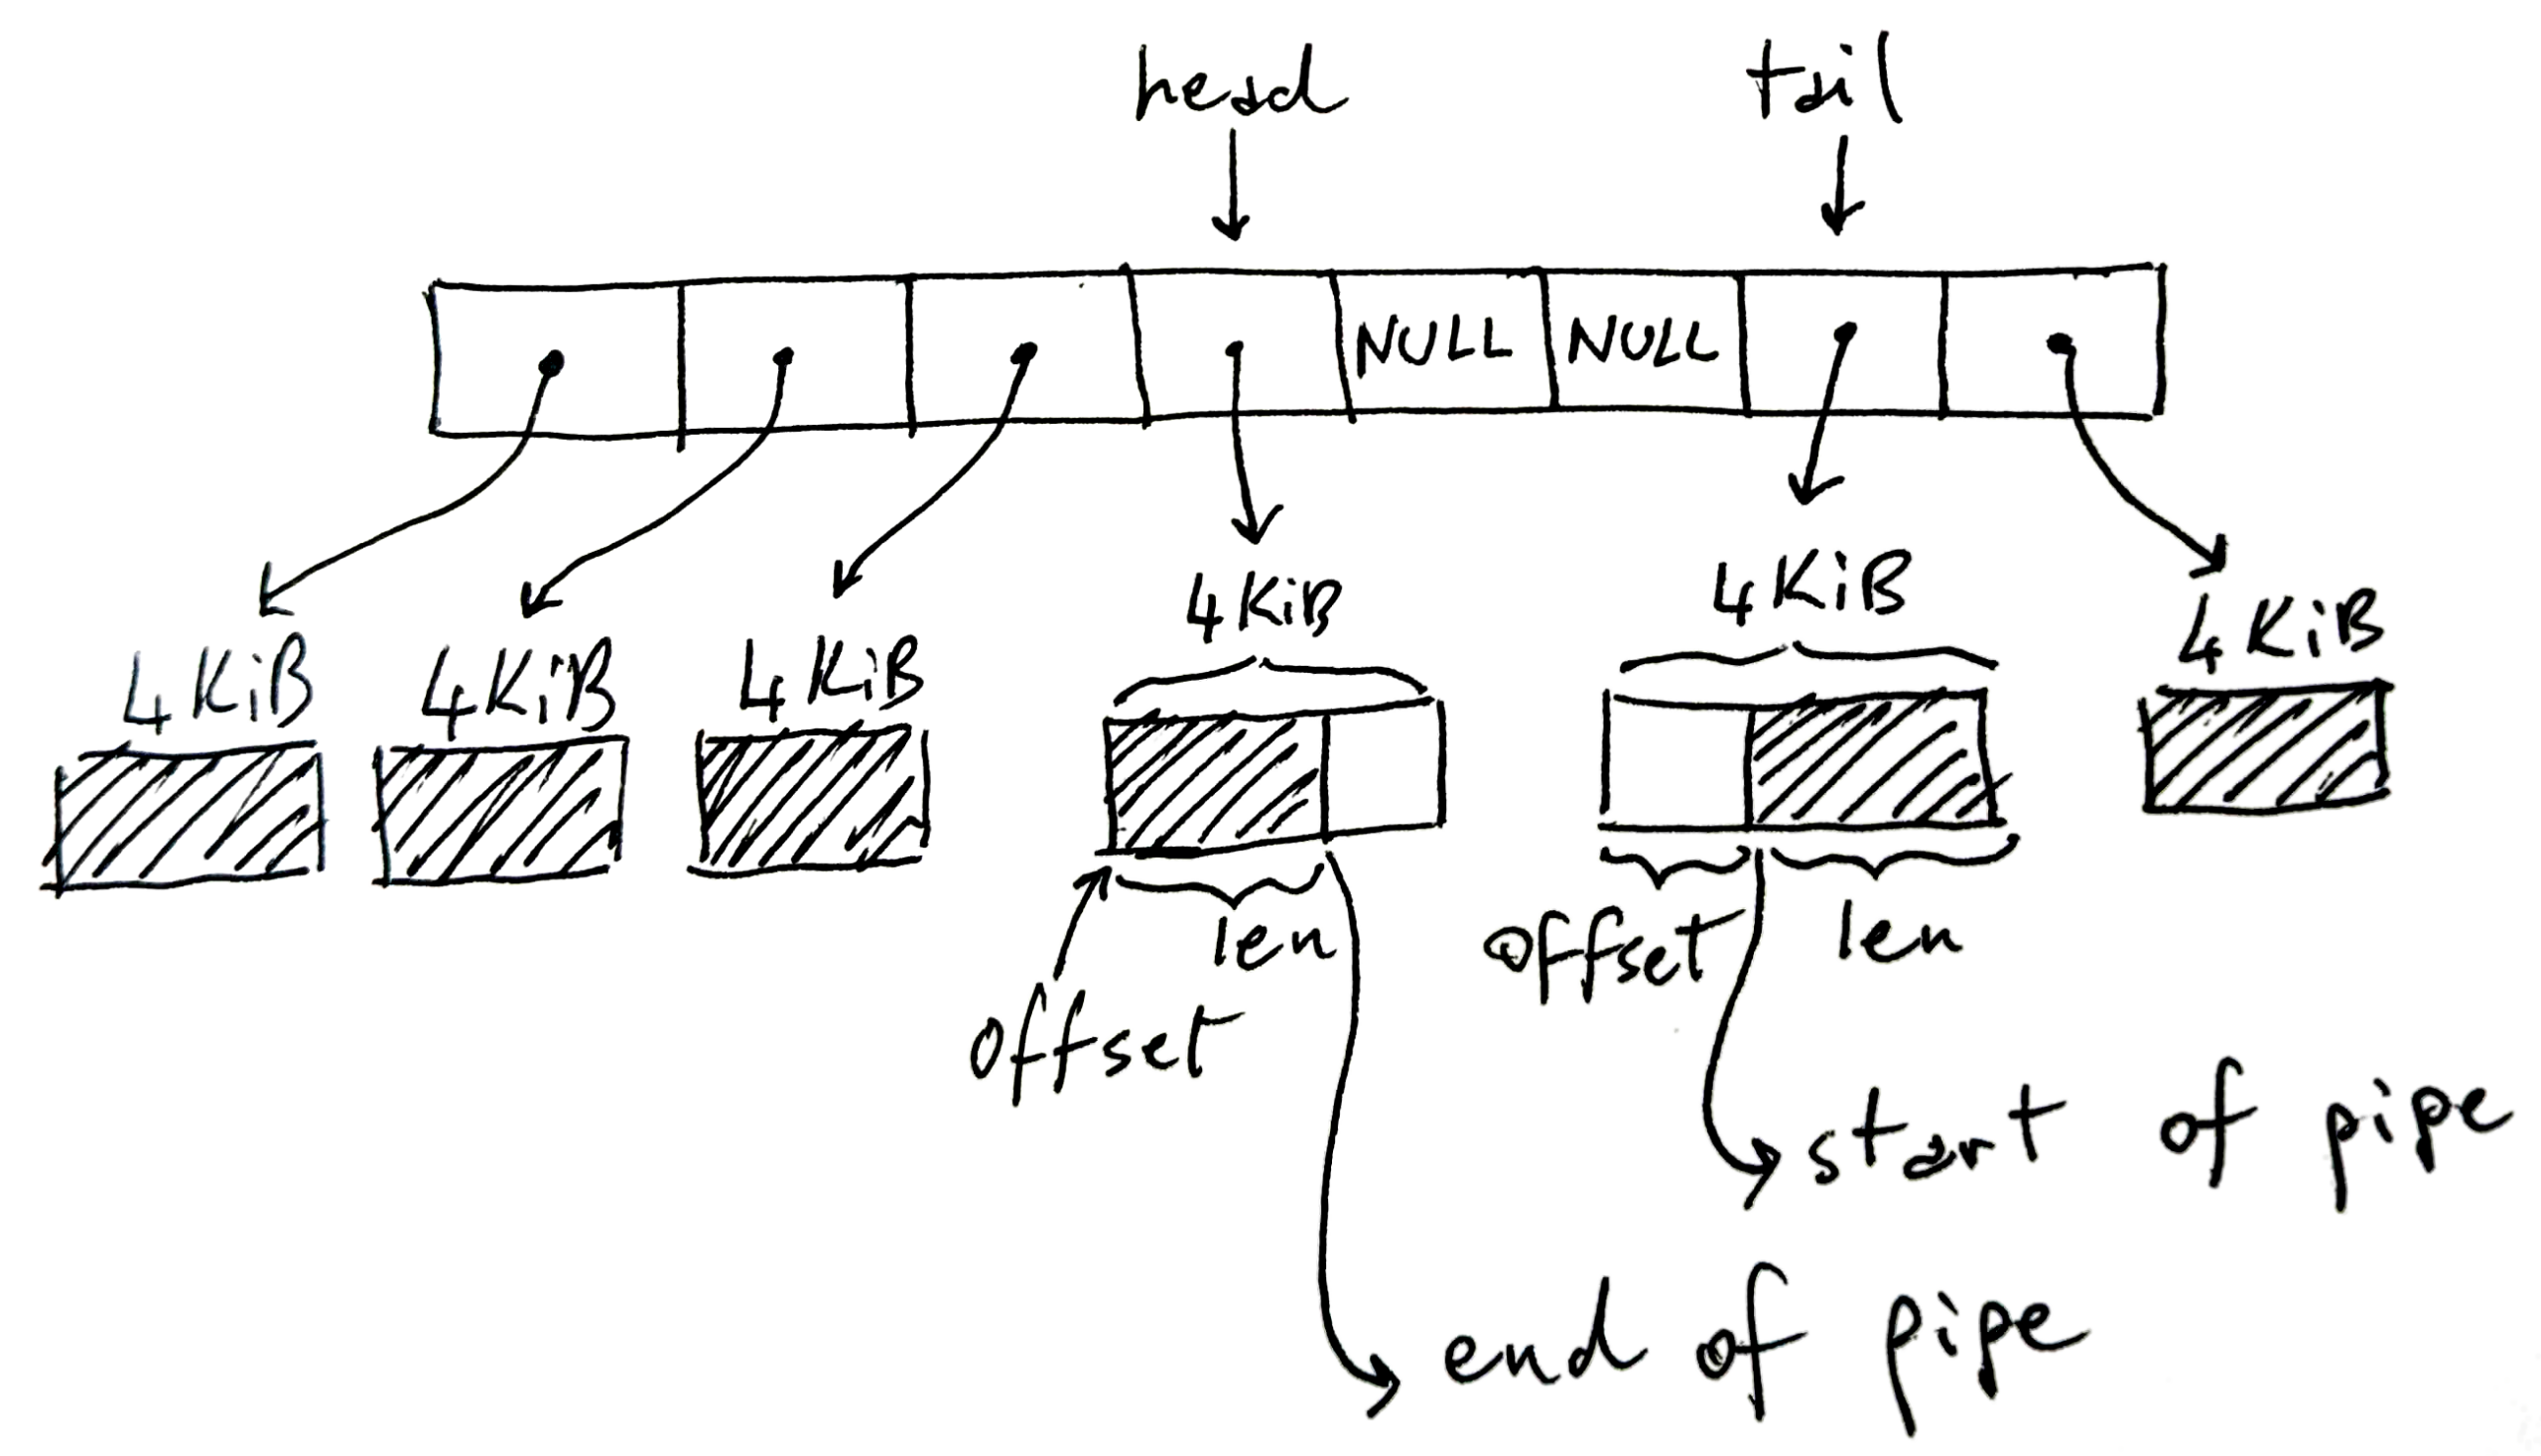
Термин «конвейер» происходит от идеи «трубы» : потока данных, перемещающегося из одной точки в другую. В вычислительной технике, и в частности в Linux, «труба» — это механизм, позволяющий стандартному выводу одного процесса стать стандартным вводом другого. Другими словами, вывод одной команды автоматически передается в следующую, минуя промежуточные файлы.
В Unix-подобных системах существует два основных типа каналов . С одной стороны, это анонимные или безымянные каналы , которые могут использоваться только между тесно связанными процессами (например, родительским и дочерним). С другой стороны, существуют именованные каналы , также известные как FIFO (First In – First Out), которые позволяют обмениваться данными между процессами, не связанными напрямую и даже находящимися на разных машинах, подключенных к сети.
Анонимные каналы обычно обеспечивают однонаправленную связь : один процесс записывает, а другой читает. В отличие от них, именованные каналы допускают двунаправленную связь , если они спроектированы соответствующим образом, например, путем открытия FIFO в режиме чтения/записи с обоих концов. Они широко используются для координации процессов демонов, скриптов или служб, которым необходимо передавать данные друг другу без блокировки.
На уровне реализации поддержка конвейеров осуществляется в ядро linuxне в оболочке. Интерпретатор команд (bash, zsh и т. д.) просто создает конвейер с помощью системных вызовов, например: pipe() y fork()Перенаправьте дескрипторы файлов, а затем запустите каждую программу. Реальная магия блокировки процессов, управления буфером и распространения данных между производителем и потребителем обрабатывается ядром системы.
Понимание stdin, stdout и потока данных
Для эффективной работы с конвейерами крайне важно понимать, что такое stdin, stdout и stderr . Это не абстрактные понятия: каждый процесс в Linux начинается с трех открытых файловых дескрипторов, которые указывают на конкретные ресурсы, управляемые ядром.
stdin (дескриптор 0) и stdout (дескриптор 1) можно рассматривать как потоки байтов, подключенные к чему-либо: это может быть терминал, файл, сетевой сокет или канал. Это не просто буферы; это ссылки на объекты ядра ( структуры файлового типа ), которые, в свою очередь, связаны с inode, сокетами или внутренними структурами каналов.
Каждый процесс имеет свои собственные дескрипторы, так что каждая команда в конвейере Он рассматривает стандартный ввод и стандартный вывод независимо друг от друга. В строке, подобной этой: ls | grep txt | wc -l, el
ls написать в трубке, grep Оно считывает данные из одного канала и записывает их в другой, и wc Читайте с последнего элемента. Для пользователя он отображается как единая строка, но внутри системы они представляют собой несколько объединенных буферов ядраПри этом каждый процесс блокируется и возобновляется в зависимости от доступного пространства или данных.
Когда первый процесс генерирует данные быстрее, чем второй их потребляет, буфер канала заполняется. В этот момент последующие операции записи прекращаются, блокируя отправляющий процесс до тех пор, пока потребляющий процесс... достаточно прочтите информации и освобождает место. Это предотвращает бесконтрольное разрастание памяти; данные не накапливаются бесконечно, если не использовать неблокирующий ввод-вывод или специальные сигналы. Например, в таком случае, как dd if=/dev/sda | gzip -9и gzip сжимается медленнее, dd Он вынужден ждать.
Этот механизм противодавления делает конвейеры достаточно стабильными даже при наличии дисбаланса производительности между этапами, что затем отражается и на проектировании конвейеров CI/CD , где медленные этапы становятся узким местом, которое необходимо измерять и оптимизировать.
Практическое использование каналов в терминале Linux
В повседневной жизни конвейеры используются для объединения команд в одной строке и пошагового преобразования данных. Вместо того чтобы запускать команду, просматривать результат, копировать его и вставлять в другую команду, можно создавать небольшие, очень гибкие «фабрики данных» в обычном текстовом формате.
Типичным примером в средах Unix является объединение команд. fortune, которая отображает случайные цитаты, с cowsayкоторый выводит на экран "говорящую" корову. При использовании конвейера, Уход Форчуна становится посланием Коусея.Всё это одной командой. Это забавный пример, но он прекрасно иллюстрирует идею объединения простых инструментов для решения более сложных задач.
Ещё один классический вариант — отправить результат ls a wc Подсчитать строки, слова и символы. Что-то вроде... ls | wc Это позволяет быстро увидеть, сколько товаров отображается в списке. Прелесть в том, что вам не нужна одна программа для всего, а скорее... Вы создаете решения с помощью небольших, хорошо продуманных утилит..
Также очень часто их соединяют в цепочки. cat, sort y more (или другой пейджер) для сортировки текстового файла с последующим постраничным просмотром. При использовании конвейера содержимое передается от одной команды к другой без сохранения в явных временных файлах, что значительно упрощает написание скриптов и административные задачи.
В практических случаях, например, при обработке списков учащихся и оценок в отдельных файлах, можно использовать paste для объединения столбцов, cut Чтобы выбрать только интересующие вас поля, используйте цепочки конвейеров для фильтрации, сортировки или преобразования всего в одной строке скрипта оболочки. Этот шаблон Разбейте большую проблему на простые команды, объединенные с помощью конвейеров. Это суть философии Unix.
Расширенные команды для максимально эффективного использования каналов: tee, xargs и cpio.
Когда вы начинаете по-настоящему автоматизировать процессы в Linux, конвейеры становятся еще более мощными благодаря ряду ключевых инструментов. Среди них: tee, xargs y cpioкоторые очень хорошо дополняют стандартный поток данных.
Команда tee Он работает как тройник в водопроводной трубе: считывает данные из стандартного ввода, записывает в стандартный вывод, а также копирует этот же вывод в один или несколько файлов. Это идеально подходит, когда вам нужно Просмотрите результат на экране и одновременно сохраните его. для последующего просмотра или обработки на другом этапе. С возможностью -a Эта команда добавляет данные в конец файла, а не перезаписывает его.
Например, вы можете отсортировать список с помощью sortотправить результат tee сохранить это в журнале и одновременно передать его дальше. more для постраничного отображения. Таким образом, в рамках одного процесса вы получаете сортировку, сохранение на диск и удобный просмотр без повторения процесса сортировки.
Команда xargs Это ещё один фундаментальный элемент, когда речь идёт о каналах ввода. Его функция заключается в том, чтобы брать то, что поступает через стандартный ввод (обычно список элементов), и преобразовывать это в аргументы для другой команды. Это особенно полезно, когда программа аварийно завершает работу из-за получения слишком большого количества параметров одновременно, или когда вам нужно... Разбейте работу на этапы. с опцией -n, что ограничивает количество аргументов, передаваемых за одно выполнение.
Например, с ls | xargs -n 4 Вы разделяете список файлов на группы по четыре, выполняя целевую команду (по умолчанию). echo(или тот, который вы укажете) несколько раз. Таким образом, вы можете создавать конвейеры, например, "предварительный просмотр того, что я собираюсь удалить", комбинируя их. ls, xargs y echo rm перед началом фактического удаления данных.
Будьте осторожны со сложными входными данными: Пути с пробелами или специальными символами может нарушить поведение по умолчанию xargsВ таких случаях его обычно используют в сочетании с find и вариант -print0, который разделяет элементы нулевым символом, наряду с xargs -0 чтобы с обеих сторон использовался один и тот же надежный разделитель.
Наконец, cpio Это менее известная команда, чем... tarНо он невероятно гибок в работе с файловыми потоками через каналы. В отличие от tar, он изначально разработан для работы с... перенаправления и каналыполучает список файлов через стандартный ввод (обычно генерируется с помощью find) и создает или потребляет файлы типа «пакет» без собственного сжатия, которые затем можно сжать с помощью gzip или похожие.
Основные способы cpio разрешить создание файлов (-o), копировать деревья каталогов (-p) или извлечь содержимое (-i(часто называемое «копирование»). Варианты, такие как -u перезаписать, -m для сохранения временных меток или -d воссоздание структуры каталогов делает это возможным. детально контролировать, что копируется и как.особенно полезно в сложных скриптах, где tar не дотягивает.
Проектирование и оптимизация конвейеров CI/CD на серверах Linux.
Концепция конвейера, выходящая за рамки традиционной командной строки, стала основополагающей в мире непрерывной интеграции и непрерывной доставки (CI/CD) . На сервере Linux конвейер CI/CD представляет собой автоматизированную последовательность шагов: получение кода, установка зависимостей, компиляция, запуск тестов, упаковка артефактов и развертывание.
Linux особенно хорошо подходит для этого, поскольку отличается скоростью, стабильностью и экосистемой инструментов автоматизации . Такие платформы, как Jenkins, GitHub Actions и GitLab CI, полагаются на исполнителей Linux (физические машины, виртуальные машины или контейнеры) для стабильного выполнения конвейеров.
Оптимизация этих конвейеров означает не только обеспечение их «работоспособности», но и минимизацию трений. Это подразумевает сокращение времени извлечения, минимизацию повторных установок зависимостей, оптимизацию образов Docker во избежание ненужных пересборок, повторное использование уже сгенерированных артефактов, а также обеспечение безопасности и наблюдаемости среды.
Основной принцип хорошей практики — структурировать конвейер в четко определенные этапы: сборка, тестирование и развертывание . В идеале компиляцию следует выполнять только один раз, генерировать артефакт (бинарный файл, пакет, образ Docker), который тестируется параллельно в различных вариантах (например, на разных языковых версиях), а затем развертывать тот же артефакт в тестовой и производственной средах без повторной компиляции.
Работа с неизменяемыми артефактами, хранящимися в репозиториях (S3, Nexus, Artifactory, реестрах контейнеров или пакетах, встроенных в GitLab/GitHub), упрощает аудит, позволяет быстро откатывать версии и снижает вероятность ситуации, когда «работает на моей машине, но не в продакшене».
Предварительные условия: дистрибутив, пользователь CI и усиление безопасности сервера.
Прежде чем углубляться в оптимизацию до миллисекунд, важно заложить стабильную основу на сервере Linux , который будет выступать в качестве исполнителя CI/CD. Это начинается с выбора дистрибутива и минимальной конфигурации безопасности.
Наиболее разумный подход обычно заключается в стандартизации на основе LTS- или стабильного дистрибутива , с которым команда знакома: Ubuntu LTS, Debian Stable или корпоративные альтернативы, такие как AlmaLinux или Rocky Linux. Использование одной и той же версии для всех запускаемых процессов предотвращает неожиданное поведение, вызванное различиями в библиотеках или ядрах между заданиями.
Ещё одна рекомендация — настроить выделенный пользователь для CIбез прав root, с использованием sudo, ограниченного только необходимыми командами (например, systemctl o docker (если это действительно необходимо). Этот пользователь должен пройти аутентификацию с помощью SSH-ключей как для доступа к серверу, так и для взаимодействия с репозиториями Git или другими удаленными машинами.
На системном уровне целесообразно проводить техническое обслуживание сервера. обновленный и минимально усиленныйЭто включает в себя применение обновлений безопасности, настройку ограничительного межсетевого экрана (например, с помощью UFW: запрет всего входящего трафика, кроме необходимого, и разрешение исходящего трафика), а также включение таких инструментов, как fail2ban чтобы остановить атаки методом перебора паролей на SSH и настроить некоторые параметры сети и ядра через sysctl для повышения надежности и производительности.
Например, часто повышают лимит Inotify чтобы предотвратить исчерпание ресурсов в системах сборки, отслеживающих множество файлов, и скорректировать параметр. vm.swappiness чтобы сделать ядро более консервативным при использовании файла подкачки, что особенно актуально, когда задачи CI потребляют много памяти одновременно.
Кэши, Docker и параллелизация: рычаги повышения производительности в CI/CD.
Если посмотреть, на что на самом деле уходит время в среднем конвейере разработки, то окажется, что огромная его часть теряется на установку зависимостей и пересборку образов Docker . Решение этой проблемы обычно эффективнее, чем оптимизация тестового кода на несколько миллисекунд.
Первый рычаг — кэширование зависимостей . Практически все менеджеры зависимостей (pip, npm, Maven, Gradle, модули Go и т. д.) используют локальные каталоги кэша. На постоянно работающем сервере Linux вы можете совместно использовать эти каталоги между задачами или монтировать их на постоянный том. Таким образом, каждому выполнению не придётся заново скачивать половину интернета.
Для Docker включите BuildKit и хорошо структурировать Dockerfile Это знаменует собой поворотный момент. Размещение установки зависимостей сразу после копирования файла requirements.txt и перед остальной частью кода гарантирует повторное использование слоев до тех пор, пока версии этих зависимостей остаются неизменными. Кроме того, в самом процессе сборки можно настроить специальные кэши для pip, npm и т.д.
Второй важный рычаг — это параллельное выполнение тестовМногие фреймворки изначально поддерживают параллельное выполнение: pytest c -n autoИнструменты Java, такие как Surefire и Jest, в JavaScript с --maxWorkersи т. д. Разделение пакета тестов на модули, папки или даже по расчетному времени и распределение его между несколькими сотрудниками позволяет сократить продолжительность этапа тестирования в 2–5 раз без изменения ни одного направления бизнеса.
Наконец, существует проблема артефактов и развертывания . Вместо того чтобы перекомпилировать один и тот же образ для промежуточной, предпроизводственной и производственной среды, более эффективный подход заключается в том, чтобы выполнить сборку один раз, сохранить результат в репозитории и пометить его в соответствии со средой развертывания. Это снижает нагрузку на процессор, позволяет избежать несоответствий и значительно ускоряет длительные конвейеры.
Оптимизация Jenkins, GitHub Actions и GitLab Runner на Linux
Каждая система CI имеет свои особенности, но все они выигрывают от применения одних и тех же основных принципов при работе на Linux. Ключевым моментом обычно является использование временных и чистых исполнителей , поддержание достаточно большого постоянного кэша и контроль параллельной обработки.
В Jenkins распространенной практикой является использование легковесных временных агентов (таких как контейнеры Docker или поды в Kubernetes или других решениях для оркестрации контейнеров ) для выполнения заданий, при этом главный узел остается максимально простым. Эти агенты могут быть настроены как службы systemd на серверах Linux, регистрируясь у контроллера и автоматически запускаясь при загрузке машины.
Для GitHub Actions с самостоятельно размещаемыми средствами запуска рекомендуется развертывать их в Виртуальные машины Linux с быстрыми SSD-накопителямиЧтобы создать большой каталог кэша, предназначенный для выполнения определенных действий (зависимости языков, кэширование сборки и т. д.), ограничьте количество одновременно выполняемых задач, чтобы избежать перегрузки процессора и диска. Воспользуйтесь официальным механизмом кэширования, указав пути, например, такие: ~/.cache/pip, ~/.npm o ~/.m2 Это существенно экономит время.
В GitLab Runner выбор между исполнителем командной оболочки и Docker зависит от необходимого баланса между производительностью и изоляцией. Исполнитель командной оболочки быстрее, поскольку работает непосредственно на хосте, но исполнитель Docker предлагает чистые и воспроизводимые среды. Вы также можете настроить общее кэширование (локальное или на S3) и отрегулировать максимальное количество одновременно выполняемых задач, чтобы использовать преимущества оборудования без его перегрузки.
Во всех этих случаях крайне важно использовать общие тома для кэширования зависимостей, предотвращая при этом захламление рабочих областей между сборками. Временные машины или контейнеры, которые создаются и уничтожаются с каждым конвейером или группой конвейеров, значительно уменьшают проблемы типа «вчера работало, а сегодня нет», вызванные остатками предыдущих сборок.
Производительность Linux-сервера: ЦП, память, ввод-вывод и Docker.
Независимо от того, насколько оптимизированы ваши скрипты, если сервер Linux, на котором работает конвейер, не имеет достаточных ресурсов, вы столкнетесь с бесконечными очередями и медленно выполняющимися задачами. Типичная, разумная конфигурация для машины среднего уровня — это 4-8 виртуальных процессоров и 8-16 ГБ оперативной памяти , а также SSD-накопитель (в идеале NVMe) и некоторое пространство подкачки (2-4 ГБ) для обработки пиковых нагрузок без агрессивного завершения процессов.
Файловая система также имеет значение. Используйте ext4 или XFS с опцией noatime В томах, где вы компилируете или записываете журналы, сократите ненужные операции ввода-вывода. Кроме того, монтируйте tmpfs для временных файлов или кратковременных артефактов (например, /mnt/ci-tmp) ускоряет ресурсоемкие операции и предотвращает заполнение диска остаточными файлами между заданиями.
Что касается Docker, то гигиена демонов имеет ключевое значение. Безопасное и регулярное удаление неиспользуемых образов и томов, при одновременном поддержании работоспособности базовых образов, помогает контроль дискового пространства и времени загрузки. Команды типа docker system prune При наличии соответствующих временных фильтров они позволяют проводить очистку без перегрузки недавно использованных ресурсов.
Если ваша система CI интенсивно использует контейнеры, вы также можете использовать зеркальные регистры , чтобы избежать постоянной загрузки из интернета, использовать BuildKit для параллельного выполнения и кэширования слоев, а также настраивать привязку ЦП (наборы ЦП) или выделенные узлы для наиболее ресурсоемких исполнителей, предотвращая конфликты между соседними рабочими нагрузками. Кроме того, понимание микроархитектуры ЦП поможет вам лучше рассчитать ресурсы для интенсивных рабочих нагрузок CI.
Обеспечение безопасности на всех этапах разработки (DevSecOps) и развертывания на Linux.
Быстрый, но небезопасный конвейер — это бомба замедленного действия. Интеграция безопасности в сам конвейер и безопасность контейнеров Docker теперь является стандартом в любой стратегии DevSecOps, и Linux предлагает множество инструментов для этого.
Первое, что нужно сделать, это с предельной осторожностью обращаться с секретами и учетными данными . Они никогда не должны храниться в коде или в версионированных конфигурационных файлах. Вместо этого их следует хранить в менеджерах секретов (маскированные переменные GitLab, зашифрованные секреты GitHub, HashiCorp Vault и т. д.) и внедрять только во время выполнения задачи, которая в них нуждается, используя, по возможности, кратковременные токены.
Ещё одним важным этапом является генерация спецификаций программного обеспечения (SBOM) и подписание артефактов. Такие инструменты, как Syft или CycloneDX, позволяют перечислить все компоненты, составляющие образ или бинарный файл, а Cosign или другие проверяемые решения для подписания гарантируют, что развертываются только те артефакты, которые прошли весь конвейер обработки и были проверены.
Что касается сети и доступа, рекомендуется разделить сети CI и производственной сети , внедрить строгие межсетевые экраны, проводить аудит журналов выполнения и регулярно менять учетные данные. При использовании SSH лучше использовать сертификаты или ключи с ограниченным сроком действия, а не статические пароли.
При развертывании на Linux такие стратегии, как Blue/Green, Rolling и Canary, значительно снижают влияние ошибок развертывания. Запуск приложения в качестве службы systemd, размещение перед ним Nginx или HAProxy и управление трафиком между версиями с помощью проверок работоспособности позволяют добиться практически нулевого времени простоя во время обновлений.
Например, при перезагрузке Nginx и перезапуске служб с помощью systemd с использованием сигналов мягкой остановки (таких как SIGTERMПри разумном времени ожидания вы можете разорвать активные соединения до остановки процесса, сохраняя удобство использования при переключении версий в фоновом режиме.
Наблюдаемость, метрики и затраты в конвейерах обработки данных Linux
После запуска конвейеров следующим шагом является их измерение и понимание того, куда уходят время и ресурсы . Недостаточно знать, успешно ли завершился рабочий процесс или нет; необходимо отслеживать продолжительность каждого этапа, время ожидания в очереди, процент успешных запусков, частоту развертывания, процент попаданий в кэш и так далее.
Обычно системные метрики экспортируются с помощью node_exporterЦентрализуйте логи с помощью таких решений, как ELK или Loki, и визуализируйте все данные на панелях мониторинга Grafana. Таким образом, вы сможете, например, обнаружить, увеличилась ли продолжительность этапа тестирования на 30% за последнюю неделю или тратят ли задания слишком много времени на ожидание доступного исполнителя. мониторинг сетевого трафика Инструменты с открытым исходным кодом дополняют эту прозрачность.
Также можно инструментировать сам конвейер, например, в GitHub Actions или GitLab CI, чтобы Программно измерять количество успешных выполнений, продолжительность каждого запуска и общий статус.Скрипт, который вызывает API поставщика, вычисляет общее количество запусков, количество успешных запусков, количество неудачных запусков, процент успешных запусков и среднюю продолжительность, и сохраняет все данные в JSON-файл (например, pipeline-metrics.json) позволяет интегрировать эти показатели в отчеты или панели мониторинга.
Имея эту информацию, вы можете принимать решения о размере и количестве исполнителей : иногда лучше иметь больше небольших исполнителей, чем несколько очень крупных, чтобы сократить время ожидания. Автомасштабируемость — например, автомасштабирование в облаке или динамические пулы узлов Kubernetes — помогает поглощать пиковую активность в течение дня и минимизировать неиспользуемые ресурсы ночью.
Эти методы не только улучшают опыт команды, но и помогают регулировать затраты на инфраструктуру за счет контроля потребления ресурсов процессора, памяти и, особенно, хранилища, которое имеет тенденцию резко возрастать при работе с образами и кэшем, если его не очищать регулярно и в соответствии с планом.
Овладение как классическими командными конвейерами, так и современными конвейерами CI/CD в Linux дает мощную комбинацию: вы можете автоматизировать все, от простых задач фильтрации текста до сложных, поддерживаемых, безопасных и быстрых конвейеров сборки, тестирования и развертывания. Понимание того, как информация передается между процессами, как кэшируются зависимости, как настраиваются серверы и как интегрируются метрики и безопасность, позволяет создавать рабочие процессы, масштабируемые вместе с вашей командой и проектами, не становясь постоянным узким местом.
