- XAI преобразует модели типа «черный ящик» в прозрачные системы, позволяя нам понять логику каждого алгоритмического решения.
- Существует ключевое различие между интерпретируемостью (по своей сути понятные модели) и объяснимостью (методы для разъяснения сложных моделей).
- Использование таких методов, как индексы Шапли или LIME, помогает смягчить дискриминационные предрассудки и обеспечивает соблюдение правовых норм, таких как нормы ЕС.

Вы, вероятно, сталкивались с взаимодействием с инструментом искусственного интеллекта и задавались вопросом: «Откуда он это взял?» Это ощущение, когда вы стоите перед « чёрным ящиком» , вводите данные и получаете результат, причём никто толком не знает, что происходило между этими действиями, — именно то, что пытается решить искусственный интеллект. Речь идёт не просто о работе машины, а о том, чтобы мы, люди, могли понимать логику каждого ответа, чтобы нам не приходилось слепо доверять алгоритму.
В мире, где ИИ уже решает всё — от выдачи кредита до диагностики заболеваний, — возможность заглянуть под капот и увидеть, как он работает, жизненно важна. Объяснимость ИИ — это не просто техническая прихоть инженеров, а социальная и юридическая необходимость, позволяющая избежать предвзятости, обеспечить справедливость и, прежде всего, предотвратить чувство растерянности у конечных пользователей. Давайте углубимся в эту экосистему, чтобы понять, как перейти от полной непрозрачности к истинной прозрачности.

Что же такое объяснимый искусственный интеллект (XAI)?
Когда мы говорим об XAI, или объяснимом искусственном интеллекте, мы имеем в виду специализированную область, цель которой — сделать внутренние процессы алгоритмов прозрачными и доступными . Идея проста: система должна не просто выдавать результат, но и сопровождать его обоснованием, понятным любому, независимо от уровня подготовки. Это крайне важно, поскольку современные модели, особенно глубокое обучение и нейронные сети , настолько сложны, что выполняют триллионы вычислений для одного слова, что делает невозможным для человека воспроизвести этот процесс вручную.
Интерпретируемость и объяснимость: это не одно и то же.
Эти термины часто используются как синонимы, но между ними есть важное различие. Интерпретируемость — это пассивное качество; то есть некоторые модели по своей природе прозрачны, например, деревья решений или линейная регрессия, где путь принятия решения можно проследить практически с помощью карандаша и бумаги. Такие модели известны как «белые ящики» или «стеклянные ящики».
С другой стороны, объяснимость — это активный процесс. Она применяется в основном к непрозрачным моделям (черным ящикам), таким как нейронные сети, чтобы попытаться извлечь связное объяснение произошедшего. По сути, если интерпретируемость фокусируется на внутренних процессах, то объяснимость фокусируется на обосновании конечного результата с использованием внешних методов.
Важность адаптации сообщения к пользователю.
Вы не сможете объяснить модель машинного обучения специалисту по анализу данных так же, как клиенту банка. Адаптация языка — ключ к успеху ИИ. Для технического специалиста объяснение будет сосредоточено на метриках измерения и весе переменных; для бизнес-профессионала важно понимать, какие характеристики клиента привели модель к предложению того или иного продукта.
- Эксперты в области искусственного интеллекта: Они ищут подробные технические детали для оптимизации и усовершенствования модели.
- Пользователи данных: Специалистам (врачам, юристам), которым необходимо подтвердить достоверность информации для принятия клинических или юридических решений.
- Новичкам или широкой публике: Люди, которые просто хотят знать, что их данные используются правильно и что существует... человеческий надзор процесс.

Методы вскрытия черного ящика
Чтобы искусственный интеллект перестал быть загадкой, используются различные методы, которые в основном делятся на два подхода: глобальный и локальный.
Глобальный анализ: общая карта
Эти методы направлены на понимание общего поведения модели. Например, метод «важности перестановок» измеряет, насколько увеличивается ошибка при изменении значений переменной, выявляя, какие факторы оказывают наибольшее влияние на систему. Существуют также графики частичной зависимости , которые анализируют, как изменяется прогноз при изменении значения конкретной переменной, хотя оба метода обычно предполагают независимость переменных друг от друга.
Локальный анализ: частный случай
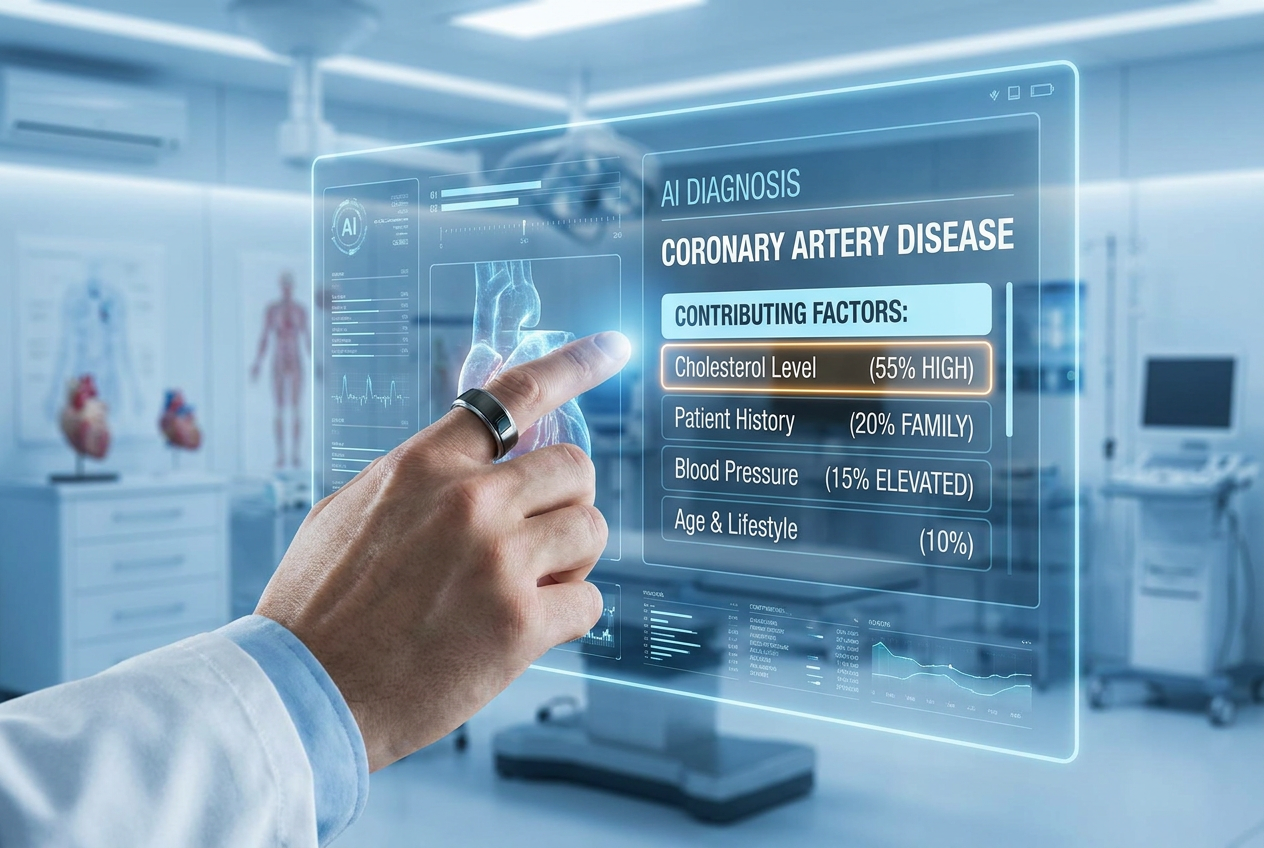
Здесь важно понять, почему именно этому пациенту было отправлено медицинское оповещение. Ключевое значение здесь имеют значения Шапли (основанные на теории игр), поскольку они определяют вклад каждой переменной в конечный результат. Это позволяет врачу увидеть, что оповещение было вызвано в первую очередь уровнем холестерина , а не возрастом пациента, что дает ему возможность действовать быстро и точно.

Риски непрозрачности и преимущества прозрачности
Слепое доверие к «чёрному ящику» опасно. Наиболее серьёзный риск — это предвзятость и дискриминация ; если ИИ обучается на исторических данных, где имели место случаи сексизма или расизма, алгоритм изучит эти закономерности и воспроизведёт их, наказывая резюме или отказывая в зачёте без логической причины. Кроме того, отсутствие прозрачности создаёт вакуум в отношении юридической ответственности : если беспилотный автомобиль попадёт в аварию, нам нужно знать причину, чтобы определить виновных.
Внедрение XAI не только предотвращает катастрофы, но и обеспечивает конкурентное преимущество . Оно позволяет быстро выявлять ошибки, обеспечивает соответствие строгим нормам, таким как Общий регламент защиты данных Европейского союза (GDPR) , и, прежде всего, укрепляет доверие. Когда пользователь понимает логику принятого решения, он с гораздо большей вероятностью примет технологию и интегрирует ее в свою повседневную жизнь.
Проблемы и дилемма точности
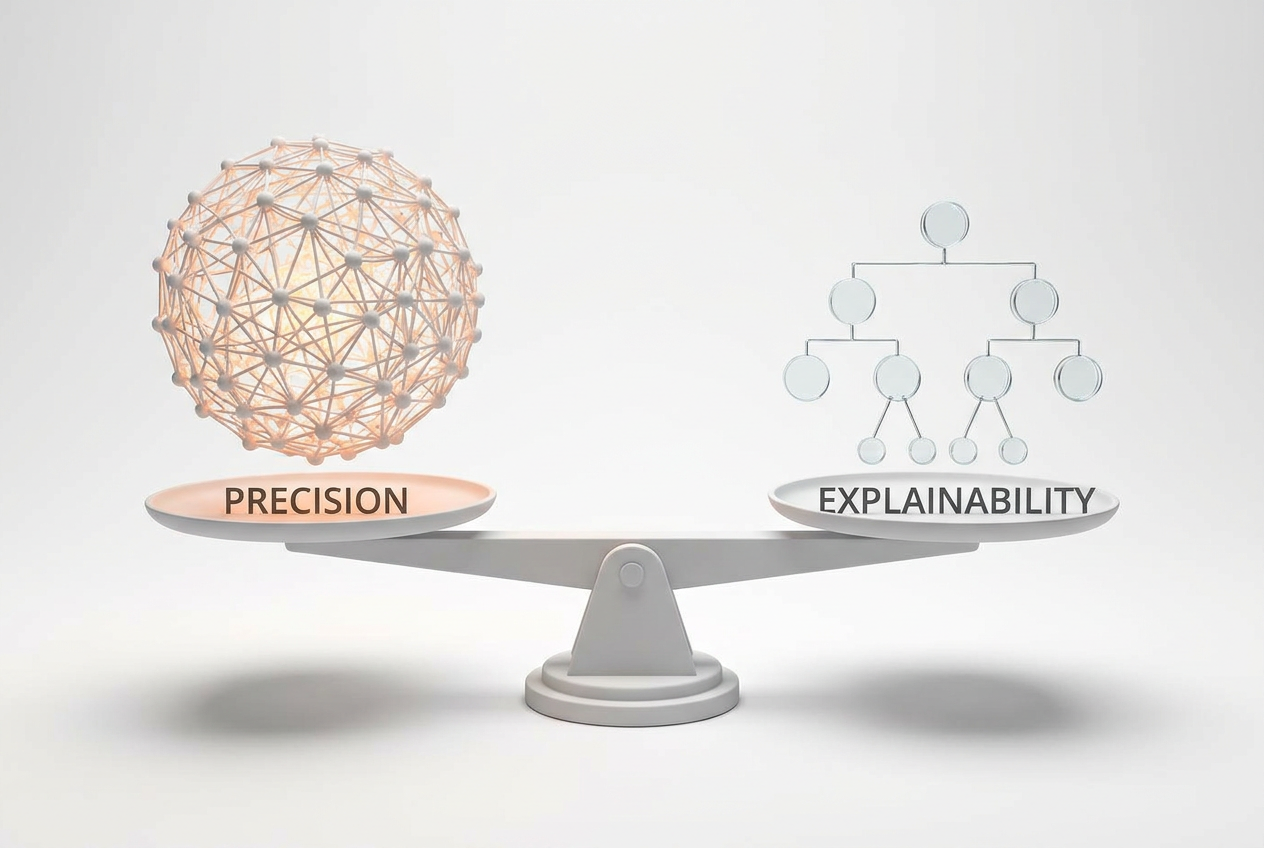
Не всё так гладко. Постоянно существует противоречие, известное как компромисс между точностью и объяснимостью . Как правило, наиболее точные модели (например, глубокое обучение) наименее понятны, в то время как наиболее простые для понимания, как правило, менее эффективны. Текущая задача состоит в поиске золотой середины, где система достаточно эффективна, чтобы быть полезной, и в то же время достаточно понятна для проверки и анализа.

Кроме того, существует вычислительная стоимость. Вычисление значений Шапли для миллионов прогнозов в секунду чрезвычайно затратно с точки зрения вычислительной мощности. Поэтому разрабатываются механистические (понимание внутренних механизмов) и апостериорные (объяснение после обучения) подходы к интерпретируемости, чтобы сделать этот процесс более эффективным.
Объяснимый ИИ в критически важных секторах
В здравоохранении искусственный интеллект может стать решающим фактором между жизнью и смертью, позволяя врачам проверять рекомендации ИИ перед операцией. В образовании крайне важно, чтобы преподаватели сохраняли свою автономию и не становились простыми исполнителями алгоритмических инструкций, развивая критическое мышление у учащихся. В логистике он помогает управлять запасами, объясняя, почему лучше перемещать паллету, исходя из частоты комплектации заказов и близости к погрузочным площадкам.
Полная прозрачность, от источника данных до логики вывода, превращает искусственный интеллект в инструмент для сотрудничества человека и машины . Благодаря интеграции человеческого контроля и понятности, технология гарантирует этичность и безопасность, исключая иллюзию понимания и обеспечивая справедливость, проверяемость и, прежде всего, полезность каждого решения для улучшения общества.
