- Microsoft Fabric centralizuje dáta, riadenie, umelú inteligenciu a analýzy v reálnom čase na platforme OneLake a v rámci zjednotených funkcií.
- Platforma posilňuje riadenie, bezpečnosť a náklady prostredníctvom Purview, zabezpečenia OneLake, DLP, DSPM a integrácie so službou Azure Cost Management.
- Nástroje Data Factory, Dataflow Gen2 a migrácie uľahčujú presun existujúcich pracovných záťaží a orchestráciu zložitých kanálov.
- Copilot, dátoví agenti, MCP a nové pracovné zaťaženia, ako napríklad Fabric IQ a Real-Time Intelligence, poháňajú pokročilé scenáre umelej inteligencie a automatizácie.
Ak už nejaký čas pracujete s dátami v ekosystéme spoločnosti Microsoft, určite ste si všimli, že platforma Microsoft Fabric sa stala ústredným centrom pre modernú analytiku a zjednotila všetko, čo bolo predtým rozptýlené v službách Power BI, Azure Synapse, Data Factory a ďalších, do jednej platformy. V tomto článku sa dôkladne a podrobne pozrieme na najnovšie funkcie, plán a praktické dôsledky platformy Fabric pre analytiku, riadenie, umelú inteligenciu a analýzu v reálnom čase.
Myšlienka je taká, že po dočítaní budete mať jasnú predstavu o tom, čo Microsoft Fabric dnes ponúka, kam smeruje a ako ovplyvňuje dátovú architektúru vašej organizácie: možnosti riadenia s Purview, automatizácia s API a Gitom, nové funkcie umelej inteligencie, inteligencia v reálnom čase, zabezpečenie v OneLake, migrácie, výkon a oveľa viac.
Microsoft Fabric a rámec pre prijatie cloudu: riadenie, náklady a automatizácia
V rámci rámca pre prijatie cloudu (CAF) spoločnosť Microsoft publikuje sériu sprievodcov na zosúladenie dizajnu platformy Microsoft Fabric s piliermi dizajnu vstupných zón . Najnovšia časť tejto série sa zaoberá tromi kľúčovými oblasťami: riadenie, optimalizácia kapacity a automatizácia/DevOps.
Na strane riadenia sú náklady na kapacitu Fabric zverejňované prostredníctvom služby Azure Cost Management . To umožňuje natívnu integráciu spotreby kapacity F (a ďalších skladových jednotiek SKU) do dashboardov nákladov, upozornení a analýz výdavkov v službe Azure. Nejde len o zobrazenie faktúry: tieto informácie môžete porovnať so značkami, predplatnými alebo skupinami zdrojov, aby ste pochopili, kto koľko míňa a prečo.
Technická architektúra a obchodný model spoločnosti Fabric umožňujú zákazníkom presne kontrolovať spotrebu kapacity s cieľom optimalizovať prevádzkové náklady . V praxi sa to prejavuje niekoľkými pákovými efektmi:
- Škálovanie schopností F: zvýšiť alebo znížiť kapacitu na základe predvídateľných špičiek, ako sú predajné kampane, účtovné termíny alebo veľké zaťaženie dát.
- Možnosti pozastavenia a obnoveniaSprávcovia infraštruktúry môžu pozastaviť kapacitu F, keď nie je potrebná (napríklad cez noc alebo cez víkendy v nekritických prostrediach), aby znížili výpočtové náklady.
- Ochrana pred prepätímDva parametre na úrovni kapacity riadia spôsob riadenia úloh na pozadí, aby sa zabránilo ich zahlteniu prostredia: Prahová hodnota odmietnutia na pozadí a Prahová hodnota obnovy na pozadí.
- Rezervácie kapacityJe možné rezervovať kapacitu na definované obdobia a získať zľavy za predpokladu, že očakávaná spotreba je prísne naplánovaná.
V oblasti správy údajov sa Fabric spolieha na Microsoft Purview ako na svoj centrálny komponent pre katalogizáciu, pôvod a klasifikáciu . Purview umožňuje používateľom aplikovať označenia citlivosti, zobraziť pôvod naprieč zdrojmi, transformáciami a spotrebou, certifikovať dátové aktíva a riadiť kampane zamerané na kvalitu údajov, a to všetko pri integrácii prvkov Fabric (Lakehouse, Warehouse, KQL, Power BI atď.).
Komponenta „Automatizácia platformy a DevOps“ sa zameriava predovšetkým na integráciu Gitu, procesy nasadenia a rozhrania REST API . Pracovné priestory Fabric je možné prepojiť s repozitármi Git, čo umožňuje viacerým vývojárom spolupracovať na tom istom projekte dátového inžinierstva, dátovej vedy alebo analýzy v reálnom čase bez prekrývania práce.
Git a Deployment Pipelines umožňujú kontrolované riadenie vývojových, testovacích a produkčných cyklov : propagáciu obsahu, sledovanie zmien, synchronizáciu artefaktov a správu verzií. Od marca 2025 tieto pipeliny podporujú (vo všeobecnom alebo ukážkovom stave) širokú škálu typov prvkov vrátane spúšťačov, dashboardov, tokov údajov, dátových pipelinov, dátových mól, jazerných úložísk, dátových skladov, KQL, poznámkových blokov, stránkovaných zostáv, organizačných aplikácií a ďalších.
Súbežne Fabric poskytuje veľmi širokú sadu REST API, pomocou ktorých je možné automatizovať takmer akúkoľvek administratívnu úlohu alebo úlohu nasadenia: vytváranie pracovných priestorov a priečinkov, hromadnú migráciu položiek, správu pripojení a brán, extrakciu definícií, aktiváciu kanálov alebo poznámkových blokov a ďalšie.
Kľúčové aktualizácie v oblasti analytiky, umelej inteligencie a riadenia pre Microsoft Fabric
Vývoj platformy Fabric sa vyznačuje obrovským množstvom ukážkových funkcií a nových možností, ktoré sa dotýkajú prakticky každej oblasti platformy . Tieto funkcie sú zoskupené a diskutované nižšie štruktúrovaným spôsobom, aby sa ukázal ich plný rozsah.
Funkcie umelej inteligencie v dátovom sklade a multimodálne funkcie
V oblasti relačných dát integruje Fabric Data Warehouse funkcie umelej inteligencie priamo do T-SQL (preview). To umožňuje:
- Klasifikovať alebo kategorizovať text.
- Analyzujte sentiment.
- Extrahujte štruktúrované informácie z voľného textu.
- Prekladať text medzi jazykmi.
- Správna gramatika.
Cieľom je eliminovať potrebu opustiť kontext SQL na obohatenie dát pomocou umelej inteligencie . Tieto funkcie sú kombinované so širšou multimodálnou podporou vo funkciách umelej inteligencie v rozhraní Fabric, ktoré teraz dokážu spracovať obrázky (JPG/JPEG, PNG, GIF, WebP), PDF a bežné textové formáty, ako aj vstupy ciest k súborom.
Súčasťou sú aj nástroje ako aifunc.load na prijímanie priečinkov do tabuliek s možnosťami výzvy a schémy, aifunc.list_file_paths na prechádzanie cestami k súborom a ai.infer_schema na odvodzovanie schém kompatibilných s ai.extract . To všetko vám umožňuje transformovať a obohacovať dáta bez budovania zložitých dátových kanálov od začiatku.
OneLake, Delta, Apache Iceberg a multiplatformový prístup
Na úrovni úložiska zostáva OneLake jednotným jazerom, kde sa nachádza celý Fabric. Jedným z hlavných vylepšení je možnosť sprístupniť tabuľky Delta Lake ako tabuľky Apache Iceberg bez presúvania alebo duplikovania údajov, takže enginy kompatibilné s Iceberg môžu priamo čítať, čo sa nachádza v OneLake.
Okrem toho OneLake teraz podporuje dáta Apache Iceberg, ktoré sú priamo zapísané aplikáciou Snowflake a spracovávané v prostredí Fabric bez nutnosti kopírovania . Táto stratégia posilňuje interoperabilitu: Fabric nie je určený ako izolované úložisko, ale skôr ako dátové centrum, ktoré môžu iné enginy využívať bez duplikovania úložiska.
Podobne OneLake podporuje skratky k úložisku Azure Blob Storage , OneDrive a SharePoint a rozširuje zabezpečenie o prístupové role, zabezpečenie na úrovni priečinkov, riadkov a stĺpcov a model zabezpečenia, ktorý môžu tretie strany rešpektovať vďaka rozšíreniu modelu autorizovaného enginu.
Obzvlášť dôležitou funkciou je federácia katalógu OneLake s Azure Databricks, ktorá umožňuje prístup bez kópie z katalógu Unity k tabuľkám OneLake . Týmto spôsobom OneLake zostáva zdrojom pravdy, ale Databricks môže dotazovať údaje priamo a synchronizovať iba metadáta.
Databáza SQL na Fabric: výkon, bezpečnosť a virtualizácia
Databáza SQL vo Fabric získava vlastné možnosti: možnosti ALTER DATABASE SET , podporu zoradenia a fulltextové indexovanie v ukážkovej verzii. Z hľadiska výkonu a nákladov databázy existuje niekoľko vylepšení:
- Automatické zhutňovanie indexov na zníženie úložiska, I/O operácií a zlepšenie časov dotazov bez nutnosti plánovania úloh údržby.
- Maximálny limit virtuálnych jadier na riadenie využívania výpočtových zdrojov (4 alebo 32 vCore), ktoré sú navrhnuté tak, aby zabránili nadmernej spotrebe zdieľanej kapacity pracovnou záťažou.
- Vlastné SQL fondy ktoré poskytujú správcom pracovného priestoru podrobnú kontrolu nad alokáciou zdrojov a smerovaním dotazov podľa názvu aplikácie.
Virtualizácia dát je povolená aj v databáze SQL , ktorá umožňuje dotazovanie externých dát uložených v OneLake pomocou T-SQL, spájanie súborov v bežných formátoch s lokálnymi relačnými tabuľkami pomocou spojení bez nutnosti fyzického importu dát.
Z hľadiska zabezpečenia databáza SQL podporuje Private Link na úrovni nájomníka (preview) , čo uľahčuje súkromné a kontrolované smerovanie dátovej prevádzky a integráciu s celkovou konfiguráciou zabezpečenej siete Fabric.
Real-time Intelligence, Eventhouse, Eventstream a Activator
Modul Real-Time Intelligence (RTI) sa stal jedným z kľúčových rozlišovacích znakov platformy Fabric. Eventhouse a Eventstream spolupracujú na prijímaní, spracovaní a spúšťaní udalostí v reálnom čase zo všetkých typov zdrojov a Activator riadi akcie, ktoré sa spúšťajú za určitých podmienok.
Medzi najvýkonnejšie nové funkcie patria:
- Detekcia anomálií bez kódu s automatickým výberom modelu, jednoduchým rozhraním a flexibilnými upozorneniami.
- Obchodné udalosti, ktoré zachytávajú kľúčové obchodné momenty generované z funkcií používateľských údajov a poznámkových blokov a umožňujú vám aktivovať upozornenia, vlastnú logiku, postupy, modely umelej inteligencie alebo úlohy Spark.
- Integrácia funkcií aktivátora a používateľských dátaby funkcie vytvorené vo Fabric mohli spracovávať udalosti z akéhokoľvek zdroja vrátane interných udalostí zo samotnej platformy a z OneLake.
- Schopnosť spracovať udalosti pomocou SQL (operátor SQL v Eventstream), čo umožňuje transformáciu tokov v reálnom čase so známou syntaxou SQL.
Pridali sa relevantné konektory, ako napríklad Cribl (na príjem protokolov a telemetrie z viacerých zdrojov), konektor so Solace PubSub+ a podpora streamovania cez súkromné siete prostredníctvom Azure Virtual Network, VPN, ExpressRoute alebo súkromných koncových bodov.
Pre dátové schémy a zmluvy zavádza Eventstream register schém , ktorý definuje a overuje schémy udalostí pre robustnejšie kanály, a podporu pre Confluent Schema Registry na prepojenie s Kafkou v Confluent Cloude pri rešpektovaní existujúcich zmlúv.
Funkcie Copilota a umelej inteligencie naprieč celou platformou
Copilot v aplikácii Fabric je teraz dostupný globálne s podporou pre Power BI, Data Factory, Data Science & Data Engineering a písanie dotazov KQL . Okrem toho boli pridané špecifické funkcie:
- Copilot pre Dataflow Gen2 (moderné získavanie údajov), ktorý pomáha prijímať a transformovať dáta pomocou inštrukcií v prirodzenom jazyku.
- Copilot pre dátový sklad (chat), prístupné pomocou tlačidla na páse s nástrojmi na urýchlenie skladovacích úloh prostredníctvom dialógového okna.
- Copilot pre koncový bod analytiky SQL, ktorý generuje a optimalizuje SQL dotazy z popisov firiem.
- Copilot na notebookoch so znalosťou kontextu pracovného priestoru, Lakehouse, štruktúry notebookov a prostredia vykonávania, schopný generovať viackrokový kód, refaktorovať, sumarizovať zložité notebooky a diagnostikovať chyby pomocou možnosti „Opraviť pomocou Copilota“.
- Automatické dopĺňanie v kóde (dopĺňanie kódu v kóde) a dopĺňanie kódu v kóde Notebook Copilot (ukážka), písať Python rýchlejšie a s menším počtom chýb.
Okrem toho sa technologická základňa umelej inteligencie rozširuje o integrované predpripravené nástroje Foundry Tools (Azure OpenAI, Azure Language, Azure Translator), pluginy OpenAI pre Eventhouse (ai_embed_text a ai_chat_completion) a sériu agentov a dátových agentov, ktoré umožňujú iným aplikáciám vrátane Copilot Studio pracovať s dátami Fabric orchestrovaným spôsobom.
Dátoví agenti Fabric, MCP a nástroje pre vývojárov
Fabric predstavuje dátových agentov schopných riadiť prístup k údajom a nástroje pre agentov s umelou inteligenciou, s Python SDK a priamou integráciou s Microsoft Copilot Studio. To uľahčuje vytváranie konverzačných asistentov, ktorí pracujú s podnikovými údajmi riadenými v prostredí Fabric.
Súbežne sa protokol Model Context Protocol (MCP) stáva kľúčovou súčasťou integrácie medzi agentmi umelej inteligencie a službami Fabric. Existujú dedikované servery MCP pre Activator a Eventhouse a vývojovo orientovaný Fabric MCP, ktorý:
- Umožňuje asistentom s umelou inteligenciou generovať kód a obsah pre položky Fabric.
- Integruje sa s vývojovými nástrojmi ako VS Code a GitHub Codespaces.
- Predstavuje nástroje na konzultácie a prácu s údajmi v reálnom čase v Eventhouse.
Pre každodennú prácu vývojárov je potrebné zdôrazniť niekoľko aspektov, vrátane vývojového prostredia : rozšírenie MSSQL pre VS Code s podporou databázy SQL v prostredí Fabric , ovládač Microsoft ADO.NET a ovládač ODBC pre Fabric Data Engineering (pripojenie k Spark SQL cez Livy) a konektor Spark pre databázy SQL, ktorý zjednodušuje overený prístup zo Sparku k databázam SQL v službách Azure a Fabric.
Súčasťou je aj rozhranie Fabric CLI , ktoré je k dispozícii ako integrovaná úloha v Azure DevOps a umožňuje automatizovať správu pracovných priestorov, položiek a nasadení bez manuálnej inštalácie externých nástrojov.
Dátová továreň, migrácie dát a orchestrácia vo Fabric
Vrstva integrácie dát v platforme Fabric sa spolieha na služby Data Factory a Dataflow Gen2, ktoré dostávajú funkcie, vďaka ktorým bude orchestrácia inteligentnejšia, automatizovanejšia a s jednoduchšími migráciami z existujúcich platforiem.
Dataflow Gen2: výkon, verejné API a diagnostika
V Dataflow Gen2 nájdeme v ukážkovej verzii niekoľko funkcií:
- Pokročilá úprava cieľových dopytov upraviť logiku v cieli priamo zo samotného prostredia pre tvorbu.
- Rozdelené výpočtyčo umožňuje, aby časti toku údajov bežali paralelne, čím sa skracuje celkový čas vyhodnocovania.
- Stiahnutie diagnostických údajov na úrovni vykonávania so štruktúrovanými protokolovými balíkmi pre analýzu výkonu a riešenie incidentov.
- Verejné API na programovo vytváranie, aktualizáciu, odstraňovanie, plánovanie a monitorovanie tokov údajov.
- Verejné parametre s podporou CI/CDktoré umožňujú obnovovanie tokov údajov odovzdávaním hodnôt z kanálov alebo iných zdrojov.
- Nedávne údaje pre rýchly prístup k naposledy použitým položkám na páse s nástrojmi Power Query a v modernej funkcii Získať údaje.
Toto všetko je doplnené možnosťou programovo vyhodnocovať Power Query prostredníctvom REST , čo otvára dvere k spúšťaniu M skriptov ako súčasti automatizovaných procesov, ich integrácii so Sparkom, kanálmi alebo externými nástrojmi s využitím konektorov Power Query.
Dátová továreň: adaptívny výkon, konektivita a DBT
V „klasickejšej“ časti integrácie predstavuje Data Factory v rámci Fabricu:
- Adaptívne ladenie výkonu pre aktivitu kopírovania, ktorá inteligentne upravuje výkonnostné parametre podľa konfigurácie a kontextu vykonávania.
- Podpora zachytávania zmien údajov (CDC) v úlohe kopírovania, aby sa priebežne replikovali iba zmeny (vkladanie, aktualizácie, vymazanie).
- Lokálne brány s možnosťou manuálnej aktualizácie spravované z portálu Fabric, rozhrania API alebo skriptov.
- nedávne pripojenie, ktorý pridáva k pripojeniam vlastnosti posledného použitia na uľahčenie auditu a správy životného cyklu.
- natívna úloha DBT, čo umožňuje spúšťanie DBT projektov v rámci Fabricu s integrovanou orchestráciou, testovaním, dokumentáciou a riadením.
- Vyvolať aktivitu balíka SSIS v kanáloch na spúšťanie balíkov SSIS zo samotnej orchestrácie v prostredí Fabric.
Používateľskú skúsenosť vylepšuje aj nástroj na výber lokality SharePoint , ktorý eliminuje potrebu manuálneho zadávania adries URL, a podpora MCP pre Data Factory umožňuje asistentom s umelou inteligenciou vytvárať a nasadzovať Dataflow Gen2 jednoducho z pokynov v prirodzenom jazyku.
Nástroje na migráciu a replikáciu údajov
Spoločnosť Microsoft dôrazne podporuje migráciu na platformu Fabric prostredníctvom niekoľkých špecifických nástrojov:
- Posúdenie migrácie Fabric pre Data Factory, ktorá analyzuje prípravu ADF kanálov a migruje tie podporované do pracovného priestoru Fabric s mapovaním pripojení.
- Asistent migrácie pre dátový skladktorý sa teraz môže priamo pripojiť k zdrojovému skladu a presunúť ho do dátového skladu Fabric.
- Asistent migrácie pre databázu SQL, zameraný na migráciu lokálnych pracovných záťaží SQL Servera s importom schémy prostredníctvom DACPAC, detekciou nekompatibility a odporúčaniami.
Pokiaľ ide o replikáciu, je podporované zrkadlenie z rôznych operačných zdrojov (Azure Database for MySQL, Google BigQuery, SQL Server atď.) do Fabric s možnosťou kontroly, ktoré tabuľky sa replikujú, reštartovania procesov zrkadlenia prostredníctvom REST a v prípade Databricks mapovania politík Unity Catalog na zabezpečenie OneLake.
Súčasťou je aj replikačný konektor od Lakehouse pomocou Delta Change Data Feed , ktorý sprístupňuje zmeny z tabuliek Lakehouse Delta kompatibilným destináciám bez nutnosti znovu vynájsť koleso s domácimi riešeniami CDC.
Bezpečnosť, pokročilá správa a monitorovanie v prostredí Fabric
Jednou z najväčších obáv každej analytickej platformy je zabezpečenie údajov, riadenie ich používania a monitorovanie spotreby zdrojov . Fabric v týchto oblastiach rýchlo dozrieva.
Bezpečnosť a ochrana údajov v OneLake
OneLake pridáva kompletný model zabezpečenia prístupu k údajom s:
- Roly prístupu k údajom pre Lakehouse s konfigurovateľnými povoleniami z bezpečnostného rozhrania založeného na priečinkoch.
- Podpora zabezpečenia pre skratky, aby tretie strany mohli rešpektovať definované pravidlá.
- API pre zabezpečenie prístupu k údajom OneLake, ktoré umožňuje automatizovanú správu povolení.
- Rozšírenie modelu na externé enginy (bezpečnostná autorizácia OneLake pre tretie strany).
Súbežne s tým je ochrana rozšírená o obmedzenie prístupu DLP ku všetkým štruktúrovaným dátam v OneLake (SQL, KQL, dátové sklady) a pre Fabric Copilots a dátových agentov je zavedený DSPM pre AI , ktorý monitoruje interakcie AI s cieľom nájsť citlivé informácie a rizikové správanie s integráciou s Purview Audit a eDiscovery.
V rovine identít sa objavujú funkcie, ako sú identity spojené s položkami (napr. Lakehouse a Eventstream) prostredníctvom rozhraní REST API, ktoré eliminujú závislosť od vlastníka pre určité operácie, a overovanie skratiek OneDrive a SharePoint prostredníctvom identít pracovného priestoru alebo principálu služby.
Centralizované riadenie a katalóg OneLake
Správa údajov je vylepšená o nový centralizovaný dashboard v katalógu OneLake , kde si vlastníci údajov môžu pozrieť súhrnný prehľad položiek, ktoré vytvorili, dostávať odporúčania týkajúce sa opatrení v oblasti správy a mať prístup ku všetkým dostupným nástrojom na zlepšenie zabezpečenia a dodržiavania predpisov.
Okrem toho je povolené rozhranie API pre vyhľadávanie v katalógu OneLake spolu s nástrojom MCP, ktorý umožňuje objavovať položky v celom prostredí Fabric z kódu alebo agentov AI v rámci jediného volania, pričom sa rešpektujú povolenia a metadáta katalógu.
Monitorovanie kapacít, spotreby a práce
Látka poskytuje niekoľko vrstiev pozorovateľnosti:
- Monitorovanie pracovného priestoru, ktorá vytvára databázu v prostredí Fabric, kde sú konsolidované protokoly a metriky z viacerých položiek (vrátane úloh kopírovania s podrobným monitorovaním).
- Monitorovanie pracovného priestoru pre úlohu kopírovanias metrikami ako priepustnosť, objem dát, chybové kódy a časy, všetky zamerané na centralizovanú analýzu.
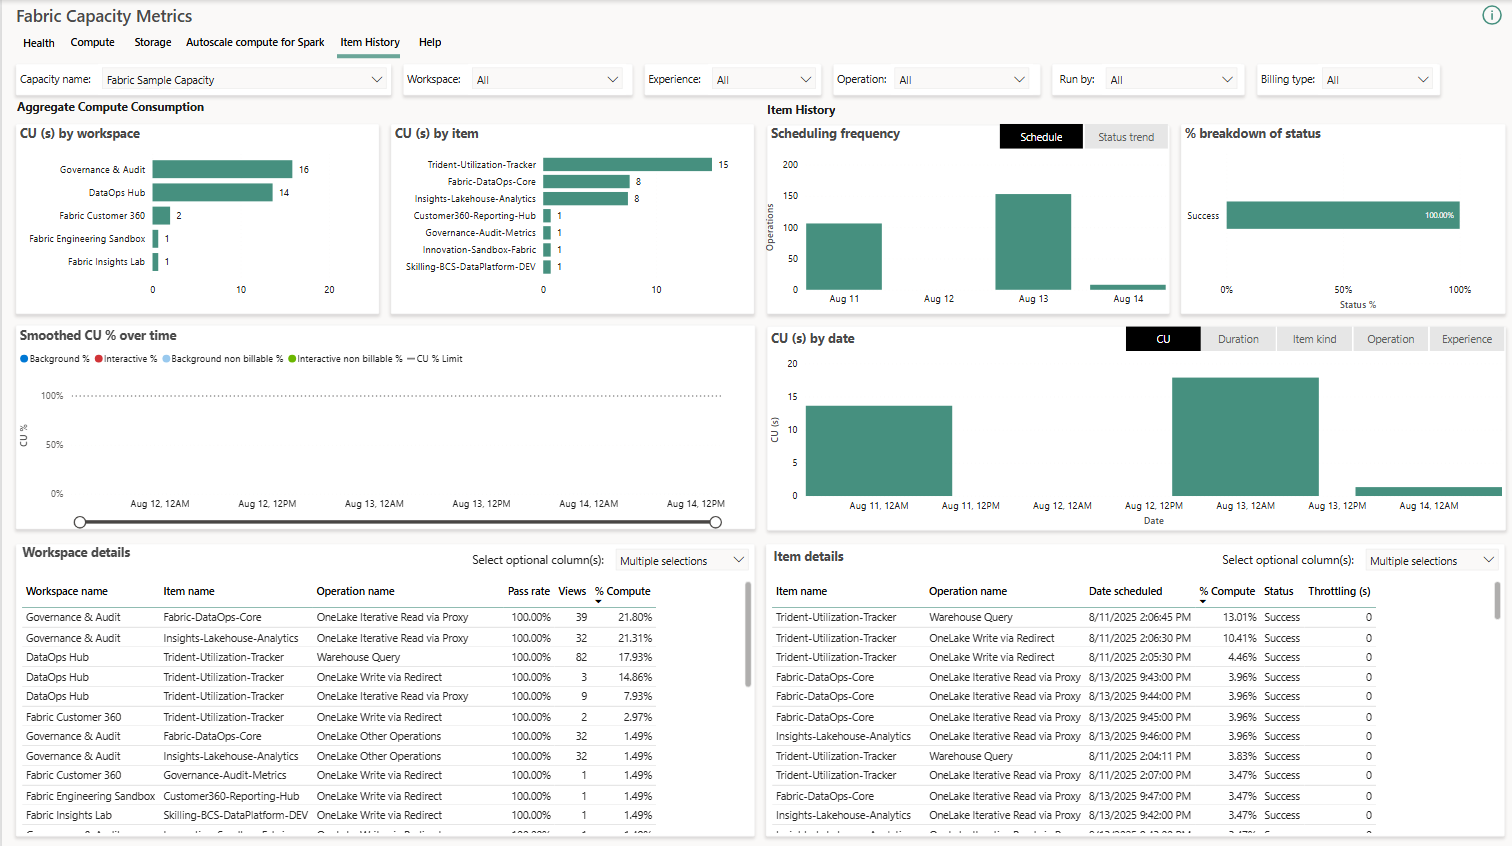
- História položiek pri aplikácii metrík kapacity, s 30-dňovými zobrazeniami spotreby CU pre každú položku, filtrovateľnými podľa pracovného priestoru a typu.
- Prepäťová ochrana na úrovni pracovného priestoručo umožňuje nastaviť prahové hodnoty spotreby pre každý pracovný priestor v 24-hodinovom posuvnom okne, automaticky blokovať tie, ktoré ich prekročia, a označiť pracovné priestory ako „kriticky dôležité“, aby sa vylúčili z obmedzení.
Ako doplnok k tomu sa vydáva úvodná sada rozhraní API pre správu Fabric , ktorá sa zameriava na vyhľadávanie pracovných priestorov, položiek a podrobností o prístupe používateľov, uľahčuje dynamické inventarizácie a pravidelné kontroly prístupu.
Obchodné modelovanie, plánovanie a nové pracovné zaťaženia
Okrem technickej vrstvy spoločnosť Microsoft zavádza nové obchodne orientované pracovné zaťaženia nad rámec platformy Fabric. Jednou z najvýznamnejších je Fabric IQ, ktorej cieľom je zjednotiť obchodnú sémantiku, dáta a modely pre inteligentných agentov, ktorí sa rozhodujú na základe holistického pohľadu na organizáciu.
V rámci Fabric IQ sa zobrazujú nasledujúce prvky:
- Ontológia (ukážka), typ položky, kde sú entity, vzťahy, vlastnosti a obmedzenia definované podľa obchodného jazyka spoločnosti.
- Plán (ukážka), platforma bez kódovania pre plánovanie, reporting, analytiku, integráciu a kolaboratívnu správu.
V Real-Time Intelligence sa objavuje aj nástroj na tvorbu digitálnych dvojčiat , ktorý sa špecializuje na modelovanie digitálnych dvojčiat na základe údajov v reálnom čase s cieľom optimalizovať fyzické operácie, monitorovať stavy a simulovať scenáre.
Na druhej strane, pracovná záťaž Fabric IQ je predstavená ako samostatná pracovná záťaž a podporné nástroje pre riadenie a sémantické zarovnanie sa naďalej rozširujú, čím sa uzatvára kruh medzi dátovými modelmi, obchodnou logikou a aplikáciami umelej inteligencie/analytiky.
Vylepšenia výkonu, používateľskej skúsenosti a produktivity
Na záver prehľadu stojí za to zdôrazniť sériu prierezových vylepšení, ktoré sa síce ne vždy dostanú na titulné stránky novín, ale výrazne ovplyvňujú každodenné fungovanie tímov.
V sekcii Spark a distribuované výpočty Fabric predstavuje:
- Fabric Runtime 2.0 (ukážka) s Apache Spark 4.0, Delta Lake 4.0, Java 21, Scala 2.13 a Python 3.12 na Azure Linux 3.0.
- Nástroj na porovnávanie aplikácií Sparkčo vám umožňuje vybrať a porovnať až štyri spustenia Spark paralelne.
- Diagnostický emitor iskier, ktorý zhromažďuje protokoly, metriky a udalosti z aplikácií Spark a odosiela ich do cieľových umiestnení, ako sú centrá udalostí, úložiská alebo Log Analytics.
- Diagnostická knižnica JobInsight, knižnica na analýzu dokončených spustení Spark prostredníctvom API (dotazy, úlohy, fázy, úlohy, vykonávače, protokoly udalostí).
Vo vrstve skladu sa pridáva klastrovanie údajov na zlepšenie výkonu a zníženie nákladov na prístup, stĺpce IDENTITY pre náhradné kľúče a podpora riadenia verzií a CI/CD prostredníctvom projektov databázy SQL vo VS Code (riadenie zdrojového kódu skladu).
Používateľské rozhranie portálu Fabric sa tiež vyvíja s prehliadaním v kartách a prieskumníkom objektov , čo používateľom umožňuje otvárať viacero položiek súčasne a rýchlo medzi nimi prepínať. Toto spolu s vylepšeniami, ako je automatické viazanie Lakehouse v Gite a sada nástrojov na údržbu Lakehouse (činnosti údržby a aktualizácia koncových bodov SQL), prispieva k užívateľsky prívetivejšej a agilnejšej platforme.
Funkcie ako hromadný import/export definícií položiek (pre migrácie, šablóny a zálohy metadát), REST pre priečinky, podpora parametrov pri aktiváciách položiek z Activatoru a načítanie údajov OneLake do Excelu s integrovaným katalógom dopĺňajú ekosystém, ktorý začína pokrývať prakticky všetky bežné potreby moderného dátového tímu.
Vďaka celej tejto sade funkcií – od centralizovaného riadenia, granulárneho zabezpečenia a inteligentnej orchestrácie až po umelú inteligenciu zabudovanú v SQL, analýzu v reálnom čase, digitálne dvojčatá a agentov MCP – sa Microsoft Fabric etabluje ako kompletná dátová platforma, kde kľúčom už nie je len ukladanie a vizualizácia údajov, ale riadenie, automatizácia a využívanie umelej inteligencie na napájanie každej časti životného cyklu údajov . To umožňuje organizáciám postupne vyvíjať svoje architektúry, migrovať existujúce systémy a umožňovať nové riešenia oveľa rýchlejšie ako pri tradičných prístupoch.