- Kritická zraniteľnosť v NLTK (CVE-2026-0848) umožňuje vzdialené spustenie kódu a ovplyvňuje systémy umelej inteligencie a spracovania prirodzeného jazyka.
- Bežné chyby pri inštalácii a konfigurácii Pythonu (cesta, verzie, prostredia) spôsobujú zlyhania importu a problémy s knižnicami.
- Ekosystém PyPI utrpel vydanie tisícok škodlivých balíkov, čo zdôrazňuje riziká v dodávateľskom reťazci softvéru.
- Kombinácia osvedčených bezpečnostných postupov, aktualizácií knižníc a prísnej správy závislostí je nevyhnutná na zníženie týchto rizík.
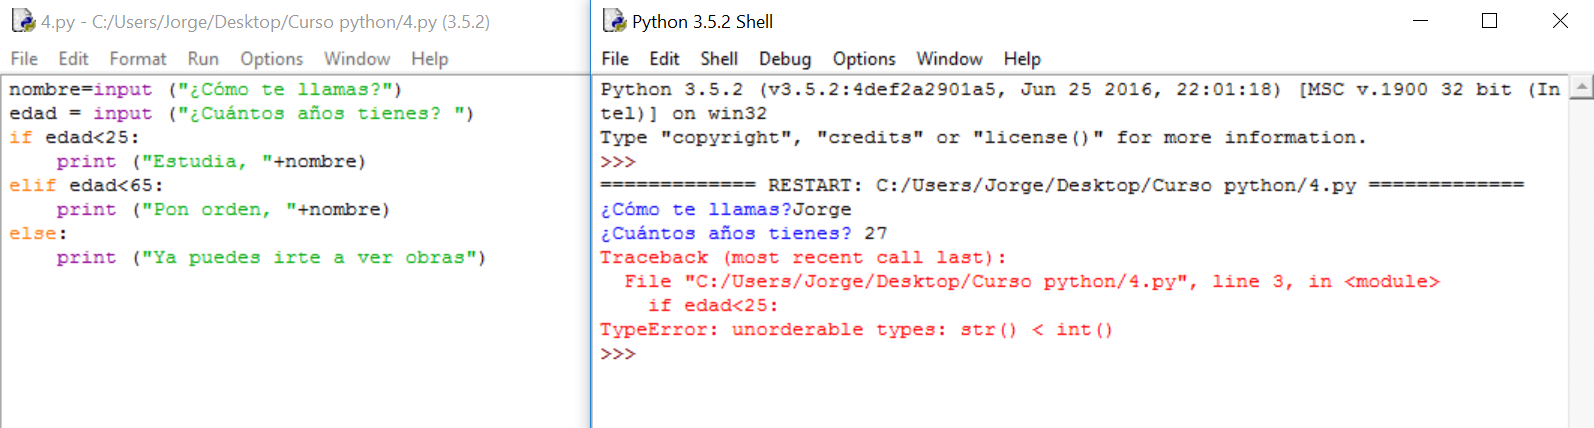
Keď hovoríme o chybe v knižnici Pythonu , nehovoríme len o jednej chybe, ktorá naruší fungovanie skriptu: v mnohých prípadoch sa môže stať priamym vstupným bodom pre útoky, frustrujúce problémy s inštaláciou alebo dokonca veľkú bolesť hlavy kvôli jednoduchej, zle napísanej závislosti. Python je praktický a všadeprítomný, čo znamená, že akýkoľvek problém, nech sa zdá akokoľvek malý, môže mať obrovský vplyv na umelú inteligenciu, spracovanie prirodzeného jazyka a webové vývojové projekty.
Nedávno sa objavili prípady od kritických zraniteľností zahŕňajúcich vzdialené spustenie kódu až po škodlivé balíky skryté v oficiálnom indexe Pythonu a zdanlivo absurdné chyby v knižniciach tak neškodných, ako je ovládač jasu obrazovky. To všetko vykresľuje obraz, kde nestačí len nainštalovať závislosť a zabudnúť na ňu: musíme pochopiť, čo sa deje „pod kapotou“, ako sú knižnice distribuované a aké osvedčené postupy nás môžu zachrániť pred vážnymi problémami.
Kritická chyba v NLTK: zraniteľnosť CVE-2026-0848
Jedným z najvýraznejších prípadov je kritická chyba v knižnici NLTK , ktorá je v ekosystéme Pythonu známa pre svoje použitie v úlohách spracovania prirodzeného jazyka . Pod identifikátorom CVE-2026-0848 bola opísaná zraniteľnosť, ktorá priamo ovplyvňuje prostredia, v ktorých sa používajú systémy na analýzu textu, a vo všeobecnosti aplikácie založené na umelej inteligencii a NLP.
Táto zraniteľnosť umožňuje vzdialené spustenie kódu (RCE) , čo znamená, že útočník môže vynútiť ľubovoľné spustenie vlastného kódu na počítači s NLTK. Z hľadiska kybernetickej bezpečnosti ide o jeden z najzávažnejších scenárov, ktoré sa môžu vyskytnúť v bežne používanom softvéri, pretože nielenže uniká dáta, ale môže poskytnúť efektívnu kontrolu nad napadnutým systémom.
Znepokojujúce je, že NLTK zostáva štandardnou závislosťou v nespočetných projektoch, najmä v kontexte, kde bola umelá inteligencia integrovaná do všetkých druhov služieb. To znamená, že mnohé produkčné prostredia, notebooky, API a kanály strojového učenia môžu byť odhalené bez toho, aby si ich vývojári boli plne vedomí skutočného rizika, ktoré táto zraniteľnosť predstavuje.
Vzostup spracovania prirodzeného jazyka viedol k tomu, že sme obklopení aplikáciami, ktoré neustále spotrebúvajú text: virtuálni asistenti, klasifikačné systémy, analýza názorov a mnoho ďalších. Vo všetkých týchto prípadoch sa zraniteľnosť v široko používanej knižnici Pythonu môže stať kľúčovým prvkom útoku na dodávateľský reťazec alebo širšieho narušenia infraštruktúry.
V konečnom dôsledku, explozívna kombinácia RCE s populárnou knižnicou ako NLTK nie je len technický problém; je to tiež pripomienka, že slepá dôvera v závislosti môže mať veľmi vysokú cenu, ak sa s ňou nezaobchádza opatrne.
Kde je chyba a ako sa zneužíva?
Problém v CVE-2026-0848 pramení zo spôsobu, akým knižnica NLTK spracováva určité externé zdroje . Za určitých podmienok môže knižnica načítať súbory bez riadneho overenia ich pôvodu alebo obsahu, čím vytvára nebezpečnú zraniteľnosť v toku údajov aplikácie.
V praxi to znamená, že súbor manipulovaný útočníkom môže byť nástrojom NLTK považovaný za legitímny zdroj. Ak aplikácia dôveruje týmto externým zdrojom bez dodatočných filtrov, škodlivý kód vložený do tohto súboru by sa mohol spustiť priamo v systéme a spotrebovať tieto dáta.
Tento scenár si nevyžaduje žiadne dramatické nastavenie: v mnohých súčasných prostrediach – ako sú API, interaktívne notebooky, automatizované analytické služby alebo kanály strojového učenia – sa dáta prijímajú a spracovávajú automaticky. Ak je jeden zo zdrojov týchto dát ohrozený, útočník môže túto zraniteľnosť v knižnici Python využiť na vloženie svojho užitočného zaťaženia bez toho, aby ktokoľvek musel stlačiť tlačidlo alebo čokoľvek manuálne spustiť.
Okrem toho sú mnohé z týchto systémov nasadené na serveroch so širokými oprávneniami a prístupom k citlivým zdrojom . To znamená, že zneužitie zraniteľnosti RCE (Real-Time Enterprise) prostredníctvom NLTK (Network Linked Key) je viac než len postrach: môže viesť ku krádeži údajov, úprave modelu, sabotáži interných procesov alebo implementácii zadných vrátok pre následné útoky.
Jadro problému spočíva v tom, že pri práci s knižnicami, ktoré „robia všetko za nás“, sa často prehliada validácia externých zdrojov . Ak predpokladáme, že závislosť je bezpečná bez auditu toho, ako nakladá so zdrojmi, ktoré jej poskytujeme, riskujeme, že sa z užitočnej funkcie stane ideálny vektor útoku.
Prečo je táto zraniteľnosť dnes taká relevantná
Kontext, v ktorom sa objavuje chyba CVE-2026-0848, robí jej potenciálny dopad obzvlášť citlivým. Používanie knižníc NLP a umelej inteligencie prudko vzrástlo a NLTK, napriek vzniku modernejších alternatív, zostáva pevne zakorenená v mnohých projektoch, tutoriáloch, vzdelávacích repozitároch a produkčných systémoch.
Tento typ zraniteľnosti predstavuje veľmi špecifické riziko: dôveryhodná knižnica by sa mohla stať slabým článkom útoku v dodávateľskom reťazci. Inými slovami, útočník by sa nemusel zamerať priamo na našu aplikáciu, ale skôr na medziľahlý komponent, ktorý používa každý a ktorý si takmer nikto nevšimne, kým sa niečo nepokazí.
Toto sme už videli v iných ekosystémoch: JavaScript a npm, Ruby a RubyGems a samozrejme samotný PyPI v ekosystéme Pythonu . Vzor sa opakuje: čím viac dôverujeme repozitáru a čím viac automatizujeme inštaláciu balíkov, tým atraktívnejším sa stáva pre tých, ktorí chcú nasadiť systémy vo veľkom meradle.
Skutočnosť, že zraniteľnosť NLTK umožňuje vzdialené spustenie kódu, znásobuje jej závažnosť. Nehovoríme o chybe, ktorá „iba“ uniká informácie alebo spôsobuje pády; ide o vektor, ktorý môže poskytnúť úplnú kontrolu nad postihnutým počítačom so všetkými dôsledkami, ktoré to má v produkčnom prostredí, dátovej infraštruktúre alebo firemných sieťach.
Preto, hoci okamžité riešenie zahŕňa aktualizovať NLTK na opravenú verziuZákladná debata sa viac týka bezpečnostnej kultúry a toho, ako zaobchádzame so závislosťami: auditovanie, izolácia, obmedzovanie oprávnení a kontrola nad rámec jednoduchých pip install posun.
Zmiernenie a osvedčené postupy pre zlyhania knižnice Python
Prvý krok na zmiernenie zraniteľnosti, ako je CVE-2026-0848, je pomerne jednoduchý: nainštalujte verziu NLTK, ktorá obsahuje opravu , alebo ak to nie je možné, prestaňte používať postihnuté verzie. Aktualizácia knižníc je minimálnym opatrením, aby ste sa vyhli zbytočnému vystaveniu sa už zdokumentovaným zraniteľnostiam.
Zastaviť sa tam však nestačí. Takéto incidenty zdôrazňujú potrebu prehodnotiť, ako v našich aplikáciách nakladáme s externými zdrojmi . Vždy, keď sa načítajú súbory, modely, korpusy alebo akýkoľvek iný typ údajov zvonku, je nevyhnutné overiť ich pôvod, formát a obsah, čím sa minimalizuje priestor na manévrovanie útočníka.
Ďalšou odporúčanou vrstvou ochrany je spúšťanie najcitlivejších procesov v izolovaných prostrediach, ako sú kontajnery alebo virtuálne počítače . Ak kód, ktorý spracováva text a modely NLP, beží v prostredí s veľmi obmedzenými oprávneniami, aj zneužitie RCE bude mať oveľa kontrolovanejší dopad bez priameho prístupu k zvyšku infraštruktúry.
Pomáha tiež prísne obmedziť platné zdroje údajov a kanály, ktorými sa údaje dostávajú do našich systémov. Čím jasnejšie je, ktoré API, trasy alebo úložiská sú autorizované, tým ťažšie bude pre škodlivý zdroj infiltrovať tok údajov bez toho, aby vzbudil podozrenie alebo spustil bezpečnostné upozornenia.
Nakoniec je vhodné integrovať tieto opatrenia do širšieho bezpečnostného prístupu počas celého životného cyklu vývoja : statická analýza kódu, kontroly závislostí, pravidelné audity balíkov a monitorovanie známych zraniteľností v knižniciach, ktoré používame denne. Cieľom nie je stať sa posadnutým, ale skôr vyhnúť sa slepej práci.
Typické chyby pri práci s knižnicami Pythonu: prípad screen_brightness_control
Nie všetky problémy súvisia s python knižnica Toto sú kritické zraniteľnosti. Často sa stretávame s oveľa bežnejšími chybami, ktoré však môžu zastaviť projekt alebo spôsobiť zbytočné plytvanie hodinami. Jednoduchým príkladom je prípad knižnice. screen_brightness_control, používaný na správu jasu obrazovky z Pythonu.
Vývojár pracujúci na analytickom programe na svojom počítači pomocou Kód Visual Studio, narazil na Pylanceovu správu: „import „screen_brightness_control“ sa nepodarilo vyriešiť“ priamo na čiare import screen_brightness_control as sbcToto bolo doslovne skopírované z oficiálnej dokumentácie. Python a samotná knižnica boli aktuálne, ale vývojové prostredie trvalo na tom, že modul neexistuje.
Tento typ chyby zvyčajne súvisí s problémami, ako sú nesprávne nakonfigurované virtuálne prostredia , inštalácie v cestách odlišných od tých, ktoré používa interpret, alebo nezrovnalosti medzi verziou Pythonu, ktorá spúšťa kód, a verziou použitou na inštaláciu balíka. Hoci sa tento konkrétny prípad nakoniec „magicky“ vyriešil sám od seba bez toho, aby niekto vedel, čo sa zmenilo, s najväčšou pravdepodobnosťou to bolo spôsobené nastavením prostredia alebo cesty.
Keď sa stretnete s takýmto problémom, je vhodné skontrolovať základné aspekty, ako napríklad to, ktorý interpret jazyka Python používa kód Visual Studio a či je balík skutočne nainštalovaný v danom konkrétnom prostredí pomocou pip show screen_brightness_controlalebo ak na tom istom systéme koexistuje niekoľko verzií Pythonu.
Okrem anekdoty tieto chyby ilustrujú, že hoci sa Python ľahko učí , interakcia medzi IDE, virtuálnymi prostrediami a správcami balíkov môže generovať mätúce chyby. A predovšetkým, že problém často nespočíva ani v kóde, ani v knižnici, ale v konfigurácii prostredia.
Bežné chyby pri inštalácii Pythonu, ktoré ovplyvňujú knižnice
Ešte pred inštaláciou knižnice sa mnohí používatelia stretávajú s problémami so samotnou inštaláciou Pythonu , ktoré potom ovplyvňujú používanie akýchkoľvek ďalších balíkov. Tieto chyby sú obzvlášť bežné u tých, ktorí začínajú programovať a hneď po otvorení terminálu sa im zobrazujú záhadné správy.
Súbor Python.exe sa nepodarilo nájsť
Jednou z najčastejších chýb v systéme Windows je správa, že súbor „python.exe“ sa nedá nájsť pri pokuse o spustenie Pythonu z príkazového riadku. Zvyčajne je to preto, že systém nemá v premennej prostredia PATH zahrnutú cestu k spustiteľnému súboru, takže nevie, kde hľadať interpret.
Riešenie je hotové manuálne pridajte inštalačnú cestu Pythonu k premenným prostredia systému. Ak to chcete urobiť, prejdite do rozšírených nastavení systému, otvorte sekciu „Premenné prostredia“, vyhľadajte premennú PATH v sekcii systémových premenných a upravte ju tak, aby obsahovala adresár, v ktorom sa nachádza. python.exe (napríklad C:\\PythonXX\\, pričom sa „XX“ nahradí príslušnou verziou).
Po uložení zmien je dôležité zatvoriť a znova otvoriť príkazový riadok , aby sa nová hodnota PATH prejavila. Od tohto momentu by mal byť systém schopný nájsť spustiteľný súbor Pythonu po vykonaní príslušného príkazu.
Mätúce chybové hlásenia počas inštalácie
Ďalším bežným problémom sú nejasné chybové hlásenia , ktoré sa zobrazujú počas inštalácie Pythonu alebo pri pokuse o konfiguráciu určitých komponentov. Niekedy sú spôsobené závislosťami operačného systému, inokedy nedostatočnými oprávneniami alebo konfliktmi s nesprávne odinštalovanými predchádzajúcimi verziami.
Ak chyba nie je zrejmá, najrozumnejším postupom je preštudovať si oficiálnu dokumentáciu k jazyku Python , ktorá pokrýva množstvo bežných prípadov, často kladených otázok a podrobných riešení. Priame prechádzanie na fóra bez predchádzajúceho prečítania týchto informácií môže diagnostiku ešte viac skomplikovať.
Je tiež dôležité overiť, či sťahujete správny inštalátor z oficiálnej webovej stránky Pythonu a nie zo zdrojov tretích strán, pretože používanie neoficiálnych inštalátorov môže viesť k problémom s kompatibilitou, zvláštnym verziám alebo dokonca k bezpečnostným rizikám.
Nevhodná verzia Pythonu
Je celkom bežné, že pri sledovaní tutoriálu alebo práci na konkrétnom projekte je potrebná konkrétna verzia Pythonu a bez toho, aby si to niekto uvedomil, sa nainštaluje iná verzia. To môže viesť k nekompatibilite s určitými knižnicami alebo skriptmi, ktoré používajú funkcie alebo syntax zavedenú alebo odstránenú medzi verziami.
Aby sa tieto problémy minimalizovali, je dobré uveďte presnú verziu ktoré chcete použiť pri vytváraní prostredí alebo spúšťaní príkazov. Napríklad, ak potrebujete pracovať s Pythonom 3.8, môžete vytvoriť virtuálne prostredie pomocou niečoho ako python3.8 -m venv mi_entornočím sa zabezpečí, že knižnice sú nainštalované a spustené na správnej verzii.
V prostrediach, kde koexistuje niekoľko verzií (napríklad Python 3.8 a 3.11), je dôležité mať jasno v tom, ktorý binárny súbor sa v danom čase používa, či už prostredníctvom aliasov, správcov verzií alebo nástrojov špecifických pre použitú distribúciu.
Nesprávne nakonfigurovaná cesta
Správna konfigurácia cesty (PATH) ovplyvňuje nielen hlavný spustiteľný súbor Pythonu, ale aj to, ako systém vyhľadáva skripty, doplnkové nástroje a binárne súbory nainštalované s knižnicami.
Ak sa premenná PATH upraví neopatrne alebo sa Python nainštaluje na nekonvenčné miesta bez aktualizácie, môžu vzniknúť zdanlivo nevysvetliteľné problémy: príkazy, ktoré prestanú fungovať, knižnice, ktoré „zmiznú“, alebo skripty, ktoré sa spúšťajú s verziami odlišnými od očakávaných.
Ak chcete skontrolovať aktívnu cestu, v systéme Windows môžete spustiť echo %PATH% Z príkazového riadka skontrolujte, či je zahrnutý inštalačný priečinok Pythonu. Na iných systémoch, ako napríklad Linux alebo macOS, použite echo $PATHDôsledné upravovanie týchto ciest je nevyhnutné na zabezpečenie toho, aby sa Python a jeho knižnice správali tak, ako by mali.
V profesionálnom prostredí je tiež často vhodné spoliehať sa na virtuálne prostredia a nástroje na správu verzií , aby sa zapuzdrili závislosti a nespoliehali sa až tak na globálnu konfiguráciu systému.
Škodlivé balíky v PyPI a útokoch na dodávateľský reťazec
Okrem chýb pri inštalácii a ojedinelých zraniteľností existuje zásadný problém, ktorý ovplyvňuje celý ekosystém: dôvera v správcov balíkov, ako sú PyPI, npm a RubyGems. Python nie je výnimkou a v posledných rokoch boli do oficiálneho indexu pridané tisíce škodlivých balíkov.
V jednom konkrétnom incidente bol Python Package Index (PyPI) nútený odstrániť približne 3 653 škodlivých balíkov krátko po tom, čo bola identifikovaná bezpečnostná zraniteľnosť, ktorá s nimi súvisela. Tieto balíky obsahovali neoprávnené verzie knižníc, ako napríklad CuPy, a iných legitímnych projektov, ktoré boli skopírované alebo imitované.
Problém pramení zo skutočnosti, že mnohí vývojári používajú PyPI ako priamy zdroj na integráciu knižníc tretích strán do svojich projektov, často bez dôkladnej kontroly kódu, ktorý importujú. Systém sa vo veľkej miere spolieha na dôveru v autorov knižníc a samotný repozitár a túto dôveru môžu zneužiť škodliví aktéri.
Tento typ útoku sa často spolieha na techniky, ako napríklad preklepyTo zahŕňa nahrávanie balíkov s názvami veľmi podobnými názvom populárnych knižníc, pričom sa využívajú preklepy alebo zmätky v názvoch. Ak vývojár nesprávne zadá identifikátor v pip installMôže sa stať, že si nainštalujete poškodenú verziu bez toho, aby ste si to uvedomili.
Medzi škodlivými balíkmi zistenými pri tejto operácii boli nájdené falošné verzie CupyAko cupy-cuda112 (CuPy pre CUDA 11.2), ktorý bol nahraný 25. februára 2021 a nasledujúci deň odstránený vďaka politike reakcie stanovenej v PEP 541. V tomto prípade jeden z oficiálnych projektových manažérov, Kenichi Maehashi, spustil poplach po zistení problému.
Motivácie a skutočné dôsledky týchto útokov
Zaujímavé na tomto incidente je, že účet zodpovedný za nahranie podozrivých balíkov používal názov „RemindSupplyChainRisks“ , čo naznačuje, že cieľom mohlo byť skôr upozorniť na bezpečnostné riziká vo vývojovom reťazci než vykonať rozsiahly škodlivý útok.
Komentáre k niektorým z týchto balíkov dokonca obsahovali správu s upozornením, že cieľom bolo zvýšiť povedomie o vysokom riziku slepej dôvery v dodávateľský reťazec softvéru. Napriek tomu skutočné zámery neboli úplne jasné, čiastočne preto, že autor zostal v anonymite a zanechal neaktívnu e-mailovú adresu.
Ee W. Durbin III, riaditeľ infraštruktúry Python Software Foundation, vyjadril určité pochybnosti o užitočnosti pozastavenia problematického účtu a poznamenal, že je triviálne vytvoriť nový profil a pokračovať v nahrávaní balíčkov pod inou identitou. To zdôrazňuje jednu z hlavných výziev verejných repozitárov: obmedzenú kontrolu nad tým, kto čo publikuje.
Vlastné správanie škodlivého kódu v rámci balíka cupy-cuda112 Nebolo to ani nijako zvlášť sofistikované: v podstate odoslaná požiadavka GET na IP adresu v Tokiu (101.32.99.28) vrátane názvu balíka. Nevykonával deštruktívne akcie ani nenasadil prepracovanejšie užitočné zaťaženie, čo posilňuje hypotézu, že by mohlo ísť skôr o „dôkaz konceptu“ než o plne škodlivý útok.
Napriek tomu skutočnosť, že niekto môže naraz nahrať tisíce balíkov, že tieto balíky si môžu stiahnuť legitímni používatelia a že kód sa dá spustiť na ich systémoch, jasne ukazuje, že plocha útoku ekosystému Pythonu je veľmi široká. A že akékoľvek zlyhanie, či už v dizajne, dohľade alebo bezpečnostnej kultúre, môže mať významné následky.
Praktické lekcie pre vývojárov a technické tímy
Kritické zraniteľnosti ako CVE-2026-0848 v NLTK, ako aj škodlivé balíky zistené v PyPI alebo zdanlivo neškodné chyby inštalácie poukazujú rovnakým smerom: nestačí vedieť programovať v Pythone , musíte tiež pochopiť, ako je kód distribuovaný, ako sa inštalujú závislosti a aké dôsledky má každé rozhodnutie o návrhu.
Pre každý tím, ktorý profesionálne pracuje s Pythonom, je kľúčové stanoviť jasné zásady správy závislostí : skontrolovať, ktoré knižnice sú povolené, skontrolovať ich pôvod, monitorovať známe zraniteľnosti a vyhnúť sa začleňovaniu balíkov od neznámych autorov bez minimálneho auditu kódu.
Je tiež nevyhnutné integrovať bezpečnosť do životného cyklu vývoja softvéru : od fázy návrhu až po nasadenie, vrátane automatizovaného testovania na detekciu nezabezpečených verzií, analýzy zloženia softvéru (SCA) a pravidelných kontrol runtime prostredí.
Na individuálnej úrovni sa oplatí venovať čas dôkladnému pochopeniu fungovania PIP, virtuálnych prostredí a premenných prostredia . Tento základ výrazne znižuje pravdepodobnosť výskytu frustrujúcich chýb, ako sú nevyriešené importy, konflikty verzií alebo fiktívne inštalácie, ktoré nikto nedokáže identifikovať.
V prostredí, kde sa Python používa na všetko od malých osobných skriptov až po kritické systémy umelej inteligencie, produkčné backendy a nástroje pre obchodnú analytiku, je predpoklad, že knižnice „jednoducho fungujú“ bez ohľadu na bezpečnosť, čoraz viac luxusom, ktorý si už nemôžeme dovoliť. Starostlivejší a uvedomelejší prístup k inštalácii, aktualizácii a kontrole závislostí môže byť rozdielom medzi robustným prostredím a systémom plným zadných vrátok, o ktorých nikto nevie.

Prijatie tohto spôsobu myslenia nielen pomáha predchádzať zraniteľnostiam alebo škodlivému softvéru, ale tiež zlepšuje celkovú kvalitu projektov: menej zvláštnych zlyhaní, menej času stráveného na nefunkčných inštaláciách a väčšia istota, že kód bežiaci na našich serveroch robí presne to, čo má robiť, a nič viac.