- Monitorovanie sieťovej prevádzky v reálnom čase umožňuje predvídať poruchy, zlepšovať výkon a posilňovať bezpečnosť IT infraštruktúry.
- Nástroje s otvoreným zdrojovým kódom ako Nagios, Zabbix, Prometheus, Cacti, OpenNMS, Icinga, Netdata, LibreNMS alebo Observium ponúkajú pokročilé funkcie bez licenčných nákladov.
- Kombinácia zberačov metrík, databáz časových radov a vizualizačných vrstiev, ako sú Grafana a Graphite, vytvára vysoko flexibilné a škálovateľné riešenia.
- Definovanie požiadaviek, uplatňovanie osvedčených postupov a vykonanie overenia konceptu sú kľúčové pre výber a nasadenie najvhodnejšej monitorovacej platformy.
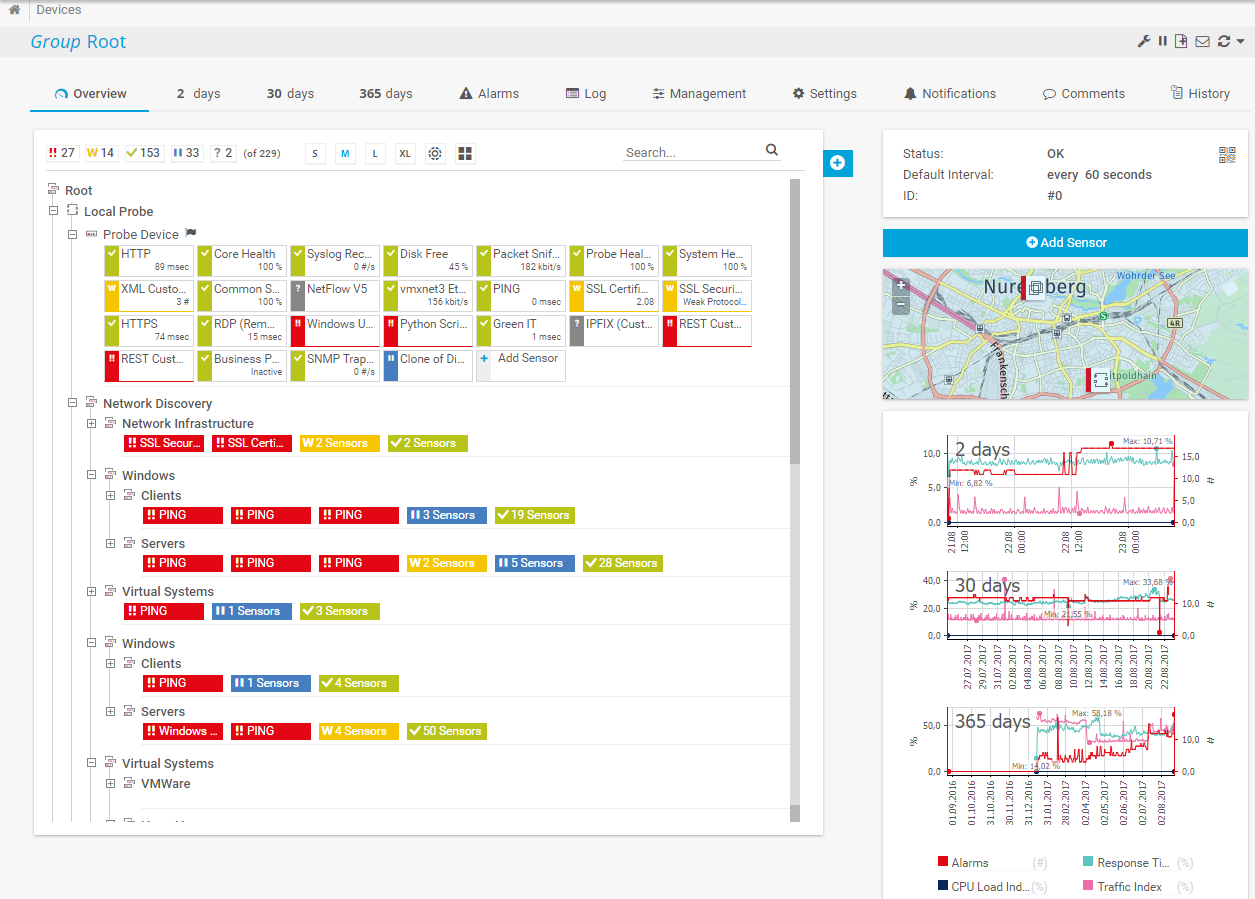
Keď sa firemná sieť začne spomaľovať, výpadok Wi-Fi alebo kritický server zlyhá v najhoršom možnom okamihu, už nestačí len „reštartovať router a dúfať, že sa to nepodarí“. Dnes je nevyhnutné mať nástroje na monitorovanie sieťovej prevádzky s otvoreným zdrojovým kódom , ktoré vám umožnia vidieť, čo sa deje v reálnom čase, predvídať problémy a vyhnúť sa nákladným prestojom.
Ak pracujete v oblasti IT, sietí alebo ste niekedy boli technickým vedúcim vo vašej spoločnosti, pravdepodobne ste už počuli o riešeniach ako PRTG alebo SolarWinds… a ich licenciách. Dobrou správou je, že existuje veľmi vyspelý ekosystém open-source platforiem na monitorovanie zariadení, služieb a sieťovej prevádzky (routery, prepínače, prístupové body Wi-Fi, servery, kontajnery, verejné cloudy a mnoho ďalšieho) bez prehnaných poplatkov a s neuveriteľnou flexibilitou.
Čo je monitorovanie sieťovej prevádzky v reálnom čase a prečo je také dôležité?
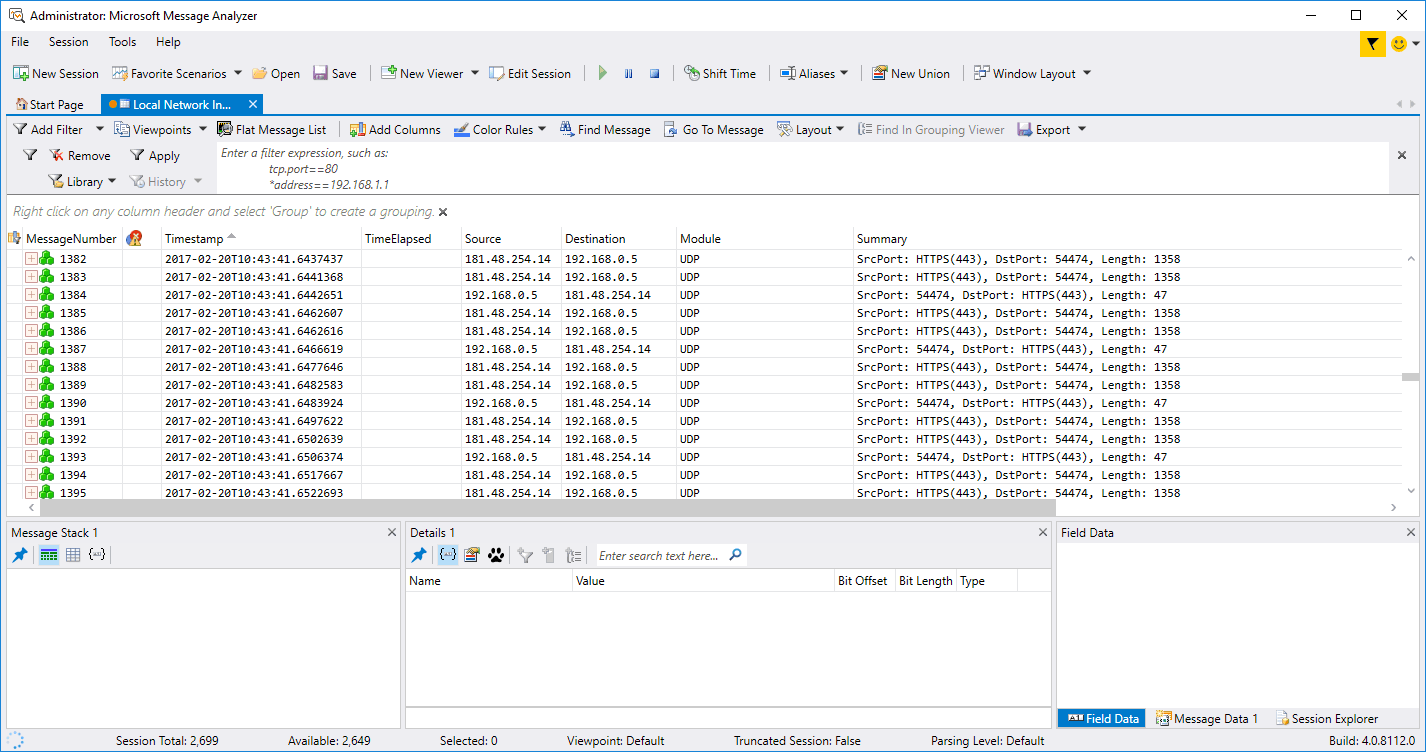
Keď hovoríme o monitorovaní siete v reálnom čase, máme na mysli nepretržitý dohľad nad stavom, výkonom a bezpečnosťou IT a komunikačnej infraštruktúry , pričom detekuje incidenty v momente ich vzniku. Softvér neustále zhromažďuje a analyzuje metriky zo zariadení, systémov a aplikácií, aby IT tím mohol reagovať skôr, ako problém ovplyvní podnikanie.
Tieto typy riešení sa spoliehajú na protokoly ako SNMP, NetFlow/sFlow, ICMP , API a špecifických agentov na zhromažďovanie údajov zo smerovačov, prepínačov, firewallov, prístupových bodov, fyzických a virtuálnych serverov, kontajnerov, cloudových služieb, webových aplikácií, databáz a prakticky akéhokoľvek prvku, ktorý je súčasťou infraštruktúry.
Hlavným cieľom je mať úplný prehľad o prevádzke, využití šírky pásma, dostupnosti a stave každej súčasti . To umožňuje odhaliť úzke miesta , útoky, zlyhania hardvéru alebo preťaženie služieb skôr, ako povedú k výpadkom, rozsiahlemu spomaleniu alebo strate údajov.
Okrem aktuálnych údajov vám mnoho nástrojov umožňuje ukladať historické metriky na analýzu trendov , plánovanie kapacity, overovanie súladu s dohodami SLA/OLA, bezpečnostný audit a podporu investičných rozhodnutí do nových zariadení alebo spojení.
Hlavné využitie a výhody monitorovania v reálnom čase
Jednou z najväčších výhod je preventívna údržba IT a sieťovej infraštruktúry . Nepretržité sledovanie údajov o CPU, pamäti, teplote, stave napájania, chybách rozhrania a strate paketov pomáha odhaliť včasné príznaky poruchy skôr, ako dôjde k vážnemu výpadku alebo prerušeniu služby.
Ďalším kľúčovým pilierom je včasná reakcia na incidenty . Monitorovacie platformy generujú prispôsobiteľné upozornenia (e-mail, SMS, Slack, Teams, webhooky atď.), keď hodnota prekročí prahovú hodnotu, služba prestane reagovať alebo sa objaví podozrivý vzorec prenosu. To dramaticky znižuje prestoje a dopad bezpečnostných incidentov alebo výpadkov výkonu.
V každodennej prevádzke prispieva monitorovanie k optimalizácii celkového výkonu sietí, serverov a aplikácií. Možnosť vidieť, ktoré spojenia sú preťažené, ktoré služby spotrebúvajú najviac zdrojov alebo ktoré časové pásma spôsobujú špičkové zaťaženie, pomáha upraviť konfigurácie, vyvážiť zaťaženie, predefinovať politiky QoS a vo všeobecnosti dosiahnuť lepší výkon z nainštalovanej technológie.
Ďalším čoraz dôležitejším aspektom je dodržiavanie predpisov. Dobrý monitorovací systém uľahčuje kontrolu prístupu, sledovanie citlivých údajov a detekciu neoprávneného prístupu , pričom poskytuje protokoly a metriky užitočné pre audity a na preukázanie súladu s regulačnými alebo zmluvnými požiadavkami.
Z obchodného hľadiska sa tieto riešenia nakoniec stávajú nástrojmi na podporu rozhodovania : pravidelné správy, riadiace panely pre manažérov, historická analýza incidentov a dostupnosti, porovnania medzi lokalitami alebo poskytovateľmi cloudu… to všetko pomáha zdôvodniť investície, vyjednávať s tretími stranami a stanovovať priority IT projektov.
Špecifické výhody open-source monitorovacieho softvéru
Prvou zjavnou výhodou nástrojov s otvoreným zdrojovým kódom je ich nákladová efektívnosť: neexistujú žiadne uzavreté licencie ani agresívne náklady na zariadenie, ako sú tie, ktoré sa nachádzajú na mnohých komerčných platformách. To neznamená, že všetko je zadarmo (vždy existujú náklady na infraštruktúru, podporu a školenie), ale úspory na licenciách uvoľňujú priestor na investície do iných kritických oblastí.
Druhou hlavnou silnou stránkou je podpora komunity a inovácie . Projekty ako Nagios, Zabbix, Prometheus, LibreNMS a Netdata majú veľmi aktívne komunity, ktoré vyvíjajú pluginy, integrácie, dashboardy a neustále vylepšujú, ako aj rýchlo opravujú chyby a odstraňujú zraniteľnosti.
Vyniká tiež transparentnosťou a dôveryhodnosťou kódu : keďže ide o softvér s otvoreným zdrojovým kódom, ktokoľvek môže auditovať, ako sa údaje spracovávajú a ukladajú, kontrolovať bezpečnosť systému a prispôsobovať zdrojový kód špecifickým potrebám. To znižuje riziko skrytých zadných vrátok a uľahčuje dodržiavanie interných bezpečnostných politík.
Ďalším kľúčovým bodom je vyhnúť sa závislosti od dodávateľa. Vďaka otvoreným riešeniam je jednoduchšie migrovať medzi nástrojmi alebo ich kombinovať (napríklad pomocou Prometheusu pre metriky aplikácií, Zabbixu pre sieťové zariadenia a Grafany ako jednotnej vizualizačnej vrstvy) bez toho, aby ste boli doživotne viazaní na plán jednej spoločnosti.
Je zrejmé, že nástroje s otvoreným zdrojovým kódom zvyčajne vyžadujú určitú úroveň technických zručností na inštaláciu, konfiguráciu a údržbu , ale na oplátku ponúkajú flexibilitu a výkon, ktoré priamo konkurujú mnohým komerčným riešeniam, najmä v prostrediach, kde sa cení prispôsobenie a integrácia s existujúcimi systémami.
Najlepšie open-source nástroje na monitorovanie sietí a infraštruktúry
Existujú desiatky vyspelých projektov zameraných na monitorovanie sietí, serverov, aplikácií a cloudových prostredí. Nižšie je uvedený prehľad najrelevantnejších open-source nástrojov pre sieťovú prevádzku a pozorovateľnosť , založený na rôznych technických analýzach a špecializovaných porovnaniach.
Jedným z klasických príkladov je Nagios Core , vysoko robustný monitorovací a upozorňovací engine. Slúži ako základ pre viacero projektov Nagios a zaoberá sa plánovaním kontrol, spracovaním výsledkov, správou udalostí a generovaním upozornení. Jeho modulárna architektúra umožňuje rozširovanie funkcií prostredníctvom vlastných API a pluginov a jeho ekosystém je rozsiahly s integráciami pre takmer akýkoľvek typ zariadenia alebo služby.
Ďalším gigantom vo svete open source je Zabbix , ktorý sa silne zameriava na monitorovanie rozsiahlych IT infraštruktúr. Je obzvlášť výkonný na zhromažďovanie a analýzu metrík sieťových zariadení (využitie šírky pásma, stav rozhrania, pripojenia, strata paketov, teplota, CPU, pamäť atď.), buď prostredníctvom SNMP, alebo pomocou vlastných agentov. Umožňuje používateľom definovať prahové hodnoty, postupy eskalácie upozornení, plány, notifikačné kanály a vysoko granulárnu logiku udalostí.
V oblasti cloudových aplikácií a časových radov vyniká Prometheus . Toto riešenie používa dimenzionálny dátový model identifikovaný názvami metrík a značkami kľúč-hodnota a využíva dotazovací jazyk PromQL na vytváranie grafov, tabuliek, pravidiel upozornení a komplexných dotazov. Jeho dáta sú efektívne uložené v pamäti a na lokálnom disku, vďaka čomu sú jednotlivé inštancie vysoko autonómne, a bezproblémovo sa integruje s Grafanou pre vizualizáciu.
Pre tých, ktorí hľadajú ľahké riešenie zamerané na veľmi krátke reálne časy a minimálnu latenciu, je Netdata veľmi zaujímavou možnosťou. Inštaluje sa ako agent na každý Linuxový server alebo zariadenie, zhromažďuje systémové a aplikačné metriky, ukladá údaje na samotnom uzle (bez toho, aby sa v krátkodobom horizonte spoliehal na externé databázy) a ponúka automatizované dashboardy s veľmi detailnými vizualizáciami výkonu, dokonca využíva modely strojového učenia na detekciu anomálií.
Špecializované nástroje pre vizualizáciu sietí a prevádzky
Okrem univerzálnych platforiem existujú aj nástroje s otvoreným zdrojovým kódom, ktoré sa priamo zameriavajú na monitorovanie sieťovej prevádzky a grafy výkonu , čo je obzvlášť užitočné, keď sa zameriavate na zobrazenie šírky pásma, tokov a stavu pripojenia.
Jedným z najpopulárnejších je Cacti , ktorý sa zameriava na vytváranie sieťových grafov a správu porúch pre prevádzkové monitorovanie. Na ukladanie údajov a generovanie grafov používa RRDTool, ponúka šablóny na automatizáciu registrácie zariadení a podporuje viacero metód získavania údajov. Jeho pluginy (okrem iných THold, SysLog, MacTrack) umožňujú nastavenie prahových hodnôt, integráciu syslogu, sledovanie MAC adries a monitorovanie zariadení v reálnom čase.
Ďalšou veľmi výkonnou platformou je OpenNMS Horizon , ktorá sa považuje za jedno z prvých plne open-source riešení pre monitorovanie sieťových služieb na podnikovej úrovni. Podporuje monitorovanie lokálnych a distribuovaných sietí a ponúka inventúru, správu porúch, vzdialený zber údajov, koreláciu alarmov, monitorovanie obchodných služieb a monitorovanie prevádzky. Všetko sa spravuje prostredníctvom intuitívneho webového rozhrania s prispôsobiteľnými dashboardmi.
V podobnom duchu sa Icinga prezentuje ako moderný vývoj modelu Nagios s prepracovaným webovým rozhraním a silným zameraním na monitorovanie siete, výkon rozhrania, využitie šírky pásma, chyby, zaťaženie CPU a pamäte a stav hardvéru. Icinga podporuje SNMP kontroly, metriky špecifické pre dodávateľa a príjem SNMP trapov, pričom sa integruje s Logstash na správu udalostí z viacerých zariadení.
Pre tých, ktorí potrebujú veľmi podrobný prehľad o sieťových zariadeniach, rozhraniach a prevádzke, sú obzvlášť užitočné projekty ako LibreNMS a Observium . Oba sa vo veľkej miere spoliehajú na SNMP a objavovacie protokoly (CDP, LLDP, OSPF, BGP, ARP atď.) na automatické vyhľadávanie siete, generovanie máp a prezentovanie výkonnostných metrík s prehľadnými grafmi , konfigurovateľnými prahovými hodnotami a flexibilnými systémami upozornení.
Pokročilá vizualizácia s Grafanou a Graphite
V mnohých komplexných nasadeniach je vrstva zberu metrík oddelená od vrstvy vizualizácie. Dva kľúčové projekty v tomto prístupe sú Grafana a Graphite , oba s otvoreným zdrojovým kódom a široko používané v podnikových prostrediach.
Grafana je multiplatformový nástroj s podporou pluginov, ktorý je určený na vytváranie plne prispôsobiteľných dashboardov na vizualizáciu dát. Umožňuje vám pripojiť viacero zdrojov dát (Prometheus, Graphite, InfluxDB, MySQL, cloudoví poskytovatelia atď.) a zobraziť metriky v histogramoch, geografických mapách, tepelných mapách, čiarových grafoch, tabuľkách a mnohých ďalších typoch vizualizácií. Podporuje anotácie v reálnom čase, dynamické dashboardy a definovanie upozornení s upozorneniami na rôzne kanály.
Graphite sa zameriava na zachytávanie a grafické znázornenie metrík časových radov. Dá sa nasadiť na jednoduchý hardvér alebo v cloude a je ideálny na monitorovanie výkonu webových stránok, podnikových služieb, serverov a sieťových metrík . Mnoho tímov sa rozhoduje pre spravované služby založené na Graphite (ako napríklad MetricFire), ktoré pridávajú klastrované úložisko, označovanie údajov, ďalšie integrácie a viackanálové upozornenia, pričom stále využívajú silu Graphite a často Grafany pre front-end.
V typickom nasadení sieťové systémy a servery odosielajú metriky do Graphite alebo kompatibilného kolektora (napr. pomocou protokolov ako StatsD) a potom sa v Grafane vytvoria dashboardy, ktoré poskytujú jednotný pohľad na stav celej infraštruktúry: od prevádzky na každom rozhraní až po latenciu dotazov alebo využitie CPU na službu.
Ďalšie relevantné riešenia monitorovania s otvoreným zdrojovým kódom
Ekosystém monitorovania s otvoreným zdrojovým kódom je veľmi široký a pokrýva špecifické potreby, ako je automatické vyhľadávanie, monitorovanie procesov, kanály pozorovateľnosti alebo zber metrík z veľmi heterogénnych prostredí.
Napríklad Checkmk je vysoko škálovateľná platforma schopná monitorovať všetko od malých prostredí až po veľké podniky. Zahŕňa pokročilú správu agentov, automatické vyhľadávanie siete, interaktívne vizualizácie, výkonné systémy upozornení, reportovanie SLA, analýzu protokolov a udalostí a API na rozšírenie svojej funkčnosti. Je ponúkaná v rôznych edíciách (bezplatná RAW, Enterprise, Cloud a MSP) a prispôsobuje sa rôznym veľkostiam a modelom služieb.
M/Monit sa zameriava na monitorovanie a samoopravu systémov Unix a Linux. Monitoruje procesy, využitie CPU a pamäte a sieťové rozhrania a dokáže automaticky reagovať na chyby vykonávaním nápravných opatrení. Umožňuje tiež monitorovať spúšťanie služieb, skenovať súbory a adresáre, či neobsahujú neoprávnené zmeny, a kontrolovať sieťové pripojenia k lokálnym alebo vzdialeným serverom.
V oblasti analýzy topológie siete a metrík vyniká Pandora FMS ako komplexné riešenie, ktoré ponúka monitorovanie siete, používateľského rozhrania, cloudu, serverov a aplikácií, správu inventára, protokolov a prispôsobiteľné dashboardy. Dokáže automaticky detekovať sieťové rozhrania, vytvárať mapy, zobrazovať štatistiky o úzkych miestach v reálnom čase a poskytovať komplexné správy.
Pre moderné mikroslužby a multicloudové architektúry funguje Sensu ako druh centralizovaného kanála pozorovateľnosti , ktorý zjednocuje rôzne monitorovacie nástroje. Ponúka kontroly stavu, vlastné metriky výkonu, správu protokolov, správu sieťových problémov a viackanálové upozornenia s deduplikáciou. Okrem toho podporuje samoopravu vykonávaním reštartov služieb alebo vlastných skriptov pri detekcii problémov.
Agenti, zberatelia a pomocné nástroje
Okrem veľkých platforiem existujú aj ľahšie nástroje, ktorých hlavnou funkciou je zhromažďovať a odosielať metriky zo systémov, senzorov a aplikácií do databáz alebo hlavných monitorovacích systémov.
Výborným príkladom je Telegraf , agent založený na jazyku Go bez externých závislostí, schopný fungovať prostredníctvom rozsiahleho systému pluginov. S viac ako 300 vstupno-výstupnými pluginmi dokáže Telegraf extrahovať metriky a udalosti z rôznych technologických stackov a odosielať dáta do systémov ako InfluxDB, Graphite, OpenTSDB, Datadog, Librato a ďalšie. Jeho vyrovnávacie pamäte v pamäti zabezpečujú, že metriky sa nestratia, ani keď je hlavný backend dočasne nefunkčný.
Ďalším dôležitým prvkom v mnohých architektúrach je použitie špecifických exportérov a kolektorov (napríklad v ekosystéme Prometheus s exportérmi pre databázy, webové servery, systémy radenia atď.), ktoré umožňujú sprístupnenie metrík v štandardnom formáte bez nutnosti prepisovania každej aplikácie.
Kombináciou agentov ako Telegraf, špecializovaných exportérov a platforiem pre časové rady a vizualizáciu je možné vytvoriť veľmi kompletné riešenia pre monitorovanie sietí, serverov, aplikácií a cloudov , úplne založené na slobodnom softvéri alebo s minimálnymi komerčnými komponentmi, ak je požadovaná oficiálna podpora.
Tento modulárny prístup má výhodu v tom, že každá organizácia si môže vybrať iba tie časti, ktoré potrebuje , integrovať ich so svojimi existujúcimi systémami (ticketing, CMDB, SIEM atď.) a vyvíjať architektúru podľa toho, ako prostredie rastie alebo sa mení smerom ku kontajnerom, Kubernetes alebo bezserverovým službám.
Ako si vybrať najlepší nástroj na monitorovanie siete s otvoreným zdrojovým kódom
Pred inštaláciou prvého populárneho nástroja je dôležité jasne definovať, čo chcete monitorovať : iba fyzickú sieť (routre, prepínače, prístupové body), alebo aj servery, virtuálne počítače, kontajnery, aplikácie, či dokonca používateľskú skúsenosť a cloudové služby. Toto stanovenie priorít vám umožňuje zúžiť rozsah možností a vybrať si riešenia, ktoré dobre zodpovedajú vášmu primárnemu prípadu použitia.
Je dôležité posúdiť kľúčové funkcie, ktoré potrebujete: reporty, upozornenia, vizualizáciu údajov, ukladanie historických údajov, integráciu so systémami tretích strán, API a podporu pre špecifické protokoly (SNMP, NetFlow, WMI, cloudové API atď.). Napríklad Prometheus je ideálny, keď sú potrebné vlastné metriky a komplexné pravidlá upozornení; Cacti vyniká v zobrazovaní grafov sieťovej prevádzky; a Checkmk poskytuje interaktívnu vizualizáciu a komplexné SLA reporty.
Ďalším kľúčovým faktorom je jednoduchosť používania a konfigurácie. Nástroje ako Zabbix, Netdata alebo Checkmk zvyčajne ponúkajú užívateľsky prívetivých sprievodcov nastavením a dashboardy, zatiaľ čo vysoko flexibilné riešenia môžu vyžadovať viac počiatočného nastavenia. Pred rozhodnutím sa odporúča otestovať rozhranie pre vyhľadávanie siete, vytváranie hostiteľov a služieb a konfiguráciu upozornení.
Z hľadiska bezpečnosti je nevyhnutné, aby platforma podporovala šifrovanie, silnú autentifikáciu a riadenie prístupu na základe rolí . Niektoré, ako napríklad OpenNMS, Icinga alebo Prometheus, umožňujú pridanie pokročilých modulov alebo konfigurácií na posilnenie bezpečnosti, segmentovaný prístup k údajom a súlad s internými alebo regulačnými normami; okrem toho je vhodné doplniť to osvedčenými postupmi pre pokročilú konfiguráciu firewallu na serveroch.
Nakoniec sa dôrazne odporúča vykonať overenie konceptu (POC) s 2 alebo 3 finalistickými nástrojmi , nasadiť ich v kontrolovanom prostredí, monitorovať reprezentatívnu podmnožinu infraštruktúry a vyhodnotiť výkon, jednoduchosť používania, kvalitu upozornení a integračné schopnosti s existujúcimi nástrojmi (systémy ticketov, CI/CD, zasielanie správ atď.).
Najlepšie postupy pre efektívne monitorovanie siete
Po výbere platformy úspech do značnej miery závisí od toho, ako je navrhnuté nasadenie. Kľúčovým prvým krokom je zdokumentovanie a mapovanie siete : aké zariadenia sú prítomné, kde sa nachádzajú, aké prepojenia používajú, aké kritické služby podporujú a aké závislosti medzi nimi existujú. To uľahčí definovanie toho, čo a ako monitorovať. Pre lepšie pochopenie topológií a typov sietí si pozrite článok Počítačové siete: Typy a príklady.
Odporúča sa zvoliť jeden alebo viac štandardných komunikačných protokolov pre zariadenia, ktoré budú odosielať informácie do nástroja: SNMP pre sieťové zariadenia, agentov pre servery, exportérov Prometheus pre špecifické služby, syslog pre udalosti atď. Čím homogénnejší je prístup, tým ľahšie sa bude dlhodobo udržiavať.
Je tiež dôležité definovať základné správanie : normálne hodnoty pre latenciu, šírku pásma, CPU, pamäť, súbežné pripojenia atď. To umožňuje konfiguráciu realistických prahových hodnôt a presnejšiu detekciu anomálií, čím sa zabráni falošným poplachom aj zmeškaným upozorneniam na skutočné incidenty.
Nastavenie jasných, prehľadných dashboardov špecifických pre jednotlivé role (prevádzka 24 hodín denne, 7 dní v týždni, sieť, systémy, správa atď.) pomáha skrátiť čas diagnostiky. NOC bude potrebovať súhrnné zobrazenia a upozornenia v reálnom čase; správcu siete bude potrebovať podrobné rozhrania, chyby a fronty; a CIO, dostupnosť a SLA pre kritické služby.
Nakoniec je nevyhnutné definovať politiku eskalácie upozornení : kto prijíma aký typ upozornenia, prostredníctvom ktorého kanála a s akou prioritou; čo sa robí mimo pracovnej doby; čo predstavuje závažný incident; a ako je reakcia koordinovaná medzi tímami. Aj tie najlepšie nástroje na svete strácajú účinnosť, ak nikto nereaguje na upozornenia alebo ak neexistuje jasný akčný plán.
Berúc do úvahy všetky tieto aspekty, riešenia monitorovania sieťovej prevádzky s otvoreným zdrojovým kódom vám umožňujú budovať superrobustné prostredia s komplexným prehľadom, podporou rozhodovania a pevným základom pre zlepšenie bezpečnosti, dostupnosti a výkonu akejkoľvek infraštruktúry, od malej firmy až po veľkú distribuovanú spoločnosť.