- Microsoft Fabric centralizon të dhënat, qeverisjen, inteligjencën artificiale dhe analizat në kohë reale në OneLake dhe aftësi të unifikuara.
- Platforma forcon qeverisjen, sigurinë dhe koston përmes Purview, sigurisë OneLake, DLP, DSPM dhe integrimit me Azure Cost Management.
- Data Factory, Dataflow Gen2 dhe mjetet e migrimit e bëjnë të lehtë zhvendosjen e ngarkesave ekzistuese të punës dhe orkestrimin e tubacioneve komplekse.
- Bashkëpiloti, agjentët e të dhënave, MCP dhe ngarkesa të reja pune si Fabric IQ dhe Inteligjenca në Kohë Reale nxisin skenarë të përparuar të IA-së dhe automatizimit.
Nëse keni punuar me të dhëna në ekosistemin e Microsoft për një kohë, do të keni vënë re se Microsoft Fabric është bërë qendra qendrore për analizat moderne , duke bashkuar gjithçka që më parë ishte e përhapur në Power BI, Azure Synapse, Data Factory dhe shërbime të tjera në një platformë të vetme. Në këtë artikull, do të hedhim një vështrim të plotë dhe të detajuar në veçoritë më të fundit, planin rrugor dhe implikimet praktike të Fabric për analizat, qeverisjen, inteligjencën artificiale dhe analizat në kohë reale.
Ideja është që, kur të mbaroni së lexuari, do të keni një vizion të qartë se çfarë ofron Microsoft Fabric sot, ku po shkon dhe si ndikon në arkitekturën e të dhënave të organizatës suaj: aftësitë e qeverisjes me Purview, automatizimi me API dhe Git, veçoritë e reja të IA-së, inteligjenca në kohë reale, siguria në OneLake, migrimet, performanca dhe shumë më tepër.
Microsoft Fabric dhe Korniza e Përshtatjes së Cloud: qeverisja, kostot dhe automatizimi
Brenda Kornizës së Përshtatjes së Cloud (CAF), Microsoft ka publikuar një seri udhëzuesish për të përshtatur dizajnin e Microsoft Fabric me shtyllat e dizajnit të zonave të uljes . Pjesa më e fundit në këtë seri trajton tre fusha kryesore: qeverisja, optimizimi i kapacitetit dhe automatizimi/DevOps.
Nga ana e qeverisjes, kostot e kapacitetit të Fabric ekspozohen përmes Azure Cost Management . Kjo lejon integrimin vendas të konsumit të kapacitetit F (dhe SKU-ve të tjera) në panelet e kostos, alarmet dhe analizat e shpenzimeve të Azure. Nuk ka të bëjë vetëm me shikimin e faturës: mund ta krahasoni këtë informacion me etiketat, abonimet ose grupet e burimeve për të kuptuar se kush po shpenzon çfarë dhe pse.
Arkitektura teknike dhe modeli i biznesit i Fabric u lejojnë klientëve të kontrollojnë me imtësi konsumin e kapacitetit për të optimizuar kostot operative . Në praktikë, kjo përkthehet në disa leva:
- Shkallëzimi i aftësive Frrit ose ul kapacitetin bazuar në kulmet e parashikueshme, siç janë fushatat e shitjeve, afatet e kontabilitetit ose ngarkesat e mëdha të të dhënave.
- Mundësitë e pauzës dhe rifillimitAdministratorët e fabric mund të ndalojnë një kapacitet F kur nuk është i nevojshëm (për shembull, gjatë natës ose gjatë fundjavave në mjedise jo kritike) për të ulur kostot llogaritëse.
- Mbrojtje nga mbingarkesaDy parametra të nivelit të kapacitetit kontrollojnë mënyrën se si menaxhohen punët në sfond për të parandaluar që ato të mbingarkojnë mjedisin: Pragu i Refuzimit të Sfondit dhe Pragu i Rimëkëmbjes së Sfondit.
- Rezervimet e kapacitetitËshtë e mundur të rezervohet kapacitet për periudha të përcaktuara për të përfituar zbritje, me kusht që konsumi i pritur të planifikohet me rigorozitet.
Në fushën e qeverisjes së të dhënave, Fabric mbështetet në Microsoft Purview si komponentin e tij qendror për katalogimin, prejardhjen dhe klasifikimin . Purview u lejon përdoruesve të aplikojnë etiketa ndjeshmërie, të shohin prejardhjen në burime, transformime dhe konsum, të certifikojnë asetet e të dhënave dhe të nxisin fushata për cilësinë e të dhënave, të gjitha ndërkohë që integrojnë elementët e Fabric (Lakehouse, Warehouse, KQL, Power BI, etj.).
Komponenti "Automatizimi i Platformës dhe DevOps" përqendrohet kryesisht në integrimin e Git, kanalet e vendosjes dhe API-të REST . Hapësirat e punës Fabric mund të lidhen me depot e Git, duke u lejuar zhvilluesve të shumtë të bashkëpunojnë në të njëjtin projekt inxhinierie të të dhënave, shkencë të të dhënave ose analizash në kohë reale pa mbivendosje të punës.
Gypat e Git dhe Deployment Line mundësojnë orkestrimin e cikleve të zhvillimit, testimit dhe prodhimit në një mënyrë të kontrolluar : promovimin e përmbajtjes, gjurmimin e ndryshimeve, sinkronizimin e artefakteve dhe menaxhimin e versioneve. Që nga marsi i vitit 2025, këto tubacione kanë mbështetur (në gjendje të përgjithshme ose paraprake) një gamë të gjerë llojesh elementësh, duke përfshirë shkaktuesit, panelet e kontrollit, rrjedhat e të dhënave, tubacionet e të dhënave, datamart-et, lakehouse-et, depot e të dhënave, KQL, fletoret, raportet e faqosura, aplikacionet organizative dhe më shumë.
Paralelisht, Fabric ekspozon një gamë shumë të gjerë API-sh REST me të cilat mund të automatizohet pothuajse çdo detyrë administrative ose vendosjeje: krijimi i hapësirave të punës dhe dosjeve, migrimi masiv i artikujve, menaxhimi i lidhjeve dhe portave, nxjerrja e përkufizimeve, aktivizimi i tubacioneve ose fletoreve, ndër të tjera.
Përditësime kryesore në analiza, inteligjencë artificiale dhe qeverisje për Microsoft Fabric
Evolucioni i Fabric karakterizohet nga një numër i madh veçorish paraprake dhe aftësish të reja që prekin praktikisht çdo fushë të platformës . Këto janë grupuar dhe diskutuar më poshtë në një mënyrë të strukturuar për të treguar fushëveprimin e tyre të plotë.
Funksionet e IA-së në Data Warehouse dhe funksionet multimodale
Në fushën e të dhënave relacionale, Fabric Data Warehouse përfshin funksionet e IA direkt në T-SQL (pamje paraprake). Kjo lejon:
- Klasifikoni ose kategorizoni tekstin.
- Analizoni ndjenjën.
- Nxjerr informacionin e strukturuar nga teksti i lirë.
- Përkthe tekstin midis gjuhëve.
- Gramatikë e saktë.
Qëllimi është të eliminohet nevoja për të lënë kontekstin SQL për të pasuruar të dhënat me IA . Këto funksione kombinohen me mbështetje më të gjerë multimodale në funksionet e IA-së të Fabric, të cilat tani mund të përpunojnë imazhe (JPG/JPEG, PNG, GIF, WebP), PDF dhe formate të zakonshme teksti, si dhe hyrje të shtegut të skedarit.
Përfshihen shërbime të tilla si aifunc.load për futjen e dosjeve në tabela me opsione të promptit dhe skemës, aifunc.list_file_paths për përshkimin e shtigjeve të skedarëve dhe ai.infer_schema për nxjerrjen e skemave të pajtueshme me ai.extract . E gjithë kjo ju lejon të transformoni dhe pasuroni të dhënat pa ndërtuar kanale komplekse nga e para.
OneLake, Delta, Apache Iceberg dhe qasje në shumë platforma
Në shtresën e ruajtjes, OneLake mbetet liqeni i unifikuar ku ndodhet i gjithë Fabric. Një nga përmirësimet kryesore është aftësia për të ekspozuar tabelat e Delta Lake si tabela Apache Iceberg pa lëvizur ose dublikuar të dhëna, në mënyrë që motorët e pajtueshëm me Iceberg të mund të lexojnë drejtpërdrejt atë që është në OneLake.
Për më tepër, OneLake tani mbështet të dhënat e Apache Iceberg të shkruara direkt nga Snowflake dhe të konsumuara në Fabric nëpërmjet aksesit pa kopjim . Kjo strategji forcon ndërveprimin: Fabric nuk ka për qëllim të jetë një silo, por më tepër një qendër të dhënash që motorët e tjerë mund ta shfrytëzojnë pa dublikuar hapësirën e ruajtjes.
Në të njëjtën linjë, OneLake mbështet shkurtore për Azure Blob Storage , OneDrive dhe SharePoint, dhe zgjeron sigurinë me role aksesi, siguri në nivel dosjesh, rreshtash dhe kolonash, si dhe një model sigurie që palët e treta mund ta respektojnë falë zgjerimit të modelit të motorit të autorizuar.
Një veçori veçanërisht e rëndësishme është federata e katalogut OneLake me Azure Databricks, e cila mundëson akses pa kopje nga Unity Catalog në tabelat OneLake . Në këtë mënyrë, OneLake mbetet burimi i së vërtetës, por Databricks mund të kërkojë të dhënat drejtpërdrejt, duke sinkronizuar vetëm metadatat.
Baza e të dhënave SQL në Fabric: performanca, siguria dhe virtualizimi
Baza e të dhënave SQL e Fabric po fiton aftësitë e veta: opsionet ALTER DATABASE SET , mbështetje për krahasimin dhe indeksimin e tekstit të plotë në pamje paraprake. Sa i përket performancës dhe kostos së bazës së të dhënave, ka disa përmirësime:
- Kompaktimi automatik i indeksit për të zvogëluar hapësirën e ruajtjes, I/O dhe për të përmirësuar kohën e pyetjeve pa pasur nevojë të planifikoni punë mirëmbajtjeje.
- Limiti maksimal i vCores për të kontrolluar përdorimin e burimeve kompjuterike (4 ose 32 vCore), të projektuara për të parandaluar që një ngarkesë pune të konsumojë shumë në kapacitetin e përbashkët.
- Pishinat SQL të personalizuara që u japin administratorëve të hapësirës së punës kontroll të detajuar mbi alokimin e burimeve dhe drejtimin e pyetjeve sipas emrit të aplikacionit.
Virtualizimi i të dhënave është gjithashtu i aktivizuar në bazën e të dhënave SQL , e cila lejon pyetjen e të dhënave të jashtme të ruajtura në OneLake me T-SQL, bashkimin e skedarëve në formate të zakonshme me tabela relacionale lokale duke përdorur bashkime, pa pasur nevojë të importohen fizikisht të dhënat.
Për sa i përket sigurisë, baza e të dhënave SQL mbështet Private Link në nivelin e qiramarrësit (pamje paraprake) , gjë që e bën më të lehtë kanalizimin privat të trafikut të të dhënave dhe në mënyrë të kontrolluar, duke u integruar me konfigurimin e përgjithshëm të rrjetit të sigurt të Fabric.
Inteligjencë në Kohë Reale, Eventhouse, Eventstream dhe Activator
Moduli i Inteligjencës në Kohë Reale (RTI) është bërë një nga dalluesit kryesorë të Fabric. Eventhouse dhe Eventstream punojnë së bashku për të përpunuar, përpunuar dhe shkaktuar ngjarje në kohë reale nga të gjitha llojet e burimeve, dhe Activator orkestron veprimet që shkaktohen në kushte të caktuara.
Ndër veçoritë e reja më të fuqishme janë:
- Zbulimi i anomalive pa kod me përzgjedhje automatike të modelit, ndërfaqe të thjeshtë dhe alarme fleksibile.
- Ngjarjet e biznesit, të cilat kapin momentet kryesore të biznesit të gjeneruara nga Funksionet e të Dhënave të Përdoruesit dhe Fletoret, dhe ju lejojnë të aktivizoni alarme, logjikë të personalizuar, rrjedha, modele të inteligjencës artificiale ose punë Spark.
- Integrimi i Funksioneve të të Dhënave të Aktivizuesit-Përdoruesitnë mënyrë që funksionet e krijuara në Fabric të mund të përpunojnë ngjarje nga çdo burim, duke përfshirë ngjarjet e brendshme nga vetë platforma dhe nga OneLake.
- Aftësia për të përpunuar ngjarje me SQL (Operatori SQL në Eventstream), duke lejuar transformimin e rrjedhave në kohë reale me sintaksë të njohur SQL.
Shtohen lidhës përkatës, siç është Cribl (për marrjen e regjistrave dhe telemetrisë nga burime të shumëfishta), një lidhës me Solace PubSub+ dhe mbështetje për transmetim në rrjete private nëpërmjet Azure Virtual Network, VPN, ExpressRoute ose pikave fundore private.
Për skemat e të dhënave dhe kontratat, Eventstream prezanton një Regjistër Skemash që përcakton dhe validon skemat e ngjarjeve për tubacione më të fuqishme, dhe mbështetje për Regjistrin e Skemave Confluent për t'u lidhur me Kafka në Confluent Cloud duke respektuar kontratat ekzistuese.
Aftësi bashkëpilotësh dhe inteligjence artificiale në të gjithë platformën
Copilot në Fabric tani është i disponueshëm globalisht, me mbështetje për Power BI, Data Factory, Data Science & Data Engineering, dhe shkrimin e pyetjeve KQL . Përveç kësaj, janë shtuar aftësi specifike:
- Kopilot për Dataflow Gen2 (Modern Get Data), e cila ndihmon në përthithjen dhe transformimin e të dhënave me udhëzime në gjuhë natyrore.
- Bashkëpilot për Data Warehouse (chat), i arritshëm nga një buton në shirit për të përshpejtuar detyrat e magazinimit përmes dialogut.
- Kopilot për pikën fundore të analizës SQL, i cili gjeneron dhe optimizon pyetjet SQL nga përshkrimet e biznesit.
- Bashkëpilot në fletore me njohuri të kontekstit të hapësirës së punës, lakehouse, strukturës së notebook-ut dhe mjedisit të ekzekutimit, i aftë të gjenerojë kod shumëhapësh, të riorganizojë, të përmbledhë notebook-e komplekse dhe të diagnostikojë gabime me opsionin "Fix with Copilot".
- Autoplotësimi në linjë (përfundimi i kodit në linjë) dhe përfundimi i kodit në linjë (parapamje) i Notebook Copilot, për të shkruar Python më shpejt dhe me më pak gabime.
Për më tepër, baza e teknologjisë së IA-së po zgjerohet me Mjete Foundry të parapërgatitura të integruara (Azure OpenAI, Azure Language, Azure Translator), shtojca OpenAI për Eventhouse (ai_embed_text dhe ai_chat_completion), dhe një seri agjentësh dhe agjentësh të dhënash që lejojnë aplikacione të tjera, përfshirë Copilot Studio, të punojnë me të dhënat e Fabric në një mënyrë të orkestruar.
Agjentët e të dhënave Fabric, MCP dhe mjetet e zhvilluesit
Fabric prezanton agjentë të dhënash të aftë për të orkestruar aksesin në të dhëna dhe mjete për agjentët e IA-së, me një SDK Python dhe integrim të drejtpërdrejtë me Microsoft Copilot Studio. Kjo e bën të lehtë ndërtimin e asistentëve bisedorë që punojnë me të dhënat e ndërmarrjes të menaxhuara në Fabric.
Paralelisht, Protokolli i Kontekstit të Modelit (MCP) bëhet një komponent kyç i integrimit midis agjentëve të IA-së dhe shërbimeve Fabric. Ekzistojnë serverë të dedikuar MCP për Activator dhe Eventhouse, dhe një MCP Fabric i orientuar drejt zhvillimit që:
- Kjo u lejon asistentëve të IA-së të gjenerojnë kod dhe përmbajtje për artikujt Fabric.
- Integrohet me mjete zhvillimi si VS Code dhe GitHub Codespaces.
- Ai paraqet mjete për konsultim dhe veprim mbi të dhënat në kohë reale në Eventhouse.
Për punën e përditshme të zhvilluesit, ka disa pjesë për t'u theksuar, duke përfshirë mjedisin e zhvillimit : zgjerimin MSSQL për VS Code me mbështetje për bazën e të dhënave SQL të Fabric , drajverin Microsoft ADO.NET dhe drajverin ODBC për Fabric Data Engineering (lidhje me Spark SQL nëpërmjet Livy), dhe një lidhës Spark për bazat e të dhënave SQL që thjeshton aksesin e autentifikuar nga Spark në bazat e të dhënave SQL në Azure dhe Fabric.
Gjithashtu përfshihet Fabric CLI , i disponueshëm si një detyrë e integruar në Azure DevOps, i cili ju lejon të automatizoni menaxhimin e hapësirave të punës, artikujve dhe vendosjeve pa instaluar manualisht mjete të jashtme.
Fabrika e të Dhënave, migrimet e të dhënave dhe orkestrimi në Fabric
Shtresa e integrimit të të dhënave të Fabric mbështetet në Data Factory dhe Dataflow Gen2, të cilat po marrin veçori për ta bërë orkestrimin më të zgjuar, më të automatizuar dhe me migrime më të lehta nga platformat ekzistuese.
Dataflow Gen2: performanca, API-të publike dhe diagnostikimi
Në Dataflow Gen2 gjejmë disa veçori në pamjen paraprake:
- Redaktim i avancuar i pyetjeve të synuara për të rregulluar logjikën në destinacion direkt nga vetë mjedisi i krijimit.
- Llogaritja e ndarëgjë që lejon që pjesë të rrjedhës së të dhënave të funksionojnë paralelisht, duke zvogëluar kohën totale të vlerësimit.
- Shkarkoni diagnostikimin në nivelin e ekzekutimit, me paketa të strukturuara të regjistrave për analizën e performancës dhe zgjidhjen e incidenteve.
- API-të publike për krijimin, përditësimin, fshirjen, planifikimin dhe monitorimin e rrjedhave të të dhënave në mënyrë programore.
- Parametrat publikë me mbështetje CI/CDtë cilat lejojnë rifreskimin e rrjedhave të të dhënave duke kaluar vlera nga tubacionet ose burime të tjera.
- Të dhënat e fundit për qasje të shpejtë në artikujt e përdorur së fundmi në shiritin e Power Query dhe në Modern Get Data.
E gjithë kjo plotësohet nga aftësia për të vlerësuar në mënyrë programore Power Query nëpërmjet REST , e cila hap derën për ekzekutimin e skripteve M si pjesë e proceseve të automatizuara, duke i integruar ato me Spark, tubacione ose mjete të jashtme, duke përfituar nga lidhësit Power Query.
Fabrika e të Dhënave: performancë adaptive, lidhshmëri dhe dbt
Në pjesën më "klasike" të integrimit, Data Factory brenda Fabric prezanton:
- Akordimi adaptiv i performancës për aktivitetin e kopjimit, i cili rregullon në mënyrë inteligjente parametrat e performancës sipas kontekstit të konfigurimit dhe ekzekutimit.
- Mbështetje për Kapjen e të Dhënave të Ndryshuara (CDC) në punën e Kopjimit, për të replikuar vetëm ndryshimet (futjet, përditësimet, fshirjet) vazhdimisht.
- Porta hyrëse në vend me opsion përmirësimi manual të menaxhuara nga portali Fabric, API ose skriptet.
- lidhje e fundit, i cili shton veti të përdorimit të fundit në lidhje për të lehtësuar auditimin dhe menaxhimin e ciklit jetësor.
- Punë dbt vendase, e cila lejon ekzekutimin e projekteve dbt brenda Fabric me orkestrim, testim, dokumentim dhe qeverisje të integruar.
- Thirr aktivitetin e paketës SSIS në tubacione, për të ekzekutuar paketa SSIS nga vetë orkestrimi në Fabric.
Përvoja e përdoruesit përmirësohet gjithashtu me një SharePoint Site Picker që eliminon nevojën për të shkruar manualisht URL-të, dhe me mbështetjen MCP për Data Factory, duke u mundësuar asistentëve të IA-së të krijojnë dhe vendosin Dataflow Gen2 thjesht nga udhëzimet në gjuhën natyrore.
Mjetet e migrimit dhe replikimit të të dhënave
Microsoft po e promovon fuqishëm migrimin në Fabric përmes disa mjeteve specifike:
- Vlerësimi i Migrimit të Fabrikës për Fabrikën e të Dhënave, i cili analizon përgatitjen e tubacioneve ADF dhe migron ato të mbështetura në një hapësirë pune Fabric me hartëzim lidhjesh.
- Asistent Migrimi për Deponë e të Dhënavei cili tani mund të lidhet direkt me depon e burimit për ta zhvendosur atë në Fabric Data Warehouse.
- Asistent Migrimi për bazën e të dhënave SQL, që synon migrimin e ngarkesave të punës të SQL Server në ambientet e tyre, me importimin e skemës nëpërmjet DACPAC, zbulimin e papajtueshmërisë dhe rekomandimet.
Lidhur me replikimin, ofrohet mbështetje për pasqyrimin nga burime të ndryshme operative (Azure Database për MySQL, Google BigQuery, SQL Server, etj.) në Fabric, me mundësinë për të kontrolluar se cilat tabela replikohen, për të rinisur proceset e pasqyrimit nëpërmjet REST dhe, në rastin e Databricks, për të lidhur politikat e Unity Catalog me sigurinë e OneLake.
Gjithashtu përfshihet një lidhës replikimi nga Lakehouse duke përdorur Delta Change Data Feed , i cili ekspozon ndryshimet nga tabelat Lakehouse Delta në destinacione të pajtueshme pa pasur nevojë të shpikësh rrotën me zgjidhje CDC të prodhuara në shtëpi.
Siguria, qeverisja e përparuar dhe monitorimi në Fabric
Një nga shqetësimet më të mëdha për çdo platformë analitike është se si të sigurohen të dhënat, të qeveriset përdorimi dhe të monitorohet konsumi i burimeve . Fabrika po piqet me shpejtësi në këto fusha.
Siguria dhe mbrojtja e të dhënave në OneLake
OneLake shton një model të plotë sigurie për aksesin në të dhëna me:
- Rolet e aksesit në të dhëna për lakehouse me leje të konfigurueshme nga një ndërfaqe sigurie e bazuar në dosje.
- Mbështetje sigurie për shkurtesat në mënyrë që palët e treta të mund të respektojnë politikat e përcaktuara.
- API-ja e sigurisë së aksesit të të dhënave OneLake, e cila lejon menaxhimin e automatizuar të lejeve.
- Zgjerimi i modelit në motorë të jashtëm (autorizimi i sigurisë OneLake për palët e treta).
Paralelisht, mbrojtja zgjerohet me DLP që kufizon aksesin mbi të gjitha të dhënat e strukturuara në OneLake (SQL, KQL, depo) dhe është prezantuar DSPM për IA-në për Fabric Copilots dhe agjentët e të dhënave , i cili monitoron ndërveprimet e IA-së për informacione të ndjeshme dhe sjellje të rrezikshme, me integrim me Purview Audit dhe eDiscovery.
Në planin e identitetit, shfaqen veçori të tilla si identitetet e lidhura me artikujt (p.sh., Lakehouse dhe Eventstream) nëpërmjet API-ve REST, të cilat eliminojnë varësinë e pronarit për operacione të caktuara dhe vërtetimin e shkurtoreve të OneDrive dhe SharePoint nëpërmjet identiteteve kryesore të hapësirës së punës ose shërbimit.
Qeverisja e centralizuar dhe katalogu OneLake
Përvoja e qeverisjes së të dhënave është përmirësuar me një panel të ri të centralizuar në katalogun OneLake , ku pronarët e të dhënave mund të shohin një pamje të përmbledhur të artikujve që kanë krijuar, të marrin rekomandime për veprime qeverisjeje dhe të kenë qasje në të gjitha mjetet e disponueshme për të përmirësuar sigurinë dhe pajtueshmërinë.
Për më tepër, është aktivizuar një API kërkimi në katalogun OneLake së bashku me një mjet MCP, i cili lejon zbulimin e artikujve në të gjithë mjedisin Fabric nga kodi ose agjentët e IA-së, në një thirrje të vetme, duke respektuar lejet e katalogut dhe meta të dhënat.
Monitorimi i kapaciteteve, konsumit dhe punës
Pëlhura ofron disa shtresa vëzhgueshmërie:
- Monitorimi i hapësirës së punës, e cila krijon një bazë të dhënash në Fabric ku konsolidohen regjistrat dhe metrikat nga artikuj të shumtë (duke përfshirë punët e kopjimit me monitorim të detajuar).
- Monitorimi i hapësirës së punës për punën e kopjimitme metrika të tilla si rendimenti, vëllimi i të dhënave, kodet e gabimeve dhe kohët, të gjitha të orientuara drejt analizës së centralizuar.
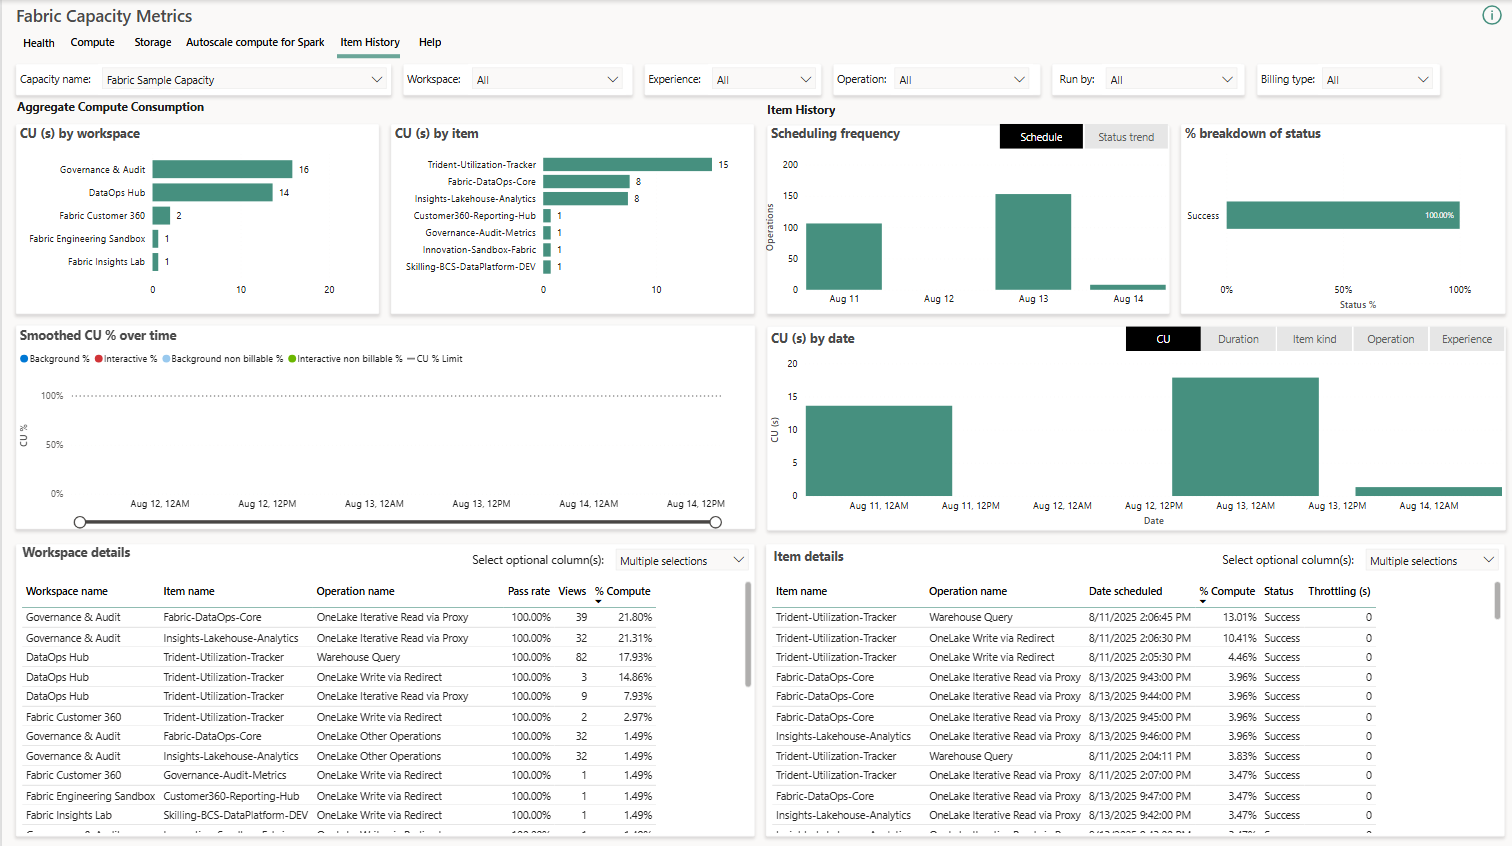
- Historia e Artikullit në zbatimin e metrikave të kapacitetit, me pamje 30-ditore mbi konsumin e CU-së për secilin artikull, të filtrueshme sipas hapësirës së punës dhe llojit.
- Mbrojtje nga mbingarkesa në nivelin e hapësirës së punësgjë që lejon vendosjen e pragjeve të konsumit për hapësirë pune në një dritare rrotulluese 24-orëshe, duke bllokuar automatikisht ato që i tejkalojnë ato dhe duke shënuar hapësirat e punës si "kritike për misionin" për t'i përjashtuar ato nga kufizimet.
Në plotësim të kësaj, po publikohet një grup fillestar i API-ve të Administratorit të Fabric , të përqendruara në zbulimin e hapësirave të punës, artikujve dhe detajeve të aksesit të përdoruesve, duke lehtësuar inventarët dinamikë dhe kontrollet periodike të aksesit.
Modelimi i biznesit, planifikimi dhe ngarkesat e reja të punës
Përtej shtresës teknike, Microsoft po prezanton ngarkesa të reja pune të orientuara drejt biznesit, përveç Fabric. Një nga më të dalluarit është Fabric IQ, i cili synon të unifikojë semantikën, të dhënat dhe modelet e biznesit për agjentët inteligjentë që marrin vendime bazuar në një pamje holistike të organizatës.
Brenda Fabric IQ do të gjeni:
- Ontologjia (pamje paraprake), një lloj artikulli ku entitetet, marrëdhëniet, vetitë dhe kufizimet përcaktohen sipas gjuhës së biznesit të kompanisë.
- Plani (pamje paraprake), një platformë pa kod për planifikim, raportim, analiza, integrim dhe menaxhim bashkëpunues.
Në Inteligjencën në Kohë Reale, shfaqet edhe ndërtuesi i binjakëve dixhitalë , një artikull i specializuar në modelimin e binjakëve dixhitalë bazuar në të dhëna në kohë reale, me qëllim optimizimin e operacioneve fizike, monitorimin e gjendjeve dhe simulimin e skenarëve.
Nga ana tjetër, ngarkesa e punës së Fabric IQ prezantohet si një ngarkesë e veçantë pune, dhe mjetet mbështetëse për qeverisjen dhe harmonizimin semantik vazhdojnë të zgjerohen, duke mbyllur rrethin midis modeleve të të dhënave, logjikës së biznesit dhe aplikacioneve të IA-së/analitikës.
Përmirësime të performancës, përvojës së përdoruesit dhe produktivitetit
Për të përfunduar shqyrtimin, ia vlen të theksohet një sërë përmirësimesh të tërthorta që nuk bëjnë gjithmonë bujë në media, por ndikojnë shumë në operacionet e përditshme të ekipeve.
Në seksionin Spark dhe informatikën e shpërndarë, Fabric prezanton:
- Fabric Runtime 2.0 (pamje paraprake) me Apache Spark 4.0, Delta Lake 4.0, Java 21, Scala 2.13 dhe Python 3.12 në Azure Linux 3.0.
- Mjet krahasimi i aplikacioneve Sparkqë ju lejon të zgjidhni dhe krahasoni deri në katër ekzekutime Spark paralelisht.
- Emitues diagnostikues i shkëndijave, i cili mbledh regjistra, metrika dhe ngjarje nga aplikacionet Spark dhe i dërgon ato në destinacione të tilla si Qendrat e Ngjarjeve, magazinimi ose Analitika e Regjistrit.
- Biblioteka e diagnostikimit të JobInsight, një bibliotekë për analizimin e ekzekutimeve të përfunduara të Spark nëpërmjet API-ve (pyetje, punë, faza, detyra, ekzekutues, regjistra ngjarjesh).
Në shtresën e depove, shtohet grupimi i të dhënave për të përmirësuar performancën dhe për të ulur kostot e aksesit, kolonat IDENTITY për çelësat zëvendësues, si dhe kontrolli i versioneve dhe mbështetja CI/CD përmes projekteve të Bazës së të Dhënave SQL në VS Code (kontrolli i burimit të depove).
Përvoja e përdoruesit të portalit Fabric po evoluon gjithashtu me shfletimin me skeda dhe një eksplorues objektesh , duke u lejuar përdoruesve të hapin shumë artikuj njëkohësisht dhe të kalojnë shpejt midis tyre. Kjo, së bashku me përmirësime të tilla si lidhja automatike e Lakehouse në Git dhe grupi i shërbimeve për mirëmbajtjen e Lakehouse (aktivitetet e mirëmbajtjes dhe rifreskimi i pikës fundore SQL), kontribuon në një platformë më miqësore për përdoruesit dhe më të shkathët.
Së fundmi, veçori të tilla si importimi/eksporti në masë i përkufizimeve të artikujve (për migrime, shabllone dhe kopje rezervë të meta të dhënave), REST për dosjet, mbështetja e parametrave në aktivizimet e artikujve nga Activator dhe ngarkimi i të dhënave OneLake në Excel me një katalog të integruar, plotësojnë një ekosistem që fillon të mbulojë praktikisht të gjitha nevojat e zakonshme të një ekipi modern të të dhënave.
Me të gjithë këtë grup aftësish - nga qeverisja e centralizuar, siguria e detajuar dhe orkestrimi inteligjent, deri te IA e integruar në SQL, analizat në kohë reale, binjakët dixhitalë dhe agjentët MCP - Microsoft Fabric po e vendos veten si një platformë e plotë të dhënash ku çelësi nuk është më vetëm ruajtja dhe vizualizimi i të dhënave, por qeverisja, automatizimi dhe shfrytëzimi i IA-së për të fuqizuar çdo pjesë të ciklit jetësor të të dhënave . Kjo u lejon organizatave të zhvillojnë gradualisht arkitekturat e tyre, duke migruar sistemet ekzistuese dhe duke mundësuar zgjidhje të reja shumë më shpejt sesa me qasjet tradicionale.