- Dallimet arkitekturore midis CPU-së dhe GPU-së që mundësojnë llogaritje masive paralele.
- Strategjitë e vendosjes në cloud duke përdorur modele standarde, spot dhe fleksibile të ofrimit të shërbimeve.
- Kritere teknike kritike për përzgjedhjen e pajisjeve bazuar në VRAM, gjerësinë e brezit dhe vonesën.
- Sisteme të përparuara programimi dhe orkestrimi global për të optimizuar përdorimin e klastereve të IA-së.

Kur flasim për fuqinë e papërpunuar për lëvizjen e maleve me të dhëna, është e pamundur të mos përmendim rolin themelor që luajnë njësitë e përpunimit grafik. Edhe pse fillimisht u projektuan për t'i bërë videolojërat të duken të pabesueshme, sot ato janë motori kryesor i inteligjencës artificiale dhe analizës masive të të dhënave, duke lejuar që detyrat që më parë zgjasin javë të përfundohen vetëm në pak orë.
Zhvendosja e këtyre ngarkesave të punës në cloud ka qenë një ndryshim rrënjësor për zhvilluesit dhe shkencëtarët e të dhënave. Nuk është më e nevojshme të shpenzojmë një pasuri për pajisje që bëhen shpejt të vjetëruara; në vend të kësaj, ne mund të marrim me qira fuqi llogaritëse të përshtatur sipas nevojave tona aktuale, duke shkallëzuar burimet sipas projektit dhe duke optimizuar çdo qindarkë të investuar në infrastrukturë.

CPU vs GPU: Cili është ndryshimi i vërtetë?
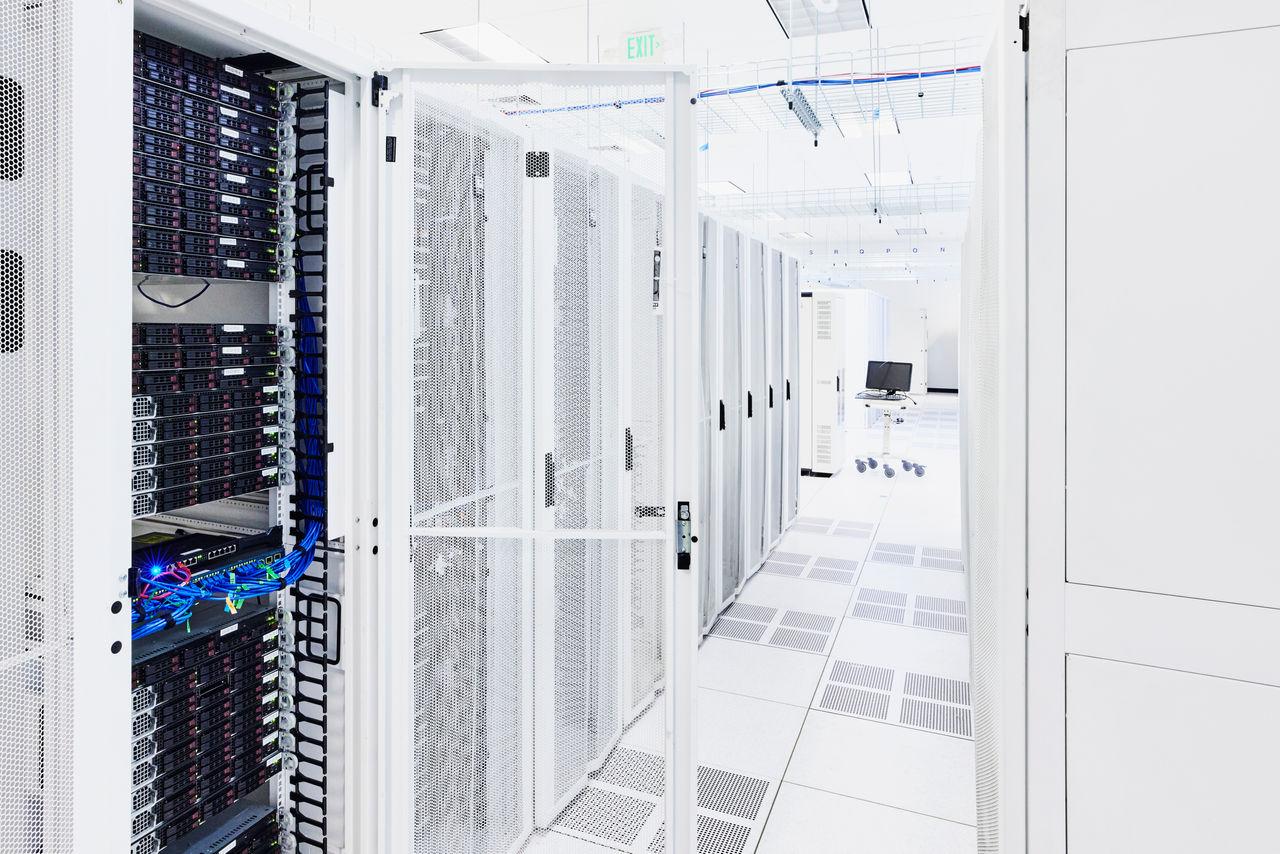
Thënë thjesht, CPU është si një përçues shumë inteligjent që mund të bëjë gjithçka, por përpunon detyrat njëra pas tjetrës. Në të kundërt, GPU është si një ushtri me mijëra punëtorë të specializuar në kryerjen e të njëjtit operacion matematikor vazhdimisht, por njëkohësisht. Kjo është baza e asaj që ne e quajmë llogaritje paralele.
Ndërsa CPU-ja trajton logjikë komplekse dhe kontroll të sistemit, GPU-ja shkëlqen në përpunimin e matricave dhe renderimin e imazheve. Falë qindra ose mijëra bërthamave të saj , të ngjashme me një arkitekturë CPU-je me shumë bërthama , por në një shkallë masive, ajo mund të ekzekutojë njëkohësisht nëngrupe të shumëfishta të një detyre - thelbësore për trajnimin e rrjeteve nervore ose përpunimin e terabajtëve të të dhënave pa u bllokuar sistemi.
Menaxhimi i punës në grup dhe në kohë reale
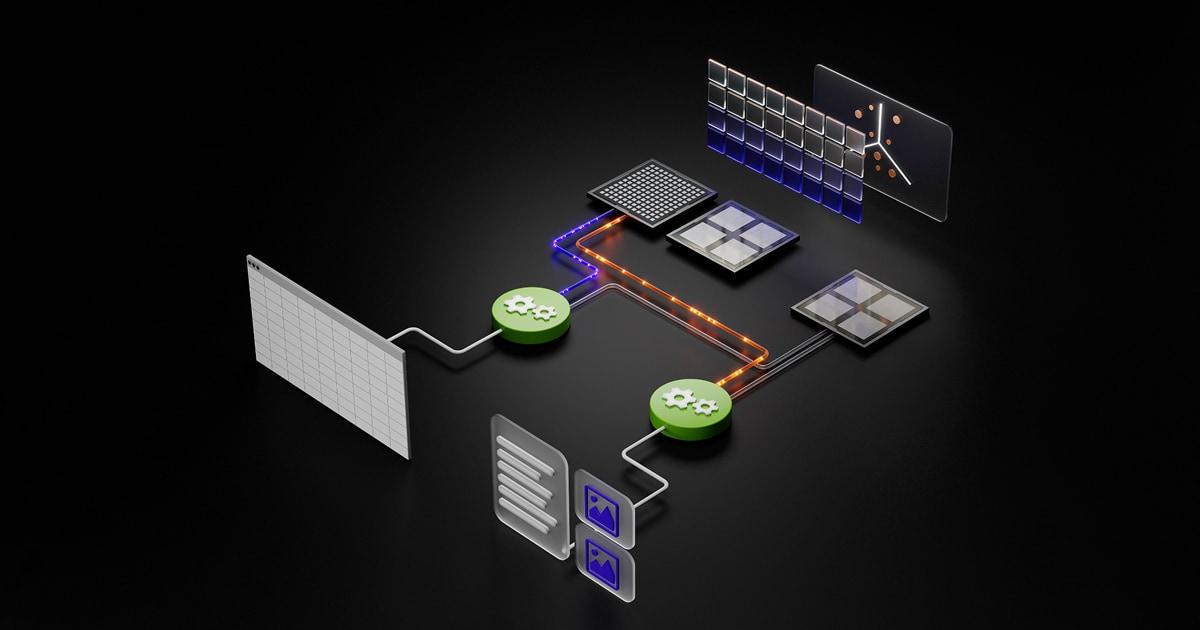
Në ekosistemin cloud, ekzistojnë dy mënyra kryesore për të kryer këto detyra. Përpunimi në grup është ideal për punët që nuk kërkojnë një përgjigje të menjëhershme, siç është përpunimi paraprak i të dhënave ose nxjerrja masive e inferencave. Këtu, qëllimi është të maksimizohet efikasiteti dhe performanca e përgjithshme e sistemit duke lejuar që punët të grumbullohen dhe të ekzekutohen kur burimet janë të disponueshme.
Nga ana tjetër, përpunimi në kohë reale është kritik për aplikacionet që duhet të përgjigjen menjëherë, siç janë chatbot-et gjeneruese të inteligjencës artificiale ose njohja e fytyrës. Në këto raste, përparësia absolute është vonesa e ulët dhe disponueshmëria e lartë, duke siguruar që përdoruesi përfundimtar të mos vërejë vonesa ndërsa modeli përpunon informacionin.
Për të ngritur një projekt si ky, planifikimi i kërkesave është thelbësor. Nga zgjedhja e makinës së duhur deri te instalimi i drajverëve (të cilët mund të jenë automatikë ose manualë duke përdorur imazhe të personalizuara), çdo hap ndikon nëse procesi është i qetë apo një problem teknik.
Modelet e konsumit dhe optimizimi i kostos
Jo të gjitha makinat virtuale janë krijuar të barabarta, dhe as nuk kushtojnë të gjitha njësoj. Për ata që duan të kursejnë para, makinat virtuale Spot janë një opsion joshës, duke ofruar zbritje të mëdha, megjithëse ato vijnë me rrezikun që cloud t'i rimarrë ato në çdo kohë. Ato janë perfekte për detyra tolerante ndaj defekteve ku kostoja është përparësia.
Nëse ju nevojitet diçka më e qëndrueshme, por me zbritje, ekzistojnë makina virtuale fleksibile për startup , të cilat lejojnë akses në burimet e GPU-së me çmime të reduktuara në këmbim të disa ditësh vonesë para se të fillojë puna. Për projektet kritike për misionin, opsionet janë sigurimi standard sipas kërkesës ose rezervimet e planifikuara , të cilat garantojnë që hardueri është aty pikërisht kur ju nevojitet.

Një teknikë e përparuar për maksimizimin e buxhetit është arbitrazhi rajonal i kostos . Shfrytëzimi i ndryshimeve të çmimeve nëpër zona gjeografike ose përdorimi i planifikimit "ndiq diellin" u lejon ekipeve në Azi, Evropë dhe Amerikë të përdorin me radhë grupet, duke arritur pothuajse 100% shfrytëzim të pajisjeve.
Si të zgjidhni GPU-në e duhur për rastin tuaj të përdorimit

Nuk ka të bëjë me zgjedhjen e kartës më të shtrenjtë, por me atë që i përshtatet më mirë detyrës. Në trajnimin e modelit të gjuhës së madhe (LLM) , memoria video (VRAM) është pengesa kryesore. Nëse ju mbaron VRAM, do t'ju duhet të zvogëloni madhësinë e grupeve, gjë që do të rrisë ndjeshëm kohën e ekzekutimit dhe kostot e përgjithshme.
- Trajnim për IA-në: Kërkon fuqi të lartë në precizion të përzier (FP16/BF16) dhe një VRAM të bollshëm për të trajtuar gradientët dhe gjendjet e optimizuesit.
- Përfundim në kohë reale: Këtu, vonesa e rrjetit dhe stabiliteti i paketës së softuerëve janë thelbësore për të parandaluar ndërprerjet e prodhimit.
- Shkenca e të Dhënave: Kërkohet një ekuilibër midis CPU-së, RAM-it dhe GPU-së, pasi pjesa më e madhe e pastrimit të të dhënave është ende një detyrë sekuenciale.
- Renderimi 3D dhe efektet vizuale: Ato varen në mënyrë kritike nga gjerësia e brezit të memories për të lëvizur shpejt tekstura dhe gjeometri komplekse.
- Llogaritjet Shkencore: Ata i japin përparësi saktësisë së FP32 ose FP64 dhe riprodhueshmërisë së saktë të rezultateve përmes versioneve fikse të drajverëve.
Është jetike të monitorohet rrjedha e të dhënave të sistemit . Të kesh një GPU ultra të fuqishme është e padobishme nëse CPU-ja ose hapësira e ruajtjes janë të ngadalta; në këtë rast, GPU-ja do ta kalojë pjesën më të madhe të kohës në gjendje pa punë, duke pritur për të dhëna, gjë që njihet si nënshfrytëzim i burimeve.
Orkestrimi i avancuar dhe e ardhmja e informatikës
Ndërsa klasteret rriten, planifikimi i thjeshtë "i pari që hyn, i pari që del" nuk funksionon më. Kompanitë kryesore po zbatojnë hierarki planifikimi me shumë nivele që shpërndajnë punët bazuar në vendndodhjen e të dhënave, përparësinë e biznesit dhe gjurmën e karbonit të rajonit.

Inovacione si ndërrimi i CPU/GPU në kohë reale i lejojnë sistemit të vendosë menjëherë se cili procesor është më efikas për secilën fije pune. Kjo adreson mungesën globale të harduerit duke optimizuar çdo cikël të disponueshëm të orës, duke i mundësuar inteligjencës artificiale gjeneruese dhe binjakëve dixhitalë të përparojnë pa u bllokuar nga mungesa e çipave.
Përdorimi i Kubernetes me teknologjinë e Alokimit Dinamike të Burimeve (DRA) dhe GPU-së me Shumë Instanca (MIG) po mundëson që një kartë grafike e vetme fizike të ndahet në instanca të shumta virtuale. Kjo demokratizon aksesin në informatikë me performancë të lartë, duke u lejuar përdoruesve të shumtë të ndajnë të njëjtën GPU pa ndërhyrë me njëri-tjetrin.
Të kesh një strategji të qartë që kombinon harduerin e duhur, një model të zgjuar pagese dhe orkestrim fleksibël është e vetmja mënyrë për të shmangur shpërdorimin e parave në cloud computing. Nga përzgjedhja e VRAM deri te vendosja e instancave Spot, çdo vendim teknik ndikon drejtpërdrejt në shpejtësinë e inovacionit dhe rentabilitetin e çdo projekti të avancuar informatik.
