- VibeVoice је Microsoft TTS модел способан да генерише дуг, експресиван звук са више звучника, идеалан за подкасте и аудио књиге.
- Његова архитектура комбинује токенизаторе говора, велики језички модел и дифузију како би се постигли природни гласови чак и у аудио снимцима дужине до 90 минута.
- Омогућава одговоре готово у реалном времену са малим варијацијама, али захтева одговорну употребу због ризика клонирања гласа и дипфејкова.
- Објављен је као истраживачки оквир отвореног кода, иако је Мајкрософт привремено ограничио спремиште због забринутости због злоупотребе.

Долазак Мајкрософтовог VibeVoice-а револуционише начин на који се подкасти и дугометражни аудио садржаји креирају помоћу вештачке интелигенције. Овај TTS (текст-у-говор) модел отвореног кода не само да генерише хиперреалистичне гласове, већ омогућава и продукцију разговора са више говорника и трајањем које може достићи и до 90 минута без незгодних прекида или падова у квалитету.
Циљ компаније VibeVoice је да свима пружи виртуелну кабину за снимање способну за професионалну продукцију подкаста, аудио књига или нарација са рачунара. Све што вам је потребно је скрипта и неко основно техничко знање за подешавање модела, а вештачка интелигенција ће се побринути за остало: интонацију, природност, промене гласа и континуитет током целог звука.
Шта је VibeVoice и зашто је толико важан за подкасте?
Модел је базиран на TTS (Text-to-Speech) технологији, што значи да директно трансформише текст у говор , али са нивоом течности и нијанси који веома подсећа на људски говор. VibeVoice је првобитно објављен у верзијама са параметрима 1.5B и 7B , дизајнираним да уравнотеже квалитет и могућност генерисања дугих аудио стримова без прекомерне потрошње ресурса.
Једна од његових највећих предности је могућност континуираног снимања до 90 минута звука , одржавајући конзистентност гласа и интонацију током целог снимања. Ово га чини посебно корисним за целе подкасте, поглавља аудио књига или дугачке епизоде образовног садржаја где је раније било потребно више сесија снимања са људским гласовним глумцима.
Штавише, VibeVoice је дизајниран да обрађује до четири различита гласа у једном аудио снимку , омогућавајући симулиране интервјуе, панел дискусије, дијалоге између ликова или епизоде које нарирају различити гласовни глумци. Ова могућност вишеструких звучника је кључна за то да подкасти засновани на вештачкој интелигенцији буду динамичнији и занимљивији.
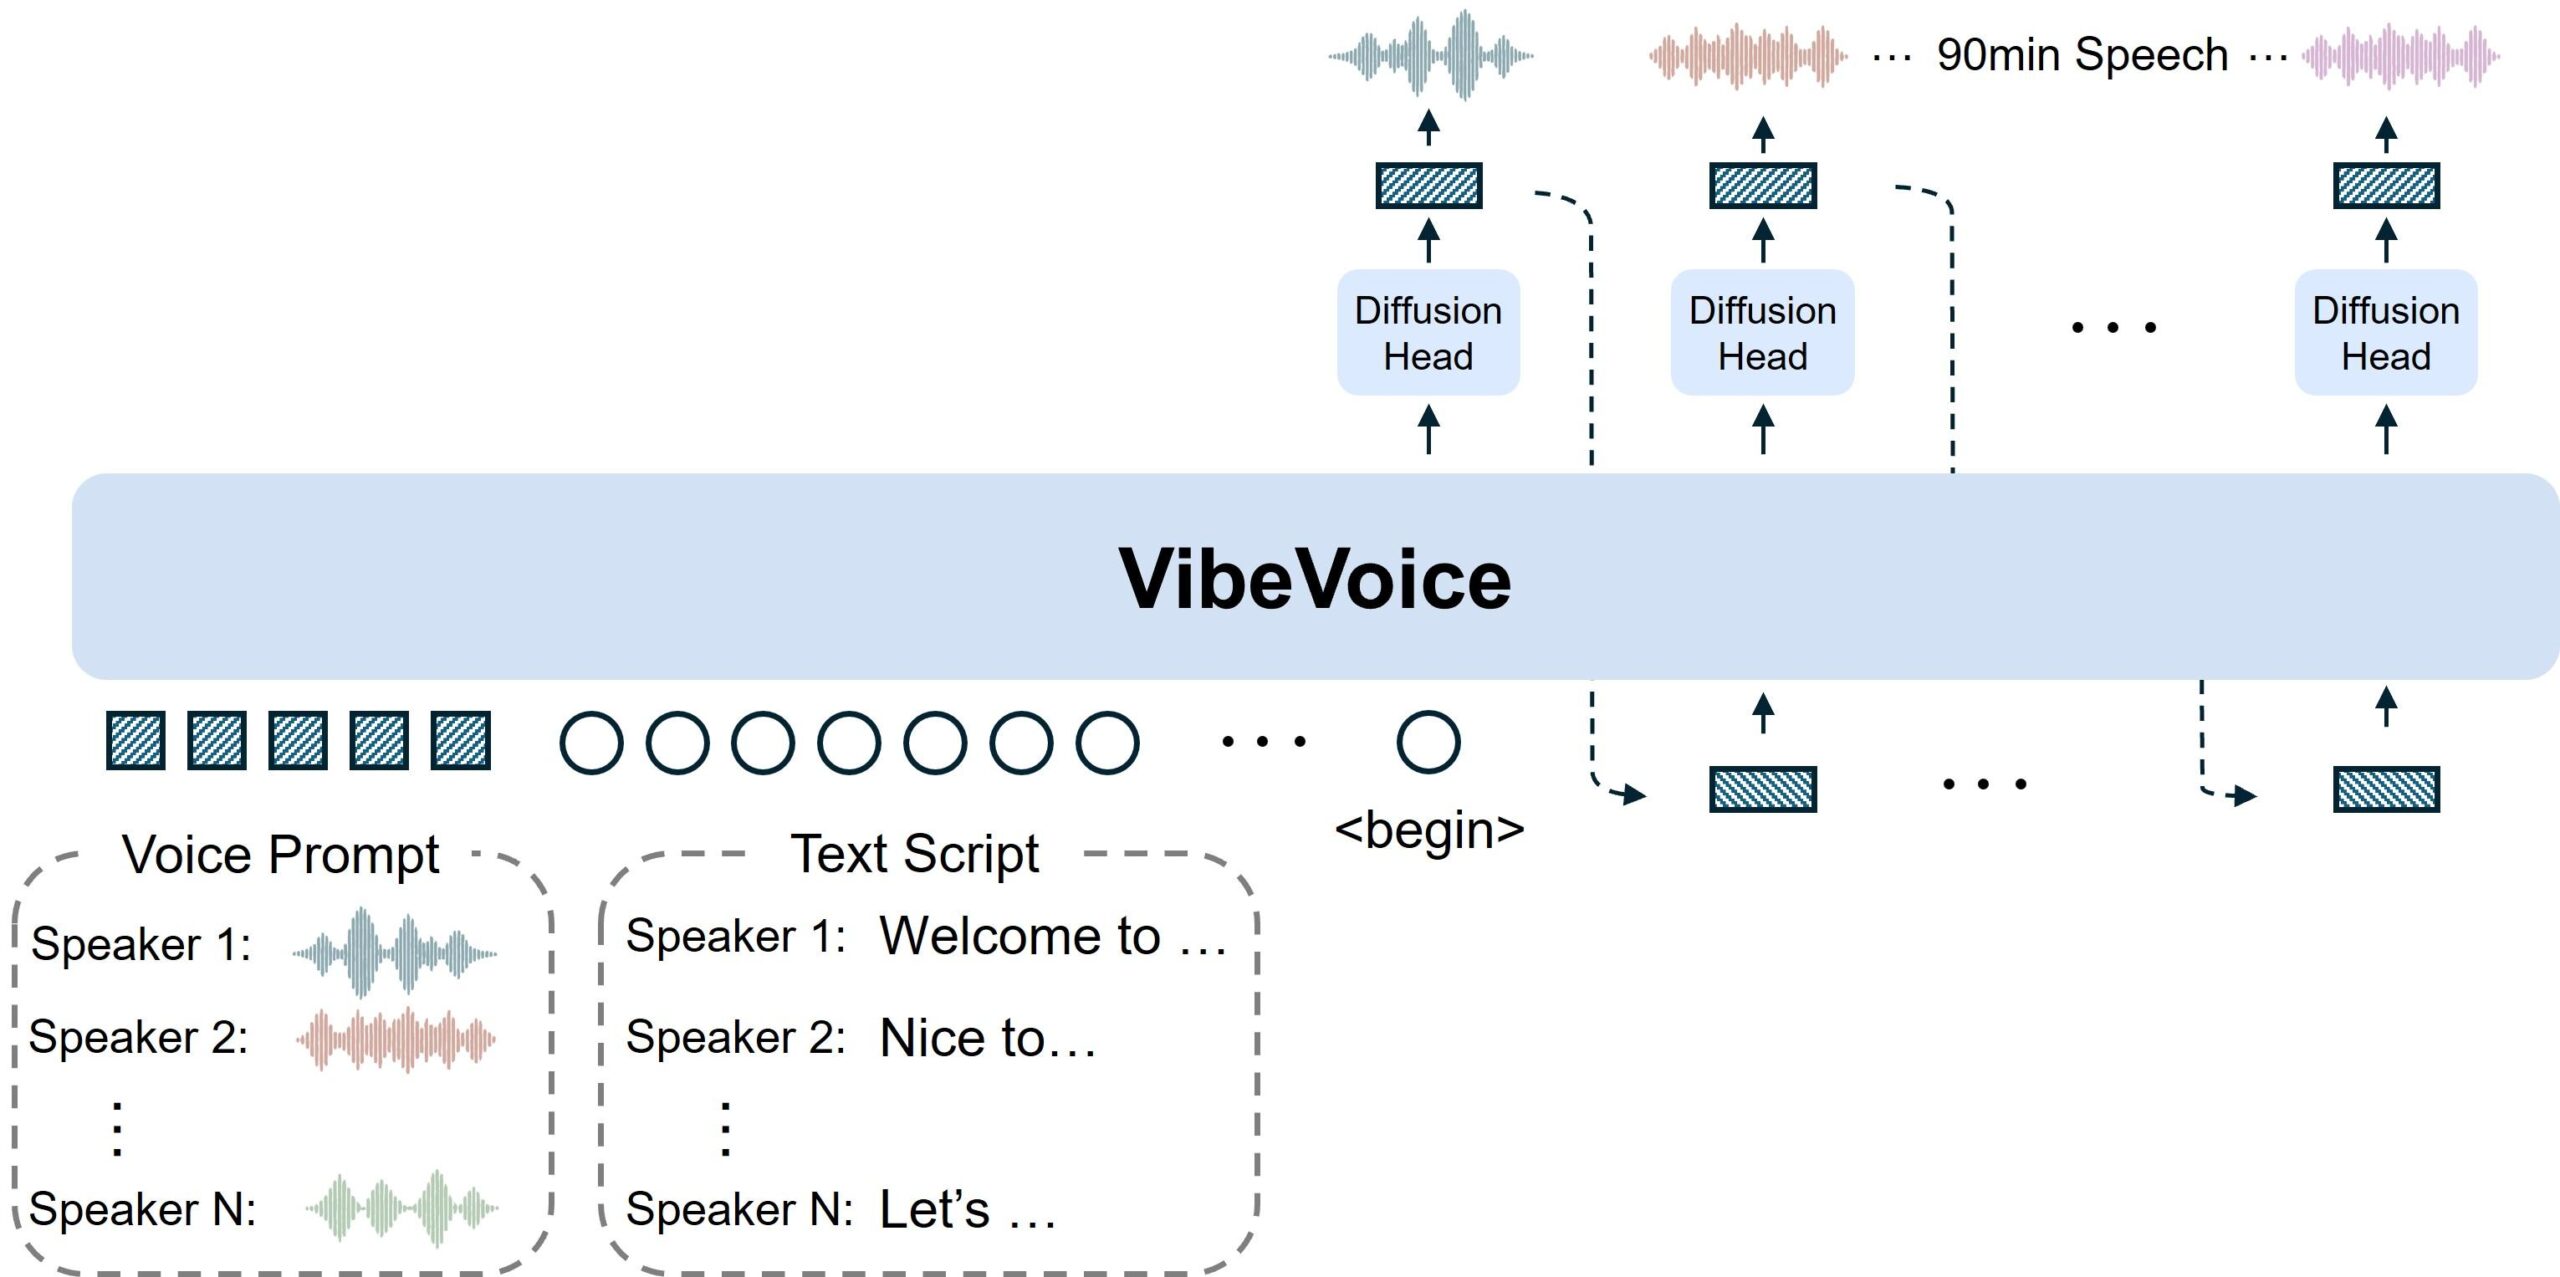
Како VibeVoice функционише: напредна синтеза говора и ниска латенција
Поред упечатљивог наслова, оно што VibeVoice чини посебним јесте његова техничка архитектура дизајнирана за дуге аудио снимке и разговоре . Мајкрософт комбинује неколико компоненти како би глас звучао природно, прилагодио се тексту и генерисао се у реалном времену или близу њега.
Систем користи континуиране акустичке и семантичке токенизаторе говора који раде на веома ниској фреквенцији, око 7,5 Hz. То значи да кондензује аудио информације у мање „корака“ у секунди него други модели, чувајући верност звука и значајно смањујући трошкове рачунања при раду са дугим секвенцама.
Поред ове компресоване репрезентације, на сцену ступа велики језички модел (LLM) , који је одговоран за тумачење садржаја скрипте, тока разговора и ко говори у датом тренутку. На овај начин, разуме да ли је у питању питање, одговор, ироничан коментар или промена теме и сходно томе прилагођава гласовни излаз.
Коначно, дифузиона глава се користи за реконструкцију висококвалитетних акустичних детаља: тембра, вокалне текстуре, суптилног дисања и других нијанси. Ова комбинација LLM + дифузије осигурава да је резултујући звук конзистентан, експресиван и пријатан за слушање током дужег временског периода.
Паралелно са тим, Мајкрософт је лансирао специфичну варијанту под називом VibeVoice-Realtime-0.5B , дизајнирану за изузетно брзе одговоре: овај модел може почети да емитује глас око 300 милисекунди након пријема текста. То јест, практично у реалном времену, идеално за гласовне агенте, конверзацијске асистенте или апликације где латенција мора бити минимална.
Доступне верзије: модели, параметри и препоручена употреба
У оквиру VibeVoice екосистема, представљено је неколико верзија са различитим величинама и оријентацијама модела , дизајнираних и за дуге аудио и за интерактивне апликације.
С једне стране, имамо главне варијанте са параметрима од 1.5B и 7B , дизајниране за обраду опсежног садржаја као што су комплетни подкасти, симулирани радио програми, поглавља аудио књига или аудио курсеви. Већи број параметара омогућава већи капацитет за снимање нијанси и управљање сложеним дијалозима, иако такође повећава хардверске захтеве.
С друге стране, верзија VibeVoice-Realtime-0.5B даје приоритет брзини одзива у односу на величину модела. Иако има „само“ 0,5 милијарди параметара , што је скромна количина у поређењу са гигантима попут ChatGPT-а или Gemini-ја, управо то јој омогућава да генерише до 90 минута непрекидног звука уз одржавање јасног гласа и стабилне интонације.
Ова варијанта у реалном времену је посебно атрактивна за гласовне агенте, четботове, виртуелне асистенте и било коју апликацију где корисник очекује да вештачка интелигенција одмах одговори гласом, а не само текстом. Са латенцијама близу 300 мс, искуство је веома слично разговору са неким са друге стране.
У свим случајевима, модел је намењен за употребу из локалних или истраживачких окружења , пошто је Мајкрософт првобитно одлучио да га објави као пројекат отвореног кода, доступан са ГитХаба и платформи попут Хугинг Фејса, што заједници олакшава тестирање, прилагођавање и изградњу алата на основу њега.
Практичне примене: како креирати подкаст помоћу VibeVoice-а
Једна од водећих апликација VibeVoice-а је несумњиво креирање подкаста без потребе за људским гласовним глумцима . За свакога ко има идеје, сценарије или писани садржај, али се не усуђује да стане пред микрофон, овај модел отвара огромну прилику.
Општи ток рада за продукцију подкаста помоћу VibeVoice-а обично укључује припрему добро структурираног сценарија : увод, блокове садржаја, потенцијалне интервјуе (стварне или измишљене), прелазе и завршетак. Што је текст јаснији, модел боље може да ухвати промене у тону, паузе и улоге сваке „особе“ у разговору.
Затим, коришћењем алата изграђених на моделу (скрипти, графичких интерфејса или интеграција са другим апликацијама), сваки део текста се додељује једном од доступних говорника . Можемо, на пример, користити један глас за презентера, други за госта који се стално јавља, трећи за питања која се читају из публике и четврти за информативне белешке или спонзорисане сегменте.
Модел генерише континуирани звук поштујући редослед сценарија, гласовне прелазе и ритам разговора. Одатле се резултат може усавршити у традиционалном аудио едитору, додавањем позадинске музике, звучних ефеката, прелаза или мањим подешавањима јачине звука и изједначавања.
Захваљујући могућности генерисања до 90 минута садржаја без губитка кохерентности , можемо креирати комплетну епизоду одједном: нема потребе за снимањем у малим блоковима или бригом о замору гласа, грешкама у дикцији или позадинској буци, нечему што је у физичкој кабини стална главобоља.
Клонирање гласа помоћу вештачке интелигенције и персонализација гласа
Један од најделикатнијих, али и најмоћнијих напредака у овој технологији је „клонирање гласа“ или клонирање гласа засновано на вештачкој интелигенцији . Оно укључује технике синтезе засноване на дубоком учењу које омогућавају репликацију тембра, говорних образаца и нијанси одређеног гласа.
У пракси, ови системи анализирају јединствене карактеристике циљног гласа, као што су тембар, форманти, ритам говора и прозодијски обрасци (паузе, акценти, упитна интонација итд.). Са само неколико секунди семпла, они су у стању да генеришу синтетички глас који веома подсећа на оригинал.
У случају VibeVoice-а, помиње се да је могуће постићи веома прецизне симулације са само 10 секунди оригиналног звука , прилично добро хватајући емоционални утицај и текстуру гласа. За подкаст, ово отвара могућности као што је одржавање „гласа бренда“ чак и након што је права особа престала са снимањем или креирање понављајућих ликова са доследним вокалним идентитетом.
Међутим, ова могућност долази са веома озбиљним етичким ризицима и потребом за детекцијом синтетичког звука :
Из тог разлога, Microsoft наглашава да се VibeVoice објављује у оквиру истраживања и са јасним упозорењима: не треба га користити за крађу идентитета, превару, манипулацију или кампање дезинформисања. Одговорна употреба је кључна компонента целог овог екосистема.
Предности за креаторе садржаја и мале пројекте
Са рачунаром који може да покрене модел и мало времена за писање сценарија, могуће је претворити дугачке текстове у професионални аудио за само неколико минута. Ово се односи на информативне подкасте, вести, фиктивне приче, серијске романе или чак наративне техничке приручнике.
Такође је од велике помоћи у рециклирању постојећег писаног садржаја : чланци на блоговима, билтени, дискусије на друштвеним мрежама или извештаји могу се трансформисати у аудио епизоде које проширују домет поруке и нуде практичнији начин за оне који више воле да слушају него да читају.
Још једна предност је конзистентност квалитета током времена . Док људски гласовни глумац може да мења енергију, интонацију или јасноћу у зависности од дана, вештачка интелигенција одржава константан ниво, што олакшава серијску продукцију: неколико епизода снимљених у једном покушају задржаће исто присуство и стил гласа.
У области образовања, VibeVoice је савршен за аудио курсеве, вођена читања и приступачне материјале за особе са оштећеним видом или оне који једноставно више воле да уче слушајући док обављају друге задатке. Могућност генерисања говорних верзија лекција или дугачких докумената нуди мноштво могућности.
Ризици, ограничења и Мајкрософтова одлука у вези са репозиторијумом
Друга страна медаље је да вештачка интелигенција способна да имитира људске гласове и генерише реалистичан говор покреће озбиљне етичке и безбедносне проблеме. Ризик од злонамерне употребе је реалан, а велике технолошке компаније су све више свесне тога.
У самом тексту о лансирању, Мајкрософт експлицитно наводи да се VibeVoice не сме користити за дипфејкове, крађу идентитета или илегалне активности . Такође директно забрањује његову употребу у контекстима дезинформација или превара, управо зато што би његов ниво реализма могао лако да обмане неопрезне слушаоце.
Иако је глас који генерише веома убедљив, творци модела истичу да он и даље не обухвата све суптилности правог људског гласа : дисање, емоционалне микро-варијације, одређене природне паузе и промене ритма су и даље богатије код особе него код вештачке интелигенције. Ова „несавршеност“ може делимично помоћи да се открије да имамо посла са синтетичким гласом, али граница постаје све замагљенија.
Након објављивања пројекта као истраживачког оквира отвореног кода , Мајкрософт је открио случајеве у којима је модел коришћен на начине који нису били у складу са његовом првобитном намером и принципима одговорне употребе. Као одговор, компанија је објавила да је била приморана да привремено онемогући спремиште док не буде могла да осигура да се ове употребе ван домета више не могу дешавати.
У саопштењу се наглашава да је одговорно коришћење вештачке интелигенције основни принцип за Мајкрософт и да они више воле да паузирају и прегледају него да одржавају алат који би могао да олакша озбиљну злоупотребу. Упркос томе, документација, демонстрације и технички материјали су већ послужили да инспиришу заједницу и наставе да унапређују област синтезе говора.
Друге примене поред подкастинга
Иако је медијска пажња првенствено усмерена на подкасте, VibeVoice отвара прилично широк спектар случајева употребе у свету звука генерисаног вештачком интелигенцијом. Многи од њих се такође уклапају у стратегије дигиталног садржаја и аутоматизације.
Један од најочигледнијих примера су аудио књиге и наративне приче , где је кључно имати изражајне гласове способне да држе пажњу десетинама минута. Могућност вишеструких звучника омогућава сваком лику да има свој глас, што значајно побољшава искуство слушања у поређењу са једним наратором.
У области гласовних агената и конверзационих асистената, VibeVoice-ова верзија у реалном времену је идеална. Бот који одговара са кашњењем од само 300 ms делује много природније од оног коме је потребно неколико секунди да проговори, што чини интеракције са корисничком службом, четботовима или гласовним интерфејсима много глаткијим.
Још једно веома занимљиво подручје је аутоматизовани садржај : резимеи вести, ажурирања тржишта, периодични извештаји или чак читања и обавештења е-поште могу се генерисати без људске интервенције, одржавајући тон у складу са имиџом бренда.
Коначно, постоје експерименталније примене, као што је креирање фиктивних дијалога, симулираних интервјуа или забавних програма које је у потпуности креирала вештачка интелигенција . Овде се језички модели за писање сценарија комбинују са VibeVoice-ом за гласовну глуму, што резултира форматима који су недавно изгледали као научна фантастика.
Гледајући целу слику, VibeVoice се истиче као кључни играч у новом таласу звука генерисаног вештачком интелигенцијом , способан да комбинује природне гласове, разговоре са више учесника, веома дуге аудио клипове и готово тренутне одговоре. Коришћен одговорно и у оквиру утврђених етичких граница, може постати невероватно моћан алат за свакога ко жели да покрене или скалира подкаст, произведе аудио књиге или дода професионалну гласовну подршку својим дигиталним пројектима, а да се увек не ослања на традиционални студио за снимање.

Индекс
- 1 Шта је VibeVoice и зашто је толико важан за подкасте?
- 2 Како VibeVoice функционише: напредна синтеза говора и ниска латенција
- 3 Доступне верзије: модели, параметри и препоручена употреба
- 4 Практичне примене: како креирати подкаст помоћу VibeVoice-а
- 5 Клонирање гласа помоћу вештачке интелигенције и персонализација гласа
- 6 Предности за креаторе садржаја и мале пројекте
- 7 Ризици, ограничења и Мајкрософтова одлука у вези са репозиторијумом
- 8 Друге примене поред подкастинга