- Нативни омнимодални модел са текстом, сликом, звуком и видеом и стримовањем у реалном времену.
- SOTA у 22/36 аудио/видео бенчмарк тестовима и вишејезично (119/19/10 језика).
- Архитектура Мислилац–Говорник са MoE, ниском латенцијом и контролом системских промптова.
- Препоручено имплементирање са vLLM/Transformers, Docker и званичним услужним програмима.
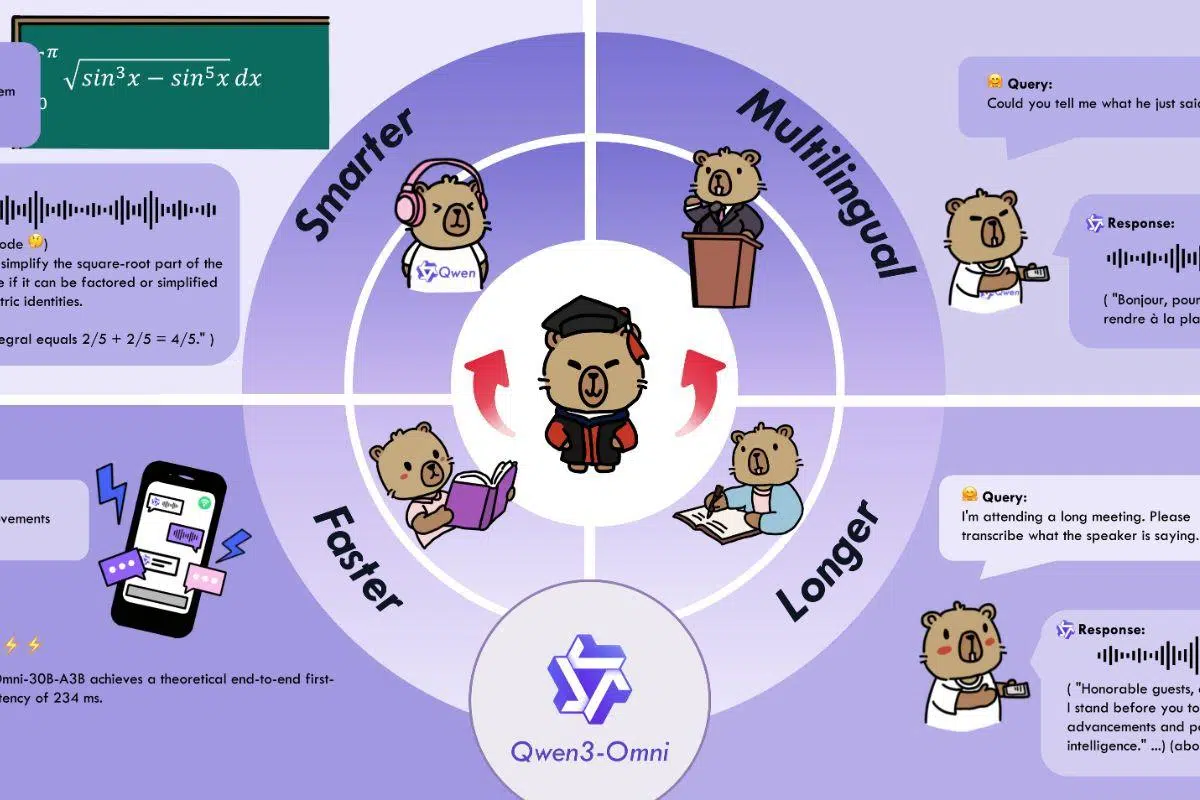
Долазак Qwen3-Omni је променио пејзаж вештачке интелигенције: један изворни модел способан да разуме и реагује на текст, слике, звук и видео , са одговорима у ходу, како у писаном тако и у усменом облику. Не говоримо о мултимодалним „закрпама“, већ о фундаментално дизајнираној архитектури за интеграцију модалитета са ниском латенцијом и фино подешеном контролом понашања.
У време када скоро сви тестирају четботове и асистенте, Qwen3-Omni стиже са амбицијом: подржава 119 језика путем текста, препознаје говор на 19 и говори на 10 језика , разуме дуге аудио записе (до 30 минута) и може се похвалити резултатима у десетинама тестова. Штавише, његов дизајн „Мислилац-Говорник“ и приступ „Мешавина стручњака“ циљају на брзину одзива и квалитет расуђивања у реалним сценаријима.
Шта је Qwen3-Omni и шта нуди?
Qwen3-Omni је породица основних, омнимодалних и свеобухватних вишејезичних модела дизајнираних за обраду текста, слика, звука и видеа, са излазом и у тексту и у природном говору. Кључ лежи не само у разноврсности улаза и излаза, већ и у функционалности стримовања са флуидним конверзационим окретима и могућношћу тренутног одговора.
Тим је увео неколико архитектонских побољшања за перформансе и ефикасност: рану претходну обуку „прво текст“ комбиновану са мешовитом мултимодалном обуком и дизајн са мешавином стручњака (MoE) који одржава своје перформансе у тексту и слици, а истовремено побољшава звук и видео. Са овим побољшањима, модел постиже SOTA у 22 од 36 аудио/видео бенчмаркова и SOTA отвореног кода у 32 од 36, са резултатима упоредивим са Gemini 2.5 Pro у ASR-у, разумевању звука и говорном разговору.
Кључне могућности и модалитети
Qwen3-Omni је спреман за аудио, видео и аудиовизуелне примене у стварном свету, са широком вишејезичном подршком: 119 језика за текст, 19 језика за гласовни унос и 10 језика за гласовни излаз . Језици за гласовни унос укључују енглески, кинески, корејски, јапански, немачки, руски, италијански, француски, шпански, португалски, малајски, холандски, индонежански, турски, вијетнамски, кантонски, арапски и урду; а излазни језици укључују енглески, кинески, француски, немачки, руски, италијански, шпански, португалски, јапански и корејски, између осталих.
Званични куварски пакет илуструје ширину његове употребе. У аудио формату, приказује вишејезично и дуготрајно препознавање говора (ASR) , претварање говора у текст и говора у говор, анализу музике (стил, ритам, жанрови), опис звучних ефеката и титловање било ког аудио записа . Такође подржава мешовиту анализу нумера са говором, музиком и амбијенталним звуцима.
У области вида, нуди „тешко“ оптичко препознавање знања (OCR) за сложене слике, детекцију и уземљење објеката , проверу квалитета слике, решавање математичких задатака слике (где модел размишљања блиста), опис видеа, навигацију из видеа из првог лица и анализу прелаза између сцена . У аудиовизуелним сценаријима, демонстрира проверу квалитета звука и видеа са временским усклађивањем, вођену интеракцију са AV улазима и дијалоге са понашањем асистента.
Као агент, истиче се својом способношћу да функционише позивањем из звука , што отвара гласовне токове рада који активирају алате, а у изведеним задацима постоји Омни-Каптионер за титловање са великим детаљима, што показује генерализацију основног.
Мислилац-говорник Архитектура и дизајн са Министарством просвете
Једна од кључних разлика је подела одговорности: Мислилац генерише текст (са варијацијама које укључују експлицитно резоновање о току мисли), а Говорник производи звук у реалном времену . Ово раздвајање омогућава природни гласовни разговор док систем одржава висок ниво разумевања текста и планирања.
База података Министарства просвете распоређује радно оптерећење међу стручњацима и ослања се на претходну обуку за аутоматско учење (AuT) за снажне опште репрезентације. Штавише, употреба вишекодног кодирања у аудио каналу смањује латенцију на минимум, што је кључно за позиве или асистенте где је свака стотина секунде битна.
Перформансе и бенчмаркови: текст, визуелни приказ, аудио и аудиовизуелни садржај
Qwen3-Omni одржава врхунске перформансе текста и слика без деградације у поређењу са Qwen моделима сличне величине фокусираним на један режим, док у аудио и аудиовизуелним перформансама поставља темпо у већини тестова . У батерији од 36 аудио и аудиовизуелних бенчмаркова, постиже отворени код SOTA у 32 и укупни SOTA у 22, надмашујући Gemini 2.5 Pro и GPT-4o у неколико тачака.
Неки значајни достигнући у тексту: у AIME25 варијанта Flash-Instruct постиже резултат од око 65,9; у ZebraLogic- у Instruct достиже 90, а у MultiPL-E постиже конкурентне резултате у односу на GPT-4o. У задацима поравнања као што су IFEval и WritingBench, модели Instruct и Thinking показују високе и конзистентне резултате.
У аудио снимцима, резултати ASR-а за кинески и енглески језик су одлични: у WenetSpeech- у и LibriSpeech-у, значајно се смањује стопа грешака у речима, са бројкама близу 1,22/2,48 у LibriSpeech clean/other, а у сетовима попут FLEURS-а (вишејезични), нуди веома ниске стопе. У VoiceBench-у, метрике као што су AlpacaEval, CommonEval и WildVoice стављају Qwen3-Omni у ранг са затвореним референтним системима, а истиче се у аудио резоновању у MMAU v05.15.25.
У аудиовизуелним апликацијама, најчешће цитирана метрика је WorldSense (приближно 54,1 ), надмашујући Gemini-2.5-Flash. Штавише, у пакетима као што су DailyOmni и VideoHolmes, варијанта Thinking постиже побољшања у односу на претходне SOTA системе отвореног кода. У чистом виду, истиче се у MMMU, MathVista, MathVision и разумевању докумената (AI2D, ChartQA), са веома добрим резултатима у бројању (CountBench) и разумевању видеа (Video-MME, MLVU).
Такође је мерено генерисање гласа са нултим бројем гласова: у поређењу са породицама као што су CosyVoice и Seed-TTS, Qwen3-Omni показује бољу конзистентност садржаја на више језика и високу сличност говорника . У вишејезичном одељку, табеле „Конзистентност садржаја“ и „Сличност говорника“ показују да је Qwen3-Omni 30B-A3B веома конкурентан на кинеском и енглеском језику, а солидан на немачком, италијанском, португалском, шпанском, јапанском, корејском, француском и руском језику. У међујезичном TTS-у , постиже бољу WER/конзистентност на неколико парова (нпр. zh→en, ja→en, ko→zh) у поређењу са CosyVoice 2/3.
Доступни модели и за шта се сваки од њих користи
Линија Qwen3-Omni укључује три главна дела, сваки дизајниран за одређену употребу: Instruct , Thinking и Captioner . Сви они потичу из истог језгра, али са различитим могућностима активираним или фино подешеним за одређене задатке.
Qwen3-Omni-30B-A3B- Instruct садржи Thinker и Talker, прихвата аудио, видео и текст и враћа текст и аудио. То је прави избор ако желите потпуну интеракцију и говорне резултате у реалном времену и препоручује се за гласовне или видео демонстрације .
Qwen3-Omni-30B-A3B- Размишљање се фокусира на Мислиоца са ланчаним резоновањем , подржавајући аудио, видео и текст са текстуалним излазом. Користан је за детаљну анализу, решавање сложених проблема, визуелну математику или радне процесе где вам није потребан гласовни излаз , али вам је потребно најбоље структурирано размишљање.
Qwen3-Omni-30B-A3B- Captioner је префињени дериват високопрецизног титловања звука са ниском хиперактивношћу . Отвореног је кода, покрива широк спектар звука са великим детаљима и попуњава историјску празнину у екосистему отвореног кода: поуздани и богати титлови за аудио опште намене.
Латенција, реално време и контрола понашања
Систем је оптимизован за тренутну интеракцију, са временима одзива од приближно 211 ms за аудио и 507 ms за аудио-видео . Поред стримовања, нагласак је стављен на природне конверзационе окрете и стабилну гласовну испоруку, чему доприносе јасне улоге Мислиоца (текст) и Говорника (глас).
За фино подешавање, можете прилагодити стил помоћу системских упутстава . У AV сценаријима где се видео звук користи као референца, тим предлаже системско упутство које одржава размишљање Мислиоца, а истовремено пружа читљивији и разговорнији текст, што Говорнику олакшава течни говор . Такође се препоручује да параметар `use_audio_in_video` буде доследан током вишеструког разговора.
Приликом евалуације постоје специфичне смернице: не постављајте системски упит , пратите ChatML формат сваког бенчмарка и, када нема упита, користите следеће подразумевано: кинески ASR („请将这段中文语音转换为纯文本。“), ASR за друге језике („Транскрибујте аудио у текст.“), S2TT („Слушајте дати <изворни_језик> говор…“) и текст песме („ Транскрибујте текст песме“… без интерпункције, редови одвојени преломима“).
Распоређивање, захтеви и алати
За потпуно локално искуство, тим препоручује Hugging Face Transformers и преглед фаза софтверског инжењеринга , али имајте на уму: будући да је MoE архитектура, може споро да ради са HF инференцијом; за производњу или апликације са малом латенцијом , саветују коришћење vLLM-а или DashScope API-ја , па чак и пружају Docker слику која укључује окружења за оба. Transformers код је већ спојен, али PyPI пакет још није објављен и мора се инсталирати из изворног кода.
Они пружају услужне програме за руковање звуком и сликама/видеом (base64, URL-ови, испреплетени улази) и препоручују FlashAttention 2 са Transformers-има за смањење GPU меморије при сваком учитавању у float16 или bfloat16 . Са vLLM, FlashAttn2 је укључен, а параметри као што су limit_mm_per_prompt (претходно додељује GPU меморију) и max_num_seqs за паралелизам су детаљно описани ; поред тога, повећање tensor_parallel_size омогућава закључивање са више GPU-ова.
Постоје неки корисни савети за уштеду ресурса: ако вам није потребан звук, можете онемогућити Talker након иницијализације, чиме ћете уштедети приближно 10 GB VRAM-а. А ако желите бржи излаз текста, користите `return_audio=False` током генерисања. Такође су дати минимални теоријски захтеви за меморију за BF16 са FlashAttn2: на пример, Instruct 30B-A3B користи приближно 78,9 GB са 15 секунди видеа и 144,8 GB са 120 секунди; Thinking користи приближно 68,7 GB и 131,7 GB, респективно.
Да бисте подесили локалну веб демонстрацију , препоручују припрему вашег vLLM окружења (или споријег Transformers окружења), осигуравање да имате инсталиран ffmpeg и коришћење њихових скрипти. Нуде Docker слике спремне за GPU „qwenllm/qwen3-omni“ са NVIDIA Container Toolkit-ом , мапирањем портова (нпр. хост 8901 → контејнер 80) и опцијом за сервирање од 0.0.0.0. Можете поново да уђете у контејнер или да га избришете када је потребно.
Демо верзије, API-ји и екосистем
Ако не желите да имплементирате локално, можете испробати демо верзије на Hugging Face Spaces и ModelScope Studio , са искуствима за Qwen3-Omni-Realtime, Instruct, Thinking и Captioner. Qwen Chat са стримовањем у реалном времену је такође доступан: једноставно изаберите опцију гласовног/видео позива у интерфејсу.
За скалабилну интеграцију са малом латенцијом, препоручени приступ је DashScope API , који нуди најпредвидљивије перформансе. Штавише, заједница координира путем канала као што су Discord и WeChat и објављује куваре са стварним евиденцијама извршавања које омогућавају корисницима да репродукују резултате променом упита или модела.
План рада и континуирана побољшања
Тим ради на додатним функцијама као што су препознавање говора више говорника , OCR примењен на видео, побољшања проактивног аудиовизуелног учења и богатији токови рада агената . Такође су назначили да ће подршка за аудио излаз у vLLM-у за Instruct модел ускоро бити доступна, чиме ће се завршити циклус имплементације у реалном времену из тог бекенда.
Најчешћа питања: Подршка за време извршавања и квантизација
Неки корисници су пријавили да не могу да покрену Qwen3-Omni чак ни са уобичајеним сумњивим програмима и да не виде квантне функције у Hugging Face-у ; штавише, изворни 16-битни формат је око 70 GB, величина која је проблематична за скромне рачунаре. Сам пројекат појашњава да је Transformers већ спојен, али без PyPI пакета , који се мора инсталирати из изворног кода, и да је vLLM преферирана опција за инференцију, иако ће подршка за Instruct аудио у vLLM-у ускоро бити објављена.
Што се тиче квантизације, у HF још увек нема наведених резервисаних кодова за Qwen3-Omni 30B-A3B, и вреди запамтити да MoE и мултимодална природа компликују непосредну компатибилност са runtime-овима као што је llama.cpp. За оне којима је потребно тестирање сада, званична препорука је да користе Docker + Transformers/vLLM из изворног кода или API-ја и да прате репозиторијум за захтеве за подршку и будуће квантизације када буду доступне.
Добре праксе и подстицаји за евалуацију
Да би се репродуковали бројеви, детаљно су описане следеће смернице: већина бенчмаркова користи похлепно декодирање у Instruct без узорковања, а за Thinking, параметри у generation_config.json морају се поштовати . Брзина кадрова у секунди видеа је такође подешена на fps=2 током евалуације и назначено је да кориснички упит треба да прати мултимодалне податке, осим ако скуп података не наводи другачије.
Када бенчмарк не укључује упит, могу се користити подразумевани упити (кинески ASR/остало, S2TT, текстови песама). Поред тога, системски упит не треба подешавати током евалуације како би се осигурало да су резултати упоредиви између система и покретања.
Qwen3-Omni се позиционира као права омнимодална платформа, са ниском латенцијом, широком вишејезичном подршком, најсавременијим аудио и видео могућностима и јасним путем имплементације користећи Transformers, vLLM и Docker. За оне који траже јединствени модел који беспрекорно обрађује текст и слике без жртвовања перформанси, а који такође слуша, говори и разуме видео , то је предлог који је данас тешко победити.