- Kärnminnesdumpar registrerar systemtillståndet vid kritiska fel och är viktiga för felsökning och säkerhetsgranskning.
- I Windows analyseras de med WinDbg eller KD, med hjälp av symboler och kommandon som !analyze -vy .bugcheck för att lokalisera drivrutiner och orsaker till felet.
- I Linux låter verktyg som crash, LiME och gcore dig extrahera och studera kärn- och processdumpar, med särskild vikt vid att skydda känsliga data.
- FreeBSD och andra Unix-system kräver kärnor kompilerade med symboler och användning av kgdb, och förlitar sig alltid på dokumentation och källkod för att tolka resultaten.
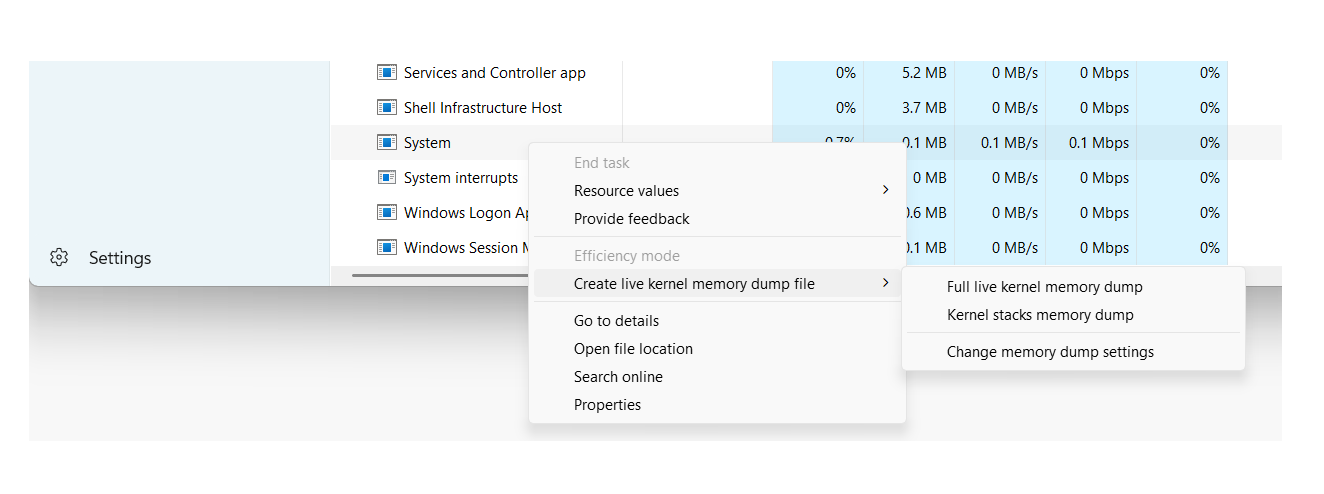
När ett operativsystem får panik eller kraschar är det enda sättet att förstå vad som hände att ta en kärnminnesdump och analysera den . Dessa dumpfiler fångar systemets interna tillstånd vid tidpunkten för felet och är viktiga för att felsöka komplexa fel, utreda säkerhetsincidenter eller utföra kriminaltekniska undersökningar.
Även om det kan låta väldigt "lågnivå" är minnesdumpanalys inte exklusivt för kärnutvecklare. Systemadministratörer, supportingenjörer och till och med säkerhetsrevisorer kan dra nytta av det om de känner till rätt verktyg, de olika typerna av dumpar och grundläggande tolkningstekniker . Vi guidar dig igenom allt detta på Windows, Unix/Linux och BSD, med hjälp av verktyg som WinDbg, crash, kgdb och LiME.
Vad är en kärnminnesdump och varför är den värd att analysera?
En kernelminnesdump (ofta kallad Kernel Crash Dump eller helt enkelt en kraschdump ) är en fil som innehåller en kopia, antingen fullständig eller delvis, av minnet vid den tidpunkt då systemet drabbas av ett kritiskt fel, till exempel kernelpanic i Unix/Linux eller en blåskärm (BSOD) i Windows.
I praktiken sparar en dump av den här typen interna kärnstrukturer, anropsstackar, processkontext och laddade drivrutiner . Tack vare detta kan en post mortem-analys utföras efter katastrofen, vilket är mycket likt felsökning av ett live-system, men utan pressen att behöva röra en produktionsmaskin medan den går sönder.
Skälen till att fördjupa sig i kerneldumps är varierande: från att felsöka till synes slumpmässiga buggar och intermittenta krascher , till att undersöka om ett system har manipulerats på ett skadligt sätt eller om en krasch kan ha lämnat spår av känslig information på disken.
Förutom fullständiga kärndumpar finns det möjlighet att ta dumpar av enskilda processer (de klassiska kärndumparna ), vilket är mycket användbart när vi vill begränsa ett problem till en specifik applikation eller kontrollera effekten på sekretessen för en tjänst, till exempel en e-post- eller meddelandeklient.
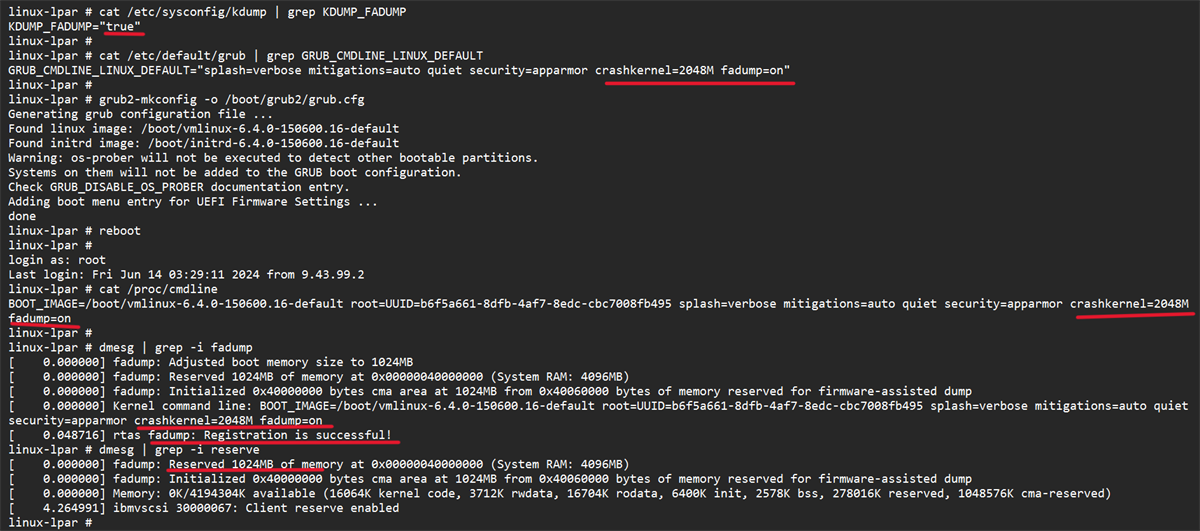
Typer av minnesdumpar i Windows och deras användbarhet
På Windows-system kan själva operativsystemet generera olika typer av dumpfiler när ett STOP-fel uppstår. Varje typ har en annan detaljnivå, så det är avgörande att veta vilken typ av dumpfil du behöver beroende på problemet och begränsningar av diskutrymme.
Ett av de vanligaste formaten i användarmiljöer och på många servrar är liten minnesdump (minidump)Det är den som tar minst plats och är vanligtvis placerad i %SystemRoot%\Minidump, med filer av stilen MiniMMDDÅÅ-01.dmp.
Denna minidump innehåller mycket specifik men viktig information: STOP-felkoden och dess parametrar , listan över drivrutiner som laddades vid tidpunkten för felet, kontexten för processorn som stoppades (PRCB), kontexterna för processen och tråden som är involverad (EPROCESS- och ETHREAD-strukturer) och kernel-mode-anropsstacken för den tråden.
Tack vare dessa grundläggande strukturer är det ofta möjligt att även med en minidump identifiera vilken drivrutin eller modul som orsakar krascherna, även om det inte alltid är möjligt att följa hela spåret om problemet har sitt ursprung långt ifrån den tråd som kördes vid tidpunkten för kraschen och den tillgängliga kontextinformationen är begränsad.
Windows kan också generera kärnminnesdumpar och mycket större fullständiga dumpar som innehåller delar av eller allt fysiskt minne. Dessa är särskilt användbara för lågnivåanalys, forensiska undersökningar och avancerad felsökning av drivrutiner eller själva systemet.
Konfigurera och öppna minnesdumpar i Windows med WinDbg och KD
För att dra nytta av systemdumpar i Windows är det första steget att konfigurera start- och återställningsalternativen korrekt . Från Kontrollpanelen, i de avancerade systemegenskaperna, kan du välja vilken typ av dump du vill generera vid ett fel: till exempel en "Liten minnesdump (256 KB)" och sökvägen där den ska lagras.
Systemet kräver också en växlingsfil på startvolymen på minst några megabyte för att skriva dumpfilen. I moderna versioner av Windows skapar varje krasch en ny fil, och en historik sparas i den konfigurerade mappen, vilket möjliggör enkel granskning av tidigare incidenter.
När de väl genererats finns det flera sätt att bekräfta att dumparna är korrekta. Ett klassiskt verktyg är Dumpchk.exe , som låter dig kontrollera filens grundläggande integritet och skriva ut sammanfattningsinformation. För mer avancerad analys används Windows felsökningsverktyg , inklusive WinDbg (grafiskt gränssnitt) och KD (kommandoradsversion).
Efter att du har installerat felsökningspaketet från Microsofts webbplats finns verktygen vanligtvis i en mapp som C:\Program Files\Debugging Tools for Windows . Därifrån kan du öppna en kommandotolk och ladda en dumpfil med WinDbg eller KD, och ange filen med parametern -z .
windbg -y <RutaSimbolos> -i <RutaBinarios> -z <RutaDump>
Symbolsökvägen kan peka till en symbolserver med lokal cachning , till exempel:
srv*C:\Symbols*https://msdl.microsoft.com/download/symbols
Medan den binära sökvägen vanligtvis är något i stil med C:\Windows\I386 eller mappen dit vi har kopierat de körbara filerna som motsvarar den version som genererade dumpfilen. Detta är viktigt eftersom Minidumps inkluderar inte alla binärfiler, bara referenser till dem, så felsökaren måste kunna hitta dem.
Grundläggande analys av en kärnkraschdump i Windows
När dumpen har laddats med WinDbg eller KD, är analys av en kärnkraschdump ganska likt en felsökningssession efter döden. Det första kommandot som nästan alla kör är `!analyze` , vilket startar en automatiserad analys och genererar en första rapport.
Kommandot !analyze -show visar buggkontrollkod och dess parametrarMedan !analyze -v Den producerar en mycket mer detaljerad utdata: misstänkt modul, anropsstack, kontextuell information och, i många fall, förslag på möjliga orsaker eller diagnostiska steg.
För att komplettera den analysen skriver .bugcheck- kommandot ut felkoden och tillhörande parametrar igen, vilka kan jämföras med Microsofts bugcheck-kodreferens för att ta reda på den exakta betydelsen av varje värde och typiska orsaker.
Kommandot lm N T (lista moduler) låter dig se Lista över laddade moduler med deras sökväg, adresser och statusDetta hjälper till att bekräfta om drivrutinen som identifierats av den automatiserade analysen faktiskt finns i minnet och vilken version den har. Den här listan är särskilt användbar när vi misstänker att drivrutiner eller säkerhetskomponenter från tredje part interagerar med kärnan.
Om så önskas kan vi förenkla inläsningen av dumpfiler genom att skapa en batchfil som tar emot sökvägen till dumpfilen och startar KD eller WinDbg med lämpliga parametrar. På så sätt behöver vi bara skriva ett kort kommando som bara inkluderar filens plats, och skriptet tar hand om allt annat.
Använda WinDbg för djupa kärndumpar
För minnesdumpar i kärnläge erbjuder WinDbg även möjligheten att arbeta med flera filer och sessioner. Dumpar kan öppnas från kommandoraden med -z , eller från det grafiska gränssnittet med hjälp av menyn Arkiv > Öppna minnesdump eller kortkommandot Ctrl+D.
Om WinDbg redan är öppet i passivt läge, välj helt enkelt filen i dialogrutan "Öppna kraschdump", ange sökvägen eller bläddra på disken. När filen är laddad kan du starta sessionen med ett "g"-kommando (Go) i vissa scenarier, eller direkt starta de initiala analyskommandona.
Förutom den klassiska !analyzeDet är lämpligt att bekanta sig med referensavsnitt för felsökarkommandonDetta beskriver alla tillgängliga kommandon för att läsa interna strukturer, undersöka minne, tolka stackar och mycket mer. Många av dessa tekniker är tillämpliga på både live-sessioner och offline-dumpar.
WinDbg låter dig också arbeta med flera parallella dumparVi kan lägga till flera -z-parametrar på kommandoraden, var och en följt av ett annat filnamn, eller lägga till nya mål med hjälp av kommandot .opendumpFelsökning av flera destinationer är användbart för att jämföra återkommande fel eller länkade incidenter.
I vissa miljöer paketeras minnesdumpar i CAB-filer för att spara utrymme eller underlätta överföring. WinDbg kan öppna en .cab med en dump inuti, både med -z och med .opendumpäven om han kommer att läsa Den kommer bara att extrahera en av de dumpade filerna och kommer inte att extrahera andra filer. som skulle kunna gå i samma paket.
Kraschdumpar i Unix och Linux: verktyg, verktyg och krav
I Unix- och GNU/Linux-system är filosofin likartad, men ekosystemet av verktyg skiljer sig avsevärt. De flesta Unix-liknande kärnor erbjuder möjligheten att spara en kopia av minnet när en katastrofal händelse inträffar , vilket kallas en kärndump eller kärnkraschdump.
Även om deras primära användning fortfarande är kärn- och drivrutinsutveckling, har dessa dumpfiler en tydlig säkerhetsaspekt. En krasch kan orsakas av programmeringsfel, men också av misslyckade skadliga handlingar, försök att manipulera systemkomponenter eller klumpigt utnyttjade kapplöpningsförhållanden.
I ett välkonfigurerat Unix-system är dagliga krascher ovanliga, men när de inträffar är det lämpligt att ha en dumpinfrastruktur på plats, såsom Kdump, LKCD eller andra lösningar som låter dig fånga systemminne. Det är dock avgörande att väga både dumpens diagnostiska värde mot risken för att den innehåller mycket känsliga data.
Ett av de mest omfattande och använda verktygen för den här typen av analys i Linux är crash , ursprungligen utvecklat av Red Hat. Detta verktyg har praktiskt taget blivit en standard för att undersöka kerneldumps och även för att analysera körbara system.
Kraschen kan påverka systemets liveminne genom /dev/mem eller, i Red Hat och derivatdistributioner, med hjälp av den specifika enheten /dev/crashÄndå är det vanligt att mata verktyget med en dumpfil som genereras av mekanismer som Kdump, makedumpfile, Diskdump eller arkitekturspecifika dumpfiler som s390/s390x eller xendump i virtualiserade miljöer.
Kraschens roll och vikten av vmlinux i Linux
Kraschverktyget skapades delvis för att övervinna begränsningarna med att använda gdb direkt på /proc/kcoreBland annat kan åtkomsten till den där minnespseudoavbildningen vara begränsad, och dessutom gör vissa kärnkompileringsalternativ det svårt att korrekt tolka de interna strukturerna om vi bara har den komprimerade körbara binärfilen.
För att kraschen ska fungera korrekt krävs två viktiga element: en kompilerad vmlinux-fil med felsökningssymboler (vanligtvis med flaggor som -g) och själva kärndumpen. Denna kombination gör att verktyget kan mappa minnesadresser till funktioner, strukturer och kodrader.
Det är viktigt att skilja på vmlinux och vmlinuzPå de flesta system syns endast vmlinux, vilket är en komprimerad, startbar version av kärnan. Krasch kräver den symboliskt dekomprimerade vmlinux; utan den, när man försöker ladda en dump eller /dev/mem Vi kommer att stöta på fel av typen kan inte hitta startad kärna — vänligen ange namnlistargumentet.
Även om det är möjligt att extrahera vmlinuz manuellt är processen inte alltid enkel, och i praktiken är det ofta mycket bekvämare att kompilera om kärnan för att hämta både vmlinux och vmlinuz samtidigt. I seriösa administrationsmiljöer är det bra att underhålla ett separat vmlinuz-paket för varje distribuerad kärnversion specifikt för dessa situationer.
När kraven är uppfyllda är det relativt enkelt att köra en krasch mot en dumpfil: du anger lämplig vmlinux- och dumpfil, och verktyget öppnar en interaktiv session där du kan utforska kärnstrukturer, lista processer, visa anropsstackar och extrahera forensisk information . De som vill fördjupa sig kan konsultera specialiserad dokumentation, till exempel den välkända tekniska vitboken om krascher.
Begränsningar med /dev/mem och första metoderna i Linux
Innan de tillgripit specifika verktyg har många administratörer historiskt sett försökt att få tag på en minnesdump. läser direkt från enheten /dev/memDen här metoden verkade enkel: använd ett verktyg som memdump (vilket dumpar den enheten till STDOUT) eller hämtar från dd if=/dev/mem of=volcado.mem.
Moderna kärnor erbjuder dock kompileringsalternativ som CONFIG_STRICT_DEVMEMvilket kraftigt begränsar åtkomsten från användarutrymmet till /dev/memDet typiska resultatet är att läsningen avbryts efter ett litet block (t.ex. 1 MB) eller, i värsta fall, att en bugg i den interaktionen kan sluta i en kärnan panik omedelbart och omstart av maskinen.
Detta skydd är helt logiskt ur säkerhetssynpunkt, men det tvingar oss att leta efter andra sätt att få en pålitlig och komplett dump utan att helt förlita oss på generiska enheter som inte längre är lika tillgängliga som tidigare.
Därför är den nuvarande trenden att förlita sig på specifika moduler eller integrerade kraschdumpinfrastrukturer, istället för att helt enkelt försöka "skrapa minne" med användarutrymmesverktyg som inte är utformade för att samexistera med moderna kärnskyddspolicyer.
LiME Forensics: Minnesutvinning i Linux och Android
Ett mycket kraftfullt alternativ inom forensikvärlden är LiME (Linux Memory Extractor) , en kärnmodul utformad just för att fånga flyktigt minne på ett kontrollerat sätt och utan de begränsningar som påverkar /dev/mem. LiME körs i kärnutrymmet, så den kan komma åt RAM mycket mer direkt.
LiME distribueras med sin källkod och kompileras mot kärnhuvuden som användsKompileringsprocessen genererar en modul .ko specifikt för den kärnversion den ska laddas till. När den har kompilerats kan vi verifiera den med verktyg som file för att säkerställa att ELF-modulen som motsvarar vår arkitektur har genererats korrekt.
För att använda LiME, ladda helt enkelt modulen med insmod från roten och skicka den lämpliga alternativ, till exempel genom att ange en nätverksdumpdestination med TCP och ett råformat:
insmod lime-3.x.y.ko "path=tcp:4444 format=raw"
Parallellt, på maskinen som ska ta emot dumpen, lyssnar vi på den konfigurerade porten med hjälp av ett verktyg som ncomdirigera utdata till en fil:
nc <IP_origen> 4444 > volcado.mem
Efter några minuter, beroende på mängden RAM och nätverksprestanda, har vi en fil vars storlek matchar källsystemets fysiska minne. Detta är en komplett RAM-dump som vi kan analysera med forensiska verktyg eller till och med med strängar eller andra verktyg som ett första steg för att hitta intressanta strängar.
Processdumpar och risker för dataexponering
En fullständig kerneldump är extremt informativ, men den kan också vara överdriven när vi bara är intresserade av en specifik process. I så fall är det mycket vettigt att ta till... individuella processdumpar med hjälp av verktyg som gcore i Unix/Linux.
Dessa dumpfiler per process är mycket mindre och mer hanterbara, och låter dig fokusera din analys på specifika applikationer som en meddelandeklient (t.ex. Skype) eller en e-postklient (t.ex. Thunderbird), där det är relativt enkelt att hitta lösenord i klartext, sessionstokens eller kontaktdata genom att utforska minnessträngar.
Ur ett utvecklingsperspektiv hjälper dessa kärndumpar till att lokalisera programmeringsfel, minnesläckor eller inkonsekventa tillstånd i en tjänst. Ur ett säkerhetsperspektiv uppstår dock problemet när dessa dumpar genereras rutinmässigt och lagras på platser som är tillgängliga för andra användare , antingen på själva systemet eller på delade nätverksresurser.
Om en användare schemalägger, till exempel, en uppgift cron Genom att regelbundet samla in dumpfiler av känsliga processer och lämna dem i en globalt läsbar katalog öppnar en angripare en enorm dörr för exponering av kritisk information. I många granskningsscenarier gör analys av dessa filer det möjligt för en angripare att återställa sig. inloggningsuppgifter, kontaktlistor, kommunikationshistorik och annan privat information med relativt låg ansträngning.
Därför är det, vid all seriös granskning av ett Unix-system, lämpligt att ägna några minuter åt att kontrollera om dumpfiler (hela eller delvisa) genereras, var de lagras, vilka behörigheter de har och om det finns någon automatiserad process som lämnar minneskopior inom räckhåll för obehöriga användare.
Obduktionsanalys av dumpfiler i FreeBSD med kgdb
I BSD-världen, och specifikt i FreeBSD, innebär tillvägagångssättet för post mortem-analys Aktivera kraschdumpar på systemet och kompilera en kärna med felsökningssymbolerDetta styrs från kärnans konfigurationskatalog, vanligtvis i /usr/src/sys/<arq>/conf.
I motsvarande konfigurationsfil kan symbolgenerering aktiveras med en rad som denna:
makeoptions DEBUG=-g # Build kernel with gdb(1) debug symbols
Efter att konfigurationen har ändrats måste kärnan kompileras om. Vissa objekt kommer att regenereras (t.ex. trap.o) på grund av ändringen i byggfilerna. Målet är att få en kärna med samma kod som den som har problem, men med tillägg av nödvändig felsökningsinformationDet är lämpligt att jämföra de gamla och nya storlekarna med hjälp av kommandot size för att säkerställa att det inte har skett några oväntade ändringar i binärfilen.
När kärnan med symboler är installerad kan vi undersöka dumparna med kgdb enligt beskrivningen i den officiella dokumentationen. Alla symboler kanske inte är kompletta, och vissa funktioner kan visas utan radnummer eller argumentinformation, men i de flesta fall är detaljeringsnivån tillräcklig för att spåra problemet.
Det finns ingen absolut garanti för att analysen kommer att lösa alla incidenter, men i praktiken fungerar den här strategin ganska bra i en hög andel scenarier , särskilt när kraschdumpar kombineras med en bra granskning av de senaste ändringarna i systemet.
Bästa praxis för att analysera och dokumentera kärnfel
Oavsett operativsystem hänvisar kernel dump-analys vanligtvis till teknisk dokumentation, kunskapsbaser, specialiserade forum eller till och med själva kernelns källkod för att tolka meddelanden, felkoder och okända symboler.
I Linux är det mycket bra att förlita sig på det officiella källkodsträdet, den inbyggda dokumentationen och community-resurser. Många kärnfelmeddelanden kan spåras tillbaka till den exakta filen där de kommer från, vilket hjälper till att förstå sammanhanget där en viss BUG() eller WARN() utlöses.
I Windows ger Microsofts dokumentation, kunskapsbas (KB) och tekniska forum detaljerade förklaringar av buggkontrollkoder, felsökningsrekommendationer och kända felmönster . Genom att kombinera denna information med rapporterna från !analyze -v är det möjligt att utveckla en rimlig åtgärdsplan.
Det verkliga värdet av en kraschdump framträder när all information jämförs med en gedigen förståelse av operativsystemet och den specifika miljö där felet inträffade. Först då kan varaktiga lösningar utvecklas och framför allt förhindras att samma problem återkommer i framtiden med allvarligare konsekvenser.
Kärndumpanalys är i slutändan en blandning av vetenskap och hantverksskicklighet: det kräver lämpliga verktyg, förhandskonfiguration (symboler, dumpalternativ, säker lagring) och en hel del erfarenhet av att läsa stackar, strukturer och felkoder. Att behärska dessa tekniker gör att vi inte bara kan felsöka komplexa incidenter utan också dramatiskt öka säkerheten och motståndskraften hos de system vi hanterar.