- Google TPU v7 Ironwood är den sjunde generationen av TPU:er och är specifikt utformad för inferenseran, med 4 614 TFLOP:er FP8 och 192 GB HBM3e per chip.
- Arkitekturen skalar upp till 9 216 chip i en superpod med 1,77 PB delat minne, 9,6 Tb/s ICI-nätverk och vätskekylning optimerad för nästan 10 MW.
- Integrerad i AI-hyperdatorn tillsammans med Axion-processorer erbjuder Ironwood en stark balans mellan prestanda, energieffektivitet och kostnad för massiva AI-arbetsbelastningar.
- Megakontraktet med Anthropic och den vertikala integrationsstrategin förstärker Googles roll som en viktig konkurrent till Nvidia på marknaden för AI-chip.

Accelerationen av artificiell intelligens genomgår en transformation . Det räcker inte längre att träna massiva modeller och skryta om sina parametrar: nu är den verkliga kampen hur man får dem att fungera dagligen, för miljontals användare, utan att AI-energi- och infrastrukturkostnaderna skjuter i höjden. I detta sammanhang framträder Google TPU v7 Ironwood, en hårdvara designad för en AI som inte bara svarar, utan också tänker, resonerar och agerar kontinuerligt.
Ironwood är Googles sjunde generationens Tensor Processing Unit (TPU) och, enligt företaget själva, deras hittills mest kraftfulla, skalbara och effektiva chip. Den är designad för den så kallade "inferenseran", där det som spelar roll inte så mycket är hur lång tid det tar att träna en ny modell, utan hur mycket det kostar att serva den, hålla den aktiv, resonera och generera resultat dygnet runt. Låt oss titta närmare på exakt vad Google TPU v7 Ironwood är, vad som gör den speciell och varför den skakar om läget jämfört med Nvidia och de andra jättarna i branschen.
Vad är Google TPU v7 Ironwood och varför är det så viktigt?
Ironwood är i huvudsak en specialbyggd AI-accelerator utvecklad av Google för att köra banbrytande modeller för artificiell intelligens. Den tillhör familjen av Tensor Processing Units (TPU), chips specifikt utformade för maskininlärningsarbetsbelastningar som har drivit interna Google-tjänster (sökning, YouTube, annonsering, översättning etc.) i nästan ett decennium, och mer nyligen Google Cloud-lösningar.
Denna sjunde generation har byggts vidare på all erfarenhet som samlats med tidigare TPU:er och med ett tydligt mål: att maximera prestandan i inferens- och komplexa resonemangsuppgifter , utan att offra träningsbarheten. Stora språkmodeller (LLM), expertmix, förstärkta återkallelsesystem och AI-agenter som behöver behålla mycket kontext i minnet är de typer av arbetsbelastningar som Ironwood är utformat för att hantera.
Istället för att bara vara "ett snabbare chip" är Ironwood integrerat i Google Clouds AI- hyperdatorarkitektur , en metod där databehandling, nätverk, lagring och programvara är utformade tillsammans. Detta möjliggör finjustering från kisel till containerorkestrator för att pressa ut varje watt och varje klockcykel.
En annan viktig punkt är att Ironwood är den första TPU:n som designats från grunden för inferenseran . Fram tills nu var de flesta AI-system främst utformade för att träna massiva modeller; nu flyttas fokus till att köra dessa modeller effektivt, upprepade gånger, med agenter som inte bara reagerar utan också förutser, söker efter data, kombinerar den och returnerar slutsatser.
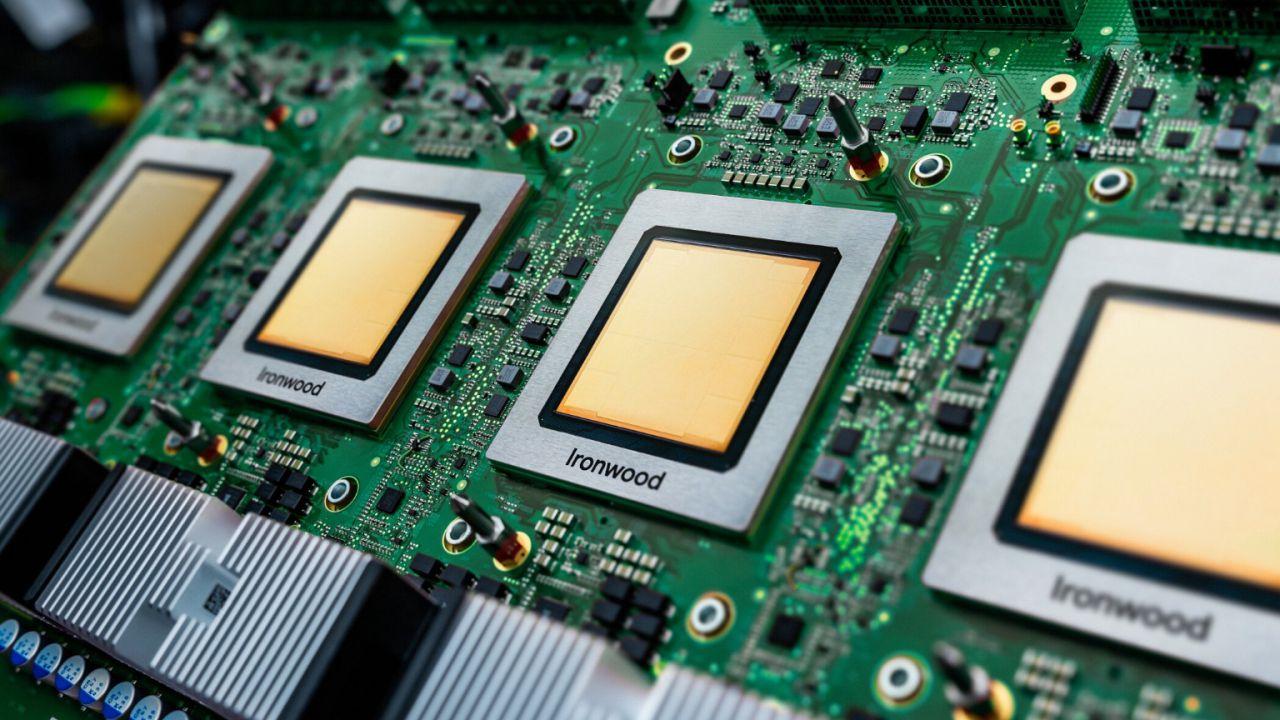
Viktiga tekniska egenskaper hos TPU v7 Ironwood
På den tekniska fronten kan Ironwood skryta med imponerande siffror, även på en marknad som är så konkurrensutsatt som AI-chip. Varje chip levererar 4 614 teraflops FP8-precisionsdatorkraft , vilket är mer än 16 gånger beräkningskapaciteten hos TPU v4 och ett stort steg framåt jämfört med tidigare generationer.
För att driva denna enorma processorkapacitet integrerar varje chip 192 GB nästa generations HBM3e-minne , med en ungefärlig bandbredd på 7,3–7,4 TB/s. Denna kombination av höghastighetsberäkning och minne är just det som gör det möjligt att hantera gigantiska modeller och mycket långa kontexter utan att uppleva flaskhalsar.
Ironwood tillverkas med en avancerad 5-nanometerprocess och förbrukar cirka 600 watt per chip. Det kanske låter högt, men jämfört med prestandan per watt är resultatet mycket konkurrenskraftigt: jämfört med föregående generation Trillium (TPU v6e) fördubblar Ironwood prestandan per watt.
Dessa förbättringar är märkbara i både utbildnings- och servicearbetsbelastningar. För utbildning kan Ironwood accelerera bearbetningen av nästa generations modeller (som Gemini eller Veo) och de från andra leverantörer, och för service möjliggör det att massiva slutsatser kan köras med lägre energikostnader, något som är avgörande nu när AI-datacenter mäts i gigawatt.

Från chip till Superpod: hur Ironwood skalar
Den sanna magin hos Ironwood ligger inte i ett enda chip, utan i hur det skalas för att bilda AI-superdatorer . Varje Ironwood SoC är monterad på en PCBA med fyra chip, och varje rack integrerar 16 av dessa kort, totalt 64 chip per rack.
Därifrån grupperas racken tillsammans för att bilda en Ironwood Superpod . En komplett superpod inkluderar 144 rack, vilket motsvarar 9 216 sammankopplade chip. Totalt motsvarar detta cirka 42,5 exaflops FP8-prestanda och cirka 1,77 petabyte delat HBM-minne, allt tillgängligt som en omfattande logisk resurs för AI-modeller.
Sammankopplingen mellan chips uppnås via Inter-Chip Interconnect (ICI) -nätverket , med en 3D Torus (4x4x4)-design och hastigheter på upp till 9,6 Tb/s. Denna topologi möjliggör minskad latens och bibehåller höga överföringshastigheter även när systemet skalas till tusentals acceleratorer, vilket är avgörande för distribuerad träning och mycket parallella inferensarbetsbelastningar.
Utöver superpoden kan infrastrukturen utökas ytterligare genom att kombinera block med 64 anslutna chip och länka dem via en optisk stamnätskabel på upp till 1,8 PB/s. Denna blandning av passiva kopparkablar, fiberoptik och optiska switchar ger enorm flexibilitet vid konfigurering av anpassade kluster för olika kunder och modeller.
Effektmässigt närmar sig en installation av denna storlek 10 megawatt elektrisk kapacitet , en siffra som kräver att kylning och effektivitet tas på största allvar. Varje rack är konstruerat för att överstiga 100 kW i förbrukning, så hela systemet har konstruerats från grunden för vätskekylning och avancerad kraftdistribution.

Kylning, förbrukning och energieffektivitet
Med sådana monstruösa effekttätheter är den uppenbara frågan: hur håller Google allt detta under termisk kontroll? Svaret ligger i ett toppmodernt vätskekylningssystem, speciellt utformat för Ironwood-superpods.
Varje rack integrerar en kylvätskedistributionsenhet (CBU) med läckagedetektorer och 416V AC elektrisk redundans . Denna konfiguration förhindrar inte bara överhettning utan ger också hög tillförlitlighet för kritiska AI-arbetsbelastningar, där ett långvarigt avbrott kan resultera i förluster på miljontals euro eller storskaliga driftstörningar.
Ironwood strävar inte bara efter att vara det kraftfullaste systemet, utan också ett av de mest effektiva. Jämfört med Trillium uppnår TPU v7 dubbelt så hög prestanda per förbrukad watt . Det betyder att med samma energibudget för 2024 skulle ett datacenter utrustat med Ironwood kunna hantera upp till dubbelt så hög inferens år 2026.
Denna strategi tar itu med en obekväm verklighet inom sektorn: energi, inte kisel, håller på att bli den begränsande faktorn för AI-expansion. Elnäten i många länder börjar nå sin kapacitet i viktiga datacenterområden, så att utvinna mer användbart arbete från varje watt är inte längre en fördel, det är en nödvändighet.
Dessutom är Ironwoods arkitektur optimerad för att minimera onödig dataförflyttning, en stor energiförbrukare i distribuerade system. Kombinationen av massivt HBM-minne och höghastighetsnätverk syftar just till detta: mer bearbetning närmare data och färre kostsamma resor över datacentret.
Ironwood inom AI Hypercomputer och programvaruskiktet
Ironwood existerar inte i isolering; det är djupt integrerat i Google Clouds AI-hyperdatorarkitektur . Detta koncept sammanför hårdvara (Axion-processorer och TPU:er), höghastighetsnätverk, lagring samt programvara för orkestrering och schemaläggning inom ett enda designramverk.
På programvarunivån förlitar sig Google på sin Pathways-stack, som möjliggör koordinering av tiotusentals Ironwood TPU:er som om de vore en enda logisk resurs. Vid sidan av Pathways har verktyg som MaxText (för storskalig LLM-utbildning ) och integration med Kubernetes Engine via Cluster Director stärkts , vilket optimerar klusterschemaläggning och motståndskraft.
För inferenskomponenten har Google utökat vLLM-stödet till att fungera med både GPU:er och TPU:er , vilket gör det enklare att migrera modeller och arbetsbelastningar mellan olika typer av acceleratorer med minimala kodändringar. Dessutom kan GKE Inference Gateway minska latensen för initiala förfrågningar med upp till 96 % och sänka servicekostnaden med cirka 30 %, enligt data som delats av företaget.
Allt detta innebär att kunderna inte bara får ett snabbt chip, utan en komplett, heltäckande optimerad plattform . IDC uppger faktiskt en avkastning på investeringar på 353 % över tre år för AI-hyperdatorkunder, med IT-kostnadsminskningar på nästan 28 %.
Det slutgiltiga målet är tydligt: att göra det möjligt för företag att utnyttja kraften hos Ironwood utan att behöva hantera komplexa infrastrukturer. Den ideala användaren definierar helt enkelt sina modeller och behov, och Google Clouds kontrollplan orkestrerar sömlöst TPU:er, Axion, nätverk, lagring och programvara.

"Inferensens tidsålder" och Ironwoods roll
I åratal har mycket av AI-diskussionen kretsat kring att träna allt större modeller . Marknaden har dock konfronterats med en hård verklighet: oavsett hur spektakulär träningen är, kommer hållbara intäkter från att tillhandahålla slutsatser i stor skala, dag ut och dag in.
Google hänvisar till denna nya era som "inferensens era ". Istället för att bara använda reaktiva modeller som väntar på att användaren ska ställa frågor, rör vi oss mot AI-agenter som hämtar data, analyserar sammanhang, koordinerar delprocesser och tar initiativ till att erbjuda rekommendationer och bearbetad information.
Ironwood är utformat just för den här typen av arbetsbelastningar: modeller med komplexa resonemang, omfattande sammanhang och beständiga tillstånd . Den stora mängden delat minne och nätverksbandbredd är avsedd att tillåta flera komponenter i samma AI-system att arbeta på ett samordnat sätt utan att bli överbelastade av trafik.
I det här scenariot antar Google en annan strategi än Nvidia. Medan Blackwell-chip fortsätter att dominera den senaste utbildningen och utlovar mycket höga inferenshastigheter i specifika konfigurationer, fokuserar Google på att optimera kontinuerlig och massiv exekvering av modeller i produktion , genom att integrera hårdvara och moln i ett enda, sammanhängande paket.
Företaget avser inte att ersätta Nvidia helt och hållet, utan snarare att ta en växande andel av den totala inferensmarknaden . Vissa interna uppskattningar tyder på att Googles TPU:er kan representera upp till 30 % av den marknaden år 2027, särskilt bland stora kunder som redan använder Google Cloud.
Avtalet med Anthropic och det kommersiella uppsvinget
Ironwoods stora kommersiella uppsving kom från Anthropic, utvecklaren av Claude-modellerna . Den 23 oktober 2025 tecknade företaget ett omfattande avtal med Google, där de åtog sig att använda upp till en miljon TPU:er och investera tiotals miljarder dollar i infrastruktur på Google Cloud.
Detta kontrakt förutser en energiförbrukning som överstiger 1 gigawatt år 2026 , en enorm siffra som ger en uppfattning om i vilken skala de stora aktörerna inom AI verkar. Över en natt gick Ironwood från att vara ett ambitiöst projekt på färdplanen till en verklig investering med stark efterfrågan som stöd.
För Google löser avtalet en av deras största problem: att bygga datacenterkapacitet utan garanterad användning . Med Anthropic som ankarkund kan företaget planera nya anläggningar, elavtal och driftsättningar av Ironwood-superpodar med mycket större insyn i avkastningen på investeringen.
Att Anthropic valde Ironwood, snarare än att vänta på Nvidias nästa generation eller tillgripa proprietär hårdvara från andra hyperskalare, är ett tydligt tecken på förtroende för effektiviteten och time-to-market hos Googles TPU:er. "Mer slutledning, mindre kraft" är i praktiken det implicita mottot för detta drag.
Den här typen av långsiktiga avtal hjälper också Google att bättre förhandla om sina egna kostnader (från chiptillverkning till energiförsörjning) och stärka sin position på en marknad där efterfrågan på AI-datoranvändning vida överstiger det tillgängliga utbudet.
Påverkan på AI-chipmarknaden och konkurrensen med Nvidia
Lanseringen av Ironwood är revolutionerande på marknaden för AI-hårdvara , som fram tills nu tydligt dominerats av Nvidia-grafikprocessorer. Google är inte de enda som gör framsteg: AWS driver sin Trainium2-linje, och Microsoft gör framsteg med sitt Maia-program, om än med förseningar.
Nvidia fortsätter att vara ledande inom banbrytande utbildning med sina Hopper-, Blackwell- och de kommande Rubin-arkitekturerna, som riktar sig mot konfigurationer med flera exaflops per rack. Google driver dock marknaden mot en modell med flera vertikalt integrerade ekosystem , där varje hyperscaler designar sina egna chip, nätverk, programvara och molntjänster.
I detta nya landskap positionerar sig Ironwood som ett solidt alternativ för företag som söker storskalig inferensinfrastruktur utan att helt förlita sig på CUDA-ekosystemet. Kombinationen av anpassade TPU:er och Axion-processorer, plus Google Cloud-plattformen, skapar ett mycket attraktivt erbjudande för företag som kräver förutsägbara kostnader, prestanda och tillgänglighet.
Åtgärden ökar också pressen på Nvidia, som måste rättfärdiga höga priser i en miljö där de inte längre är det enda gångbara alternativet. I takt med att Amazon, Microsoft och Google stärker sina egna leverantörsplattformar, förskjuts marknaden från modellen med en enda chipleverantör till ett lapptäcke av slutna, men mycket optimerade, lösningar inom varje molnleverantör.
Framgången för Ironwood och TPU:er i allmänhet kommer dock att bero starkt på att Googles programvaruutveckling fortsätter att mogna i samma takt som CUDA-ekosystemet . Om klusterutnyttjandegraden sjunker (till exempel från 90 % till 70 %) kommer den totala effektiviteten att bli lidande och priskonkurrenskraften kan påverkas.
Axion: CPU-tillägget för AI-infrastruktur
Parallellt med lanseringen av Ironwood har Google stärkt sin Axion-familj av anpassade processorer , baserade på Arm Neoverse-arkitekturen. Medan TPU:er hanterar de tyngsta aspekterna av maskininlärning, tar Axion hand om de generella arbetsbelastningarna kring AI.
De nya N4A-instanserna erbjuder upp till 64 vCPU:er, 512 GB DDR5-minne och 50 Gbps nätverksbandbredd , med upp till 100 % förbättringar av pris-prestanda jämfört med motsvarande x86-maskiner. Samtidigt är C4A Metal Google Clouds första bare-metal-version baserad på Arm, inriktad på scenarier som Android-utveckling, fordonsapplikationer och avancerade simuleringar.
Företag som Vimeo har rapporterat en förbättring på 30 % i videoomkodning , medan ZoomInfo rapporterar en ökning av effektiviteten i dataanalysprocesser på 60 %. Andra företag, som Rise, hävdar att de har minskat datorkraftförbrukningen med cirka 20 % samtidigt som de bibehållit en stabil latens.
Den underliggande idén är att Axion ska fungera som ett generellt baslager för beräkningar : dataförberedelse, mikrotjänster, webbtjänster, affärslogik, etc. Med den grunden fokuserar Ironwood TPU:er på det de gör bäst: att accelerera träning, inferens och resonemang i AI-modeller.
Denna kombination förstärker visionen att nästa generations databehandling kommer att vara hybrid : effektiva processorer för att hantera arbetsflöden och TPU:er (eller andra acceleratorer) för intensiv beräkning. Allt detta sammanförs av AI-hyperdatorplattformen och Google Cloud-verktyg.
Investeringsutsikter och marginalskydd för Alphabet
Ur ett finansiellt perspektiv är Ironwood mycket mer än ett kraftfullt chip: det är en strategisk komponent för att skydda Alphabets marginaler inom molnbaserad AI. Hyperscalers är på väg att nå tvåsiffriga gigawatt-kapaciteter år 2027, och allt tyder på att infrastrukturinvesteringarna kommer att förbli massiva.
Genom att designa sina egna chip kan Google skapa värde i hela värdekedjan : från kiseldesign till molndistribution. Istället för att sälja vidare tredjepartshårdvara med små marginaler omvandlar de kapitalutgifter (CAPEX) till en konkurrensfördel och ett verktyg för att differentiera sina tjänster.
Ironwoods förbättrade prestanda per watt innebär att varje megawatt datacenterkapacitet levererar betydligt mer i form av levererade slutsatser . Kombinerat med programvaruoptimeringar (vLLM, Pathways, GKE Inference Gateway, etc.) gör detta att Google kan erbjuda aggressiva priser utan att kompromissa med lönsamheten.
Kontraktet med Anthropic ger ett extra lager av stabilitet till Googles investeringsplan . Istället för att bygga infrastruktur "blint" och vänta på att kunderna ska anlända, kan de nu dimensionera en stor del av sin expansion baserat på långsiktiga avtal, vilket minskar osäkerheten och risken för överkapacitet.
Ändå kvarstår öppna frågor: om Google kommer att attrahera fler stora ankarkunder, om energiprojekten och de nya transformatorstationerna kommer att hålla schemat och om deras programvaruuppsättning kommer att upprätthålla höga utnyttjandegrader. Potentialen finns där, men genomförandet kommer att vara avgörande för att Ironwood ska bli både en teknisk framgång och en motor för hållbara vinster . DETTA ÄR INTE INVESTERINGSRÅD.
Sammantaget representerar Google TPU v7 Ironwood ett generationssprång som går långt bortom teraflopsen på en specifikationslista: den kombinerar rå kraft, massivt delat minne, avancerade optiska nätverk, vätskekylning och ett djupt integrerat moln för att stödja den nya vågen av AI-agenter och modeller som körs dygnet runt. I en värld där energin är knapp, modeller ständigt växer och konkurrensen om kontrollen över AI-stacken är hård, framstår Ironwood som hjärtat i en infrastruktur utformad för att inleda "inferensåldern" och omdefiniera hur, var och till vilken kostnad artificiell intelligens körs på global skala.
