- Inbyggd omnimodal modell med text, bild, ljud och video samt realtidsströmning.
- SOTA i 22/36 ljud-/videotest och flerspråkig (119/19/10 språk).
- Thinker-Talker-arkitektur med MoE, låg latens och systempromptkontroll.
- Rekommenderad driftsättning med vLLM/Transformers, Docker och officiella verktyg.
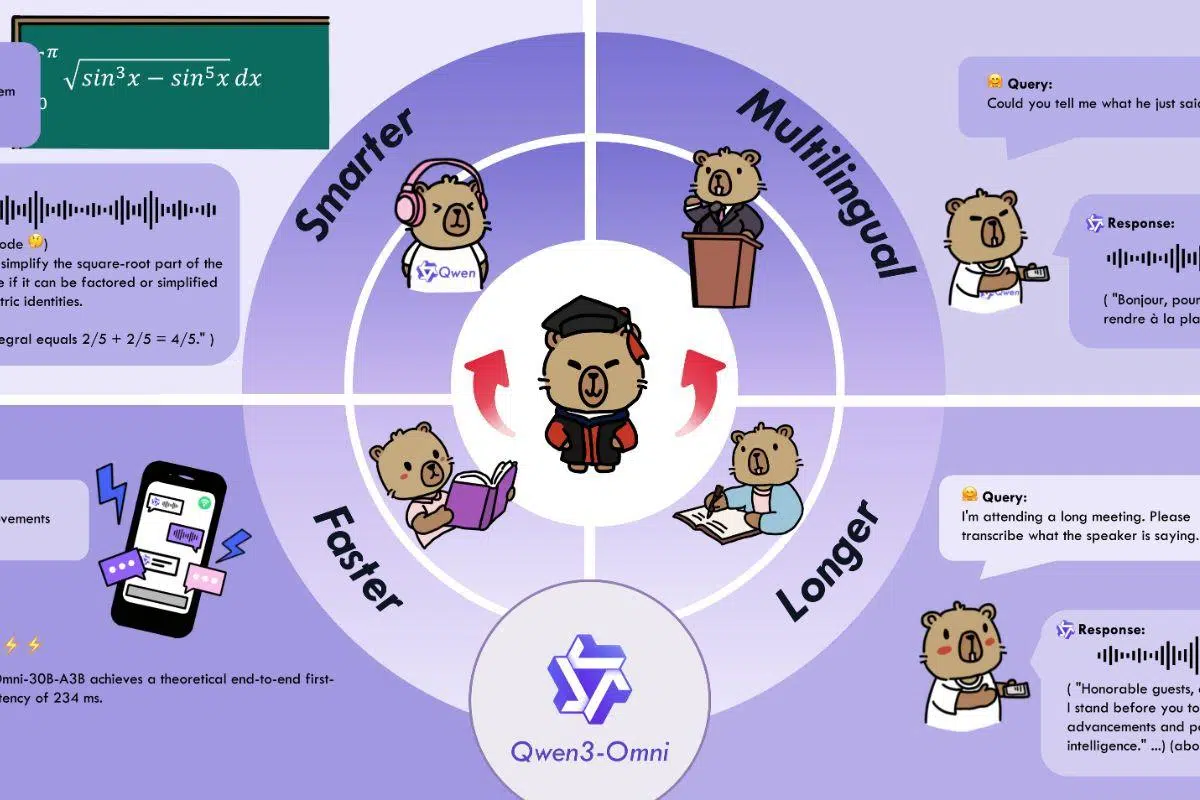
Ankomsten av Qwen3-Omni har förändrat landskapet för AI: en enda inbyggd modell som kan förstå och svara på text, bilder, ljud och video , med omedelbara svar i både skriftlig och muntlig form. Vi pratar inte om multimodala "patchar", utan snarare en fundamentalt utformad arkitektur för att integrera modaliteter med låg latens och finjusterad beteendekontroll.
I en tid då nästan alla testar chatbotar och assistenter, kommer Qwen3-Omni med ambitioner: den stöder 119 språk via text, känner igen tal på 19 språk och talar på 10 språk , förstår långt ljud (upp till 30 minuter) och kan skryta med benchmark-poäng i dussintals tester. Dessutom syftar dess Thinker-Talker-design och Mixture of Experts-strategi på snabba svar och kvalitet i resonemang i verkliga scenarier.
Vad är Qwen3-Omni och vad erbjuder det?
Qwen3-Omni är en familj av grundläggande, omnimodala och heltäckande flerspråkiga modeller utformade för att bearbeta text, bilder, ljud och video, med utdata i både text och naturligt tal. Nyckeln ligger inte bara i variationen av in- och utdata utan också i dess streamingfunktionalitet med flytande konversationsrörelser och förmågan att svara omedelbart.
Teamet har introducerat flera arkitekturförbättringar för prestanda och effektivitet: tidig "text-first" förträning kombinerad med blandad multimodal träning, och en design med en Mixture of Experts (MoE) som bibehåller prestandan i text och bild samtidigt som den förbättrar ljud och video. Med dessa förbättringar uppnår modellen SOTA i 22 av 36 ljud/video-riktmärken och öppen källkods-SOTA i 32 av 36, med resultat jämförbara med Gemini 2.5 Pro inom ASR, ljudförståelse och talkonversation.
Viktiga förmågor och metoder
Qwen3-Omni är redo för verkliga ljud-, bild- och audiovisuella tillämpningar, med omfattande flerspråkigt stöd: 119 textspråk, 19 röstinmatningsspråk och 10 röstutgångsspråk . Röstinmatningsspråken inkluderar engelska, kinesiska, koreanska, japanska, tyska, ryska, italienska, franska, spanska, portugisiska, malaysiska, nederländska, indonesiska, turkiska, vietnamesiska, kantonesiska, arabiska och urdu; och utmatningsspråk inkluderar bland annat engelska, kinesiska, franska, tyska, ryska, italienska, spanska, portugisiska, japanska och koreanska.
De officiella kokböckerna illustrerar dess bredd i användningsområden. Inom ljud visar den upp flerspråkig och långljudig taligenkänning (ASR) , tal-till-text och tal-till-tal-översättning, musikanalys (stil, rytm, genrer), beskrivning av ljudeffekter och textning av allt ljud . Den stöder också blandad analys av spår med tal, musik och omgivande ljud.
I visuella scenarier erbjuder den "hård" OCR för komplexa bilder, objektdetektering och -förankring , bildkvalitetssäkring, bildmatematisk lösning (där Thinking-modellen är utmärkt), videobeskrivning, navigering i första persons video och analys av scenövergångar . I audiovisuella scenarier demonstrerar den ljud-videokvalitetssäkring med tidsjustering, guidad interaktion med AV-ingångar och dialoger med assistentbeteende.
Som agent utmärker den sig för sin förmåga att fungera genom att ringa från ljud , vilket öppnar röstarbetsflöden som aktiverar verktyg, och i härledda uppgifter finns en Omni-Captioner för textning med stor detaljrikedom, vilket visar på generaliserbarheten hos den grundläggande.
Tänkare-pratare Arkitektur och design med MoE
En av de viktigaste skillnaderna är ansvarsfördelningen: Tänkaren genererar texten (med variationer som inkluderar explicit tankekedja), och Talaren producerar ljud i realtid . Denna frikoppling möjliggör naturlig röstkonversation samtidigt som systemet upprätthåller en hög nivå av textförståelse och planering.
MoE-databasen fördelar arbetsbelastningen mellan experter och förlitar sig på AuT-förträning för kraftfulla generella representationer. Dessutom minskar användningen av multikodskodning i ljudkanalen latensen till ett minimum, vilket är avgörande för samtal eller assistenter där varje hundradels sekund räknas.
Prestanda och riktmärken: text, bild, ljud och audiovisuellt
Qwen3-Omni bibehåller banbrytande text- och bildprestanda utan att försämras jämfört med Qwen-modeller av liknande storlek som fokuserar på ett enda läge, medan den sätter takten i de flesta tester inom ljud- och audiovisuell prestanda . Bland de 36 ljud- och audiovisuella prestandatester som samlats in uppnår den öppen källkods-SOTA i 32 och total SOTA i 22, och överträffar därmed Gemini 2.5 Pro och GPT-4o på flera punkter.
Några anmärkningsvärda milstolpar inom text: i AIME25 får Flash-Instruct-varianten runt 65,9 poäng; i ZebraLogic når Instruct 90, och i MultiPL-E uppnår den konkurrenskraftiga siffror mot GPT-4o. I justeringsuppgifter som IFEval och WritingBench visar Instruct- och Thinking-modellerna höga och konsekventa poäng.
Inom ljud är ASR-resultaten för kinesiska och engelska utmärkta: i WenetSpeech och LibriSpeech minskar det ordfelsfrekvensen avsevärt, med siffror nära 1,22/2,48 i LibriSpeech clean/other, och i uppsättningar som FLEURS (flerspråkig) erbjuder det mycket låga felfrekvenser. I VoiceBench placerar mätvärden som AlpacaEval, CommonEval och WildVoice Qwen3-Omni i nivå med slutna referenssystem, och det utmärker sig inom ljudresonemang i MMAU v05.15.25.
Inom audiovisuella tillämpningar är WorldSense det mest frekvent citerade måttet (ungefär 54,1 ), vilket överträffar Gemini-2.5-Flash. Dessutom, i programsviter som DailyOmni och VideoHolmes, uppnår Thinking-varianten förbättringar jämfört med tidigare SOTA-applikationer med öppen källkod. Inom ren syn utmärker den sig i MMMU, MathVista, MathVision och dokumentförståelse (AI2D, ChartQA), med mycket goda resultat i räkning (CountBench) och videoförståelse (Video-MME, MLVU).
Noll-shot röstgenerering mättes också: jämfört med familjer som CosyVoice och Seed-TTS visar Qwen3-Omni bättre innehållskonsistens över flera språk och hög talarlikhet . I den flerspråkiga sektionen visar tabellerna "Innehållskonsistens" och "Talarlikhet" att Qwen3-Omni 30B-A3B är mycket konkurrenskraftig på kinesiska och engelska, och stabil på tyska, italienska, portugisiska, spanska, japanska, koreanska, franska och ryska. I tvärspråkig TTS uppnår den bättre WER/konsistens över flera par (t.ex. zh→en, ja→en, ko→zh) jämfört med CosyVoice 2/3.
Tillgängliga modeller och vad var och en används till
Qwen3-Omni-serien innehåller tre huvuddelar, var och en utformad för ett specifikt ändamål: Instruct , Thinking och Captioner . De härrör alla från samma kärna men med olika funktioner aktiverade eller finjusterade för specifika uppgifter.
Qwen3-Omni-30B-A3B- Instruct innehåller tänkare och talare, accepterar ljud, video och text , och returnerar text och ljud. Det är rätt val om du vill ha fullständig interaktion och talade resultat i realtid, och rekommenderas för röst- eller videodemonstrationer.
Qwen3-Omni-30B-A3B – Tänkande fokuserar på tänkaren med kedjeresonemang , stödjer ljud, video och text med textutdata. Det är användbart för djupgående analyser, lösning av komplexa problem, visuell matematik eller arbetsflöden där du inte behöver röstutdata men det bästa strukturerade tänkandet.
Qwen3-Omni-30B-A3B- Captioner är en förfinad variant av högprecisions- och låghyperaktivitetsbaserad ljudtextning . Den är öppen källkod, täcker ett brett spektrum av ljud i detalj och fyller en historisk lucka i ekosystemet med öppen källkod: pålitlig och fyllig textning för allmänt ljud.
Latens, realtids- och beteendekontroll
Systemet är optimerat för omedelbar interaktion, med svarstider på cirka 211 ms för ljud och 507 ms för ljud-video . Förutom streaming läggs vikt vid naturliga samtalsrörelser och stabil röståtergivning, med hjälp av de tydliga rollerna Tänkare (text) och Talare (röst).
För finjustering kan du anpassa stilen med systemprompter . I AV-scenarier där video- och ljudinspelningar används som referens föreslår teamet en systemprompt som bibehåller tänkarens resonemang samtidigt som den ger mer läsbar och konversationsmässig text, vilket gör det lättare för talaren att tala flytande . Det rekommenderas också att hålla parametern `use_audio_in_video` konsekvent under en konversation med flera turer.
Vid utvärderingen finns det specifika riktlinjer: ange inte systemprompten , följ ChatML-formatet för varje riktmärke och, när det inte finns någon prompt, använd följande som standard: kinesisk ASR (“请将这段中文语音转换为纯文本。”), ASR på andra språk (“Transkribera ljudet till text.”), S2TT (“Lyssna på det angivna <källspråk>-talet…”) och sångtexter (“ Transkribera sångtexterna” … utan interpunktion, rader separerade med brytningar”).
Implementering, krav och verktyg
För en komplett lokal upplevelse rekommenderar teamet att man använder Hugging Face Transformers och granskar programvaruutvecklingsfaserna , men var medveten om att eftersom det är en MoE-arkitektur kan den köras långsamt med HF-inferens; för produktions- eller låglatensapplikationer rekommenderar de att man använder vLLM eller DashScope API , och tillhandahåller till och med en Docker-avbildning som inkluderar miljöer för båda. Transformers-koden har redan sammanfogats, men PyPI-paketet har ännu inte släppts och måste installeras från källkoden.
De tillhandahåller verktyg för hantering av ljud och bild/video (base64, URL:er, sammanflätade ingångar) och rekommenderar FlashAttention 2 med Transformers för att minska GPU-minnet vid laddning i float16 eller bfloat16 . Med vLLM ingår FlashAttn2, och parametrar som limit_mm_per_prompt (förallokerar GPU-minne) och max_num_seqs för parallellism beskrivs i detalj ; dessutom möjliggör ökning av tensor_parallel_size inferens för flera GPU:er.
Det finns några användbara tips för att spara resurser: om du inte behöver ljud kan du inaktivera Talker efter initialiseringen, vilket sparar cirka 10 GB VRAM. Och om du vill ha snabbare textutdata kan du använda `return_audio=False` under genereringen. Minimikrav på teoretiska minne för BF16 med FlashAttn2 anges också: till exempel använder Instruct 30B-A3B cirka 78,9 GB med 15 sekunder video och 144,8 GB med 120 sekunder; Thinking använder cirka 68,7 GB respektive 131,7 GB.
För att konfigurera en lokal webbdemo rekommenderar de att du förbereder din vLLM-miljö (eller den långsammare Transformers-miljön), ser till att du har ffmpeg installerat och använder deras skript. De erbjuder GPU-klara Docker-avbildningar "qwenllm/qwen3-omni" med NVIDIA Container Toolkit , portmappning (t.ex. värd 8901 → container 80) och alternativet att servera från 0.0.0.0. Du kan ange containern igen eller ta bort den efter behov.
Demonstrationer, API:er och ekosystem
Om du inte vill driftsätta lokalt kan du prova demos på Hugging Face Spaces och ModelScope Studio , med upplevelser för Qwen3-Omni-Realtime, Instruct, Thinking och Captioner. Qwen Chat med realtidsströmning är också tillgängligt: välj bara alternativet för röst-/videosamtal i gränssnittet.
För skalbar integration med låg latens rekommenderas DashScope API , vilket erbjuder den mest förutsägbara prestandan. Dessutom koordinerar communityn via kanaler som Discord och WeChat , och publicerar kokböcker med verkliga exekveringsloggar som gör det möjligt för användare att reproducera resultat genom att ändra prompter eller modeller.
Färdplan och pågående förbättringar
Teamet arbetar med ytterligare funktioner som taligenkänning för flera högtalare , OCR tillämpad på video, förbättringar av proaktiv audiovisuell inlärning och rikare arbetsflöden för agenter . De indikerade också att stöd för ljudutgång i vLLM för Instruct-modellen snart kommer att finnas tillgängligt, vilket slutför realtidsdistributionscykeln från den backend-plattformen.
Vanliga frågor: Stöd för körtid och kvantisering
Vissa användare har kommenterat att de inte kan köra Qwen3-Omni ens med de vanliga misstänkta och att de inte ser kvantfunktioner i Hugging Face ; dessutom är det ursprungliga 16-bitarsformatet runt 70 GB, en storlek som är problematisk för blygsamma datorer. Själva projektet förtydligar att Transformers redan är sammanslagna men utan PyPI-paketet , som måste installeras från källkoden, och att vLLM är det föredragna alternativet för inferens, även om Instruct-ljudstöd i vLLM kommer att släppas inom en snar framtid.
Angående kvantisering finns det ännu inga platshållare listade i HF för Qwen3-Omni 30B-A3B, och det är värt att komma ihåg att MoE- och multimodala karaktären komplicerar omedelbar kompatibilitet med runtimes som llama.cpp. För de som behöver testa nu är den officiella rekommendationen att använda Docker + Transformers/vLLM från källkoden eller API:et , och hålla ett öga på repository för support pull requests och framtida kvantiseringar när de är tillgängliga.
Goda utvärderingsrutiner och uppmaningar
För att reproducera siffrorna beskrivs följande riktlinjer: de flesta riktmärken använder girig avkodning i Instruct utan sampling, och för Thinking måste parametrarna i generation_config.json respekteras . Videobildfrekvensen är också inställd på fps=2 under utvärderingen, och det indikeras att användarprompten ska följa multimodal data om inte datasetet anger annat.
När ett riktmärke inte innehåller en prompt kan standardprompterna användas (kinesisk ASR/annan, S2TT, sångtexter). Dessutom bör systemprompten inte ställas in under utvärderingen för att säkerställa att resultaten är jämförbara mellan system och körningar.
Qwen3-Omni positionerar sig som en verkligt omnimodal plattform med låg latens, brett flerspråkigt stöd, banbrytande ljud- och videofunktioner och en tydlig distributionsväg med Transformers, vLLM och Docker. För de som söker en enda modell som hanterar text och bilder sömlöst utan att offra prestanda, och som också lyssnar, talar och förstår video , är det ett erbjudande som är svårt att slå idag.