- ใน Linux ท่อ (Pipes) ช่วยให้คุณสามารถเชื่อมโยงกระบวนการต่างๆ เข้าด้วยกันโดยการเชื่อมต่อ stdout และ stdin โดยมีการสนับสนุนจากเคอร์เนลและเครื่องมือต่างๆ เช่น tee, xargs และ cpio สำหรับการไหลที่ซับซ้อนยิ่งขึ้น
- ไปป์ไลน์ CI/CD ที่มีประสิทธิภาพใน Linux อาศัยการออกแบบขั้นตอนที่ดี การใช้แคชอย่างมีประสิทธิภาพ อาร์ติแฟกต์ที่ไม่เปลี่ยนแปลง และการทดสอบแบบขนาน
- การเพิ่มประสิทธิภาพเซิร์ฟเวอร์ Linux (CPU, RAM, I/O, Docker) และตัวดำเนินการ Jenkins, GitHub Actions หรือ GitLab Runner เป็นกุญแจสำคัญในการลดเวลาการทำงาน
- การผสานรวมระบบรักษาความปลอดภัย การตรวจสอบ และการควบคุมต้นทุนเข้ากับกระบวนการทำงาน ช่วยให้มั่นใจได้ว่าการใช้งานในสภาพแวดล้อมการผลิตมีความน่าเชื่อถือ ตรวจสอบได้ และยั่งยืน
การเพิ่มประสิทธิภาพไปป์ไลน์ในลินุกซ์ มันไม่ใช่แค่การเชื่อมต่อคำสั่งต่างๆ ด้วยสัญลักษณ์เท่านั้น |เบื้องหลังทั้งหมดนั้นคือโลกทั้งใบ การเพิ่มประสิทธิภาพการทำงานการออกแบบเวิร์กโฟลว์, CI/CD, ความปลอดภัย และการปรับแต่งระบบปฏิบัติการ คือปัจจัยสำคัญที่ทำให้ไปป์ไลน์ทำงานได้เร็วขึ้น เชื่อถือได้ และบำรุงรักษาได้ในราคาประหยัด ต่างจากไปป์ไลน์ที่ช้าและไม่เสถียร หากคุณทำงานกับเซิร์ฟเวอร์ Linux ไม่ว่าจะเป็นการทำงานอัตโนมัติในเทอร์มินัลหรือการรันไปป์ไลน์การรวมระบบอย่างต่อเนื่อง การเข้าใจรายละเอียดเหล่านี้จะช่วยประหยัดเวลาและลดปัญหาต่างๆ ได้มาก
ในบทความนี้ เราจะนำมุมมองที่เสริมกันสองประการมาผสมผสานกัน: ในด้านหนึ่งคือ... การใช้งานไปป์แบบคลาสสิกในบรรทัดคำสั่งของลินุกซ์ (ท่อ, การเปลี่ยนเส้นทาง, คำสั่งต่างๆ เช่น) tee, xargs o cpio); อีกด้านหนึ่ง การเพิ่มประสิทธิภาพไปป์ไลน์ CI/CD บนเซิร์ฟเวอร์ Linuxเนื้อหานี้ครอบคลุมถึงการแคชข้อมูล การทดสอบแบบขนาน การปรับแต่ง Docker ความปลอดภัยของห่วงโซ่อุปทาน และเมตริกเวิร์กโฟลว์ขั้นสูง ทั้งหมดนี้อธิบายเป็นภาษาสเปน (จากประเทศสเปน) พร้อมตัวอย่างที่ชัดเจนและแนวทางที่ใช้งานได้จริง
ไปป์ไลน์คืออะไร และไปป์ไลน์มีความเกี่ยวข้องกับลินุกซ์อย่างไร?
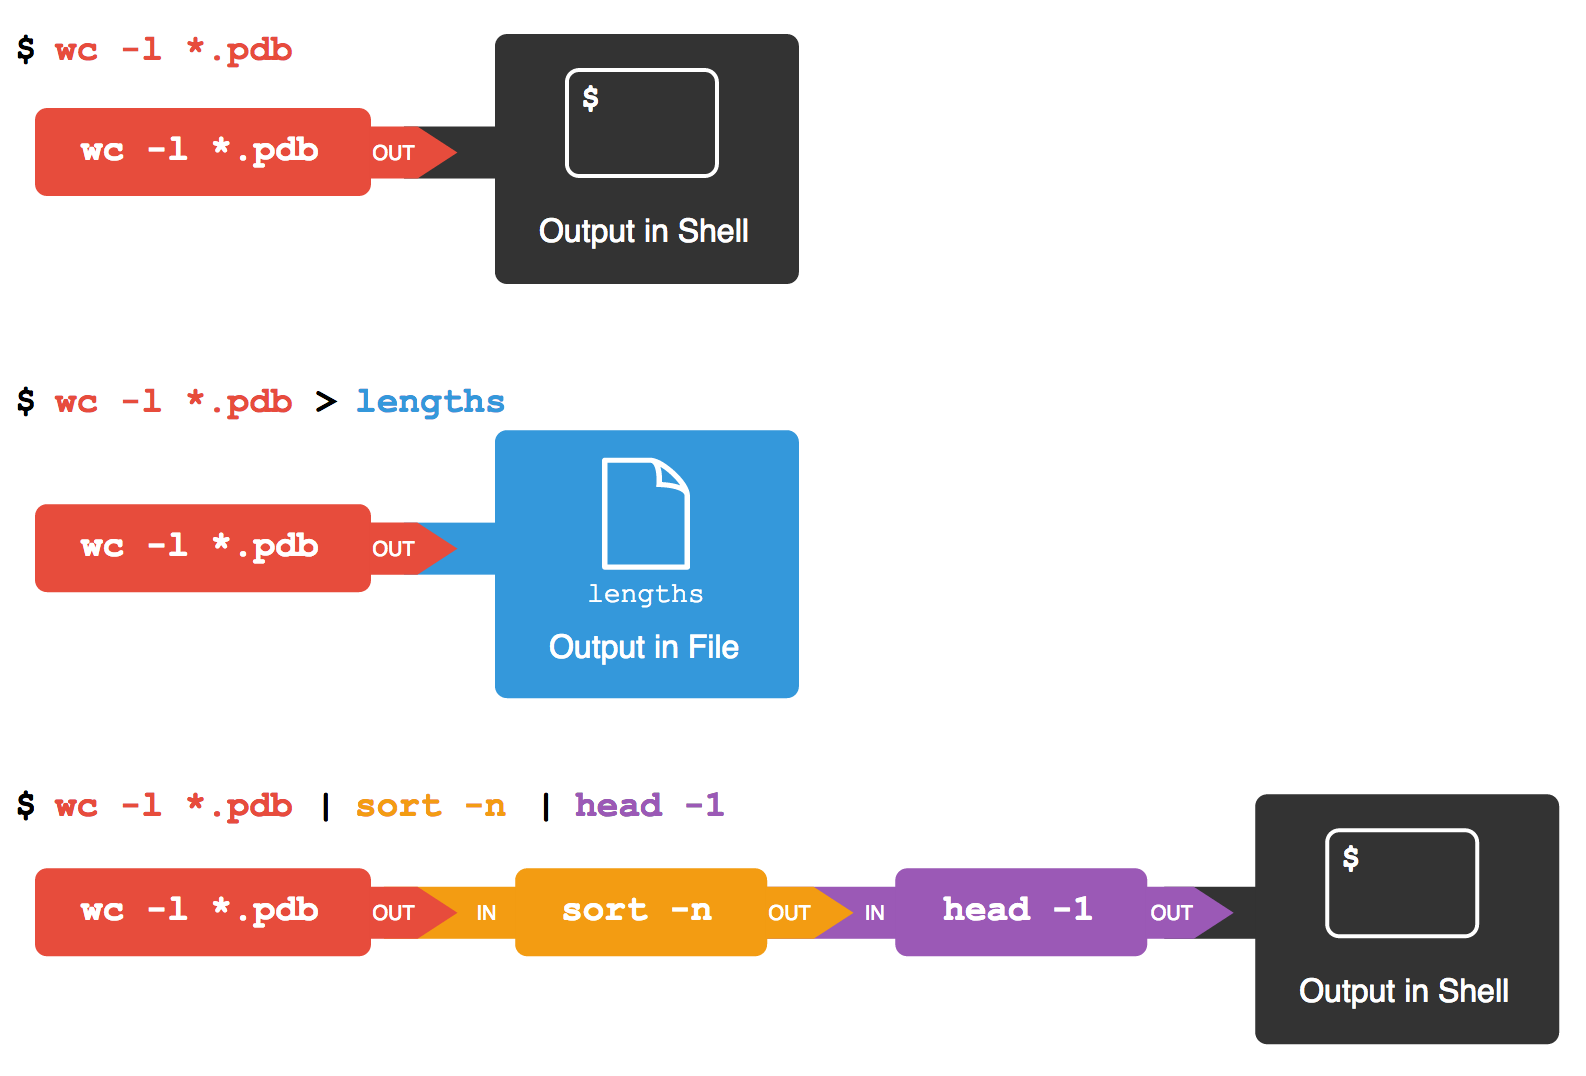
คำว่าpipeline มาจากแนวคิดของท่อ : การไหลของข้อมูลที่เดินทางจากจุดหนึ่งไปยังอีกจุดหนึ่ง ในด้านคอมพิวเตอร์ โดยเฉพาะใน Linux ท่อเป็นกลไกที่ช่วยให้เอาต์พุตมาตรฐานของกระบวนการหนึ่งกลายเป็นอินพุตมาตรฐานของอีกกระบวนการหนึ่ง กล่าวอีกนัยหนึ่งคือ เอาต์พุตของคำสั่งหนึ่งจะถูกส่งต่อไปยังคำสั่งถัดไปโดยอัตโนมัติโดยไม่ต้องผ่านไฟล์ตัวกลาง
ในระบบที่คล้าย Unix มีท่ออยู่สองประเภทหลัก ประเภทแรกคือท่อที่ไม่ระบุชื่อซึ่งใช้ได้เฉพาะระหว่างกระบวนการที่เกี่ยวข้องกันอย่างใกล้ชิดเท่านั้น (เช่น กระบวนการแม่และกระบวนการลูก) ประเภทที่สองคือท่อที่ระบุ ชื่อ หรือ ที่ เรียกว่า FIFO (First In – First Out) ซึ่งอนุญาตให้สื่อสารระหว่างกระบวนการที่ไม่เกี่ยวข้องกันโดยตรง และอาจอยู่บนเครื่องที่แตกต่างกันแต่เชื่อมต่อกันในเครือข่ายก็ได้
โดยทั่วไป แล้วไปป์แบบไม่ระบุชื่อจะให้การสื่อสารแบบทิศทางเดียว กล่าว คือ กระบวนการหนึ่งเขียนข้อมูล และอีกกระบวนการหนึ่งอ่านข้อมูล ในทางตรงกันข้าม ไปป์แบบระบุชื่อจะอนุญาตให้มี การสื่อสาร แบบสองทิศทาง หากได้รับการออกแบบมาเช่นนั้น เช่น โดยการเปิด FIFO ในโหมดอ่าน/เขียนจากทั้งสองด้าน ไปป์แบบระบุชื่อถูกใช้กันอย่างแพร่หลายเพื่อประสานงานกระบวนการดีมอน สคริปต์ หรือบริการที่ต้องการส่งข้อมูลถึงกันโดยไม่เกิดการบล็อก
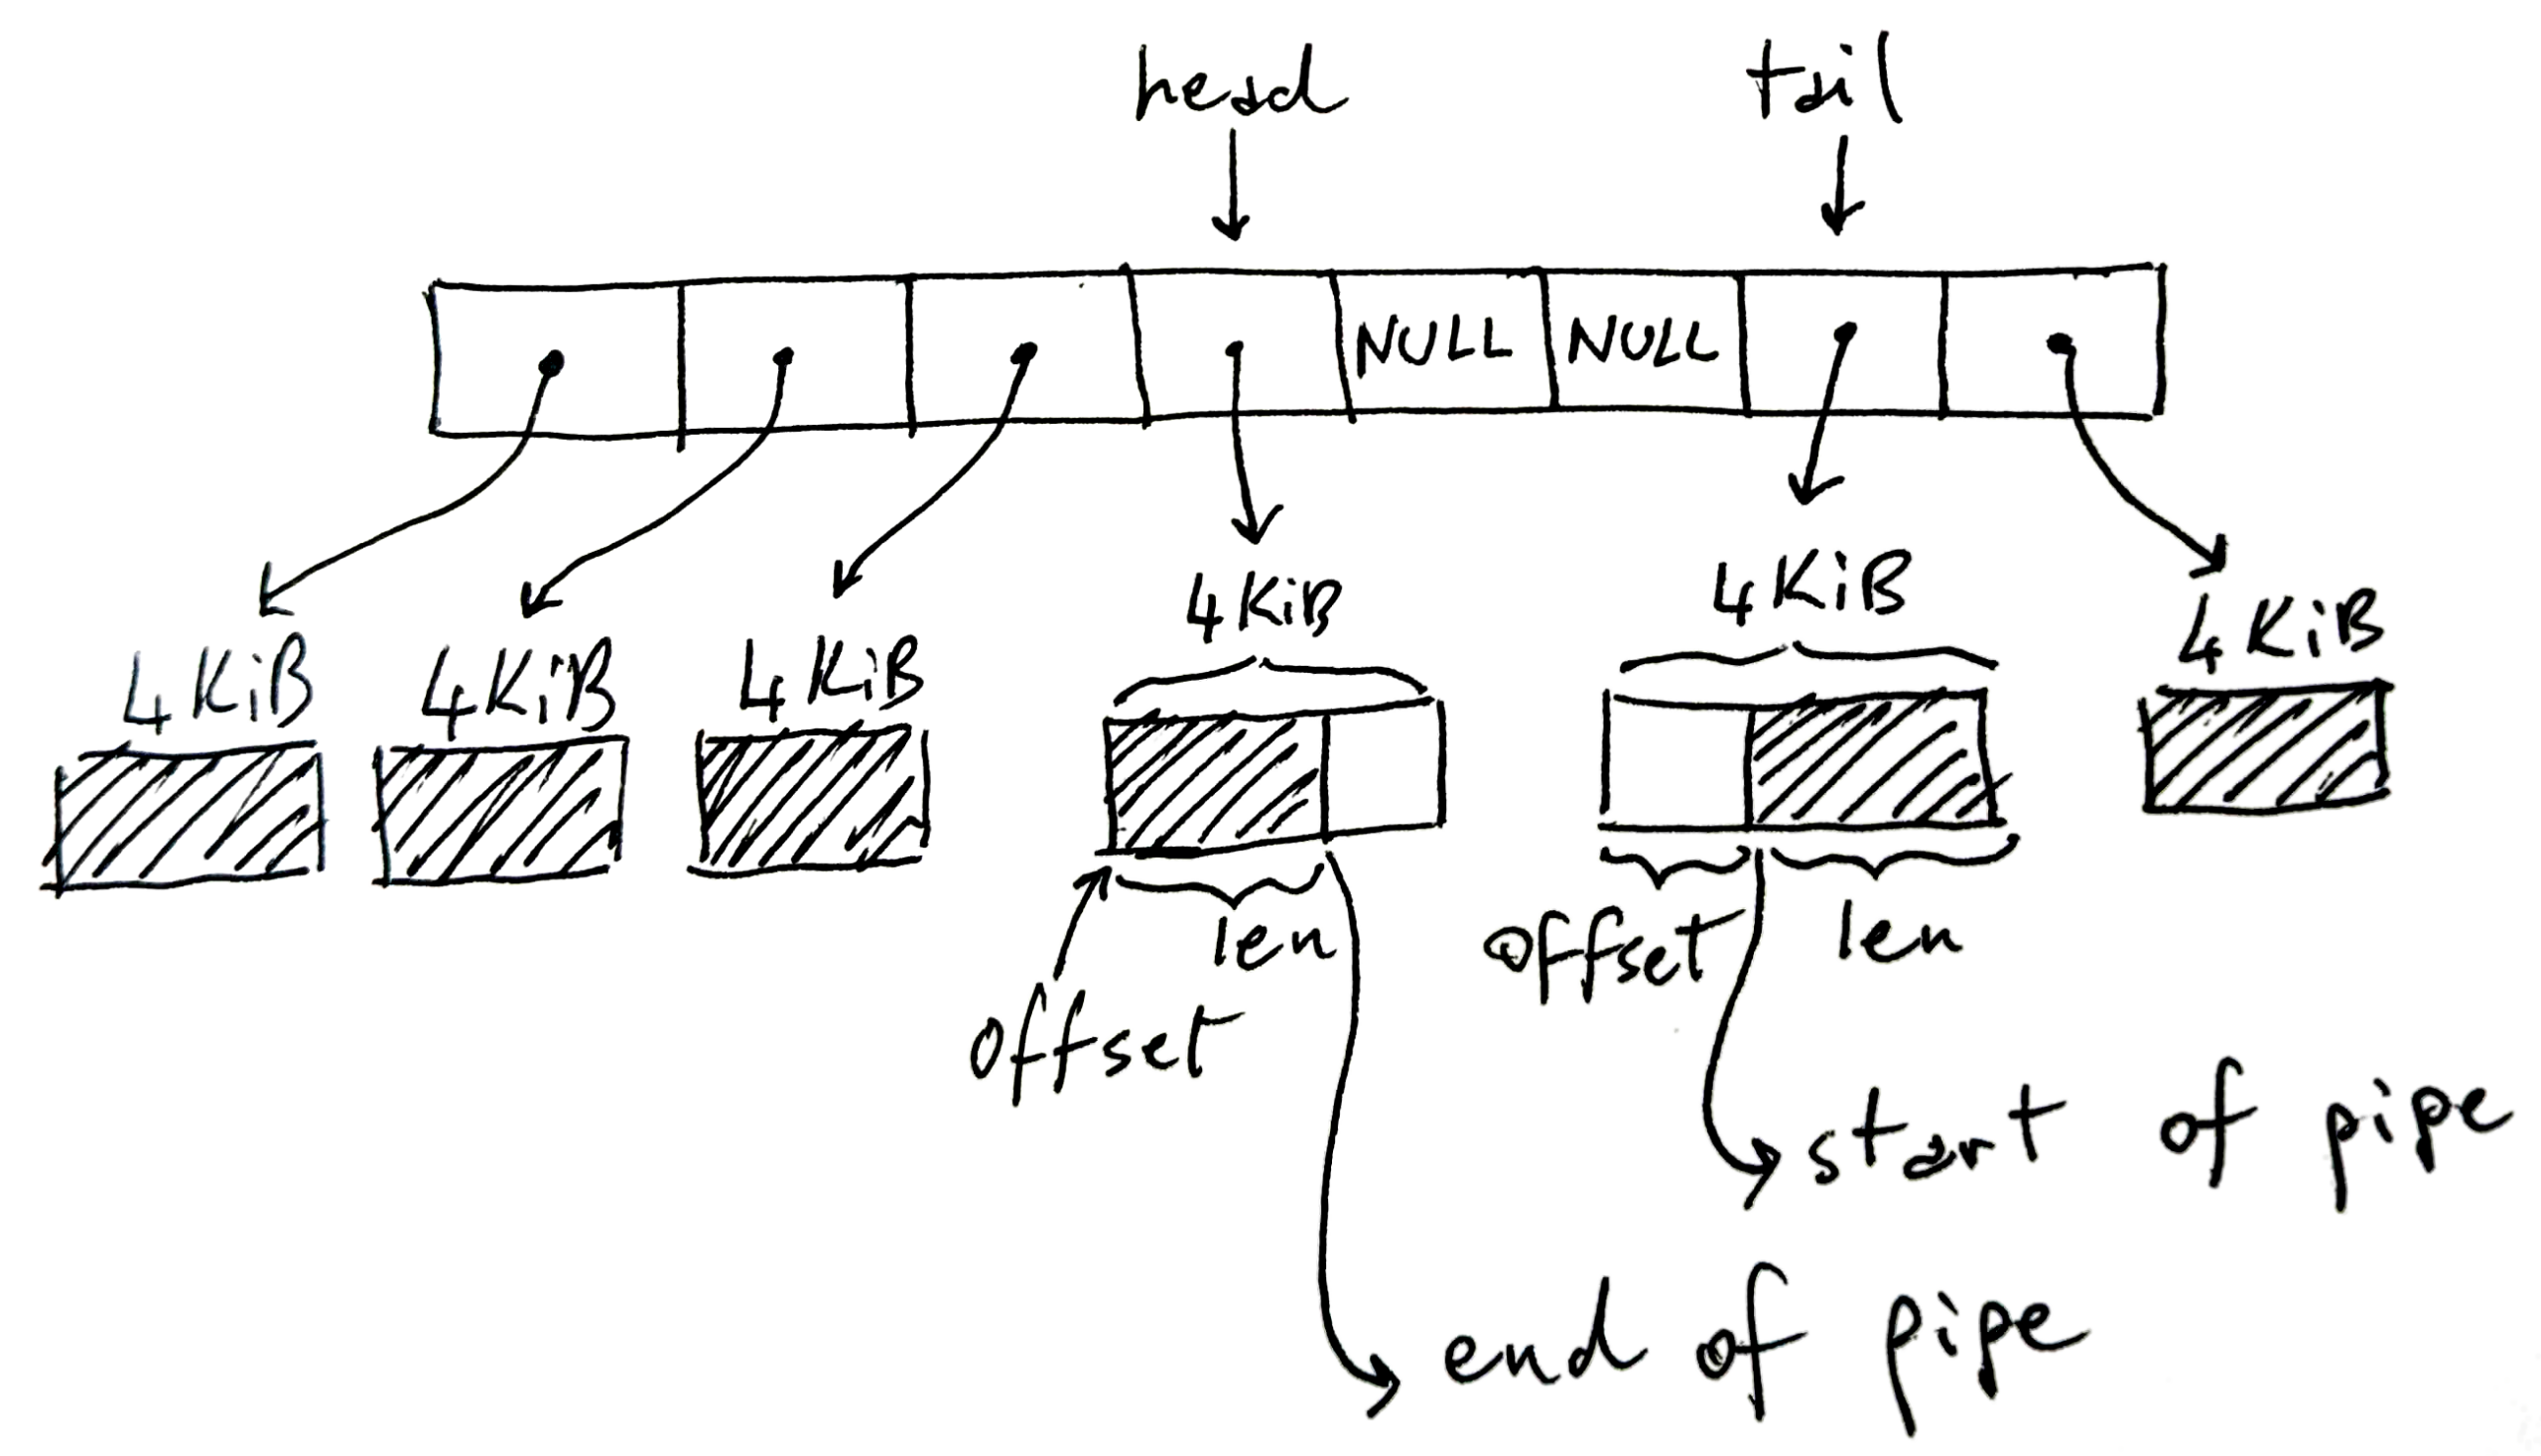
ในระดับการนำไปใช้งาน การสนับสนุนสำหรับไปป์ไลน์นั้นอยู่ใน... เคอร์เนลลินุกซ์ไม่ใช่ในเชลล์ ตัวแปลคำสั่ง (bash, zsh ฯลฯ) เพียงแค่สร้างไปป์ไลน์ผ่านการเรียกใช้ระบบ เช่น pipe() y fork()ทำการเปลี่ยนเส้นทางตัวระบุไฟล์ จากนั้นจึงเริ่มโปรแกรมแต่ละโปรแกรม กลไกสำคัญในการบล็อกกระบวนการ การจัดการบัฟเฟอร์ และการส่งต่อข้อมูลระหว่างผู้ผลิตและผู้บริโภคนั้น ถูกจัดการโดยเคอร์เนลของระบบ
ทำความเข้าใจเกี่ยวกับ stdin, stdout และการไหลของข้อมูล
เพื่อให้ทำงานกับไปป์ไลน์ได้อย่างมีประสิทธิภาพ จำเป็นอย่างยิ่งที่จะต้องเข้าใจว่าstdin, stdout และ stderr คืออะไร สิ่งเหล่านี้ไม่ใช่แนวคิดนามธรรม: ทุกกระบวนการใน Linux เริ่มต้นด้วยตัวระบุไฟล์ที่เปิดอยู่สามตัว ซึ่งชี้ไปยังทรัพยากรเฉพาะที่จัดการโดยเคอร์เนล
stdin (ตัวอธิบาย 0) และ stdout (ตัวอธิบาย 1)สามารถมองได้ว่าเป็นสตรีมไบต์ที่เชื่อมต่อกับบางสิ่งบางอย่าง เช่น เทอร์มินัล ไฟล์ ซ็อกเก็ตเครือข่าย หรือไปป์ พวกมันไม่ใช่เพียงแค่บัฟเฟอร์ แต่เป็นข้อมูลอ้างอิงถึงอ็อบเจ็กต์ของเคอร์เนล ( โครงสร้างประเภท ไฟล์ ) ซึ่งเชื่อมโยงกับ inode ซ็อกเก็ต หรือโครงสร้างไปป์ภายใน
แต่ละกระบวนการมีตัวบ่งชี้เฉพาะของตนเอง ดังนั้น แต่ละคำสั่งในไปป์ไลน์ มันมองอินพุตมาตรฐาน (stdin) และเอาต์พุตมาตรฐาน (stdout) แยกจากกัน ในบรรทัดเช่นนี้ ls | grep txt | wc -l, ls เขียนลงในท่อ grep มันอ่านข้อมูลจากท่อหนึ่งและเขียนข้อมูลไปยังอีกท่อหนึ่ง และ wc อ่านจากอันสุดท้าย สำหรับผู้ใช้แล้วมันจะปรากฏเป็นสตริงเดียว แต่ภายในแล้วมันมีหลายสตริงแยกกัน บัฟเฟอร์เคอร์เนลที่ต่อกันหลายตัวโดยแต่ละกระบวนการจะหยุดชั่วคราวและเริ่มทำงานต่อ ขึ้นอยู่กับพื้นที่ว่างหรือข้อมูลที่มีอยู่
เมื่อกระบวนการแรกสร้างข้อมูลได้เร็วกว่าที่กระบวนการที่สองใช้ข้อมูลนั้น บัฟเฟอร์ของไปป์จะเต็ม ณ จุดนั้น การเขียนข้อมูลครั้งต่อๆ ไปจะส่งค่ากลับ ทำให้กระบวนการส่งข้อมูลถูกบล็อกจนกว่ากระบวนการใช้ข้อมูลจะ... อ่านข้อมูลให้เพียงพอ และช่วยเพิ่มพื้นที่ว่าง ซึ่งจะช่วยป้องกันไม่ให้หน่วยความจำเพิ่มขึ้นจนควบคุมไม่ได้ ข้อมูลจะไม่สะสมไปเรื่อยๆ เว้นแต่คุณจะใช้การรับส่งข้อมูลแบบไม่บล็อก (non-blocking I/O) หรือสัญญาณพิเศษ ตัวอย่างเช่น ในกรณีเช่นนี้ dd if=/dev/sda | gzip -9และ gzip บีบอัดช้าลง dd เขาถูกบังคับให้รอ
กลไกการควบคุมแรงดันย้อนกลับนี้ทำให้ไปป์ไลน์มีความเสถียรมาก แม้ว่าจะมีความไม่สมดุลด้านประสิทธิภาพระหว่างขั้นตอนต่างๆ ซึ่งสิ่งนี้ก็สะท้อนให้เห็นในการออกแบบไปป์ไลน์ CI/CD ด้วยเช่นกัน โดยขั้นตอนที่ช้าจะกลายเป็นคอขวดที่ต้องวัดผลและปรับให้เหมาะสม
การใช้งานจริงของท่อ (pipes) ในเทอร์มินัล Linux
ในการใช้งานทั่วไป เครื่องหมายไปป์ (pipe) ใช้สำหรับเชื่อมต่อคำสั่งต่างๆ ในบรรทัดเดียวและแปลงข้อมูลทีละขั้นตอน แทนที่จะรันคำสั่ง ดูผลลัพธ์ คัดลอก แล้ววางลงในคำสั่งอื่น คุณสามารถสร้าง "โรงงานข้อมูล" ขนาดเล็กที่มีความยืดหยุ่นสูงได้ในรูปแบบข้อความธรรมดา
ตัวอย่างทั่วไปในสภาพแวดล้อม Unix คือการรวมคำสั่งเข้าด้วยกัน fortuneซึ่งแสดงคำคมแบบสุ่ม พร้อมด้วย cowsayซึ่งพิมพ์รูปวัว "พูดได้" เมื่อใช้ท่อ การจากไปของฟอร์จูนกลายเป็นข้อความจากคาวเซย์ทั้งหมดนี้ทำได้ด้วยคำสั่งเดียว นี่เป็นตัวอย่างที่สนุกสนาน แต่แสดงให้เห็นถึงแนวคิดของการเชื่อมต่อเครื่องมือพื้นฐานเพื่อทำงานที่ซับซ้อนยิ่งขึ้นได้อย่างสมบูรณ์แบบ
อีกหนึ่งวิธีคลาสสิกคือการส่งผลลัพธ์ของ ls a wc เพื่อนับจำนวนบรรทัด คำ และตัวอักษร อะไรทำนองนั้น ls | wc โปรแกรมนี้ช่วยให้คุณเห็นจำนวนรายการสินค้าได้อย่างรวดเร็ว ข้อดีคือคุณไม่จำเป็นต้องใช้โปรแกรมเดียวในการทำทุกอย่าง แต่... คุณสร้างโซลูชันด้วยเครื่องมือขนาดเล็กที่ออกแบบมาอย่างดี.
นอกจากนี้ การเชื่อมต่อกันเป็นลูกโซ่ก็เป็นเรื่องที่พบได้บ่อยมากเช่นกัน cat, sort y more (หรือโปรแกรมแสดงผลหลายหน้าอื่นๆ) เพื่อจัดเรียงไฟล์ข้อความแล้วเรียกดูทีละหน้า ด้วยการใช้ไปป์ เนื้อหาจะส่งผ่านจากคำสั่งหนึ่งไปยังอีกคำสั่งหนึ่งโดยไม่ต้องบันทึกไปยังไฟล์ชั่วคราวโดยเฉพาะ ซึ่งช่วยลดความซับซ้อนของการเขียนสคริปต์และงานด้านการบริหารจัดการได้อย่างมาก
ในกรณีใช้งานจริง เช่น การประมวลผลรายชื่อนักเรียนและเกรดในไฟล์แยกต่างหาก คุณสามารถใช้ paste เพื่อรวมคอลัมน์ cut เพื่อเลือกเฉพาะฟิลด์ที่คุณสนใจ และใช้คำสั่ง pipe ต่อเนื่องกันเพื่อกรอง จัดเรียง หรือแปลงทุกอย่างในบรรทัดเดียวของสคริปต์เชลล์ รูปแบบนี้คือ แบ่งปัญหาใหญ่ๆ ออกเป็นคำสั่งง่ายๆ ที่ผสานเข้าด้วยกันโดยใช้ท่อ (pipes) นี่คือแก่นแท้ของปรัชญา Unix
คำสั่งขั้นสูงเพื่อการใช้งานไปป์ไลน์อย่างเต็มประสิทธิภาพ: tee, xargs และ cpio
เมื่อคุณเริ่มทำการทำงานอัตโนมัติอย่างแท้จริงใน Linux ท่อส่งข้อมูล (pipes) จะมีประสิทธิภาพมากยิ่งขึ้นด้วยเครื่องมือสำคัญบางอย่าง ซึ่งได้แก่: tee, xargs y cpioซึ่งช่วยเสริมการไหลเวียนของข้อมูลมาตรฐานได้เป็นอย่างดี
คำสั่ง tee มันทำงานเหมือนข้อต่อรูปตัว "T" ในท่อน้ำ: มันอ่านข้อมูลจาก stdin เขียนข้อมูลไปยัง stdout และคัดลอกข้อมูลนั้นไปยังไฟล์หนึ่งไฟล์หรือมากกว่านั้น เหมาะอย่างยิ่งเมื่อคุณต้องการ ดูผลลัพธ์บนหน้าจอและบันทึกไปพร้อมกัน เพื่อตรวจสอบในภายหลังหรือดำเนินการในขั้นตอนอื่น โดยมีตัวเลือกดังกล่าว -a ฟังก์ชันนี้จะเพิ่มข้อมูลลงไปที่ส่วนท้ายของไฟล์ แทนที่จะเขียนทับข้อมูลเดิม
ตัวอย่างเช่น คุณสามารถเรียงลำดับรายการด้วย sortส่งผลลัพธ์ไปที่ tee เพื่อบันทึกไว้ในไฟล์บันทึก และในขณะเดียวกันก็ส่งต่อไปยัง more เพื่อแบ่งหน้าข้อมูล ด้วยวิธีนี้ คุณจะสามารถเรียงลำดับ บันทึกข้อมูลลงดิสก์ และดูข้อมูลได้อย่างสะดวกในขั้นตอนเดียว โดยไม่ต้องทำซ้ำขั้นตอนการเรียงลำดับอีก
คำสั่ง xargs นี่เป็นอีกหนึ่งส่วนประกอบพื้นฐานเมื่อพูดถึงไปป์ไลน์ หน้าที่ของมันคือรับสิ่งที่เข้ามาทาง stdin (โดยปกติจะเป็นรายการขององค์ประกอบ) และแปลงเป็นอาร์กิวเมนต์สำหรับคำสั่งอื่น มันมีประโยชน์อย่างยิ่งเมื่อโปรแกรมหยุดทำงานเนื่องจากได้รับพารามิเตอร์มากเกินไปในคราวเดียว หรือเมื่อคุณต้องการ... แบ่งงานออกเป็นชุดๆ พร้อมตัวเลือก -nซึ่งจะจำกัดจำนวนอาร์กิวเมนต์ที่ส่งผ่านต่อการดำเนินการแต่ละครั้ง
ตัวอย่างเช่นด้วย ls | xargs -n 4 คุณแบ่งรายการไฟล์ออกเป็นกลุ่มละสี่ไฟล์ แล้วเรียกใช้คำสั่งเป้าหมาย (ตามค่าเริ่มต้น) echo(หรืออันที่คุณระบุ) หลายๆ ครั้ง ด้วยวิธีนี้คุณสามารถสร้างไปป์ไลน์ได้ เช่น "ดูตัวอย่างสิ่งที่จะลบ" โดยการรวมกัน ls, xargs y echo rm ก่อนที่จะเริ่มการล้างข้อมูลจริง
โปรดระมัดระวังเมื่อป้อนข้อมูลที่ซับซ้อน: เส้นทางที่มีช่องว่างหรืออักขระพิเศษ สามารถเปลี่ยนแปลงพฤติกรรมเริ่มต้นของ xargsในกรณีเหล่านั้น มักจะใช้ร่วมกับ find และตัวเลือก -print0ซึ่งแยกองค์ประกอบด้วยอักขระว่าง พร้อมกับ xargs -0 เพื่อให้ปลายทั้งสองด้านใช้ตัวคั่นที่แข็งแรงทนทานเหมือนกัน
ในที่สุด cpio เป็นคำสั่งที่คนรู้จักน้อยกว่า tarแต่โปรแกรมนี้มีความยืดหยุ่นสูงมากสำหรับการทำงานกับไฟล์สตรีมผ่านทางไปป์ ต่างจาก tar ตรงที่มันถูกออกแบบมาตั้งแต่เริ่มต้นให้ทำงานร่วมกับ... การเปลี่ยนเส้นทางและท่อ: รับรายการไฟล์ผ่านทาง stdin (โดยปกติจะสร้างขึ้นด้วย find) และสร้างหรือใช้งานไฟล์ประเภท "แพ็กเกจ" โดยไม่มีการบีบอัดในตัว ซึ่งคุณสามารถบีบอัดได้ในภายหลังด้วย gzip หรือคล้ายกัน
โหมดหลักของ cpio อนุญาตให้สร้างไฟล์ (-o), คัดลอกโครงสร้างไดเร็กทอรี (-p) หรือดึงเนื้อหา (-i(มักเรียกว่า “การคัดลอกเข้า”) ตัวเลือกต่างๆ เช่น -u เพื่อเขียนทับ -m เพื่อรักษาระบบเวลาหรือ -d การสร้างโครงสร้างไดเร็กทอรีขึ้นใหม่ทำให้เป็นไปได้ เพื่อควบคุมรายละเอียดว่าอะไรถูกคัดลอกและอย่างไรโดยเฉพาะอย่างยิ่งมีประโยชน์ในสคริปต์ที่ซับซ้อน tar ตกไม่ถึง
การออกแบบและเพิ่มประสิทธิภาพของไปป์ไลน์ CI/CD บนเซิร์ฟเวอร์ Linux
นอกเหนือจากบรรทัดคำสั่งแบบดั้งเดิมแล้ว แนวคิดของไปป์ไลน์ได้กลายเป็นสิ่งสำคัญในโลกของการบูรณาการอย่างต่อเนื่องและการส่งมอบอย่างต่อเนื่อง (CI/CD)บนเซิร์ฟเวอร์ Linux ไปป์ไลน์ CI/CD คือลำดับขั้นตอนอัตโนมัติ ได้แก่ การดึงโค้ด การติดตั้งส่วนประกอบที่จำเป็น การคอมไพล์ การรันการทดสอบ การบรรจุไฟล์ และการปรับใช้
ลินุกซ์เหมาะอย่างยิ่งสำหรับงานนี้ เพราะโดดเด่นในเรื่องความเร็ว ความเสถียร และระบบนิเวศของเครื่องมืออัตโนมัติแพลตฟอร์มต่างๆ เช่น Jenkins, GitHub Actions และ GitLab CI อาศัยตัวประมวลผลลินุกซ์ (เครื่องจริง เครื่องเสมือน หรือคอนเทนเนอร์) เพื่อรันไปป์ไลน์อย่างสม่ำเสมอ
การเพิ่มประสิทธิภาพของไปป์ไลน์เหล่านี้ไม่ได้หมายความเพียงแค่ทำให้มัน "ใช้งานได้" เท่านั้น แต่ยังหมายถึงการทำให้มันใช้งานได้โดยมีอุปสรรคน้อยที่สุด ซึ่งหมายถึงการลดเวลาในการตรวจสอบ ลดการติดตั้งส่วนประกอบที่ซ้ำซ้อนให้น้อยที่สุดเพิ่มประสิทธิภาพอิมเมจ Dockerเพื่อหลีกเลี่ยงการสร้างใหม่ที่ไม่จำเป็น การนำอาร์ติแฟกต์ที่สร้างไว้แล้วกลับมาใช้ใหม่ และการรักษาความปลอดภัยและความสามารถในการตรวจสอบสภาพแวดล้อม
หลักปฏิบัติพื้นฐานที่ดีคือการจัดโครงสร้างไปป์ไลน์ออกเป็นขั้นตอนที่ชัดเจน ได้แก่การสร้าง การทดสอบ และการปรับใช้ โดยในอุดมคติแล้ว คุณควรคอมไพล์เพียงครั้งเดียว สร้างอาร์ติแฟกต์ (ไบนารี แพ็กเกจ อิมเมจ Docker) ที่ทดสอบแบบขนานในรูปแบบต่างๆ (เช่น เวอร์ชันภาษาต่างๆ) แล้วจึงปรับใช้อาร์ติแฟกต์เดียวกันนั้นไปยังสภาพแวดล้อมการทดสอบและการใช้งานจริงโดยไม่ต้องคอมไพล์ใหม่
การทำงานกับอาร์ติแฟกต์ที่ไม่สามารถเปลี่ยนแปลงได้ซึ่งจัดเก็บไว้ในที่เก็บข้อมูล (S3, Nexus, Artifactory, รีจิสทรีคอนเทนเนอร์ หรือแพ็กเกจที่ฝังอยู่ใน GitLab/GitHub) ช่วยให้การตรวจสอบทำได้ง่ายขึ้น ช่วยให้สามารถย้อนกลับเวอร์ชันได้อย่างรวดเร็ว และลดโอกาสที่จะเกิดปัญหา "มันใช้งานได้บนเครื่องของฉัน แต่ใช้งานไม่ได้ในสภาพแวดล้อมการผลิต"
ข้อกำหนดเบื้องต้น: การแจกจ่าย, ผู้ใช้ CI และการเสริมความแข็งแกร่งของเซิร์ฟเวอร์
ก่อนที่จะไปลงลึกกับการปรับแต่งประสิทธิภาพในระดับมิลลิวินาที สิ่งสำคัญคือต้องสร้างรากฐานที่มั่นคงบนเซิร์ฟเวอร์ Linuxที่จะทำหน้าที่เป็นตัวดำเนินการ CI/CD ก่อน ซึ่งเริ่มต้นจากการเลือกเวอร์ชันของระบบปฏิบัติการและการกำหนดค่าความปลอดภัยขั้นต่ำ
แนวทางที่เหมาะสมที่สุดมักจะเป็นการเลือกใช้ระบบ ปฏิบัติการเวอร์ชัน LTS หรือเวอร์ชันเสถียรที่ทีมคุ้นเคย เช่น Ubuntu LTS, Debian Stable หรือระบบปฏิบัติการระดับองค์กรอย่าง AlmaLinux หรือ Rocky Linux การใช้ระบบปฏิบัติการเวอร์ชันเดียวกันจะช่วยป้องกันพฤติกรรมที่ไม่คาดคิดที่เกิดจากไลบรารีหรือเคอร์เนลที่แตกต่างกันระหว่างงานต่างๆ
ข้อแนะนำอีกประการหนึ่งคือการกำหนดค่า ผู้ใช้งานเฉพาะสำหรับ CIโดยไม่ต้องใช้สิทธิ์ root และใช้ sudo อย่างจำกัดเฉพาะคำสั่งที่จำเป็นเท่านั้น (ตัวอย่างเช่น systemctl o docker (หากจำเป็นจริงๆ) ผู้ใช้รายนี้ต้องยืนยันตัวตนโดยใช้คีย์ SSH ทั้งในการเข้าถึงเซิร์ฟเวอร์และในการโต้ตอบกับที่เก็บ Git หรือเครื่องระยะไกลอื่นๆ
ในระดับระบบ แนะนำให้ทำการบำรุงรักษาเซิร์ฟเวอร์ ปรับปรุงใหม่และเสริมแรงขั้นต่ำซึ่งรวมถึงการติดตั้งการอัปเดตความปลอดภัย การกำหนดค่าไฟร์วอลล์ที่เข้มงวด (ตัวอย่างเช่น ด้วย UFW: ปฏิเสธการรับส่งข้อมูลขาเข้าทั้งหมด ยกเว้นสิ่งที่จำเป็น และอนุญาตการรับส่งข้อมูลขาออก) และการเปิดใช้งานเครื่องมือต่างๆ เช่น fail2ban เพื่อหยุดการโจมตีแบบ Brute-force บน SSH และปรับพารามิเตอร์เครือข่ายและเคอร์เนลบางอย่างผ่านทาง sysctl เพื่อปรับปรุงความน่าเชื่อถือและประสิทธิภาพ
ตัวอย่างเช่น เป็นเรื่องปกติที่จะเพิ่มขีดจำกัดของ แจ้งเตือน เพื่อป้องกันไม่ให้ระบบสร้างโปรแกรมที่ตรวจสอบไฟล์จำนวนมากหมดทรัพยากร และปรับค่าพารามิเตอร์ vm.swappiness เพื่อทำให้เคอร์เนลใช้หน่วยความจำสวอปอย่างประหยัดมากขึ้น ซึ่งมีความสำคัญอย่างยิ่งเมื่อกระบวนการ CI ใช้หน่วยความจำจำนวนมากในคราวเดียว
แคช, Docker และการประมวลผลแบบขนาน: ปัจจัยสำคัญในการเพิ่มประสิทธิภาพใน CI/CD
หากคุณดูว่าเวลาส่วนใหญ่ในไปป์ไลน์โดยเฉลี่ยหมดไปกับอะไร คุณจะเห็นว่าเวลาส่วนใหญ่สูญเสียไปกับการติดตั้งส่วนประกอบที่จำเป็นและการสร้างอิมเมจ Docker ใหม่การแก้ไขปัญหานี้มักจะมีประสิทธิภาพมากกว่าการปรับปรุงโค้ดทดสอบให้เร็วขึ้นเพียงไม่กี่มิลลิวินาที
กลยุทธ์แรกคือการแคชการพึ่งพา (dependency caching ) ตัวจัดการการพึ่งพาเกือบทั้งหมด (pip, npm, Maven, Gradle, Go modules ฯลฯ) ใช้ไดเร็กทอรีแคชในเครื่อง บนเซิร์ฟเวอร์ Linux ที่ทำงานอย่างต่อเนื่อง คุณสามารถแชร์ไดเร็กทอรีเหล่านี้ระหว่างงานต่างๆ หรือเมานต์พวกมันบนไดรฟ์ข้อมูลถาวรได้ ด้วยวิธีนี้ การทำงานแต่ละครั้งจะไม่ต้องดาวน์โหลดข้อมูลจากอินเทอร์เน็ตทั้งหมดอีกครั้ง
สำหรับ Docker ให้เปิดใช้งาน บิลด์คิท และจัดโครงสร้างให้ดี Dockerfile นี่ถือเป็นจุดเปลี่ยนสำคัญ การติดตั้งส่วนประกอบที่จำเป็น (dependency) ไว้หลังจากคัดลอกไฟล์ requirements และก่อนโค้ดส่วนที่เหลือ จะช่วยให้มั่นใจได้ว่าเลเยอร์ต่างๆ จะถูกนำมาใช้ซ้ำ ตราบใดที่เวอร์ชันของส่วนประกอบเหล่านั้นยังคงไม่เปลี่ยนแปลง นอกจากนี้ ยังสามารถตั้งค่าแคชเฉพาะสำหรับ pip, npm เป็นต้น ได้ภายในกระบวนการสร้าง (build) เองด้วย
กลไกสำคัญประการที่สองคือ การดำเนินการทดสอบแบบขนานเฟรมเวิร์กหลายตัวรองรับการทำงานแบบขนานโดยธรรมชาติ: pytest กับ -n autoเครื่องมือ Java เช่น Surefire, Jest ใน JavaScript พร้อมด้วย --maxWorkersเป็นต้น การแบ่งชุดทดสอบออกเป็นโมดูล โฟลเดอร์ หรือแม้แต่ตามเวลาที่คาดการณ์ไว้ และการกระจายงานให้แก่ผู้ปฏิบัติงานหลายคน จะช่วยลดระยะเวลาในการทดสอบลงได้ 2 ถึง 5 เท่า โดยไม่ต้องเปลี่ยนแปลงสายงานธุรกิจใดๆ เลย
สุดท้ายนี้ ยังมีประเด็นเรื่องไฟล์ผลลัพธ์และการปรับใช้แทนที่จะคอมไพล์อิมเมจเดียวกันซ้ำสำหรับสภาพแวดล้อมทดสอบ ก่อนการผลิต และการผลิต วิธีที่มีประสิทธิภาพคือการสร้างเพียงครั้งเดียว บันทึกผลลัพธ์ลงในที่เก็บข้อมูล และติดแท็กตามสภาพแวดล้อมการปรับใช้ วิธีนี้จะช่วยลดการใช้งาน CPU หลีกเลี่ยงความไม่สอดคล้องกัน และเร่งความเร็วของไปป์ไลน์ที่ยาวนานได้อย่างมาก
การเพิ่มประสิทธิภาพ Jenkins, GitHub Actions และ GitLab Runner บน Linux
ระบบ CI แต่ละระบบมีลักษณะเฉพาะของตนเอง แต่ทั้งหมดล้วนได้รับประโยชน์จากแนวคิดพื้นฐานเดียวกันเมื่อทำงานบนลินุกซ์ หัวใจสำคัญมักอยู่ที่การใช้ตัวดำเนินการชั่วคราวและสะอาดการรักษาแคชถาวรที่มีขนาดเหมาะสม และการควบคุมการทำงานพร้อมกัน
ใน Jenkins แนวปฏิบัติทั่วไปคือการใช้เอเจนต์ขนาดเล็กและชั่วคราว (เช่น คอนเทนเนอร์ Docker หรือพ็อดใน Kubernetes หรือ โซลูชัน การจัดการคอนเทนเนอร์ อื่นๆ ) เพื่อรันงานต่างๆ ในขณะที่รักษาโหนดหลักให้เรียบง่ายที่สุดเท่าที่จะเป็นไปได้ เอเจนต์เหล่านี้สามารถกำหนดค่าเป็นบริการ systemd บนเซิร์ฟเวอร์ Linux โดยลงทะเบียนกับคอนโทรลเลอร์และเริ่มต้นโดยอัตโนมัติเมื่อเครื่องบูต
สำหรับ GitHub Actions ที่ใช้รันเนอร์แบบโฮสต์เอง แนะนำให้ปรับใช้ใน เครื่องเสมือน Linux ที่ใช้ SSD ความเร็วสูงเพื่อสร้างไดเร็กทอรีแคชขนาดใหญ่ที่ใช้สำหรับดำเนินการต่างๆ (เช่น การพึ่งพาภาษา แคชการสร้าง ฯลฯ) ให้จำกัดจำนวนงานที่ทำงานพร้อมกันเพื่อหลีกเลี่ยงการโอเวอร์โหลด CPU และดิสก์ ใช้ประโยชน์จากการดำเนินการแคชอย่างเป็นทางการด้วยเส้นทางต่างๆ เช่น ~/.cache/pip, ~/.npm o ~/.m2 มันสร้างความแตกต่างอย่างมากในเรื่องของเวลา
ใน GitLab Runner การเลือกใช้ระหว่างshell executor และ Dockerขึ้นอยู่กับความสมดุลระหว่างประสิทธิภาพและการแยกส่วนที่คุณต้องการ shell executor เร็วกว่าเพราะทำงานโดยตรงบนโฮสต์ แต่ Docker executor ให้สภาพแวดล้อมที่สะอาดและทำซ้ำได้ นอกจากนี้ คุณยังสามารถกำหนดค่าแคชที่ใช้ร่วมกัน (ในเครื่องหรือบน S3) และปรับจำนวนงานพร้อมกันสูงสุดเพื่อใช้ประโยชน์จากฮาร์ดแวร์โดยไม่ทำให้โอเวอร์โหลด
ในทุกกรณี การมีวอลุ่มที่ใช้ร่วมกันสำหรับการแคชการพึ่งพาในขณะที่ป้องกันไม่ให้พื้นที่ทำงานรกเกินไประหว่างการสร้างนั้นมีความสำคัญอย่างยิ่ง เครื่องหรือคอนเทนเนอร์ชั่วคราว ซึ่งถูกสร้างและทำลายไปพร้อมกับแต่ละไปป์ไลน์หรือกลุ่มของไปป์ไลน์ จะช่วยลดปัญหา "เมื่อวานใช้งานได้ แต่วันนี้ใช้งานไม่ได้" ที่เกิดจากส่วนที่เหลือของการสร้างครั้งก่อนได้อย่างมาก
ประสิทธิภาพของเซิร์ฟเวอร์ Linux: CPU, หน่วยความจำ, I/O และ Docker
ไม่ว่าสคริปต์ของคุณจะได้รับการปรับแต่งมาดีแค่ไหน หากเซิร์ฟเวอร์ Linux ที่รันไปป์ไลน์นั้นมีขนาดไม่เหมาะสม คุณจะเจอปัญหาคิวงานยาวเหยียดและงานที่เคลื่อนไหวช้า การกำหนดค่าทั่วไปที่เหมาะสมสำหรับเครื่องระดับกลางคือ4-8 vCPU และ RAM 8-16 GBพร้อมพื้นที่จัดเก็บข้อมูล SSD (โดยเฉพาะอย่างยิ่ง NVMe) และพื้นที่สวอป (2-4 GB) เพื่อรองรับภาระงานสูงสุดโดยไม่ต้องปิดกระบวนการทำงานอย่างรุนแรง
ระบบไฟล์ก็มีความสำคัญเช่นกัน ควรใช้ ext4 หรือ XFS พร้อมตัวเลือกเสริม noatime ในไดรฟ์ที่คุณใช้ในการคอมไพล์หรือเขียนไฟล์บันทึก ให้ลดการอ่าน/เขียนข้อมูลที่ไม่จำเป็นลง นอกจากนี้ การเมานต์ไดรฟ์ก็เป็นสิ่งสำคัญเช่นกัน tmpfs สำหรับไฟล์ชั่วคราวหรือสิ่งประดิษฐ์ที่มีอายุสั้น (ตัวอย่างเช่น /mnt/ci-tmpช่วยเร่งความเร็วในการประมวลผลที่ต้องใช้ทรัพยากรมาก และป้องกันไม่ให้ดิสก์เต็มไปด้วยไฟล์ตกค้างระหว่างการทำงาน
สำหรับ Docker นั้น การดูแลรักษาความสะอาดของ daemon เป็นสิ่งสำคัญ การลบ image และ volume ที่ไม่ได้ใช้งานอย่างปลอดภัยและสม่ำเสมอ ในขณะที่ยังคงรักษา hot base image ไว้ จะช่วยให้... ควบคุมพื้นที่ดิสก์และเวลาบูตเครื่อง. คำสั่งเช่น docker system prune ด้วยตัวกรองเวลาที่เหมาะสม ระบบจะช่วยให้สามารถทำความสะอาดได้โดยไม่ทำให้ทรัพยากรที่ใช้งานล่าสุดทำงานหนักเกินไป
หากระบบ CI ของคุณใช้คอนเทนเนอร์เป็นจำนวนมาก คุณสามารถใช้รีจิสเตอร์แบบมิเรอร์เพื่อหลีกเลี่ยงการดาวน์โหลดจากอินเทอร์เน็ตอยู่เสมอ ใช้ BuildKit สำหรับการทำงานพร้อมกันและการแคชเลเยอร์ และแม้แต่กำหนดค่าความสัมพันธ์ของ CPU (ชุด CPU) หรือโหนดเฉพาะสำหรับตัวประมวลผลที่ต้องการทรัพยากรสูงที่สุด เพื่อป้องกันการรบกวนระหว่างเวิร์กโหลดที่อยู่ใกล้เคียง นอกจากนี้ การทำความเข้าใจสถาปัตยกรรมไมโครของ CPUจะช่วยให้คุณกำหนดขนาดทรัพยากรสำหรับเวิร์กโหลด CI ที่ต้องการทรัพยากรสูงได้ดียิ่งขึ้น
การรักษาความปลอดภัยในกระบวนการพัฒนา (DevSecOps) และการใช้งานบน Linux
กระบวนการทำงานที่รวดเร็วแต่ขาดความปลอดภัยเปรียบเสมือนระเบิดเวลา การบูรณาการความปลอดภัยเข้ากับกระบวนการทำงานและความปลอดภัยของคอนเทนเนอร์ Dockerกลายเป็นมาตรฐานในกลยุทธ์ DevSecOps แล้ว และ Linux ก็มีเครื่องมือมากมายสำหรับเรื่องนี้
สิ่งแรกที่ต้องทำคือ จัดการความลับและข้อมูลประจำตัวด้วยความระมัดระวังสูงสุดไม่ควรเก็บข้อมูลเหล่านี้ไว้ในโค้ดหรือไฟล์การกำหนดค่าที่มีการกำหนดเวอร์ชัน แต่ควรเก็บไว้ในระบบจัดการความลับ (เช่น ตัวแปรที่ถูกปกปิดใน GitLab, ความลับที่เข้ารหัสใน GitHub, HashiCorp Vault เป็นต้น) และเรียกใช้เฉพาะในระหว่างการทำงานของโปรแกรมที่ต้องการใช้ข้อมูลเหล่านั้น โดยใช้โทเค็นที่มีอายุสั้นเมื่อใดก็ตามที่เป็นไปได้
อีกชั้นที่สำคัญคือการสร้างSBOM (Software Bill of Materials)และการลงนามรับรองไฟล์ต่างๆ เครื่องมืออย่าง Syft หรือ CycloneDX ช่วยให้คุณสามารถแสดงรายการส่วนประกอบทั้งหมดที่ประกอบขึ้นเป็นอิมเมจหรือไบนารี ในขณะที่ Cosign หรือโซลูชันการลงนามที่ตรวจสอบได้อื่นๆ จะช่วยให้มั่นใจได้ว่าเฉพาะไฟล์ที่ผ่านกระบวนการตรวจสอบและได้รับการตรวจสอบความถูกต้องแล้วเท่านั้นที่จะถูกนำไปใช้งาน
ในแง่ของเครือข่ายและการเข้าถึง แนะนำให้แบ่งเครือข่าย CI และเครือข่ายการผลิตออกเป็นส่วนๆ ติดตั้งไฟร์วอลล์ที่เข้มงวด ตรวจสอบบันทึกการทำงาน และเปลี่ยนข้อมูลประจำตัวเป็นประจำ ในกรณีที่ใช้ SSH ควรใช้ใบรับรองหรือคีย์ที่มีวันหมดอายุแทนรหัสผ่านแบบคงที่
เมื่อทำการติดตั้งใช้งานบน Linux กลยุทธ์ต่างๆ เช่นBlue/Green, rolling และ canaryช่วยลดผลกระทบจากข้อผิดพลาดในการติดตั้งได้อย่างมาก การเรียกใช้แอปพลิเคชันเป็นบริการ systemd การวาง Nginx หรือ HAProxy ไว้ด้านหน้า และการควบคุมการรับส่งข้อมูลระหว่างเวอร์ชันด้วยการตรวจสอบสถานะ จะช่วยให้คุณแทบไม่มีเวลาหยุดทำงานระหว่างการอัปเดตเลย
ตัวอย่างเช่น เมื่อทำการรีโหลด Nginx และรีสตาร์ทบริการด้วย systemd โดยใช้สัญญาณ soft stop (เช่น SIGTERMด้วยระยะเวลารอที่เหมาะสม คุณสามารถปิดการเชื่อมต่อที่ใช้งานอยู่ก่อนที่กระบวนการจะหยุดลง ซึ่งจะช่วยรักษาประสบการณ์การใช้งานของผู้ใช้ให้คงเดิมในขณะที่คุณสลับเวอร์ชันในเบื้องหลัง
การตรวจสอบ การวัดผล และต้นทุนในไปป์ไลน์ Linux
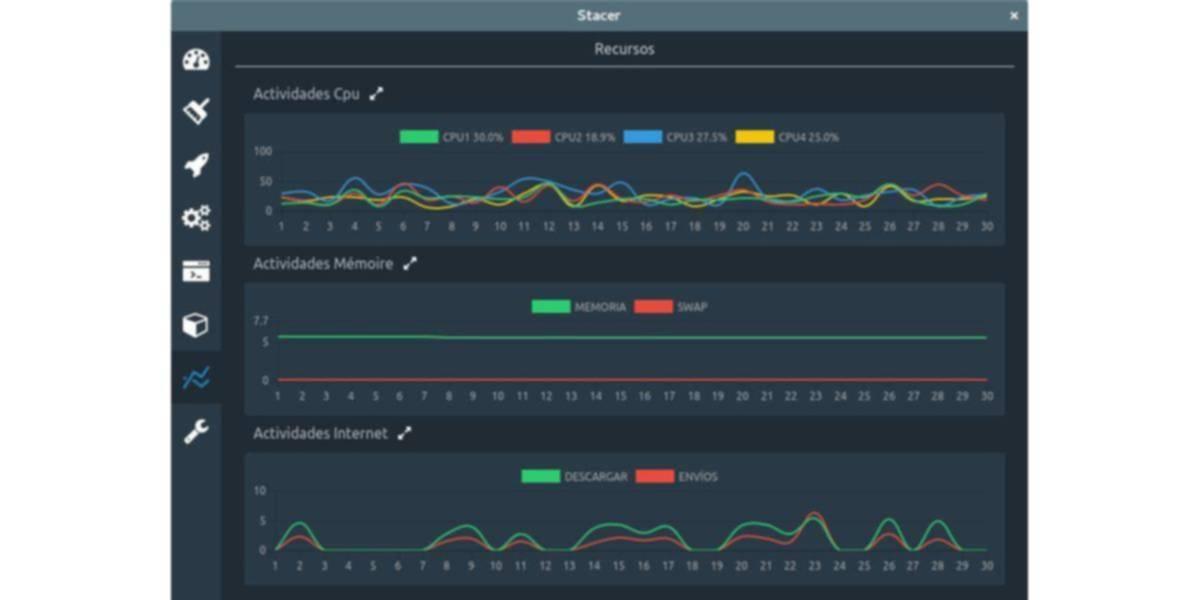
เมื่อระบบประมวลผลของคุณพร้อมใช้งานแล้ว ขั้นตอนต่อไปคือการวัดผลและทำความเข้าใจว่าเวลาและทรัพยากรถูกใช้ไปกับอะไรบ้างการรู้เพียงว่าเวิร์กโฟลว์สำเร็จหรือล้มเหลวนั้นไม่เพียงพอ คุณจำเป็นต้องตรวจสอบระยะเวลาของแต่ละขั้นตอน เวลารอคิว อัตราความสำเร็จ ความถี่ในการปรับใช้ อัตราการเข้าถึงแคช และอื่นๆ อีกมากมาย
การส่งออกข้อมูลเมตริกของระบบโดยใช้วิธีต่างๆ เป็นเรื่องปกติ node_exporterรวมศูนย์บันทึกข้อมูลด้วยโซลูชันอย่าง ELK หรือ Loki และแสดงผลทุกอย่างในแดชบอร์ด Grafana ด้วยวิธีนี้ คุณจะสามารถตรวจจับได้ เช่น หากขั้นตอนการทดสอบใช้เวลานานขึ้น 30% ในสัปดาห์ที่ผ่านมา หรือหากงานต่างๆ ใช้เวลานานเกินไปในการรอตัวดำเนินการที่ว่างอยู่ การตรวจสอบปริมาณการรับส่งข้อมูลเครือข่าย เครื่องมือโอเพนซอร์สช่วยเสริมให้มองเห็นภาพรวมได้ชัดเจนยิ่งขึ้น
นอกจากนี้ยังสามารถติดตั้งเครื่องมือตรวจสอบในกระบวนการทำงานได้โดยตรง เช่น ใน GitHub Actions หรือ GitLab CI เพื่อ... เพื่อวัดจำนวนการดำเนินการที่ประสบความสำเร็จ ระยะเวลาในการดำเนินการแต่ละครั้ง และสถานะโดยรวมโดยใช้โปรแกรมสคริปต์ที่เรียกใช้ API ของผู้ให้บริการ คำนวณจำนวนการทำงานทั้งหมด จำนวนการทำงานที่สำเร็จ จำนวนการทำงานที่ล้มเหลว อัตราความสำเร็จ และระยะเวลาเฉลี่ย แล้วบันทึกทุกอย่างลงในไฟล์ JSON (เช่น pipeline-metrics.jsonช่วยให้คุณสามารถผสานรวมตัวชี้วัดเหล่านี้เข้ากับรายงานหรือแดชบอร์ดได้
ด้วยข้อมูลนี้ คุณสามารถตัดสินใจเกี่ยวกับขนาดและจำนวนของรันเนอร์ได้: บางครั้งการมีรันเนอร์ขนาดเล็กจำนวนมากอาจดีกว่าการมีรันเนอร์ขนาดใหญ่เพียงไม่กี่ตัว เพื่อลดเวลารอคอย การปรับขนาดอัตโนมัติ—เช่น การปรับขนาดอัตโนมัติของคลาวด์หรือกลุ่มโหนด Kubernetes แบบไดนามิก—ช่วยรองรับกิจกรรมสูงสุดในช่วงกลางวันและลดทรัพยากรที่ไม่ได้ใช้งานในช่วงกลางคืน
แนวทางปฏิบัติเหล่านี้ไม่เพียงแต่ช่วยปรับปรุงประสบการณ์การทำงานของทีมเท่านั้น แต่ยังช่วยลดต้นทุนด้านโครงสร้างพื้นฐานด้วยการควบคุมการใช้งาน CPU หน่วยความจำ และโดยเฉพาะอย่างยิ่งพื้นที่จัดเก็บข้อมูล ซึ่งมักจะเพิ่มสูงขึ้นอย่างมากหากไม่ทำการล้างข้อมูลรูปภาพและแคชอย่างสม่ำเสมอและตามแผนที่วางไว้
การเชี่ยวชาญทั้งคำสั่งบรรทัดคำสั่งแบบคลาสสิกและไปป์ไลน์ CI/CD สมัยใหม่ใน Linux นั้นเป็นการผสมผสานที่ทรงพลัง: คุณสามารถทำให้ทุกอย่างเป็นอัตโนมัติได้ ตั้งแต่งานกรองข้อความง่ายๆ ไปจนถึงไปป์ไลน์การสร้าง ทดสอบ และปรับใช้ที่ซับซ้อน บำรุงรักษาได้ ปลอดภัย และรวดเร็ว การเข้าใจว่าข้อมูลไหลเวียนระหว่างกระบวนการอย่างไร การแคชการพึ่งพาอย่างไร การปรับแต่งเซิร์ฟเวอร์อย่างไร และการบูรณาการเมตริกและความปลอดภัยอย่างไร จะช่วยให้คุณสร้างเวิร์กโฟลว์ที่ปรับขนาดได้ตามทีมและโครงการของคุณโดยไม่กลายเป็นคอขวดอย่างต่อเนื่อง