- Ang Google TPU v7 Ironwood ay ang ikapitong henerasyon ng mga TPU at partikular na idinisenyo para sa panahon ng hinuha, na may 4.614 TFLOPs FP8 at 192 GB ng HBM3e bawat chip.
- Ang arkitektura ay umabot sa 9.216 chips sa isang superpod na may 1,77 PB ng shared memory, 9,6 Tb/s ICI network, at liquid cooling na na-optimize para sa halos 10 MW.
- Isinama sa AI Hypercomputer kasama ng mga Axion CPU, ang Ironwood ay nag-aalok ng malakas na balanse sa pagitan ng performance, energy efficiency at gastos para sa napakalaking AI workloads.
- Ang mega-contract kasama ang Anthropic at ang vertical na diskarte sa pagsasama ay nagpapatibay sa tungkulin ng Google bilang isang pangunahing katunggali sa Nvidia sa AI chip market.

Ang pagbilis ng artificial intelligence ay sumasailalim sa isang transpormasyon . Hindi na sapat ang sanayin ang malalaking modelo at ipagmalaki ang kanilang mga parametro: ngayon ang tunay na laban ay kung paano ito pagaganahin araw-araw, para sa milyun-milyong gumagamit, nang hindi tumataas nang husto ang mga gastos sa enerhiya at imprastraktura ng AI . Sa kontekstong ito, lumitaw ang Google TPU v7 Ironwood, isang piraso ng hardware na idinisenyo para sa isang AI na hindi lamang tumutugon, kundi pati na rin ay nag-iisip, nangangatwiran, at kumikilos nang tuluy-tuloy.
Ang Ironwood ang ikapitong henerasyon ng Tensor Processing Unit (TPU) ng Google at, ayon mismo sa kumpanya, ito ang pinakamalakas, nasusukat, at mahusay na chip nito sa kasalukuyan. Ito ay dinisenyo para sa tinatawag na "panahon ng paghihinuha," kung saan ang mahalaga ay hindi gaano katagal ang pagsasanay sa isang bagong modelo, kundi kung magkano ang magagastos upang maihatid ito, mapanatili itong aktibo, mangatwiran, at makabuo ng mga resulta sa buong araw. Tingnan natin nang mas malapitan kung ano talaga ang Google TPU v7 Ironwood, ano ang nagpapaespesyal dito, at kung bakit nito nilalabanan ang Nvidia at iba pang mga higante sa industriya.
Ano ang Google TPU v7 Ironwood at bakit ito napakahalaga?
Ang Ironwood ay mahalagang isang custom-built na AI accelerator na binuo ng Google upang magpatakbo ng mga makabagong modelo ng artificial intelligence. Ito ay kabilang sa pamilya ng mga Tensor Processing Unit (TPU), mga chip na partikular na idinisenyo para sa mga workload ng machine learning na nagpapagana sa mga panloob na serbisyo ng Google (paghahanap, YouTube, advertising, pagsasalin, atbp.) sa loob ng halos isang dekada, at kamakailan lamang, ang mga solusyon ng Google Cloud.
Ang ikapitong henerasyong ito ay binuo batay sa lahat ng karanasang naipon sa mga nakaraang TPU at may malinaw na layunin: upang ma-maximize ang pagganap sa mga hinuha at kumplikadong gawain sa pangangatwiran , nang hindi isinasakripisyo ang kakayahang magsanay. Ang mga Large Language Model (LLM), Mixture of Experts, augmented recall system, at mga AI agent na kailangang magpanatili ng maraming konteksto sa memorya ay ang mga uri ng workload na idinisenyo upang hawakan ng Ironwood.
Sa halip na maging isang "mas mabilis na chip," ang Ironwood ay isinama sa arkitektura ng AI Hypercomputer ng Google Cloud , isang pamamaraan kung saan ang computing, networking, storage, at software ay magkakasamang dinisenyo. Nagbibigay-daan ito para sa fine-tuning mula sa silicon hanggang sa container orchestrator upang masulit ang bawat watt at bawat clock cycle.
Isa pang mahalagang punto ay ang Ironwood ang unang TPU na dinisenyo mula sa umpisa para sa panahon ng paghihinuha . Hanggang ngayon, karamihan sa mga sistema ng AI ay pangunahing idinisenyo upang sanayin ang malalaking modelo; ngayon ang pokus ay lumilipat sa pagpapatakbo ng mga modelong iyon nang mahusay at paulit-ulit, kasama ang mga ahente na hindi lamang tumutugon kundi pati na rin sa pag-asam, paghahanap ng datos, pagsasama-sama nito, at pagbabalik ng mga konklusyon.
Mga pangunahing teknikal na tampok ng TPU v7 Ironwood
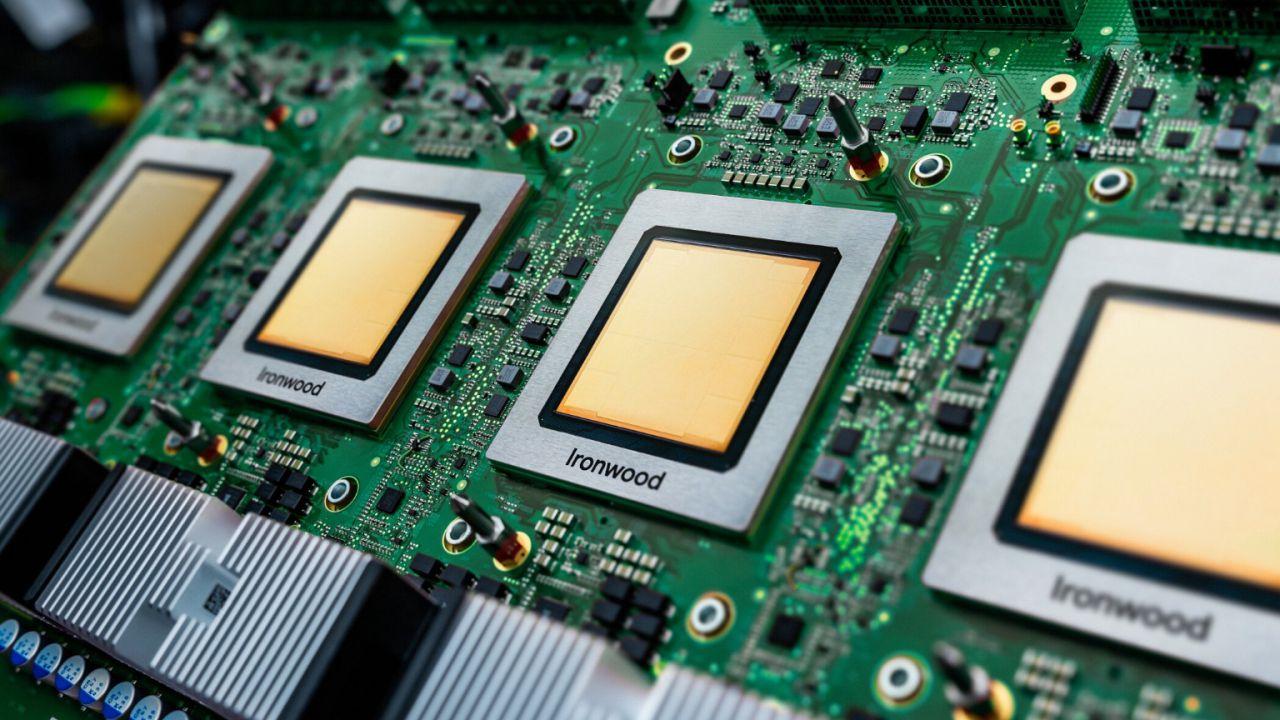
Sa teknikal na aspeto, ipinagmamalaki ng Ironwood ang kahanga-hangang mga datos, kahit na sa isang merkado na kasing-kompetitibo ng mga AI chip. Ang bawat chip ay naghahatid ng 4.614 teraflops ng FP8 precision computing power , na mahigit 16 na beses ang kapasidad ng computing ng TPU v4 at isang malaking pagsulong kumpara sa mga nakaraang henerasyon.
Upang mapagana ang napakalaking kapasidad sa pagproseso na ito, ang bawat chip ay may integrasyon ng 192 GB ng susunod na henerasyon ng HBM3e memory , na may tinatayang bandwidth na 7,3-7,4 TB/s. Ang kombinasyong ito ng high-speed computing at memory ang siyang dahilan kung bakit posible ang paghawak ng napakalalaking modelo at napakahabang konteksto nang hindi nakakaranas ng mga bottleneck.
Ang Ironwood ay ginagawa gamit ang isang advanced na prosesong 5-nanometer at kumokonsumo ng humigit-kumulang 600 watts bawat chip. Maaaring mukhang mataas ito, ngunit kung ikukumpara sa performance nito kada watt, ang resulta ay lubos na mapagkumpitensya: kumpara sa nakaraang henerasyon ng Trillium (TPU v6e), dinoble ng Ironwood ang performance kada watt.
Ang mga pagpapabuting ito ay kapansin-pansin sa parehong mga workload ng pagsasanay at serbisyo. Para sa pagsasanay, maaaring mapabilis ng Ironwood ang pagproseso ng mga susunod na henerasyon ng mga modelo (tulad ng Gemini o Veo) at ng mga mula sa ibang mga vendor, at para sa paghahatid, nagbibigay-daan ito sa pagpapatakbo ng napakalaking mga hinuha na may mas mababang gastos sa enerhiya, isang bagay na mahalaga ngayon na ang mga AI data center ay sinusukat na sa gigawatts.

Mula sa chip hanggang sa Superpod: kung paano sumusukat ang Ironwood
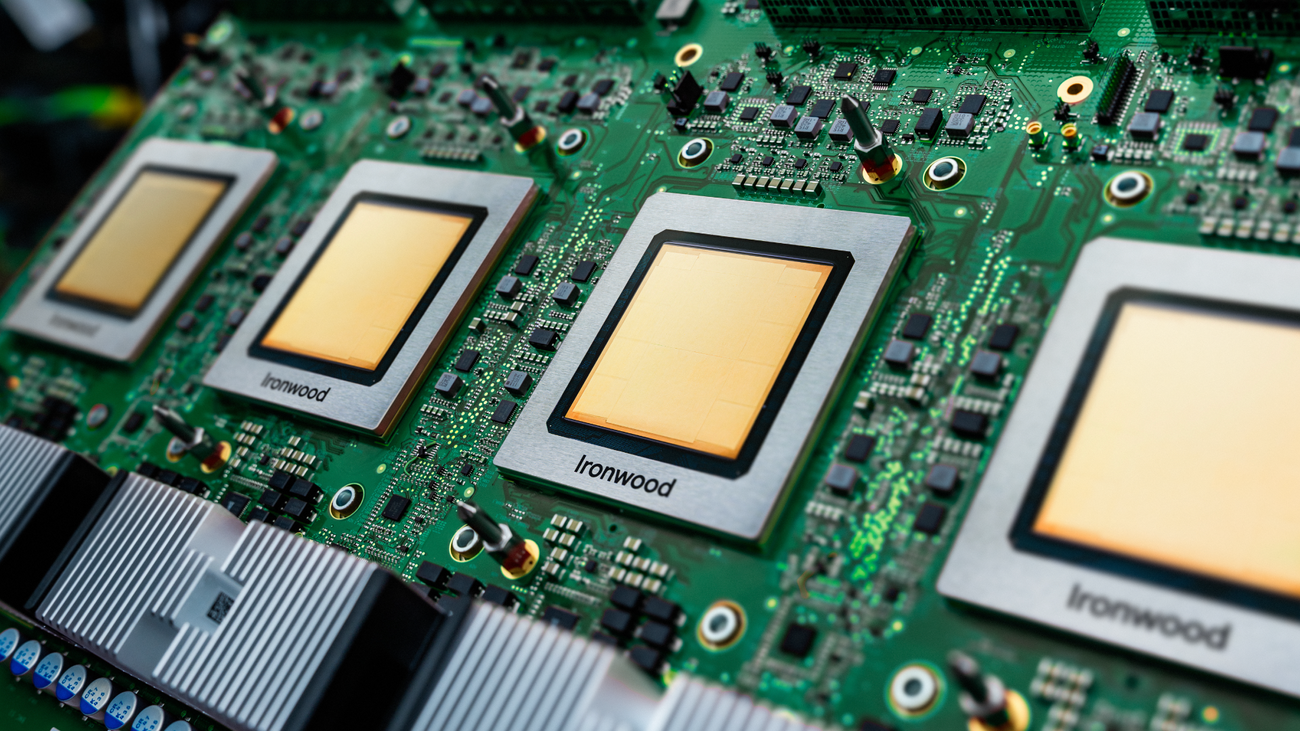
Ang tunay na mahika ng Ironwood ay wala sa iisang chip, kundi sa kung paano ito umuunlad upang bumuo ng mga AI supercomputer . Ang bawat Ironwood SoC ay naka-mount sa isang PCBA na may apat na chip, at ang bawat rack ay nagsasama ng 16 sa mga board na ito, para sa kabuuang 64 na chip bawat rack.
Mula roon, ang mga rack ay pinagsasama-sama upang bumuo ng isang Ironwood Superpod . Ang isang kumpletong superpod ay may kasamang 144 na rack, na katumbas ng 9.216 na magkakaugnay na chips. Sa kabuuan, ito ay katumbas ng humigit-kumulang 42,5 exaflops ng FP8 performance at humigit-kumulang 1,77 petabytes ng shared HBM memory, na lahat ay maaaring ma-access bilang isang malawak na logical resource para sa mga AI model.
Ang pagkakaugnay sa pagitan ng mga chip ay nakakamit sa pamamagitan ng Inter-Chip Interconnect (ICI) network , na may disenyong 3D Torus (4x4x4) at bilis na hanggang 9,6 Tb/s. Ang topolohiyang ito ay nagbibigay-daan para sa pinababang latency at nagpapanatili ng mataas na transfer rates kahit na ang sistema ay umaabot sa libu-libong accelerators, na mahalaga para sa distributed training at highly parallel inference workloads.
Higit pa sa superpod, ang imprastraktura ay maaaring mapalawak pa sa pamamagitan ng pagsasama-sama ng mga bloke ng 64 na konektadong chips at pag-uugnay sa mga ito sa pamamagitan ng isang optical backbone na hanggang 1,8 PB/s. Ang pinaghalong ito ng mga passive copper cable, fiber optics, at optical switch ay nagbibigay ng napakalaking flexibility kapag nagko-configure ng mga custom cluster para sa iba't ibang customer at modelo.
Sa usapin ng kuryente, ang pag-deploy ng ganitong laki ay umaabot sa 10 megawatts ng kapasidad ng kuryente , isang bilang na nangangailangan ng seryosong pagsasaalang-alang sa pagpapalamig at kahusayan. Ang bawat rack ay idinisenyo upang lumampas sa 100 kW ng konsumo, kaya ang buong sistema ay dinisenyo mula sa simula para sa liquid cooling at advanced power distribution.

Pagpapalamig, pagkonsumo at kahusayan ng enerhiya
Dahil sa napakalaking densidad ng kuryente, ang malinaw na tanong ay: paano pinapanatili ng Google ang lahat ng ito sa ilalim ng thermal control? Ang sagot ay nasa isang makabagong liquid cooling system, na partikular na idinisenyo para sa mga Ironwood superpod.
Ang bawat rack ay may integrasyon ng coolant distribution unit (CBU) na may mga leak detector at 416V AC electrical redundancy . Ang configuration na ito ay hindi lamang pumipigil sa sobrang pag-init kundi nagbibigay din ng mataas na reliability para sa mga kritikal na AI workload, kung saan ang matagalang outage ay maaaring magresulta sa milyun-milyong euro na pagkalugi o malawakang pagkaantala sa serbisyo.
Hindi lamang layunin ng Ironwood na maging pinakamalakas na sistema, kundi isa rin sa mga pinaka-epektibo. Kung ikukumpara sa Trillium, ang TPU v7 ay nakakamit ng dobleng performance kada watt na nakonsumo . Nangangahulugan ito na, sa parehong badyet sa enerhiya para sa 2024, ang isang data center na may Ironwood ay maaaring humawak ng hanggang dobleng kapasidad pagdating ng 2026.
Tinutugunan ng pamamaraang ito ang isang hindi komportableng realidad sa sektor: enerhiya, hindi silicon, ang nagiging salik na naglilimita sa pagpapalawak ng AI. Ang mga electrical grid ng maraming bansa ay nagsisimula nang maabot ang kanilang kapasidad sa mga pangunahing lugar ng data center, kaya ang pagkuha ng mas kapaki-pakinabang na trabaho mula sa bawat watt ay hindi na isang kalamangan, ito ay isang pangangailangan.
Bukod pa rito, ang arkitektura ng Ironwood ay na-optimize upang mabawasan ang hindi kinakailangang paggalaw ng data, isang pangunahing gumagamit ng enerhiya sa mga distributed system. Ang kombinasyon ng napakalaking HBM memory at mga high-speed network ay naglalayong tiyak na ganito: mas maraming pagproseso na mas malapit sa data at mas kaunting magastos na paglalakbay sa data center.
Ironwood sa loob ng AI Hypercomputer at ang software layer
Hindi umiiral nang nag-iisa ang Ironwood; malalim itong isinama sa arkitektura ng AI Hypercomputer ng Google Cloud . Pinagsasama-sama ng konseptong ito ang hardware (mga Axion CPU at TPU), high-speed networking, storage, at orchestration at scheduling software sa loob ng iisang balangkas ng disenyo.
Sa software layer, umaasa ang Google sa Pathways stack nito, na nagbibigay-daan para sa koordinasyon ng sampu-sampung libong Ironwood TPU na parang iisang lohikal na mapagkukunan ang mga ito. Kasama ng Pathways, pinalakas din ang mga tool tulad ng MaxText (para sa malawakang pagsasanay sa LLM ) at integrasyon sa Kubernetes Engine sa pamamagitan ng Cluster Director , na nag-optimize sa pag-iiskedyul at katatagan ng cluster.
Para sa bahagi ng paghihinuha, pinalawak ng Google ang suporta sa vLLM upang gumana sa parehong GPU at TPU , na ginagawang mas madali ang paglipat ng mga modelo at workload sa pagitan ng iba't ibang uri ng mga accelerator na may kaunting pagbabago sa code. Bukod pa rito, kayang bawasan ng GKE Inference Gateway ang latency ng paunang kahilingan nang hanggang 96% at mapababa ang gastos ng serbisyo nang humigit-kumulang 30%, ayon sa datos na ibinahagi ng kumpanya.
Ang lahat ng ito ay nangangahulugan na ang mga customer ay hindi lamang nakakakuha ng isang mabilis na chip, kundi isang kumpleto, end-to-end na na-optimize na platform . Sa katunayan, binabanggit ng IDC ang 353% na balik sa puhunan sa loob ng tatlong taon para sa mga customer ng AI Hypercomputer, na may halos 28% na pagbawas sa gastos sa IT.
Malinaw ang pangunahing layunin: upang paganahin ang mga negosyo na gamitin ang kapangyarihan ng Ironwood nang walang abala sa pamamahala ng mga kumplikadong imprastraktura. Tinutukoy lamang ng mainam na gumagamit ang kanilang mga modelo at pangangailangan, at ang Google Cloud control plane ay maayos na nag-oorganisa ng mga TPU, Axion, networking, storage, at software.

Ang "edad ng hinuha" at ang papel ng Ironwood
Sa loob ng maraming taon, ang malaking bahagi ng diskurso tungkol sa AI ay umiikot sa pagsasanay ng lalong lumalaking mga modelo . Gayunpaman, ang merkado ay nahaharap sa isang malupit na katotohanan: gaano man kaganda ang pagsasanay, ang patuloy na kita ay nagmumula sa pagbibigay ng mga hinuha sa malawakang saklaw, araw-araw.
Tinutukoy ng Google ang bagong panahong ito bilang ang "panahon ng paghihinuha ." Sa halip na mga reaktibong modelo lamang na naghihintay sa pagtatanong ng gumagamit, lumilipat tayo patungo sa mga ahente ng AI na kumukuha ng data, nagsusuri ng mga konteksto, nag-uugnay ng mga subprocess, at nagkukusa na mag-alok ng mga rekomendasyon at naprosesong impormasyon.
Ang Ironwood ay dinisenyo para sa ganitong uri ng mga workload: mga modelo na may masalimuot na pangangatwiran, malawak na konteksto, at mga persistent states . Ang malaking halaga ng shared memory at network bandwidth ay inilaan upang payagan ang maraming bahagi ng iisang AI system na gumana sa isang koordinadong paraan nang hindi nalulula sa trapiko.
Sa ganitong sitwasyon, gumagamit ang Google ng ibang estratehiya kumpara sa Nvidia. Habang patuloy na nangingibabaw ang mga Blackwell chip sa makabagong pagsasanay at nangangako ng napakataas na bilis ng paghihinuha sa mga partikular na configuration, nakatuon ang Google sa pag-optimize ng tuluy-tuloy at malawakang pagpapatupad ng mga modelo sa produksyon , pagsasama ng hardware at cloud sa isang solong, magkakaugnay na pakete.
Hindi nilayon ng kumpanya na palitan ang Nvidia sa pangkalahatan, ngunit sa halip ay makuha ang lumalaking bahagi ng pangkalahatang merkado ng inference . Iminumungkahi ng ilang panloob na pagtatantya na, pagdating ng 2027, ang mga TPU ng Google ay maaaring kumatawan sa hanggang 30% ng merkado na iyon, lalo na sa malalaking kliyente na gumagamit na ng Google Cloud.
Ang kasunduan sa Anthropic at ang commercial boost
Ang pangunahing tulong pangkomersyo ng Ironwood ay nagmula sa Anthropic, ang developer ng mga modelong Claude . Noong Oktubre 23, 2025, pumirma ang kumpanya ng isang malaking kasunduan sa Google, na nangangakong gagamit ng hanggang isang milyong TPU at mamumuhunan ng sampu-sampung bilyong dolyar sa imprastraktura sa Google Cloud.
Inaasahan ng kontratang ito na lalampas sa 1 gigawatt ang pagkonsumo ng enerhiya pagsapit ng 2026 , isang napakalaking bilang na nagbibigay ng ideya sa lawak ng operasyon ng mga pangunahing manlalaro sa AI. Sa isang iglap, ang Ironwood ay nagbago mula sa pagiging isang ambisyosong proyekto sa roadmap patungo sa isang tunay na pamumuhunan na sinusuportahan ng malakas na demand.
Para sa Google, nilulutas ng kasunduan ang isa sa mga pinakamalaking alalahanin nito: ang pagpapalakas ng kapasidad ng data center nang walang garantisadong paggamit . Gamit ang Anthropic bilang anchor client nito, maaaring magplano ang kumpanya ng mga bagong pasilidad, kontrata ng kuryente, at pag-deploy ng Ironwood superpod nang may mas malawak na pagtingin sa kanilang balik sa puhunan.
Ang pagpili ng Anthropic sa Ironwood, sa halip na maghintay para sa susunod na henerasyon ng Nvidia o gumamit ng proprietary hardware mula sa ibang hyperscaler, ay isang malinaw na senyales ng tiwala sa kahusayan at time-to-market ng mga TPU ng Google . "Mas maraming hinuha, mas kaunting lakas" ang, sa pagsasagawa, ang pahiwatig na motto ng hakbang na ito.
Ang mga ganitong uri ng pangmatagalang kasunduan ay nakakatulong din sa Google na mas mahusay na makipagnegosasyon sa sarili nitong mga gastos (mula sa paggawa ng chip hanggang sa suplay ng enerhiya) at palakasin ang posisyon nito sa isang merkado kung saan ang demand para sa AI computing ay higit na lumalampas sa magagamit na supply.
Epekto sa merkado ng AI chip at kumpetisyon sa Nvidia
Ang paglulunsad ng Ironwood ay isang game-changer sa merkado ng AI hardware , na malinaw na pinangungunahan ng mga Nvidia GPU hanggang ngayon. Hindi lamang ang Google ang gumagawa ng mga hakbang: Itinutulak ng AWS ang linya ng Trainium2 nito, at ang Microsoft ay umuusad sa programang Maia nito, bagama't may mga pagkaantala.
Patuloy na nangunguna ang Nvidia sa makabagong pagsasanay, kasama ang Hopper, Blackwell, at ang mga paparating na arkitektura ng Rubin, na nagta-target ng mga configuration ng ilang exaflops bawat rack. Gayunpaman, itinutulak ng Google ang merkado patungo sa isang modelo ng maramihang vertical integrated ecosystems , kung saan ang bawat hyperscaler ay nagdidisenyo ng sarili nitong mga chip, network, software, at mga serbisyo sa cloud.
Sa bagong tanawing ito, ipinoposisyon ng Ironwood ang sarili bilang isang matibay na alternatibo para sa mga kumpanyang naghahanap ng malawakang imprastraktura ng inference nang hindi lubos na umaasa sa CUDA ecosystem. Ang kombinasyon ng mga custom na TPU at Axion CPU, kasama ang Google Cloud platform, ay lumilikha ng isang lubos na kaakit-akit na alok para sa mga kumpanyang nangangailangan ng mahuhulaang gastos, pagganap, at availability.
Ang hakbang na ito ay nagdaragdag din ng presyon sa Nvidia, na dapat bigyang-katwiran ang mataas na presyo sa isang kapaligiran kung saan hindi na ito ang tanging mabisang opsyon . Habang pinapalakas ng Amazon, Microsoft, at Google ang kanilang sariling mga stack, ang merkado ay lumilipat palayo sa single-chip vendor model patungo sa isang pinaghalong sarado, ngunit lubos na na-optimize, na mga solusyon sa loob ng bawat cloud provider.
Gayunpaman, ang tagumpay ng Ironwood at mga TPU sa pangkalahatan ay lubos na nakasalalay sa patuloy na pag-unlad ng software stack ng Google kasabay ng CUDA ecosystem . Kung bababa ang mga rate ng paggamit ng cluster (halimbawa, mula 90% hanggang 70%), ang pangkalahatang kahusayan ay magdurusa at maaaring maapektuhan ang kakayahang makipagkumpitensya sa presyo.
Axion: ang CPU add-on para sa AI infrastructure
Kasabay ng paglulunsad ng Ironwood, pinalakas ng Google ang pamilya nito ng mga custom na CPU na Axion , batay sa arkitektura ng Arm Neoverse. Bagama't ang mga TPU ang humahawak sa pinakamabibigat na aspeto ng machine learning, ang Axion naman ang humahawak sa mga pangkalahatang workload na nakapalibot sa AI.
Ang mga bagong N4A instances ay nag-aalok ng hanggang 64 vCPU, 512 GB ng DDR5 memory, at 50 Gbps network bandwidth , na may hanggang 100% na pagpapabuti sa presyo kumpara sa mga katumbas na x86 machine. Samantala, ang C4A Metal ang unang bare-metal na bersyon ng Google Cloud na batay sa Arm, na nakatuon sa mga senaryo tulad ng pagbuo ng Android, mga aplikasyon sa automotive, at mga advanced na simulation.
Ang mga kompanyang tulad ng Vimeo ay nag-ulat ng 30% na pagbuti sa video transcoding , habang ang ZoomInfo ay nag-uulat ng 60% na pagtaas sa kahusayan sa mga proseso ng pagsusuri ng datos. Ang ibang mga kompanya, tulad ng Rise, ay nagsasabing nabawasan nila ang pagkonsumo ng lakas ng computing ng humigit-kumulang 20% habang pinapanatili ang matatag na latency.
Ang pinagbabatayang ideya ay ang Axion ay kumilos bilang isang pangkalahatang-layunin na computing base layer : paghahanda ng datos, mga microservice, mga serbisyo sa web, business logic, atbp. Sa pundasyong iyon, ang mga Ironwood TPU ay nakatuon sa kung ano ang kanilang pinakamahusay na nagagawa: pagpapabilis ng pagsasanay, paghihinuha, at pangangatwiran ng mga modelo ng AI.
Pinatitibay ng kombinasyong ito ang pananaw na ang susunod na henerasyon ng computing ay magiging hybrid : mahusay na mga CPU upang pamahalaan ang mga daloy ng trabaho at mga TPU (o iba pang mga accelerator) para sa masinsinang pagkalkula. Ang lahat ng ito ay pinagsama-sama ng AI Hypercomputer platform at mga tool ng Google Cloud.
Pananaw sa pamumuhunan at proteksyon sa margin para sa Alphabet
Mula sa pananaw sa pananalapi, ang Ironwood ay higit pa sa isang makapangyarihang chip: ito ay isang estratehikong bahagi para protektahan ang mga margin ng Alphabet sa negosyo ng cloud AI. Ang mga hyperscaler ay nasa tamang landas upang maabot ang double-digit na gigawatt power capacities pagsapit ng 2027, at lahat ng indikasyon ay nagpapakita na ang pamumuhunan sa imprastraktura ay mananatiling malaki.
Sa pamamagitan ng pagdidisenyo ng sarili nitong mga chips, makukuha ng Google ang halaga sa buong value chain : mula sa disenyo ng silicon hanggang sa pag-deploy ng cloud. Sa halip na muling ibenta ang hardware ng third-party na may maliit na margin, binabago nito ang capital expenditure (CAPEX) tungo sa isang competitive advantage at isang tool para sa pagkakaiba ng mga serbisyo nito.
Ang pinahusay na performance per watt ng Ironwood ay nangangahulugan na ang bawat megawatt ng kapasidad ng data center ay naghahatid ng mas malaki sa mga tuntunin ng mga hinuha na naihatid . Kapag sinamahan ng mga software optimization (vLLM, Pathways, GKE Inference Gateway, atbp.), pinapayagan nito ang Google na mag-alok ng agresibong pagpepresyo nang hindi isinasakripisyo ang kakayahang kumita.
Ang kontrata sa Anthropic ay nagdaragdag ng karagdagang patong ng katatagan sa plano ng paggastos ng kapital ng Google . Sa halip na magtayo ng imprastraktura nang "walang taros," habang naghihintay sa pagdating ng mga customer, maaari na nitong sukatin ang malaking bahagi ng pagpapalawak nito batay sa mga pangmatagalang kasunduan, na binabawasan ang kawalan ng katiyakan at ang panganib ng labis na kapasidad.
Gayunpaman, nananatili pa rin ang mga bukas na tanong: kung makakaakit ba ang Google ng mas malalaking anchor client, kung ang mga proyekto sa enerhiya at mga bagong substation ay mananatili sa iskedyul, at kung mapapanatili ba ng software stack nito ang mataas na rate ng paggamit. Nariyan ang potensyal, ngunit ang pagpapatupad ay magiging susi para sa Ironwood upang maging isang teknikal na tagumpay at isang makina ng patuloy na kita . HINDI ITO PAYO SA PAMUMUHUNAN.
Kung pagsasama-samahin, ang Google TPU v7 Ironwood ay kumakatawan sa isang paglukso ng henerasyon na higit pa sa mga teraflop sa isang spec sheet: pinagsasama nito ang raw power, napakalaking shared memory, mga advanced optical network, liquid cooling, at isang malalim na integrated cloud upang suportahan ang bagong alon ng mga AI agent at modelo na tumatakbo nang walang tigil. Sa isang mundo kung saan limitado ang enerhiya, ang mga modelo ay patuloy na lumalaki, at ang kompetisyon para sa kontrol ng AI stack ay matinding, ang Ironwood ay umuusbong bilang puso ng isang imprastraktura na idinisenyo upang ihatid ang "panahon ng paghihinuha" at muling tukuyin kung paano, saan, at sa anong gastos pinapatakbo ang artificial intelligence sa isang pandaigdigang saklaw.
