- Tinitiyak ng pagkakaugnay-ugnay ng cache na ang lahat ng kopya ng parehong data sa iba't ibang cache at sa RAM ay nananatiling pare-pareho sa mga multi-core system.
- Pinapadali ng hierarchy ng cache na may nakabahaging huling antas ang pagkontrol ng pagkakapare-pareho at binabawasan ang direktang pag-access sa pangunahing memorya.
- Ang mga coherence protocol ay gumagamit ng mga estratehiya sa copy invalidation o update, na sinusuportahan ng mga estado at control bits bawat linya ng cache.
- Maaaring dagdagan ng compiler at operating system ang pagkakapare-pareho ng hardware sa pamamagitan ng pagpasok ng mga tagubilin at pag-configure ng memorya para sa mga kritikal na panahon.
Kapag tiningnan mo ang isang diagram ng anumang modernong multi-core processor, palaging lumilitaw ang parehong pattern: maraming core, bawat isa ay may kanya-kanyang kalapit na cache, at isang shared last-level cache na nagsisilbing isang karaniwang punto bago maabot ang RAM. Ang kaayusang ito ay hindi aksidente o kapritso lamang ng mga taga-disenyo, kundi isang direktang tugon sa isang kritikal na problema sa mga parallel system: ang cache coherence.
Kung walang matibay na mekanismo ng consistency, ang bawat core ay maaaring gumana gamit ang iba at hindi na napapanahong bersyon ng parehong data sa memorya , na sa isang programa sa totoong mundo ay isinasalin sa mga banayad na error, hindi mahuhulaan na pagkabigo, at maging ang mga pag-crash ng system. Samakatuwid, ang pag-unawa kung paano pinapanatili ang consistency na ito—sa parehong antas ng hardware at software—ay susi sa pag-unawa sa performance at stability ng mga modernong multi-core CPU.
Ano ang cache coherence: ang pangwakas na metapora

Isipin ang ilang tao na nakaupo sa harap ng iba't ibang terminal, lahat ay nag-eedit ng iisang dokumento na nakaimbak sa isang sentral na server . Ang bawat screen ay nagpapakita ng isang kopya ng file, at ang anumang mga pagbabagong gagawin ng isang tao ay inaasahang agad na makikita sa mga screen ng lahat.
Para gumana ito, kailangang mayroong mekanismo ng pag-synchronize na nagpapakalat ng mga pagbabago sa dokumento sa lahat ng terminal, upang palaging makita ng lahat ang parehong bersyon. Hangga't gumagana ang sistemang ito, maayos ang lahat: alam ng sinumang magbabago sa teksto na makikita ng lahat ang bagong bersyon halos agad-agad.
Ngayon isipin na biglang nabigo ang sistema ng pag-synchronize. Patuloy na nag-eedit ang bawat tao, kumbinsido na ginagawa nila ang ibinahaging dokumento, ngunit sa katotohanan, ang bawat terminal ay naiiwan na may sarili nitong hindi nakakonektang lokal na kopya . Mula sa sandaling iyon, ang mga pagbabagong ginawa ng isang tao ay hindi na nakakarating sa iba, at ang dokumento ay nagsisimulang maghiwalay nang hindi mapigilan.
Sa larangan ng pag-compute, ito mismo ang mangyayari kung ang CPU ay kulang sa isang maaasahang consistency protocol: binabago ng isang core ang data sa memorya, ngunit ang iba pang mga core ay patuloy na nagbabasa ng isang mas lumang bersyon mula sa kanilang mga pribadong cache . Lumilikha ito ng matabang lupa para sa mga malubhang logical error, corrupted data, at pag-underbugging.
Samakatuwid, ang cache coherence ay ang hanay ng mga mekanismo na nagsisiguro na, sa isang multi-core system, lahat ng kopya ng parehong data na ipinamamahagi sa iba't ibang cache at RAM ay nagpapanatili ng isang pare-parehong estado . Kahit na maraming kopya ang umiiral, ang sistema ay dapat kumilos "na parang" iisa lamang.
Mga cache at hierarchy ng memorya sa isang multi-core CPU
Ang mga CPU cache ay maliliit at napakabilis na memorya na naglalaman ng mga kopya ng mga madalas gamiting bahagi ng RAM . Kapag isinasagawa ng processor ang code, sa halip na patuloy na i-access ang (medyo mabagal) na RAM, sinusubukan nitong magbasa at magsulat papunta sa cache, na lubhang binabawasan ang latency.
Ang sekreto, siyempre, ay hindi iniimbak ng mga cache ang "opisyal na bersyon" ng data, kundi isang pansamantalang replika lamang . Kasunod ng metapora ng terminal, ang RAM ang magiging dokumento sa server, habang ang mga cache ang magiging mga lokal na screen na nagpapakita ng mga kopya ng ilang bahagi ng file.
Sa isang multi-core CPU, ang disenyo ay nagiging mas kumplikado dahil ang bawat core ay karaniwang may sarili nitong pribadong Level 1 (L1) at maging Level 2 (L2) caches . Sa itaas ng mga ito, isang shared Level 3 cache (halimbawa) ang idinaragdag, na matatagpuan sa pagitan ng mga core at ng memory controller na nagbibigay ng access sa RAM.
Ipinakilala ang shared cache na ito dahil ang pagpapahintulot sa lahat ng core na direkta at masinsinang ma-access ang RAM ay magdudulot ng mga conflict sa access, pagtatalo sa memory bus, at malaking pagbaba ng performance . Ang last-level cache ay gumaganap bilang isang karaniwang "buffer" na nagbabawas sa mga access sa RAM at nagsesentralisa ng halos lahat ng trapiko ng data.
Bukod pa rito, maraming arkitektura ang nagsasaayos ng mga cache nang inklusibo: ang mga linyang nakaimbak sa mga antas na malapit sa processor ay naroroon din sa mas matataas na antas ng hierarchy . Ibig sabihin, ang isang linyang lumilitaw sa L1 ay nasa L2 din at, kaugnay nito, sa L3. Ito ay may kapaki-pakinabang na bunga para sa consistency: ang simpleng pag-update ng cache sa pinakamababang antas nang tama ay sapat na upang makontrol ang estado ng iba pang mga antas nang hindi kinakailangang palaging i-access ang RAM.
Bakit ang huling antas ng shared caching ay susi sa consistency
Kung wala ang pandaigdigang huling antas ng cache na ito, kailangang suriin ng bawat core ang pagkakapare-pareho nito nang direkta laban sa pangunahing memorya . Sa tuwing babaguhin ang isang linya ng memorya sa isang pribadong cache, kinakailangang suriin kung ang ibang mga core ay nagpapanatili ng kopya ng parehong linyang iyon at, kung gayon, ia-update o ipapawalang-bisa ito kahit saan.
Sa isang sistemang may maraming core, ang ganitong dami ng mga tseke ay magreresulta sa napakaraming transaksyon sa RAM , na magpapawalang-bisa sa malaking benepisyo ng pagkakaroon ng mabibilis na cache. Sa pamamagitan ng paglalagay ng shared cache sa pagitan ng mga core at memory, maaaring i-concentrate ng CPU ang coherence control sa iisang intermediate na lokasyon.
Sa maraming implementasyon, ang mga cache sa mas matataas na antas (malayo sa processor) ay naglalaman ng mga kopya ng mga linyang nasa mga antas na mas malapit sa core . Sa organisasyong ito, kailangan lamang tiyakin ng coherence protocol na ang huling antas ay naka-synchronize sa pangunahing memorya, at ang mga pribadong antas ng bawat core ay naka-synchronize sa antas na nasa itaas nito.
Maaari itong mailarawan bilang isang uri ng manika ng Russia na namumugad: ang ikatlong antas ng cache ay kinabibilangan ng nilalaman ng pangalawa at unang antas , ang pangalawang antas ay kinabibilangan ng sarili nitong nilalaman at ng sa unang antas, at ang unang antas ay tanging sarili nitong mga linya lamang ang alam. Kaya, sa pamamagitan ng pagkontrol sa "malaking manika" (ang huling antas), mas mahusay na maikokoordina ng sistema ang iba pa.
Ang resulta ay ang pagpapanatili ng consistency ay nagiging mas matipid sa mga tuntunin ng disenyo at trapiko ng memorya . Sa halip na pilitin ang bawat core na patuloy na humawak sa RAM, ang protocol ay gumagana sa shared cache at mula roon ay pinamamahalaan kung aling mga linya ang dapat i-update o i-invalidate sa mga pribadong cache.
Mga paraan ng pag-update: pagpapawalang-bisa at pag-update ng mga kopya
Isang kritikal na isyu ang lumilitaw kapag halos sabay-sabay na nais i-access ng dalawa o higit pang mga core ang parehong linya ng data na kinokopya sa maraming cache . Sa kontekstong ito, ang mga consistency system ay karaniwang gumagamit ng dalawang pangunahing estratehiya kapag humahawak ng mga write.
Ang unang paraan ay batay sa pagpapawalang-bisa. Kapag kailangang sumulat ang isang kernel sa isang partikular na linya ng cache, pinapawalang-bisa ng protocol ang anumang kopya ng parehong linya na maaaring umiiral sa iba pang mga cache . Tanging ang kernel na magsusulat ang nagpapanatili sa linya sa isang estado na pinagana ng read-and-write; ang iba, kung gusto nilang gamitin muli ang data na iyon, ay kailangang i-reload ang linya mula sa mas mataas na antas (o mula sa memorya) gamit ang na-update na bersyon.
Ang pangalawang estratehiya ay kinabibilangan ng pag-update. Sa kasong ito, kapag binago ng isang kernel ang isang linya, sinusubukan ng system na awtomatikong ipalaganap ang bagong nilalaman sa mga umiiral na kopya sa iba pang mga cache . Sa ganitong paraan, lahat ng cache na nag-imbak sa linyang iyon ay makakatanggap ng na-update na bersyon nang hindi kinakailangang i-invalidate at i-reload ito sa ibang pagkakataon.
Ang bawat pamamaraan ay may mga kalamangan at kahinaan. Ang pagpapawalang-bisa ay karaniwang mas mahusay kapag ang mga pagsusulat ay madalas dahil iniiwasan nito ang pagkapuno ng memorya ng mga update na maaaring hindi agad kailanganin ng ibang mga core. Sa kabaligtaran, ang pag-update ay maaaring maging kapaki-pakinabang kapag maraming core ang madalas na nagbabasa ng parehong data na medyo madalang na binabago , dahil binabawasan nito ang latency sa pamamagitan ng hindi na kinakailangang i-reload ang linya pagkatapos ng bawat pagpapawalang-bisa.
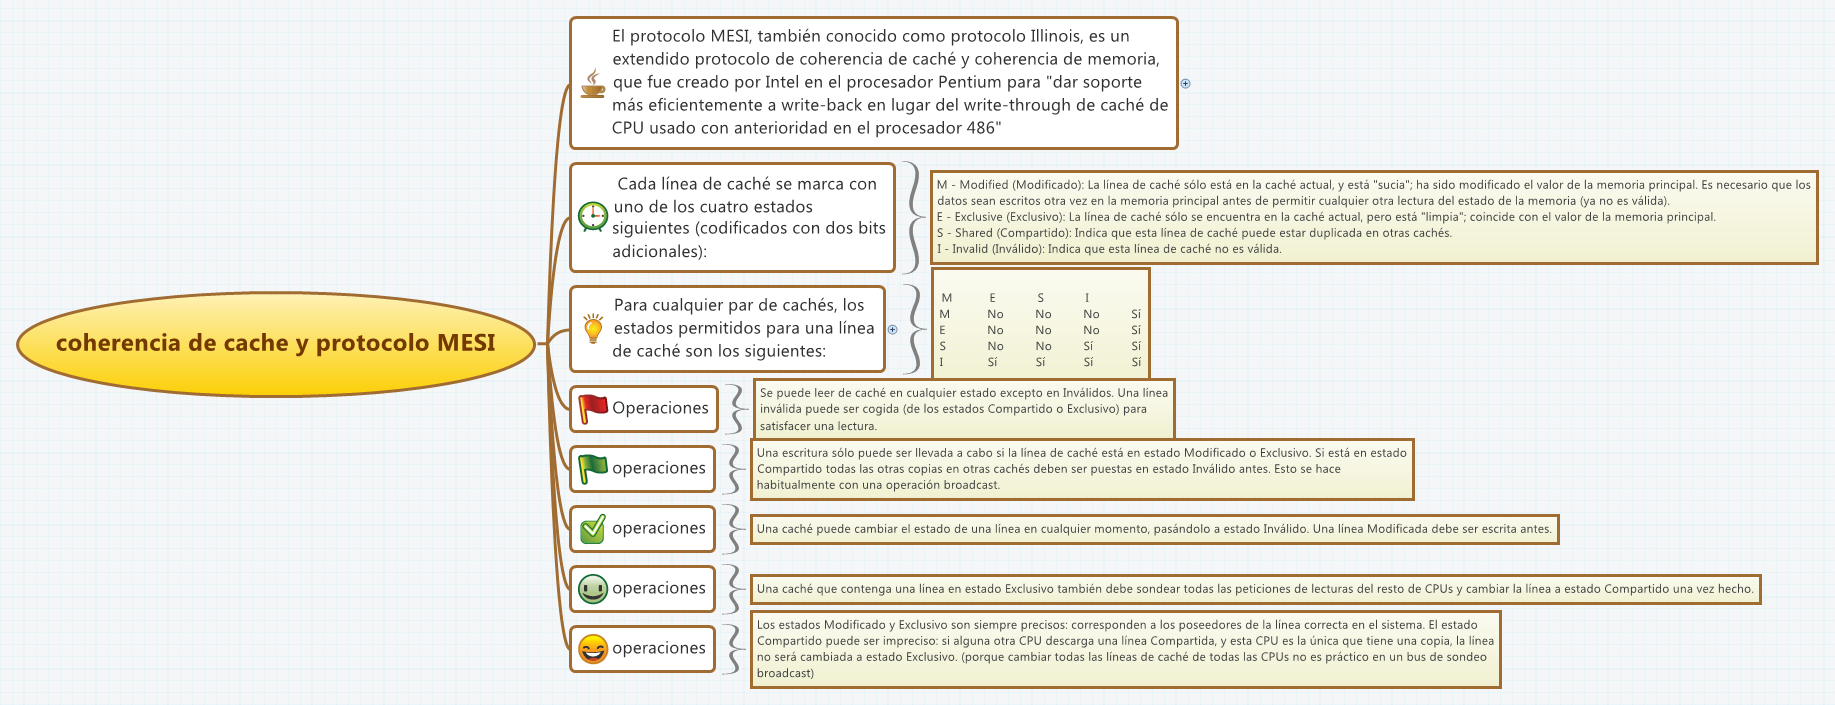
Sa alinmang kaso, ang parehong pamamaraan ay gumagamit ng mga karagdagang estado at mga control bit sa mga linya ng cache. Ang bawat linya ay karaniwang naglalaman ng impormasyon tungkol sa kung ang mga nilalaman nito ay tumutugma sa mga nasa RAM , at kung ito ay ibinahagi, binago, eksklusibo, nakalaan, atbp., depende sa partikular na protocol (MESI, MOESI, MSI, atbp.). Nagbibigay-daan ito sa hardware na gumawa ng mabilis na mga desisyon tungkol sa kung ano ang gagawin kapag ang isang operasyon ng pagbasa o pagsulat ay naganap sa isang linya na na-replicate na.
Sinusuri ang pagkakapare-pareho sa pagitan ng mga cache at memorya
Ang direktang pag-verify ng pagkakapare-pareho sa pagitan ng lahat ng antas ng cache ng isang CPU o GPU at pangunahing memorya ay magiging isang napakalaking gawain, kapwa sa mga tuntunin ng pagiging kumplikado ng disenyo at gastos sa pagganap. Samakatuwid, inaayos ng mga modernong sistema ang pag-verify na ito nang hierarchical.
Ang mga cache na pinakamalapit sa processor (L1, L2) ay karaniwang hindi direktang nakakonekta sa RAM, kundi sa susunod na antas ng cache. Nangangahulugan ito na ang consistency ay hindi pinapatunayan laban sa pangunahing memorya sa bawat antas, kundi laban sa agarang mas mataas na antas . Binabawasan nito ang bilang ng mga access sa RAM at pinapasimple ang lohika na kinakailangan sa mas mababang antas.
Sa huli, ang paghahambing sa pagitan ng mga nilalaman ng cache at mga nilalaman ng RAM ay isinasagawa sa pagitan ng huling antas ng cache at pangunahing memorya . Kung ang huling antas na ito ay nagpapanatili ng tama at pare-parehong estado, at ang bawat mas mababang antas ay nagpapanatili ng pagkakapare-pareho nito sa nasa itaas nito, ang buong hierarchy ay nananatiling pare-pareho nang hindi kinakailangang paulit-ulit na suriin ang bawat linya laban sa RAM.
Kapag ang isang kernel ay nagsusulat sa isang linya ng cache at binabago ang datos nito, ang estado ng linyang iyon ay minarkahan upang ipahiwatig na hindi na ito eksaktong tumutugma sa kopyang nakaimbak sa memorya . Mula doon, kino-coordinate ng protocol ang pag-update: minamarkahan nito ang mga kaukulang kopya sa iba pang mga cache bilang nakalaan o hindi wasto at, kung naaangkop, isinusulat ang bagong nilalaman sa nauugnay na pangunahing linya ng memorya.
Ang cascading organization na ito ay nagpapahintulot sa mga pagbabago na progresibong kumalat mula sa kernel, na siyang nag-a-update ng data, patungo sa main memory, na dumadaan sa bawat antas ng cache sa isang kontroladong paraan. Sa ganitong paraan, ang pagpapanatili ng consistency ay hindi nagiging isang hindi malulutas na bottleneck para sa processor.
Pagkakaugnay ng hardware laban sa pagkakaugnay ng software
Sa ngayon, natalakay na natin ang mga mekanismo ng consistency na pangunahing ipinapatupad sa hardware: mga protocol, status bit, shared cache, atbp. Gayunpaman, may isa pang pamamaraan na naglalayong ilipat ang ilan sa pagiging kumplikado na iyon sa software , partikular sa compiler at operating system.
Tinatangka ng mga software-based consistency scheme na bawasan ang pangangailangan para sa karagdagang on-chip logic sa pamamagitan ng pagsusuri ng code at paggawa ng mga desisyon sa oras ng pag-compile . Ang ideya ay kung mahuhulaan ng compiler kung kailan at paano ina-access ang ilang partikular na nakabahaging data, maaari nitong, sa maraming kaso, mapigilan ang pag-cache ng data na iyon o tahasang pamahalaan ang visibility nito.
Ang pamamaraang ito ay may malinaw na bentahe: bahagi ng workload ay lumilipat mula sa runtime patungo sa compile-time resolution . Sa halip na ang hardware ang mag-detect at humawak ng lahat ng conflict nang mabilisan, sinusubukan ng compiler na mahulaan ang mga ito at bumuo ng code na umiiwas sa mga mapanganib na sitwasyon.
Ang downside ay limitado ang static code analysis, at samakatuwid ay may posibilidad na maging konserbatibo ang mga compiler . Nangangahulugan ito na, upang maiwasan ang paglabag sa consistency, madalas silang gumagawa ng mga desisyon na nagbabawas sa bisa ng mga cache. Kung pinaghihinalaan nila na ang ilang data ay maaaring maging problema, madalas nilang pinipigilan ang pag-cache nito o pinipilit ang mga synchronization nang mas madalas kaysa sa mahigpit na kinakailangan.
Samakatuwid, bagama't ang mga iskema ng software na ito ay kaakit-akit sa teorya, lalo na para sa pagpapasimple ng disenyo ng hardware, sa pagsasagawa ay hindi nila pinapalitan ang suporta sa pagkakaugnay-ugnay na isinama sa mismong CPU , ngunit sa halip ay pinupunan ito sa ilang partikular na senaryo.
Ang papel ng compiler sa pagkakapare-pareho ng cache
Ang isang mahalagang elemento ng mga pamamaraan ng pagkakapare-pareho batay sa software ay ang papel ng compiler. Maaaring magsagawa ang compiler ng malalim na pagsusuri ng code at matukoy kung aling mga istruktura ng ibinahaging data ang maaaring hindi ligtas para sa pag-cache . Batay dito, minamarkahan nito ang mga elementong ito sa isang espesyal na paraan o inaangkop ang pagbuo ng code.
Ang pinakasimple, at ang pinakakonserbatibo rin, na pamamaraan ay ang pagpigil sa pag-cache ng mga shared data variable . Ibig sabihin, ang bawat pag-access sa mga variable na ito ay pumipilit ng access sa pangunahing memorya o isang non-cacheable area. Ginagarantiyahan nito ang consistency, ngunit nakakaligtaan ang maraming pagkakataon sa performance, dahil ang isang shared structure ay maaaring, sa katunayan, gamitin nang pribado sa ilang partikular na panahon, o read-only sa iba.
Sa katotohanan, ang problema sa consistency ay lumilitaw lamang sa mga interval kung kailan kahit isang proseso ay maaaring sumulat sa variable at ang isa pang proseso ay maaaring magbasa nito . Sa labas ng mga kritikal na panahong ito, ang variable ay maaaring ituring bilang para sa eksklusibong paggamit ng isang thread o kahit bilang isang epektibong constant sa loob ng ilang sandali, na nagbibigay-daan upang ma-cache ito nang walang mga isyu.
Sinusubukan ng mga pinaka-advanced na estratehiya sa compilation na tukuyin ang mga "ligtas" na panahon kung saan ang ibinahaging variable ay maituturing na hindi magkasalungat . Upang gawin ito, sinusuri ng compiler ang mga landas ng pagpapatupad, mga potensyal na sabay-sabay na pag-access, at mga pattern ng synchronization (mga lock, kritikal na seksyon, atbp.). Batay sa pagsusuring ito, hinahati nito ang buhay ng variable sa mga yugto: ang ilan ay angkop para sa caching, ang iba ay nangangailangan ng espesyal na paghawak.
Sa mga kritikal na panahon, kapag natukoy ang sabay-sabay na pag-access na may kasamang mga write, naglalagay ang compiler ng mga karagdagang tagubilin sa nabuong code upang ipatupad ang cache consistency . Maaaring pilitin ng mga tagubiling ito ang mga cache flush, memory reload, memory barrier, o access sa mga rehiyong minarkahan bilang hindi maaaring i-cache, depende sa modelo ng programming at pinagbabatayan na arkitektura.
Ugnayan sa pagitan ng compiler, operating system, at hardware
Ang pariralang "ang compiler ay naglalagay ng mga tagubilin sa nabuong code upang ipatupad ang cache consistency" ay maaaring humantong sa isa na isipin na binabasa ng operating system ang mga tagubiling ito na parang mga pahiwatig sa mataas na antas at, batay doon, nagpapasya kung paano isasagawa ang programa. Sa katotohanan, medyo naiiba ang mekanismo.
Kapag nagdagdag ang compiler ng mga ganitong uri ng instruksyon, ang ipinapasok nito sa binary ay mga partikular na operasyon na sinusuportahan ng arkitektura o ng runtime environment . Halimbawa, maaari itong magpasok ng mga instruksyon sa pag-flush ng cache, mga memory barrier, mga espesyal na instruksyon upang markahan ang mga rehiyon bilang hindi maaaring i-cache, o mga tawag sa mga serbisyo ng operating system na nagko-configure ng mga memory attribute.
Hindi binibigyang-kahulugan ng operating system ang mga instruksyong ito bilang mga "komento" o "pahiwatig" na mataas ang antas na isinulat ng compiler; isinasagawa lamang nito ang machine code tulad ng iba pa . Gayunpaman, ang ilan sa mga instruksyong ito ay idinisenyo upang makipag-ugnayan sa memory subsystem at pamamahala ng cache, kaya binabago kung paano ina-access ng CPU ang ilang data.
Sa madaling salita, ang compiler ay nagsasagawa ng paunang pagsusuri at bumubuo ng code na, kapag naisakatuparan, ay lumilikha ng ninanais na pag-uugali ng cache . Nakikipagtulungan ang operating system sa pamamagitan ng pagtatatag ng mga katangian ng memorya (mga lugar na maaaring ma-cache o hindi maaaring ma-cache, mga patakaran sa pagsulat, atbp.) at pagbibigay ng mga primitive sa pag-synchronize, ngunit hindi ito "nagbabasa" ng mga espesyal na tagubilin sa diwa ng pagbibigay-kahulugan sa mga ito nang semantiko tulad ng gagawin ng isang compiler.
Maaari ring mangyari na ang hardware, kapag nakita ang ilang partikular na tagubilin, ay nagpapagana ng mga partikular na mekanismo ng coherence o synchronization . Halimbawa, ginagarantiyahan ng mga tagubilin ng bakod o harang ang pagkakasunud-sunod ng pag-access sa memorya at ipinapatupad ang ilang partikular na epekto ng visibility sa buong hierarchy ng cache. Sa kasong ito, mayroong tatlong-daan na kolaborasyon: ang compiler ang nagpapasya kung saan ilalagay ang mga tagubiling ito, kino-configure ng operating system ang execution environment, at ang hardware ang nagpapatupad ng aktwal na pag-uugali sa antas ng cache at memory bus.
Sama-sama, tinitiyak ng lahat ng elementong ito na, kahit na maraming kopya ng parehong data ang nakakalat sa iba't ibang cache at pangunahing memorya, ang mga parallel program ay tumatakbo gamit ang isang pare-parehong modelo ng memorya . Ang pagkakaugnay-ugnay ng cache, na malayo sa pagiging isang simpleng detalye ng panloob na CPU, ay nagiging isang pangunahing bahagi para sa mga multi-core system upang gumana nang maaasahan at mahusay.
Ang pag-unawa kung paano nagsasama-sama ang hierarchy ng cache, mga protocol ng hardware coherence, at mga pamamaraan ng suporta sa software ay nagpapaliwanag kung bakit ang mga modernong disenyo ng CPU ay may magkatulad na istraktura, at kung bakit ang isang maliit na pagkabigo sa alinman sa mga mekanismong iyon ay maaaring magdulot ng magulong pag-uugali sa mga sabay-sabay na aplikasyon na ganap na nakasalalay sa lahat ng mga core na nakakakita ng parehong data sa tamang oras.