- Ang pagbabawas ng mga hindi kinakailangang serbisyo, pakete, at port ay nagpapabuti sa pagganap at seguridad ng Linux server.
- Ang pag-tune ng kernel, memory, I/O, network, at mga pangunahing serbisyo ay nakakatulong na mabawasan ang latency at mga bottleneck.
- Ang pag-automate gamit ang Ansible at paggamit ng mga Tuned profile ay nagsisiguro ng pare-pareho at mauulit na mga configuration.
- Ang patuloy na pagsubaybay at pagsusuri ng mga sukatan ay nagbibigay-daan sa epektibong preventive maintenance.
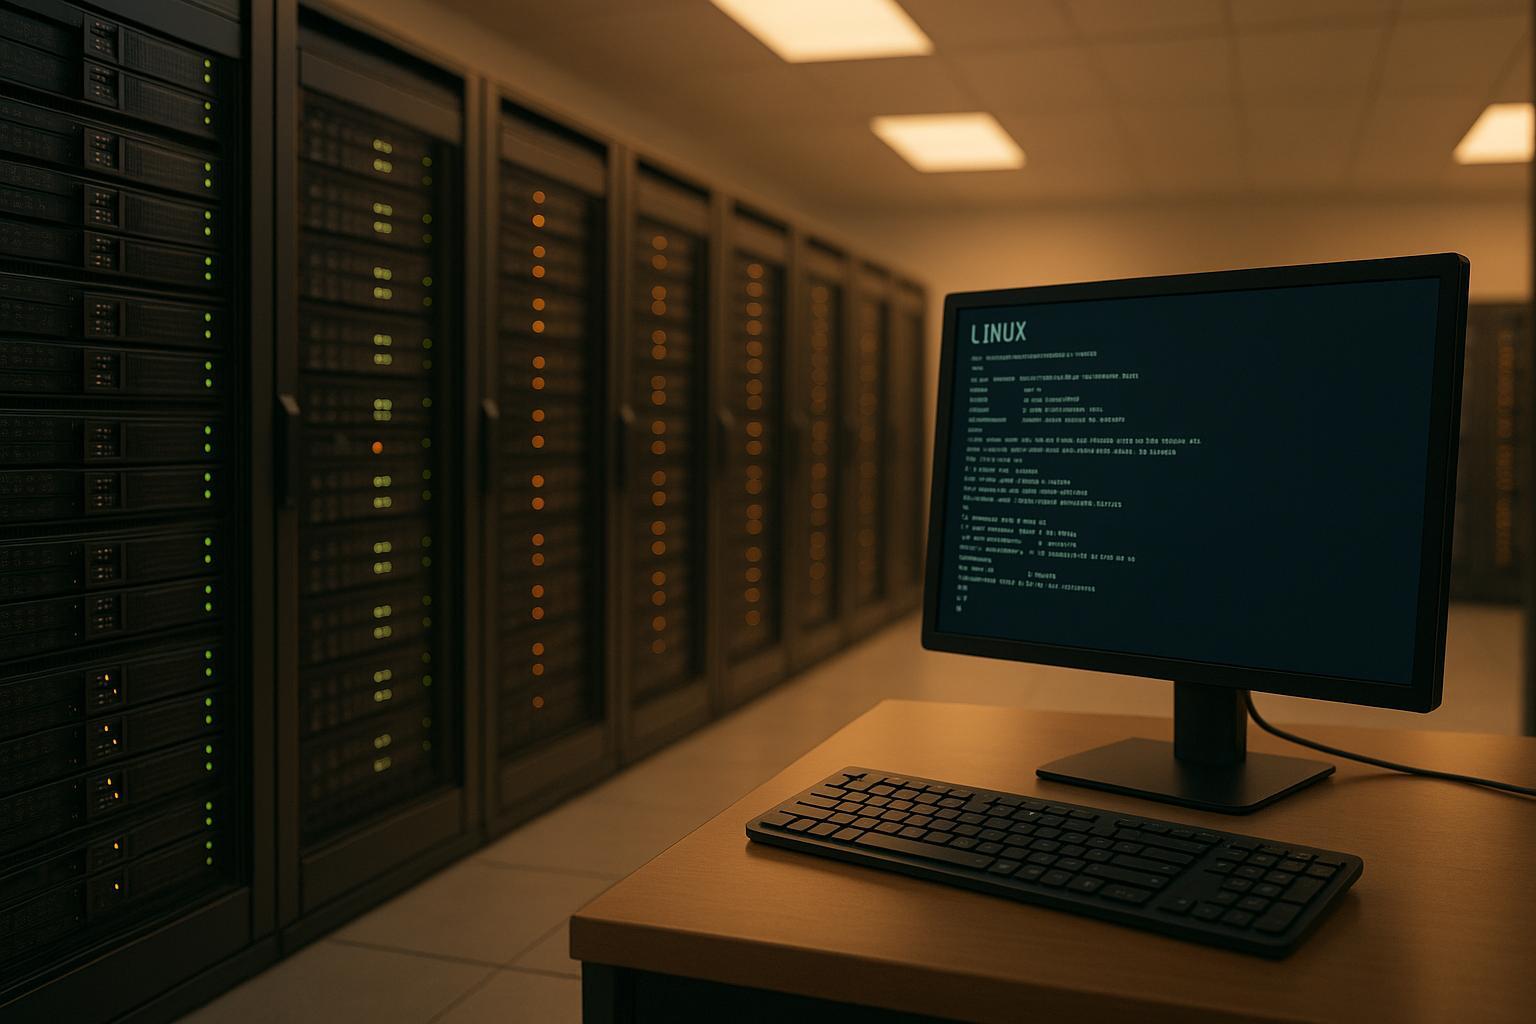
Kung namamahala ka ng mga Linux server sa produksyon, alam mo na hindi sapat ang pagbuo lamang ng isang makapangyarihang makina at pagpapatakbo nito. Ang tunay na pag-maximize ng performance, seguridad, at katatagan ay nangangailangan ng pagpino sa kernel , network, storage, mga serbisyo, at maging sa organisasyon ng administrative workload.
Pinagsasama-sama at muling inaayos ng artikulong ito ang marami sa pinakamahuhusay na ideya sa pag-optimize ng Linux server, pagpapalakas ng seguridad, at automation sa isang praktikal na gabay . Makikita mo kung paano bawasan ang latency, maiwasan ang mga bottleneck, palakasin ang iyong system laban sa mga pag-atake, at i-automate ang mga gawaing nangangailangan ng maraming mapagkukunan upang manatiling maayos ang pagtakbo ng iyong imprastraktura nang hindi mo kinakailangang magsulat ng hindi mabilang na mga utos araw-araw.
Bakit napakahalagang i-optimize at palakasin ang isang Linux server?
Sa maraming kumpanya, ang Linux ang puso ng imprastraktura: nagho-host ito ng mga database, web application, serbisyo ng VoIP, microservice, at mga workload na nangangailangan ng maraming compute . Kung hindi maayos ang pagkaka-configure ng server, lilitaw ang latency, pag-crash, I/O blocking, at, bilang dagdag pa, ang mga kahinaan sa seguridad na madaling mapagsamantalahan.
Nilalayon ng system hardening na isara ang mga attack vector, limitahan ang mga pribilehiyo, at bawasan ang attack surface . Kasabay nito, nilalayon ng performance optimization na tiyakin na ang bawat CPU cycle, bawat megabyte ng RAM, at bawat disk operation ay nagagamit nang mahusay, na iniiwasan ang pag-aaksaya na nakakabawas sa kapasidad ng mga kritikal na aplikasyon.
Bukod pa rito, ang manu-manong pamamahala ng dose-dosenang o daan-daang server ay hindi na maiisip ngayon. Ang mga tool tulad ng Ansible, Prometheus, Zabbix, Nagios, at TSplus Server Monitoring ay nagbibigay-daan sa iyong i-automate ang mga deployment, maglapat ng mga pare-parehong configuration, at subaybayan ang kalusugan ng system nang real time, nang mas maaasahan kaysa sa pag-access sa bawat server nang paisa-isa sa pamamagitan ng SSH.
Kung pagsasama-samahin, ang pagpapalakas, pag-optimize, at pag-automate ay magbabago sa isang generic na Linux server tungo sa isang matatag, mabilis, at madaling i-scalable na platform , na may kakayahang tumugon sa mga pagtaas ng load at mga banta nang hindi nasisira sa unang senyales ng problema.
Panatilihing magaan ang sistema: mga serbisyo, pakete, at port
Ang unang hakbang para matiyak na mahusay ang performance ng isang Linux server ay ang pag-iwas sa mga hindi kinakailangang gawain . Gaano man kalakas ang hardware, kung mayroon kang anim na walang kwentang daemon na kumukunsumo ng CPU, RAM, at disk space, lahat ay magdurusa.
Magsimula sa pamamagitan ng pagsuri sa mga serbisyong pinagana sa pagsisimula gamit ang isang bagay tulad ng ` systemctl list-unit-files --state=enabled` . Mula doon, i-disable ang anumang bagay na hindi makatwiran sa isang server: Bluetooth, mga serbisyo sa pag-print, mga automatic discovery daemon tulad ng Avahi, mga graphical environment, atbp.
Ang ideya ay sa isang production server, tanging ang SSH, ang firewall, ang monitoring agent, mga application daemon, mga storage service, at kakaunti pang iba ang dapat manatiling aktibo . Hindi lamang nito pinapalaya ang mga resources kundi binabawasan din nito ang bilang ng mga prosesong nalalantad sa mga potensyal na kahinaan.
Ganito rin ang prinsipyo sa mga naka-install na pakete. Maipapayo na ilista ang software gamit ang mga tool ng iyong distribution (rpm, yum, dnf, apt, atbp.) at alisin ang mga hindi nagamit na pakete na nagpapataas ng iyong attack surface . Gayunpaman, palaging suriin ang iyong mga dependency upang maiwasan ang aksidenteng pagkasira ng isang kritikal na bagay.
Panghuli, mainam na kasanayan na paminsan-minsang suriin ang mga listening port gamit ang mga command tulad ng `ss -tuln` o `netstat -tulnp` . Kung makakita ka ng mga hindi kaugnay na serbisyo o bukas na port na hindi mo ginagamit, isara ang mga ito o paghigpitan ang mga ito gamit ang isang firewall at partikular na configuration.
Pag-optimize ng CPU: mga prayoridad, pagkakaugnay, at pag-iiskedyul
Ginagamit ng Linux ang Completely Fair Scheduler (CFS) bilang default , na idinisenyo upang ipamahagi nang patas ang mga mapagkukunan ng CPU sa mga proseso. Gumagana ito nang maayos para sa pangkalahatang paggamit, ngunit sa mga server na sumusuporta sa mga database, streaming system, VoIP, o mga workload na halos real-time, ang mababang latency at predictability ay minsan inuuna kaysa sa ganap na pagiging patas.
Isa sa mga pinakasimpleng kagamitan ay ang renice, na nagbibigay-daan sa iyong itaas o ibaba ang prayoridad (nice) ng mga prosesong tumatakbo. Sa pamamagitan ng pagpapababa ng prayoridad ng mga pangalawang gawain at pagtataas nito para sa mga pangunahing proseso (tulad ng database server), mababawasan mo ang mga pagtaas ng latency kapag maraming CPU contention.
Isa pang mahalagang aspeto ay ang paggamit ng mga real-time na prayoridad gamit ang `chrt` para sa ilang partikular na prosesong sensitibo (palaging may lubos na pag-iingat), at ang pagkakaugnay ng CPU sa taskset, na nagbibigay-daan sa iyong magtalaga ng mga proseso sa isang subset ng mga core. Maaari nitong mabawasan ang pagpapalit ng konteksto sa pagitan ng mga CPU at mapabuti ang pagganap sa mga napaka-intensibong gawain.
Sa mga kapaligirang sobrang demanding, isinasaalang-alang din ang mga low-latency kernel o PREEMPT_RT kernel , na idinisenyo para sa high-frequency trading, telecom, o mga aplikasyong pang-industriya kung saan mahalaga ang mga millisecond. Hindi ito akma sa bawat server, ngunit isa pa rin itong kagamitan.
Pag-aayos ng memorya ng RAM: pagpapalit, mga cache, at HugePages
Ang memorya ay isa sa mga pinakamahalagang mapagkukunan: kapag ito ay kaunti, ang sistema ay gagamit ng pagpapalit ng impormasyon, at bumababa ang performance. Kaya naman napakahalaga na magamit ng server ang RAM nang mahusay at pare-pareho kasabay ng workload.
Kinokontrol ng parameter na `vm.swappiness` ng kernel kung gaano karami ang ginagamit ng system na swap space. Sa mga server na may sapat na memorya, karaniwan na babaan ang halaga nito upang mabawasan ang swapping , na nagpapahintulot sa kernel na manatili sa RAM nang mas matagal bago magsulat ng mga pahina sa disk.
Mahalaga ring tandaan ang `vm.vfs_cache_pressure`, na nakakaapekto sa pag-uugali ng mga inode at dentry cache. Ang wastong pagsasaayos nito ay nagbibigay-daan sa iyong balansehin ang alokasyon ng memorya sa pagitan ng file system cache at application memory , na mahalaga para sa mga file server o database na may maraming maliliit na operasyon.
Para sa malalaking database o mga aplikasyong gumagamit ng JVM, malaki ang naitutulong ng mga static na HugePages o Transparent Huge Pages (THP) . Ang pag-configure ng `vm.nr_hugepages` para magreserba ng naaangkop na malalaking pahina ay nakakabawas sa memory management overhead at maaaring mapabuti ang performance sa ilalim ng napakabigat na workload, basta't ang application ay idinisenyo para samantalahin ang mga ito.
Panghuli, ang overcommit control (vm.overcommit_memory) ang tumutukoy sa lawak kung saan nangangako ang kernel ng mas maraming memorya kaysa sa aktwal nitong mayroon. Sa mga database server at mga mission-critical na application, ang pagsasaayos ng pag-uugaling ito ay nakakatulong na maiwasan ang hindi inaasahang out-of-box (OOM) kills sa pinakamasamang posibleng sandali.
Mga Disk at I/O: mga file system, scheduler at RAID
Sa maraming kapaligiran, ang pangunahing hadlang ay hindi ang CPU kundi ang input/output (I/O) subsystem . Ang mga database, logging system, o analytics application ay karaniwang nahahadlangan ng mabagal na disk o mahinang configuration.
Ang unang hakbang ay ang pagpili ng I/O scheduler na pinakaangkop sa hardware . Sa mga modernong SSD, ang "none" o "mq-deadline" scheduler ay karaniwang gumagana nang maayos, dahil binabawasan nito ang lohika ng muling pag-order dahil minimal na ang mga disk latencies. Gayunpaman, sa mga mechanical hard drive, mas makatuwiran ang ibang mga scheduler.
Sa antas ng mount, ang mga opsyon tulad ng noatime at nodiratime ay pumipigil sa patuloy na pag-update ng mga timestamp ng pag-access sa file at direktoryo, na nagreresulta sa mas kaunting hindi kinakailangang mga write. Ito ay idinedeklara kapwa sa mga utos ng mount at patuloy sa /etc/fstab.
Mahalaga rin ang pagpili ng tamang file system . Ang XFS sa pangkalahatan ay isang mahusay na opsyon para sa mga high-concurrency load at malalaking file , habang ang isang mahusay na naka-tune na ext4 ay nananatiling matatag at maraming gamit. Sa anumang kaso, ang mga tool tulad ng tune2fs ay nagbibigay-daan sa iyong baguhin ang mga parameter upang makakuha ng mas mahusay na pagganap.
Hindi dapat kalimutan ang RAID layer: Nag-aalok ang RAID 10 ng kaakit-akit na balanse ng performance at redundancy para sa mga kritikal na database at data , samantalang ang RAID 0 ay akma lamang para sa mga transient load kung saan maaari mong ipagpalagay na mawawala ang data (hal., pansamantalang imbakan ng compute).
Network at TCP/IP stack: paggamit nang husto sa bandwidth
Kapag ang isang server ay humahawak ng mabigat na trapiko ng HTTP, mga persistent na koneksyon, o mataas na concurrency, ang network ay nagiging isang kritikal na bahagi ng pagganap. Ang isang matalinong pag-tune ng TCP/IP stack ay maaaring mabawasan ang latency, mapabuti ang throughput, at maiwasan ang hindi kinakailangang pagpila ng packet.
Isang klasikong paraan ay ang pagpapataas ng pinakamataas na bilang ng mga file descriptor gamit ang mga parameter na ulimit -ny tulad ng fs.file-max, upang ang sistema ay makahawak ng libu-libo o sampu-sampung libong sabay-sabay na koneksyon nang hindi nagka-crash.
Katulad nito, ang pagpapataas ng mga send at receive buffer gamit ang net.core.rmem_max, net.core.wmem_max at ang tcp_rmem / tcp_wmem series ay nagbibigay-daan sa TCP stack na mas madaling pangasiwaan ang mga long-distance, high-performance na koneksyon o maraming sabay-sabay na sesyon.
Kabilang sa iba pang mga kawili-wiling setting ang TCP Fast Open upang mapabilis ang mga pakikipagkamay , o ang pag-activate at wastong pag-configure ng RSS/RPS sa mga multi-core network card, upang ang packet processing load ay maipamahagi nang maayos sa pagitan ng mga CPU.
Panghuli, ang mga daemon tulad ng irqbalance ay nakakatulong sa mga pangkalahatang senaryo na ipamahagi ang mga interrupt sa pagitan ng mga core; sa mga ultra-low latency configuration, minsan ay hindi pinagana ang mga ito at manu-manong itinatakda ang mga IRQ, na nagpapakita na walang iisang recipe, ngunit sa halip ay dapat iakma ang configuration sa uri ng trapiko.
Seguridad ng account, SSH, firewall, at SELinux
Walang gaanong silbi ang isang mabilis na server kung ito ay madaling kapitan ng pag-atake. Ang seguridad ay nagsisimula sa mga pangunahing kaalaman: mga user account at mga patakaran sa pagpapatotoo.
Lubos na inirerekomenda na iwasan ang mga generic na username tulad ng "admin" o "oracle" at pumili ng mga hindi gaanong halatang pangalan. Bukod pa rito, dapat ipatupad ng mga patakaran sa password ang mahahabang at kumplikadong password na regular na pinapalitan . Binibigyang-daan ka ng mga tool ng system na suriin ang mga petsa ng pag-expire, minimum na haba, at iba pang mga paghihigpit.
Magandang ideya rin na i-customize ang hanay ng mga UID sa /etc/login.defs upang maiwasan ang mga walang kwentang pattern na maaaring ipagpalagay ng isang attacker . Sa huli, ang lahat ng mga detalyeng ito ay nagdaragdag ng maliliit na patong ng resistensya sa anumang pagtatangka ng brute-force.
Sa antas ng serbisyo, ang SSH ang pangunahing entry point. Maipapayo na huwag paganahin ang direktang root login , baguhin ang default port, paganahin ang public key authentication, at, kung naaangkop sa iyong kapaligiran, ganap na huwag paganahin ang password login.
Ang firewall (gamit ang firewalld, nftables, o iptables) — o isang implementasyon ng Netfilter at Suricata — ang nagiging unang linya ng depensa ng network: tinutukoy nito ang malinaw na mga patakaran na naglilimita sa papasok at palabas na trapiko sa kung ano lamang ang mahigpit na kinakailangan . Ang tahasang pagdaragdag ng mga serbisyo tulad ng SSH sa pampublikong sona at pag-reload ng configuration ay dapat na bahagi ng checklist para sa anumang deployment.
Nagdaragdag ang SELinux ng karagdagang patong ng mandatory access control. Ang pag-configure nito sa enforcement mode, pagrepaso sa mga denial log, at pagsasaayos ng mga patakaran gamit ang mga utility tulad ng semanage ay nakakatulong na mapigilan ang epekto ng isang potensyal na panghihimasok, na pumipigil sa isang mahinang serbisyo na ma-access ang mga resource na hindi nito pagmamay-ari.
Awtomasyon at pamamahala ng masa gamit ang Ansible
Kapag isa o dalawang server lang ang pinamamahalaan mo, nakakaakit na gawin ang lahat nang manu-mano. Ngunit habang lumalaki ang imprastraktura, ang tanging makatwirang solusyon ay ang pag-automate hangga't maaari . Dito nagniningning ang Ansible, salamat sa pagiging simple at pagiging agentless nito.
I-install lang ang Ansible sa isang control node at magpanatili ng imbentaryo sa /etc/ansible/hosts na may mga IP o hostname ng mga pinamamahalaang makina . Ang komunikasyon ay ginagawa sa pamamagitan ng SSH, kaya pinakamahusay na bumuo ng mga pares ng key at ipamahagi ang pampublikong key gamit ang ssh-copy-id upang maiwasan ang mga interactive na password.
Ang mga YAML playbook ay nagbibigay-daan sa iyo upang ilarawan ang mga gawain tulad ng pag-install ng mga pakete, pagbabago ng mga configuration file, pag-restart ng mga serbisyo, o pag-deploy ng mga application. Ang isang klasikong halimbawa ay isang playbook na nag-i-install at nagse-secure ng isang hanay ng mga karaniwang utility (tmux, monitoring agents, diagnostic tools) sa lahat ng web server sa isang cluster.
Ang malaking bentahe ay ang Ansible ay deklaratibo: inilalarawan mo ang ninanais na estado, at inaasikaso ng tool ang pagdadala ng bawat node sa estadong iyon, na iniiwasan ang magkakaibang mga configuration at paulit-ulit na mga pagkakamali ng tao . Nalalapat ito sa parehong pag-optimize ng pagganap at mga hakbang sa seguridad.
Awtomatikong pag-optimize gamit ang mga naka-tune na profile
Bukod sa mga manu-manong pagsasaayos, maraming distribusyon ang kinabibilangan ng Tuned, isang utility na naglalapat ng mga paunang natukoy na profile ng pagganap na iniayon sa iba't ibang uri ng mga workload: mga pangkalahatang server, virtual na bisita, imbakan, mababang latency, atbp.
Pagkatapos i-install at paganahin ang serbisyo, maaari mong ilista ang mga available na profile at i-activate ang pinakaangkop sa iyong mga pangangailangan. Ang isang klasiko sa mga virtualization environment ay ang profile na idinisenyo para sa mga guest machine o high-performance host , na nagbabago sa mga parameter ng kernel, pamamahala ng kuryente, at ilang setting ng I/O nang hindi mo kinakailangang isa-isang isaayos ang mga ito.
Ang kagandahan ng Tuned ay nag-aalok ito ng isang makatwiran at maaaring ulitin na panimulang punto. Mula doon, maaari mong palaging i-customize ang mga partikular na parameter para sa iyong mga sitwasyon , ngunit hindi ka na magsisimula sa simula; nagsisimula ka na sa isang configuration na nasubukan sa mga katulad na sitwasyon.
Mga sukatan at kagamitan sa pagsubaybay: CPU, memorya, disk, at network
Walang pag-optimize kung walang datos. Para malaman kung ang isang pagbabago ay nagpapabuti o nagpapalala sa sistema, kailangan mo ng maaasahan at real-time na mga sukatan . Kung hindi, bulag mo lang itong kinukunsinti.
Para sa mga CPU, ang mga tool tulad ng top at htop ay nag-aalok ng interactive na view ng mga prosesong pinakamadalas gumamit ng resources, ang load sa bawat core, at ang distribusyon ng mga estado (user, system, I/O waiting, atbp.). Ang pagsusuri sa impormasyong ito ay nakakatulong sa pagtukoy ng mga prosesong hindi naaayon sa inaasahan o kawalan ng balanse sa pagitan ng mga core.
Sa memorya, ang mga utos tulad ng free, vmstat, o pagbabasa ng /proc/meminfo ay nagbibigay ng mga detalye tungkol sa aktwal na paggamit ng RAM, mga cache, buffer, swap consumed , at marami pang iba. Nagbibigay-daan ito sa iyong mahanap ang mga tagas ng memorya o mga application na nagrereserba ng mas maraming memorya kaysa sa makatwiran.
Para sa disk I/O, ipinapakita ng iostat ang pinagsama-samang istatistika bawat device (paggamit, average na oras ng serbisyo, operasyon bawat segundo), habang ipinapakita naman ng iotop, proseso ayon sa proseso, kung aling serbisyo ang bumubuo ng pinakamaraming trapiko. Ginagawang napakadaling matukoy ng kombinasyong ito kung aling serbisyo ang pumupuno sa storage.
Sa isang network, ang mga tool tulad ng iftop o nethogs ay nagbibigay-daan sa iyong makita nang live kung aling mga koneksyon at proseso ang gumagamit ng pinakamaraming bandwidth, na mahalaga para sa pag-detect ng mga abnormal na trapiko, mga pang-aabuso, o mga simpleng load imbalance.
Patuloy na pagsubaybay, mga alerto at preventive maintenance
Higit pa sa mga interactive na utos, ang isang seryosong kapaligiran ay nangangailangan ng isang sentralisadong sistema ng pagsubaybay. Ang mga solusyon tulad ng Nagios, Zabbix, Prometheus, o TSplus Server Monitoring ay nagbibigay-daan sa iyong mangolekta ng mga sukatan mula sa maraming server, iimbak ang mga ito bilang time series, at mag-trigger ng mga alerto kapag may lumihis sa karaniwan.
Kabilang sa mga karaniwang configuration ang pagsubaybay sa CPU load, available memory, disk latency, paggamit ng network, status ng serbisyo, at mga certificate . Batay sa mga paunang natukoy na threshold, ipinapadala ang mga notification kapag naabot ang mga mapanganib na value o may natukoy na mga pagkabigo.
Sa paglipas ng panahon, ang mga kagamitang ito ay nakakaipon ng mahahalagang datos sa kasaysayan para sa pagsusuri ng mga uso: paglago ng paggamit, mga oras ng rurok, mga epekto ng mga update... Binubuksan nito ang pinto para sa mga estratehiya sa predictive maintenance , kung saan isinasagawa ang mga aksyon bago pa man mangyari ang isang pagkabigo.
Kasabay nito, mahalagang mag-iskedyul ng mga nakagawiang gawain gamit ang cron o mga katulad na sistema: mga update, backup, pag-rotate ng log, pagsusuri ng integridad ng file system, atbp. Tinitiyak ng pag-automate ng mga gawaing ito na palagi itong naisagawa at pinipigilan ang mga hindi pagkakasundo na maaaring maging magastos sa kalaunan.
Pag-optimize ng serbisyo: web, mga database at mga aplikasyon
Malaking bahagi ng pangkalahatang pagganap ay nakasalalay hindi lamang sa operating system, kundi pati na rin sa kung paano mo iko-configure ang mga serbisyong tumatakbo sa ibabaw nito. Ang isang walang kapintasang Linux server ay maaaring mahadlangan ng isang hindi maayos na na-configure na MySQL o Nginx instance.
Sa mga database ng MySQL o MariaDB, ang my.cnf file ay naglalaman ng karamihan sa mahahalagang parameter: ang laki ng iba't ibang buffer, mga limitasyon sa koneksyon, mga query cache, pag-uugali ng InnoDB, atbp. Ang pagsasaayos ng mga halaga tulad ng innodb_buffer_pool_size, query_cache_size, key_buffer_size, o tmp_table_size ay gumagawa ng malaking pagkakaiba sa pagitan ng isang sistemang nauutal at isa na maayos na tumutugon.
Sinusuri ng mga tool tulad ng MySQLTuner ang mga istatistika ng server pagkatapos nitong tumakbo nang ilang sandali at nagmumungkahi ng mga partikular na pagbabago sa configuration upang mapabuti ang performance at stability . Hindi dapat sundin nang walang ingat ang kanilang mga mungkahi, ngunit nagsisilbi itong isang kapaki-pakinabang na gabay upang malaman kung saan magsisimula.
May ginagampanan din ang hardware: ang paglipat ng mga highly active database sa mga SSD o pagpapatakbo ng mga ito sa mga na-optimize na container ay lubos na nakakabawas sa read at write latency, lalo na't kapansin-pansin sa ilalim ng mga workload na may maraming random na query o malalaking volume ng data . Isa ito sa mga pinakakanais-nais na pagpapabuti sa performance.
Sa mga web server tulad ng Nginx o Apache, ang mga parameter tulad ng bilang ng mga manggagawa, mga limitasyon sa koneksyon, keepalive, mga laki ng buffer, at mga estratehiya sa caching ay mahalaga. Ang pagsasaayos ng mga ito sa aktwal na pattern ng trapiko ( maraming maliliit na kahilingan, ilang napakalaki, maraming static na nilalaman , atbp.) ay pumipigil sa hindi kinakailangang overload ng server.
Nakikinabang ang mga aplikasyon ng Java mula sa mahusay na pag-tune ng JVM: pagpili ng garbage collector (G1GC, ZGC…), laki ng heap, at mga partikular na parameter na nagbabawas ng mga pag-pause at nagpapabuti ng latency. Katulad nito ang naaangkop sa iba pang mga runtime environment na nagbibigay-daan sa iyong pinuhin ang kanilang memorya at pamamahala ng concurrency.
Pagtukoy at paglutas ng mga bottleneck
Dahil nailagay na ang lahat ng mga piyesang ito, mayroon pa ring isang pangunahing gawain na dapat gawin: ang pag-alam kung saan eksakto ang bottleneck kapag ang sistema ay hindi gumagana nang maayos.
Nagsisimula ang proseso sa pamamagitan ng pagkolekta ng datos sa pagsubaybay: mga peak ng CPU, disk latency histogram, paggamit ng memorya, mga oras ng pagtugon ng network, mga sukatan ng database… Sa pamamagitan ng pagsusuri ng datos na ito nang sama-sama, matutukoy ang malinaw na mga pattern ng saturation o anomalya na pag-uugali.
Kapag natukoy na ang lugar ng problema (CPU, RAM, disk, network, partikular na aplikasyon), ang susunod na hakbang ay ang pagpapasya kung sapat na ang pag-optimize ng configuration o kung kinakailangan ang mga karagdagang resources . Minsan, sapat na ang pagpapalit ng parameter ng kernel, pagsasaayos ng laki ng cache, o paghahati ng database sa maraming instance; sa ibang pagkakataon, ang tanging solusyon ay ang pagdaragdag ng mas maraming CPU, mas maraming RAM, o mas mabilis na storage.
Pagkatapos ipatupad ang mga pagbabago, kailangang ulitin ang mga load test at magsagawa ng mga sukat. Sa ganitong paraan lamang matutukoy kung ang problema ay tunay na nalutas na o inilipat na lamang sa ibang lugar. Ang patuloy na siklo ng pagsukat, pagsasaayos, at pag-verify ang siyang esensya ng seryosong pag-optimize.
Kapag ang mga desisyong ito ay sinusuportahan din ng malawak na datos sa kasaysayan at, kung naaangkop, ng mga modelo ng pagsusuri ng trend o maging ng machine learning, posibleng mahulaan ang mga insidente sa hinaharap at mag-iskedyul ng mga pagpapalawak o pagsasaayos bago magsimulang magdusa ang sistema.
Ang buong hanay ng mga kasanayang ito—mga serbisyo sa paglilinis, pag-tune ng kernel, pamamahala ng memorya at disk, pagpino ng network, pagpapalakas ng seguridad, pag-automate gamit ang Ansible, paggamit ng mga Tuned profile, pagsubaybay gamit ang mga modernong tool, at pagpapakinis ng mga pangunahing serbisyo—ay nagbabago sa anumang ordinaryong Linux server tungo sa isang matatag, mabilis, at pangmatagalang malusog na plataporma na mas mahusay na nakakayanan ang mga spike, nagtatanggol laban sa mga pag-atake, at nangangailangan ng mas kaunting manu-manong interbensyon upang mapanatili ang pagganap.

Talatuntunan
- 1 Bakit napakahalagang i-optimize at palakasin ang isang Linux server?
- 2 Panatilihing magaan ang sistema: mga serbisyo, pakete, at port
- 3 Pag-optimize ng CPU: mga prayoridad, pagkakaugnay, at pag-iiskedyul
- 4 Pag-aayos ng memorya ng RAM: pagpapalit, mga cache, at HugePages
- 5 Mga Disk at I/O: mga file system, scheduler at RAID
- 6 Network at TCP/IP stack: paggamit nang husto sa bandwidth
- 7 Seguridad ng account, SSH, firewall, at SELinux
- 8 Awtomasyon at pamamahala ng masa gamit ang Ansible
- 9 Awtomatikong pag-optimize gamit ang mga naka-tune na profile
- 10 Mga sukatan at kagamitan sa pagsubaybay: CPU, memorya, disk, at network
- 11 Patuloy na pagsubaybay, mga alerto at preventive maintenance
- 12 Pag-optimize ng serbisyo: web, mga database at mga aplikasyon
- 13 Pagtukoy at paglutas ng mga bottleneck