- Сучасний штучний інтелект базується на алгоритмах оптимізації, які автоматизують завдання, аналізують великі обсяги даних та дозволяють створювати нові бізнес-моделі.
- Основні ризики включають алгоритмічну упередженість, втрату роботи, порушення конфіденційності, маніпулювання інформацією та більш складні кібератаки.
- Генеративний ШІ додає специфічних проблем: галюцинації, діпфейки, технологічну залежність, зростання витрат, а також проблеми інтелектуальної власності та репутації.
- Сильне управління, чіткі регуляторні рамки та використання штучного інтелекту для управління ризиками є ключовими для використання його потенціалу без втрати контролю над його впливом.
Інтеграція штучного інтелекту в усі аспекти нашого життя відбувається набагато швидше, ніж більшість організацій та окремих осіб могли собі уявити. Від ранніх алгоритмів рекомендацій ми рекордно швидко перейшли до генеративних моделей, здатних складати звіти, аналізувати контракти, створювати гіперреалістичні зображення та приймати автоматизовані рішення в критично важливих бізнес-процесах.
Це швидке розширення відкриває широкий спектр можливостей, але воно також несе з собою ризики, етичні дилеми та регуляторні виклики , які не можна ігнорувати. Йдеться не про вибір між апокаліптичним баченням та наївним технооптимізмом, а про спокійне розуміння того, що насправді робить сучасний ШІ, чого він не робить, де він додає найбільшу цінність і де він може стати серйозною проблемою, якщо ним не керувати з розумом.
Що ми розуміємо сьогодні під штучним інтелектом?
Коли ми говоримо про ШІ у повсякденному житті, ми насправді маємо на увазі набір алгоритмів оптимізації та статистичних моделей, навчених на великих обсягах даних . Це не свідомі машини чи «мізки», які мислять як людина, а радше системи, які вивчають закономірності та генерують результати, корисні (або правдоподібні) для дуже конкретних завдань.
У світі бізнесу штучний інтелект став популярним, оскільки він дозволяє автоматизувати рутинні завдання, аналізувати величезні бази даних та підтримувати прийняття рішень з точністю та швидкістю, недосяжними для людської команди. Від асистованої медичної діагностики до раннього виявлення фінансового шахрайства, варіанти використання множаться в усіх секторах.
Однак важливо розрізняти те, що називається обмеженим штучним інтелектом (який вирішує конкретні проблеми: класифікацію зображень, переклад текстів, рекомендації контенту тощо), та гіпотетичним загальним штучним інтелектом , який прагне міркувати про будь-яке завдання, як людина. Наразі те, що ми використовуємо у великих масштабах, – це обмежені системи, якими б вражаючими не здавалися такі моделі, як ChatGPT, Bard або DALL-E.
Ці моделі, особливо мовні моделі, розроблені для розрахунку найімовірнішої та соціально прийнятної реакції на вхідні дані, а не для розуміння світу чи досягнення власних цілей. Вони імітують міркування, але під капотом ховаються складні статистичні обчислення, а не свідомість чи намір.
Як працює ШІ: ключові методи
Більшість сучасних застосувань штучного інтелекту спираються на три основні технологічні блоки: машинне навчання, глибоке навчання та обробку природної мови , а також комп'ютерний зір для всього, що пов'язано із зображеннями та відео.
Машинне навчання або автоматичне навчання
Машинне навчання (ML) – це галузь, яка зосереджена на створенні алгоритмів, здатних навчатися на основі даних , без необхідності явно програмувати кожне правило. Система знаходить закономірності та на їх основі робить прогнози, класифікації або рекомендації.
У навчанні з учителем моделі навчаються на маркованих даних, які вказують на правильну відповідь (наприклад, чи була транзакція шахрайською чи ні). З іншого боку, у навчанні без учителя алгоритм виявляє приховані структури та групи в немаркованих даних, що дуже корисно для сегментації клієнтів, виявлення аномалій або групування поведінки.
Типовим прикладом у галузі є використання машинного навчання (ML) для аналізу даних у режимі реального часу від заводських датчиків (температура, вібрації, цикли використання) та передбачення моменту виходу машини з ладу, що дозволяє проводити прогнозне обслуговування.
Глибоке навчання
Глибоке навчання — це підмножина машинного навчання, яка використовує багатошарові штучні нейронні мережі для вивчення дедалі складніших представлень даних. Ці мережі натхненні структурою мозку, хоча їхнє фактичне функціонування значно відрізняється від біологічного.
Завдяки глибокому навчанню такі програми, як розпізнавання мовлення, вдосконалений комп'ютерний зір, системи рекомендацій та автономне водіння, набули широкого розгортання . Маючи доступ до величезних наборів даних та обчислювальної потужності, ці мережі можуть виявляти дуже тонкі зв'язки, які раніше було неможливо змоделювати.
Наприклад, у таких секторах, як автомобільна промисловість, глибоке навчання використовується для інтерпретації зображень з камер, а також даних радарів і лідарів з автономного транспортного засобу, оцінки відстаней, прогнозування траєкторій та майже миттєвого прийняття рішень щодо маневрів.
Обробка природної мови
Обробка природної мови (НЛП) зосереджена на тому, щоб дозволити системам розуміти, аналізувати та генерувати людську мову , як текст, так і мовлення. Це включає такі завдання, як класифікація документів, узагальнення текстів, переклад, відповіді на запитання та ведення розмов.
Сучасні моделі великих мов (LLM) можуть виявляти синтаксичні структури та семантичні нюанси у величезних обсягах тексту , що дозволяє їм створювати напрочуд природні відповіді. Вони використовуються в чат-ботах, віртуальних помічниках, аналізі настроїв, обслуговуванні клієнтів та внутрішній підтримці в компаніях.
комп'ютерний зір
Машинний зір зосереджений на тому, щоб дозволити машинам інтерпретувати зображення та відео з рівнем деталізації, подібним до людського . Прикладами є виявлення об'єктів, розпізнавання облич, читання символів, вимірювання розмірів або виявлення дефектів у промислових деталях.
Ця технологія стала ключовим компонентом контролю якості на заводах, системах спостереження, медичній візуалізації та доповненій реальності, серед багатьох інших застосувань.
Переваги та можливості ШІ
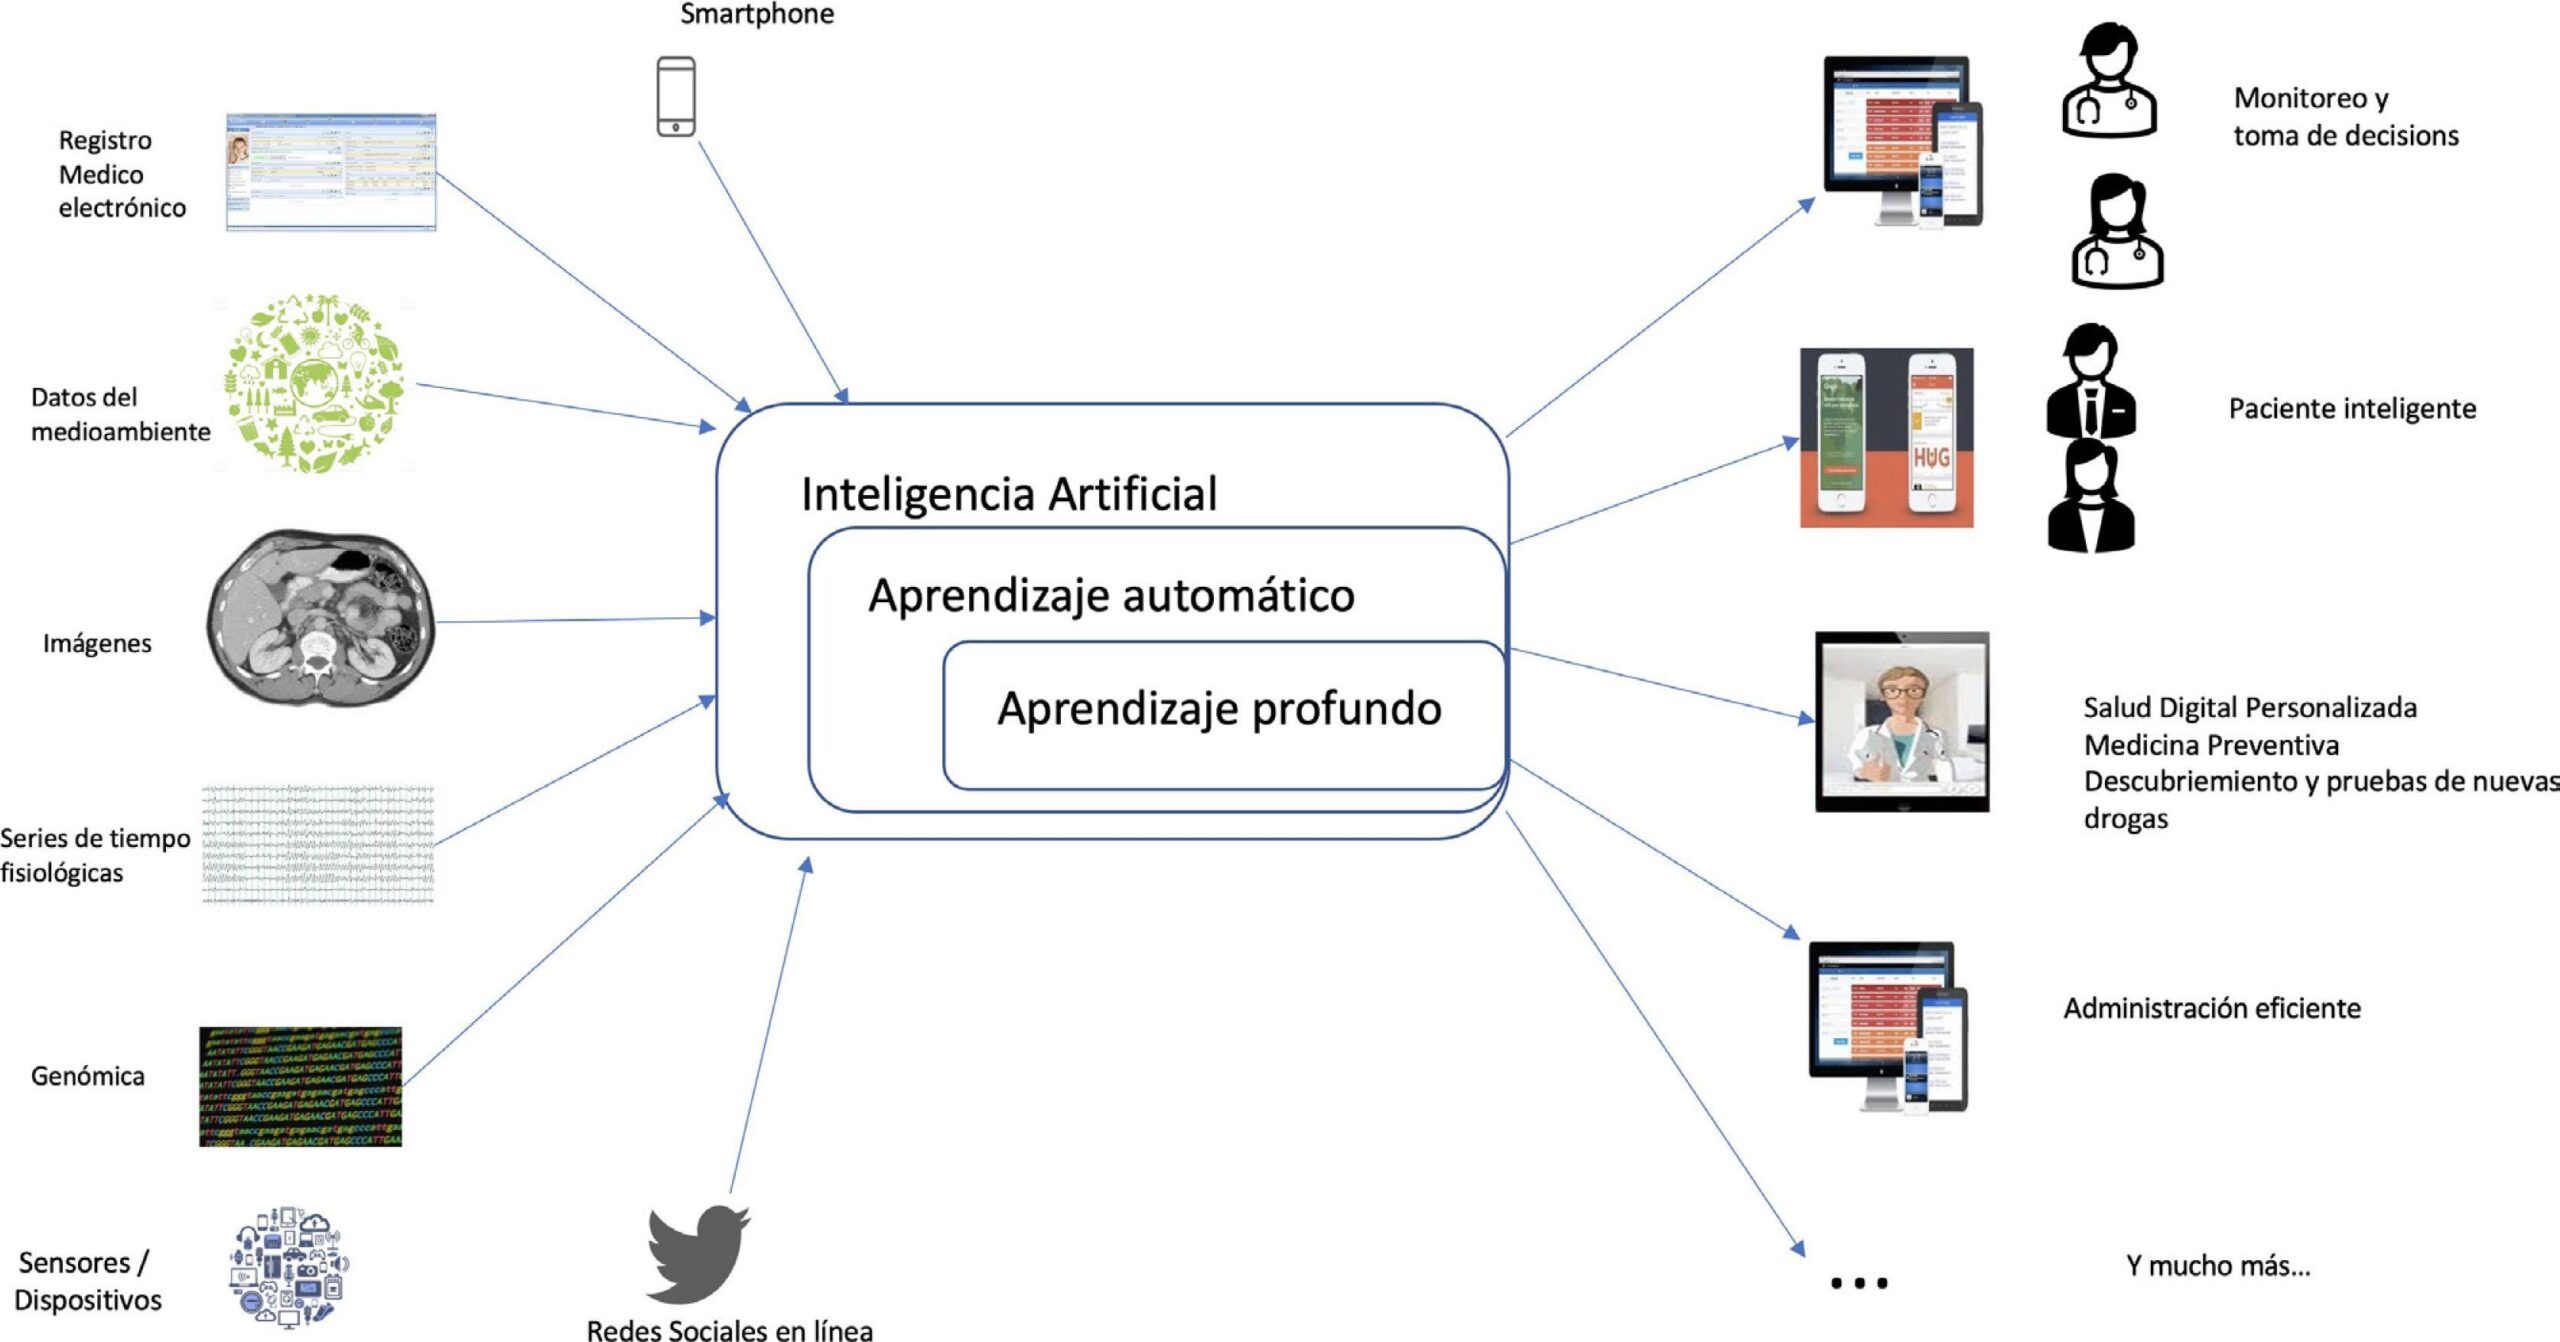
На економічному та соціальному рівні штучний інтелект відкриває двері до нової хвилі інновацій у продуктах, послугах та бізнес-моделях . Наприклад, у Європі він вважається важливим рушієм трансформації таких секторів, як зелена економіка, промислові технології , сільське господарство, охорона здоров'я, туризм та мода.
У світі бізнесу однією з найбільших сильних сторін штучного інтелекту є автоматизація повторюваних процесів і виснажливих завдань . Фізичні роботи та інтелектуальне програмне забезпечення можуть обробляти механічні операції, класифікувати інциденти, генерувати стандартні відповіді або витягувати дані, звільняючи людський час для творчої та стратегічної роботи.
Ще однією ключовою перевагою є здатність зменшити кількість людських помилок у завданнях з високою частотою повторень або високою точністю . Від виявлення мікродефектів у деталях за допомогою інфрачервоних камер до автоматичного введення даних, штучний інтелект мінімізує помилки та покращує відстеження.
Водночас, інтелектуальні системи забезпечують надзвичайну точність аналізу великих обсягів інформації , генеруючи корисні показники для прийняття інвестиційних рішень, коригування цін, визначення штату персоналу або перепроектування процесів. Ця аналітична здатність підвищує якість бізнес-рішень.
У сфері охорони здоров'я штучний інтелект вже використовується для підтримки діагностики на основі медичних зображень, розробки персоналізованих методів лікування та пришвидшення розробки ліків . У банківській справі та фінансах він допомагає виявляти шахрайство, оцінювати кредитні ризики та автоматизувати операції на фондовому ринку.
Державні послуги також отримують вигоду: оптимізований транспорт, розумне управління відходами, енергозбереження, персоналізована освіта та ефективніше електронне урядування – це чіткі сфери застосування. Водночас аналітики зазначають, що відповідальне використання штучного інтелекту може сприяти зміцненню демократії, допомагаючи боротися з дезінформацією, виявляти кібератак та підвищувати прозорість процесів закупівель.
Генеративний ШІ: новий стрибок у можливостях… і в ризиках
Поява генеративного штучного інтелекту стала поворотним моментом, оскільки ці системи здатні створювати оригінальний та правдоподібний контент : технічні тексти, зображення, аудіо, відео чи код, а також практичні приклади, такі як створення стікерів WhatsApp за допомогою ChatGPT.
Для бізнесу це відкриває можливість набагато швидше створювати документи, маркетингові кампанії, звіти або прототипи , а також підтримувати команди за допомогою помічників з продуктивності. Однак це також створює додаткові проблеми з точки зору якості, інтелектуальної власності, безпеки та репутації.
Серед найпомітніших ризиків є генерування невірної інформації або «галюцинацій» : модель вигадує дані або посилання, які здаються переконливими, але не відповідають дійсності. Якщо їх належним чином не перевірити, це може призвести до помилкових рішень, особливо в таких критично важливих сферах, як охорона здоров'я, право чи фінанси.
До цього додається питання інформаційної безпеки та конфіденційності . Якщо модель передається з конфіденційними даними (клієнти, пацієнти, бізнес-стратегія) без необхідних заходів безпеки, існує ризик витоку, невідповідності нормативним вимогам або неналежного повторного використання цієї інформації.
Крім того, генеративний штучний інтелект може сприяти надмірній технологічній залежності , що призводить до збільшення витрат, пов'язаних з використанням великих моделей, а також може надмірно гомогенізувати контент і пропозиції, зменшуючи диференціацію брендів, якщо всі вони використовують одні й ті ж інструменти без їх персоналізації.
Міжгалузеві ризики штучного інтелекту
Окрім генеративних аспектів, масове впровадження штучного інтелекту несе в собі низку структурних ризиків, які впливають на зайнятість, основні права, безпеку та економічну стабільність . Розуміння цих ризиків є важливим для управління ними.
Звільнення з роботи та дефіцит кваліфікованих кадрів
Автоматизація на основі штучного інтелекту має неоднозначний вплив на зайнятість: вона ліквідує певні робочі місця, трансформує інші та створює нові професії . Особливо вразливими є адміністративні завдання, рутинна офісна робота та основні контрольні обов'язки.
Без чіткої політики професійної перепідготовки та підвищення кваліфікації багато людей можуть залишитися позаду на ринку праці, що посилить існуючу нерівність. У плановій економіці цей перехід міг би бути краще організований; у сучасному капіталізмі він часто призводить до нестабільності та нестабільності, поки виробнича структура коригується.
Алгоритмічні упередження та дискримінація
Алгоритми навчаються на історичних даних, які часто відображають існуючі упередження, нерівність та структури влади . Якщо ці упередження не виправити, системи відтворюють та посилюють їх у процесах найму, схвалення кредитів, управління страхуванням і навіть у судовій системі.
Нам уже відомі випадки, коли моделі відбору персоналу систематично карали жінок через те, що вони навчалися переважно за чоловічими шаблонами, або коли інструменти оцінки кримінальних ризиків містили расові упередження. Зменшення цього ризику вимагає незалежних аудитів, різноманітних команд розробників, а також збалансованих і перевірених даних про навчання.
Конфіденційність, спостереження та основні права
Штучний інтелект працює краще, чим більше даних він має, що стимулює масовий збір особистої інформації . Системи розпізнавання облич, онлайн-відстеження, створення детальних поведінкових профілів та аналіз соціальних мереж можуть поставити під загрозу конфіденційність і, потрапивши в чужі руки, стати інструментами стеження.
Європейське законодавство (включно з майбутнім Законом про штучний інтелект) зосереджено на обмеженні високоризикових застосувань, таких як масова біометрична ідентифікація або автоматизоване прийняття рішень без людського контролю . Незважаючи на це, небезпека зловживань залишається, особливо в контекстах з менш демократичним контролем.
Безпека, кібератаки та зловмисне використання
Штучний інтелект — це палиця з двома кінцями: хоча він допомагає запобігати, виявляти та краще реагувати на кіберзагрози , він також може розширити можливості зловмисників. Автоматизація фішингових кампаній, створення складніших шкідливих програм або обхід систем виявлення за допомогою прикладів зловмисників — це деякі з ризиків.
У військовій сфері та сфері національної безпеки обговорюється вплив автономної зброї, автоматизованих систем оборони та кібервійни за підтримки штучного інтелекту . Міжнародна спільнота все ще далека від чіткого консенсусу щодо етичних та правових обмежень цих застосувань.
Маніпуляції інформацією та діпфейки
Генеративний штучний інтелект дозволяє відносно легко створювати фальшиві, але дуже правдоподібні відео, аудіо та зображення — так звані діпфейки. Їх можна використовувати для вимагання, політичних маніпуляцій, репутаційних атак або масових дезінформаційних кампаній.
Водночас, алгоритми, що персоналізують контент у соціальних мережах, можуть заманювати користувачів у лунокамери , підкріплюючи крайні точки зору та ще більше поляризуючи публічну сферу. Таким чином, ШІ стає підсилювачем існуючої динаміки з охопленням, яке важко контролювати.
Непередбачуваність та складність систем
Оскільки моделі стають складнішими та автономнішими, їхня поведінка стає менш прозорою, навіть для їхніх творців . Це ускладнює пояснення причин прийняття певного рішення, що є критично важливим у регульованому середовищі.
Делегування ключових функцій (охорона здоров'я, інфраструктура, юстиція, транспорт) непрозорим системам збільшує ризик системних збоїв, каскадних ефектів та втрати людського контролю . Звідси важливість розробки моделей, які можна пояснити, з можливістю відстеження та ручного втручання.
Етичні, регуляторні та відповідальні проблеми
Зростання популярності штучного інтелекту порушило складні питання: хто несе відповідальність, якщо алгоритм завдає шкоди? Як можна гарантувати справедливість та прозорість? Які обмеження слід встановити? Традиційні правила відстають від темпів інновацій, створюючи правові лазівки.
Європейський Союз просуває Закон про штучний інтелект, який класифікує програми за рівнями ризику та встановлює суворіші вимоги для програм із високим рівнем впливу (охорона здоров'я, транспорт, зайнятість, юстиція, безпека). Він включає зобов'язання щодо документування, аудиту, управління навчальними даними та людського нагляду.
Особливо делікатним питанням є відповідальність у разі завданих збитків . Якщо безпілотний автомобіль спричиняє аварію або автоматизована система неправомірно відмовляє у видачі кредиту, чи несе відповідальність виробник обладнання, розробник моделі, компанія, яка її експлуатує, чи кінцевий користувач? Занадто слабка система може негативно впливати на якість; занадто жорстка — придушувати інновації.
Паралельно, етика штучного інтелекту вимагає виходу за рамки простого формального дотримання закону. Організації, розробники та регуляторні органи повинні домовитися про принципи справедливості, недискримінації, поваги до автономії та зменшення шкоди . А це неминуче вимагає обґрунтованого публічного обговорення, за участю не лише компаній та урядів, а й громадян та зацікавлених груп.
Управління штучним інтелектом в організаціях: від хаосу до спільної структури
У багатьох компаніях впровадження штучного інтелекту розпочалося неформально: кожен відділ тестує власну модель або самостійно інтегрує зовнішній сервіс . Маркетинг використовує генератор тексту, операції навчають класифікатору інцидентів, відділ кадрів експериментує з інструментами перевірки резюме…
Такий підхід «від моделі до моделі» має перевагу в швидкості, але в середньостроковій перспективі він призводить до технологічної фрагментації, дублювання зусиль та відсутності контролю . Виникають десятки ізольованих рішень без спільної стратегії, відстежуваності чи спільних показників вартості та цінності.
Ризики зростають: невідомо, скільки моделей перебуває у виробництві, які дані вони використовують або хто їх обслуговує . Журнали рішень є неповними, що перешкоджає внутрішньому або регуляторному аудиту. А рахунки за хмарні послуги продовжують зростати, і ніхто не має чіткого уявлення про прибутки.
Альтернативою є перехід до централізованої системи управління , яка дозволяє продовжувати експерименти, але на спільній основі: каталоги моделей, політики даних, засоби контролю доступу, спільні інструменти моніторингу, відстеження та оцінка ризиків. Спеціалізовані архітектури, такі як корпоративні платформи штучного інтелекту, спрямовані саме на поєднання локальної гнучкості з глобальним контролем.
Без цієї дисципліни ШІ стає джерелом технічного боргу, правової невизначеності та перевитрат коштів . Однак з нею він стає ще одним стратегічним рівнем, нарівні з кібербезпекою чи управлінням даними, здатним забезпечити стійкі конкурентні переваги.
Застосування штучного інтелекту в управлінні ризиками підприємства
Як не парадоксально, багато загроз, пов'язаних зі штучним інтелектом, можна пом'якшити, використовуючи сам штучний інтелект як союзника в управлінні ризиками в організаціях. У таких сферах, як операційні ризики, дотримання нормативних вимог, боротьба з відмиванням грошей та інформаційна безпека, він вже використовується з позитивними результатами.
З одного боку, алгоритми дозволяють аналізувати великі обсяги внутрішніх та зовнішніх даних за дуже короткий час , виявляючи аномальні моделі поведінки, тривожні тенденції або комбінації факторів, які зазвичай передують відповідним інцидентам.
Прогнозні моделі також особливо цінні , оскільки вони допомагають передбачити матеріалізацію певних ризиків на основі історичних тенденцій. Це дозволяє планувати превентивні заходи, посилювати контроль або адаптувати страхове покриття.
У запобіганні шахрайству штучний інтелект може контролювати транзакції, доступ до системи та фінансові рухи в режимі реального часу , виявляючи підозрілі операції, які залишаються непоміченими людським оком. Аналогічно, в управлінні ризиками відповідності алгоритми сегментації сприяють класифікації клієнтів, продуктів або юрисдикцій відповідно до їхнього профілю ризику.
Все це, звичайно, вимагає високоякісних, добре керованих та репрезентативних даних . Без міцної інформаційної основи моделі генерують хибнопозитивні результати, упередження та неправильні рішення. Технології не замінюють професійне судження, а радше доповнюють його та роблять ефективнішим.
В останні роки також з'явилися специфічні рішення на основі генеративного штучного інтелекту, які виступають в ролі інших пілотів в управлінні ризиками , допомагаючи виявляти, описувати та оцінювати загрози на основі чинних норм, сектору та процесів кожної компанії. При інтеграції в надійні платформи з відповідними засобами контролю ці помічники значно підвищують продуктивність команд з управління ризиками.
Поєднання всього вищезазначеного створює неоднозначну картину: штучний інтелект має величезний потенціал для покращення того, як ми виробляємо, приймаємо рішення та живемо, але він також посилює нерівність, помилки та конфлікти, якщо його використовувати без критеріїв чи контролю . Пошук балансу вимагає інвестування в навчання, посилення регулювання, впровадження надійних систем управління та постійного залучення людей до рішень, використання ШІ як інструменту, а не як самоцілі.