- Архітектурні відмінності між центральним та графічним процесорами, що дозволяють виконувати масивні паралельні обчислення.
- Стратегії розгортання хмарних ресурсів з використанням стандартних, точкових та гнучких моделей забезпечення ресурсами.
- Критичні технічні критерії вибору обладнання на основі відеопам'яті, пропускної здатності та затримки.
- Розширене програмування та системи глобальної оркестрації для оптимізації використання кластерів штучного інтелекту.

Коли ми говоримо про потужність для переміщення гір даних, неможливо не згадати фундаментальну роль, яку відіграють графічні процесори. Хоча спочатку вони були розроблені для того, щоб відеоігри виглядали неймовірно, сьогодні вони є головним двигуном штучного інтелекту та аналізу масивних даних, що дозволяє виконувати завдання, на які раніше потрібно було тижнями, лише за кілька годин.
Перенесення цих робочих навантажень у хмару стало революційним кроком для розробників та фахівців з обробки даних. Більше не потрібно витрачати купу грошей на обладнання, яке швидко застаріває; натомість ми можемо орендувати обчислювальні потужності, адаптовані до наших фактичних потреб, масштабуючи ресурси відповідно до проекту та оптимізуючи кожну копійку, вкладену в інфраструктуру.

CPU проти GPU: у чому справжня різниця?
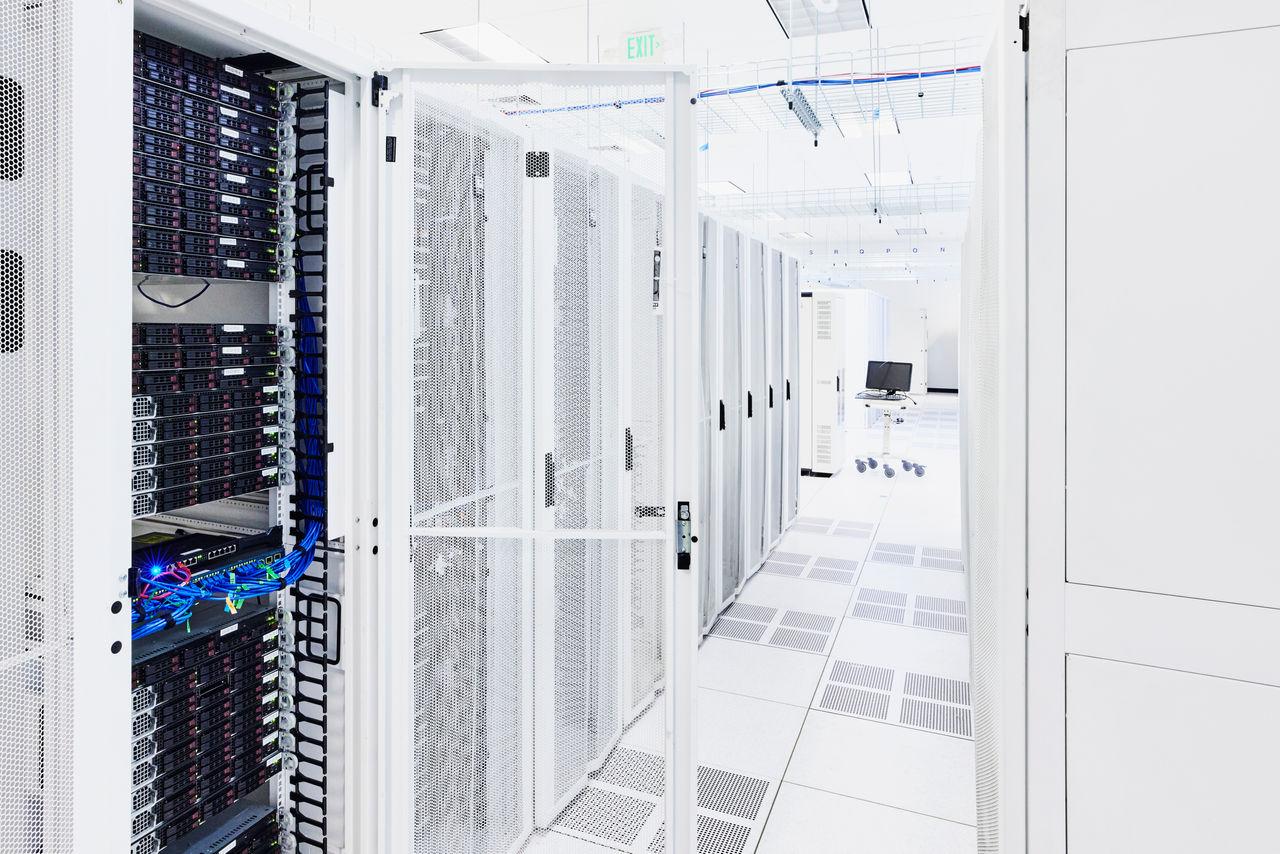
Простіше кажучи, центральний процесор схожий на високоінтелектуальний провідник, який може робити все, але обробляє завдання одну за одною. На противагу цьому, графічний процесор схожий на армію з тисяч працівників, що спеціалізуються на виконанні однієї й тієї ж математичної операції знову і знову, але одночасно. Це основа того, що ми називаємо паралельними обчисленнями.
У той час як центральний процесор обробляє складну логіку та керування системою, графічний процесор чудово справляється з обробкою матриць та рендерингом зображень. Завдяки сотням або тисячам ядер , подібним до архітектури багатоядерного процесора , але у величезних масштабах, він може виконувати кілька підмножин завдання одночасно, що життєво важливо для навчання нейронних мереж або обробки терабайтів даних без збоїв системи.
Пакетне керування завданнями та керування завданнями в режимі реального часу
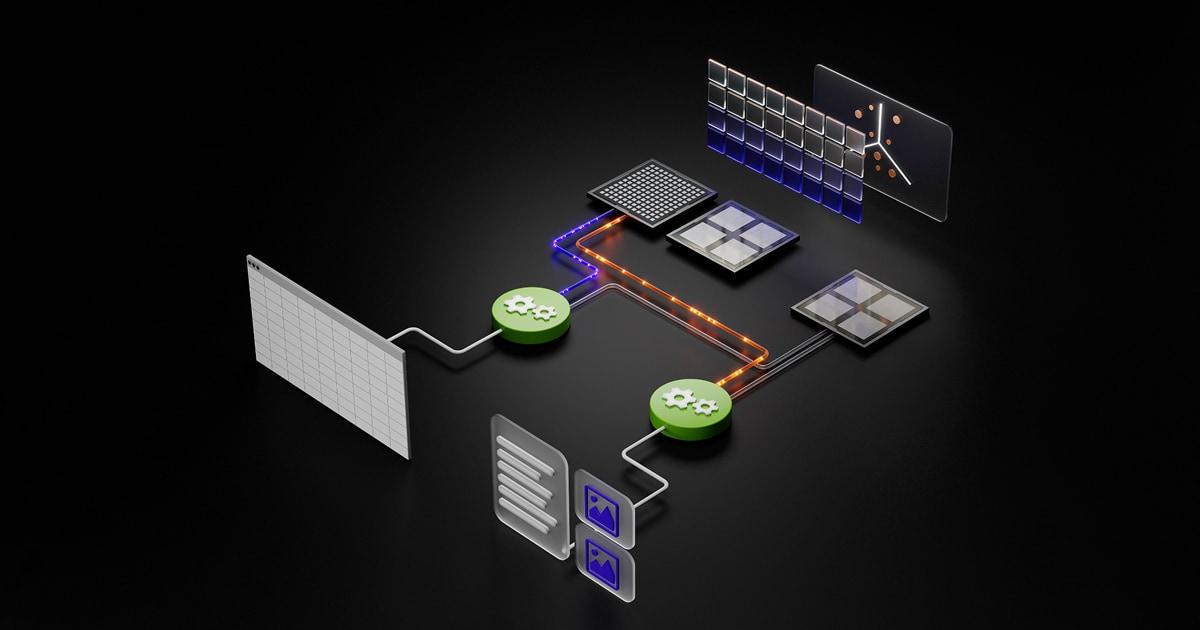
У хмарній екосистемі існує два основних способи виконання цих завдань. Пакетна обробка ідеально підходить для завдань, які не потребують негайної відповіді, таких як попередня обробка даних або масивний висновок. Тут метою є максимізація ефективності та загальної продуктивності системи , дозволяючи завданням накопичуватися та виконуватися, коли доступні ресурси.
З іншого боку, обробка в режимі реального часу є критично важливою для застосунків, які потребують миттєвої реакції, таких як генеративні чат-боти зі штучним інтелектом або розпізнавання облич. У цих випадках абсолютним пріоритетом є низька затримка та висока доступність, що гарантує, що кінцевий користувач не помітить жодних затримок, поки модель обробляє інформацію.
Для налаштування такого проєкту планування вимог є надзвичайно важливим. Від вибору правильної машини до встановлення драйверів (яке може бути автоматичним або ручним за допомогою користувацьких образів) – кожен крок впливає на те, чи буде процес гладким, чи спричинить технічні труднощі.
Моделі споживання та оптимізація витрат
Не всі віртуальні машини однакові, і не всі вони коштують однаково. Для тих, хто хоче заощадити гроші, точкові віртуальні машини є привабливим варіантом, пропонуючи значні знижки, хоча й пов'язані з ризиком того, що хмара поверне їх у будь-який момент. Вони ідеально підходять для відмовостійких завдань, де вартість є пріоритетом.
Якщо вам потрібно щось стабільніше, але зі знижкою, існують гнучкі віртуальні машини для запуску , які дозволяють отримати доступ до ресурсів графічного процесора за зниженими цінами в обмін на кількаденну затримку перед початком роботи. Для критично важливих проектів доступні стандартне виділення ресурсів на вимогу або заплановане резервування , що гарантує наявність обладнання саме тоді, коли воно вам потрібно.

Передовим методом максимізації бюджету є регіональний арбітраж витрат . Використання цінових коливань у різних географічних регіонах або використання планування «слідуй за сонцем» дозволяє командам в Азії, Європі та Америці по черзі використовувати кластери, досягаючи майже 100% використання обладнання.
Як вибрати правильний графічний процесор для вашого випадку використання

Річ не в тому, щоб вибрати найдорожчу карту, а в тій, яка найкраще відповідає завданню. У навчанні моделей великих мов програмування (LLM) відеопам'ять (VRAM) є основним вузьким місцем. Якщо у вас закінчиться VRAM, вам доведеться зменшити розмір пакетів, що значно збільшить час виконання та загальні витрати.
- Навчання ШІ: Він вимагає високої потужності зі змішаною точністю (FP16/BF16) та великої відеопам'яті для обробки градієнтів та станів оптимізатора.
- Висновок у реальному часі: Тут затримка мережі та стабільність програмного стеку є ключовими для запобігання збоям у виробництві.
- Data Science: Шукається баланс між процесором, оперативною пам'яттю та графічним процесором, оскільки значна частина очищення даних все ще є послідовним завданням.
- 3D-рендеринг та візуальні ефекти: Вони критично залежать від пропускної здатності пам'яті для швидкого переміщення складних текстур і геометрій.
- Наукові розрахунки: Вони надають пріоритет точності FP32 або FP64 та точній відтворюваності результатів завдяки фіксованим версіям драйверів.
Життєво важливо контролювати потік даних системи . Наявність надпотужного графічного процесора марна, якщо центральний процесор або сховище повільні; у такому разі графічний процесор буде проводити більшу частину часу в режимі очікування, очікуючи на дані, що називається недовикористанням ресурсів.
Розширена оркестрація та майбутнє обчислювальної техніки
Зі зростанням кластерів просте планування за принципом «перший прийшов — перший пішов» більше не працює. Провідні компанії впроваджують багаторівневі ієрархії планування , які розподіляють завдання на основі розташування даних, пріоритетів бізнесу та вуглецевого сліду регіону.

Такі інновації, як перемикання процесора/графічного процесора в режимі реального часу, дозволяють системі миттєво вирішувати, який процесор є найефективнішим для кожного потоку. Це вирішує проблему глобальної нестачі обладнання, оптимізуючи кожен доступний тактовий цикл, дозволяючи генеративному штучному інтелекту та цифровим двійникам розвиватися, не будучи блокованими нестачею чипів.
Використання Kubernetes з технологією динамічного розподілу ресурсів (DRA) та багатоекземплярного графічного процесора (MIG) дозволяє розділити одну фізичну відеокарту на кілька віртуальних екземплярів. Це демократизує доступ до високопродуктивних обчислень, дозволяючи кільком користувачам спільно використовувати один і той самий графічний процесор, не заважаючи один одному.
Чітка стратегія, яка поєднує правильне обладнання, розумну модель оплати та гнучку оркестрацію, — єдиний спосіб уникнути марнування грошей на хмарні обчислення. Від вибору відеопам'яті до розгортання спотових екземплярів, кожне технічне рішення безпосередньо впливає на швидкість інновацій та прибутковість будь-якого проекту з передових обчислень.
