- XAI перетворює моделі чорних ящиків на прозорі системи, дозволяючи нам зрозуміти логіку кожного алгоритмічного рішення.
- Існує ключова відмінність між інтерпретованістю (внутрішньо зрозумілі моделі) та пояснимістю (методи для уточнення складних моделей).
- Використання таких методів, як значення Шеплі або LIME, допомагає пом'якшити дискримінаційні упередження та забезпечує дотримання правових норм, таких як норми ЄС.
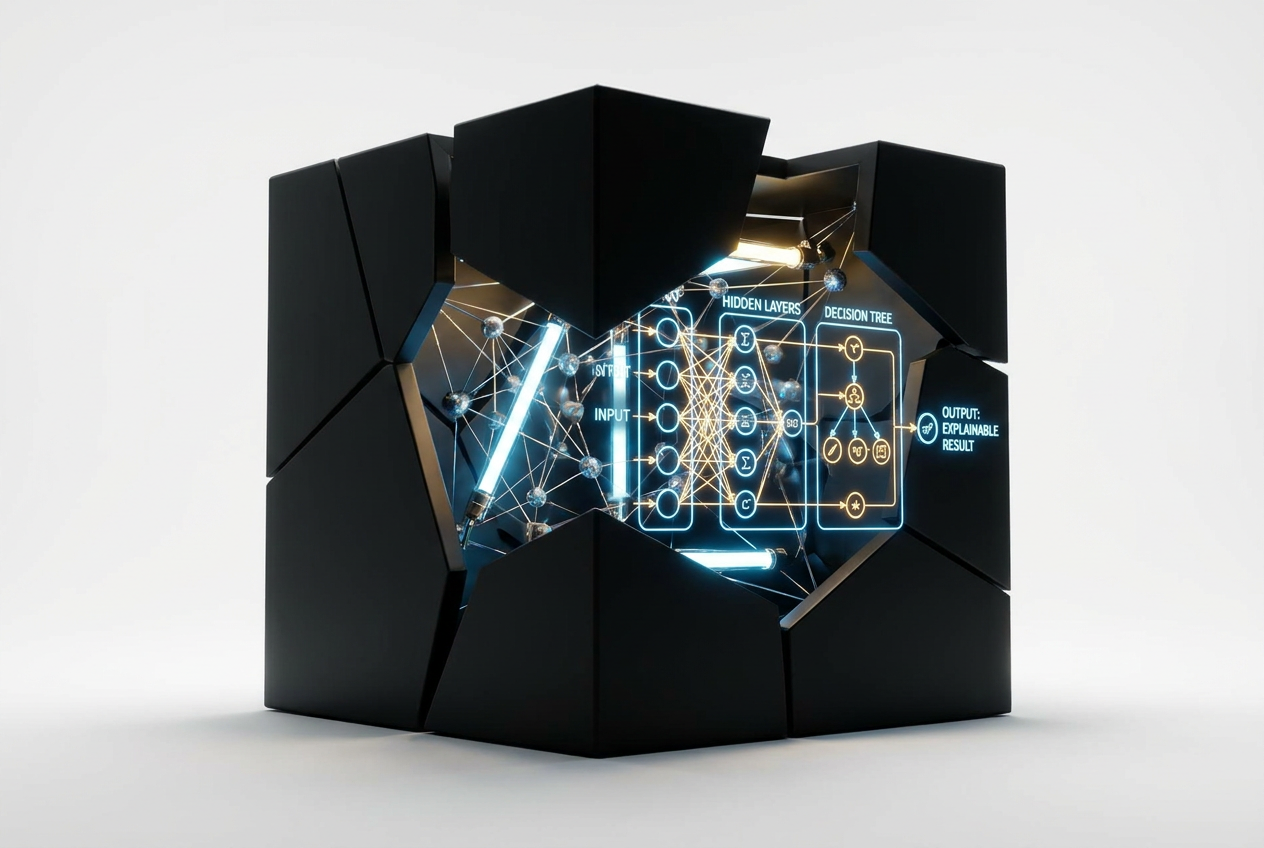
Ви, мабуть, стикалися з взаємодією з інструментом штучного інтелекту та задавалися питанням: «Звідки воно це взяло?» Саме це відчуття перебування перед чорною скринькою , де ви вводите дані та отримуєте результат, і ніхто насправді не знає, що сталося між цим, намагається вирішити XAI. Йдеться не лише про роботу машини, а й про те, щоб ми, люди, могли розуміти причини кожної відповіді, щоб нам не доводилося сліпо довіряти алгоритму.
У світі, де штучний інтелект вже вирішує все: від того, чи отримаєте ви позику, до того, як діагностувати хворобу, здатність відкрити цей капот і побачити, як це працює, є життєво важливою. Пояснення ШІ — це не просто технічна примха для інженерів, а соціальна та правова необхідність, щоб уникнути упередженості, забезпечити справедливість і, перш за все, запобігти відчуттю розгубленості кінцевих користувачів. Давайте заглибимося в цю екосистему, щоб зрозуміти, як перейти від повної непрозорості до справжньої прозорості.

Що ж таке Пояснювальний ШІ (XAI)?
Коли ми говоримо про XAI, або пояснимий штучний інтелект, ми маємо на увазі спеціалізовану галузь, метою якої є зробити внутрішні процеси алгоритмів прозорими та доступними . Ідея проста: система повинна не просто видавати результат, а супроводжувати його обґрунтуванням, яке може зрозуміти будь-хто, експерт чи ні. Це надзвичайно важливо, оскільки сучасні моделі, особливо глибоке навчання та нейронні мережі , настільки складні, що виконують трильйони обчислень для одного слова, що робить людським потенціалом неможливим повторити процес вручну.
Інтерпретованість проти пояснимості: це не одне й те саме
Вони часто використовуються як взаємозамінні, але є важлива відмінність. Інтерпретованість — це пасивна якість; тобто деякі моделі є за своєю суттю прозорими, як-от дерева рішень або лінійні регресії, де можна простежити шлях прийняття рішень майже лише за допомогою олівця та паперу. Вони відомі як білі або скляні коробки.
З іншого боку, пояснювальність – це активний процес. Вона застосовується переважно до непрозорих моделей (чорних скриньок), таких як нейронні мережі, щоб спробувати отримати послідовне пояснення того, що сталося. По суті, тоді як інтерпретаційність зосереджується на внутрішній роботі, пояснювальність зосереджується на обґрунтуванні кінцевого результату за допомогою зовнішніх методів.
Важливість адаптації повідомлення до користувача
Ви не можете пояснити модель машинного навчання спеціалісту з обробки даних так само, як і клієнту банку. Адаптація мови є ключем до успіху XAI. Для технічного спеціаліста пояснення буде зосереджено на метриках вимірювання та вазі змінних; для бізнес-професіонала важливо зрозуміти, які характеристики клієнта спонукали модель запропонувати один продукт, а не інший.
- Експерти зі штучного інтелекту: Вони шукають детальні технічні деталі для оптимізації та вдосконалення моделі.
- Користувачі даних: Фахівці (лікарі, юристи), яким необхідно перевірити надійність для прийняття клінічних або юридичних рішень.
- Новачки або широка публіка: Люди, які просто хочуть знати, що їхні дані використовуються правильно та що існує людський нагляд процес.

Методи відкриття чорної скриньки
Щоб штучний інтелект перестав бути загадкою, використовуються різні методи, які в основному поділяються на два підходи: глобальний та локальний.
Глобальний аналіз: Загальна карта
Ці методи спрямовані на розуміння того, як поводиться модель загалом. Наприклад, метод важливості перестановок вимірює, наскільки збільшується похибка, якщо ми змінюємо значення змінної, показуючи, які фактори мають найбільший вплив на систему. Існують також графіки часткової залежності , які аналізують, як змінюється прогноз, коли змінюється значення певної змінної, хоча обидва зазвичай припускають, що змінні незалежні одна від одної.
Локальний аналіз: конкретний випадок
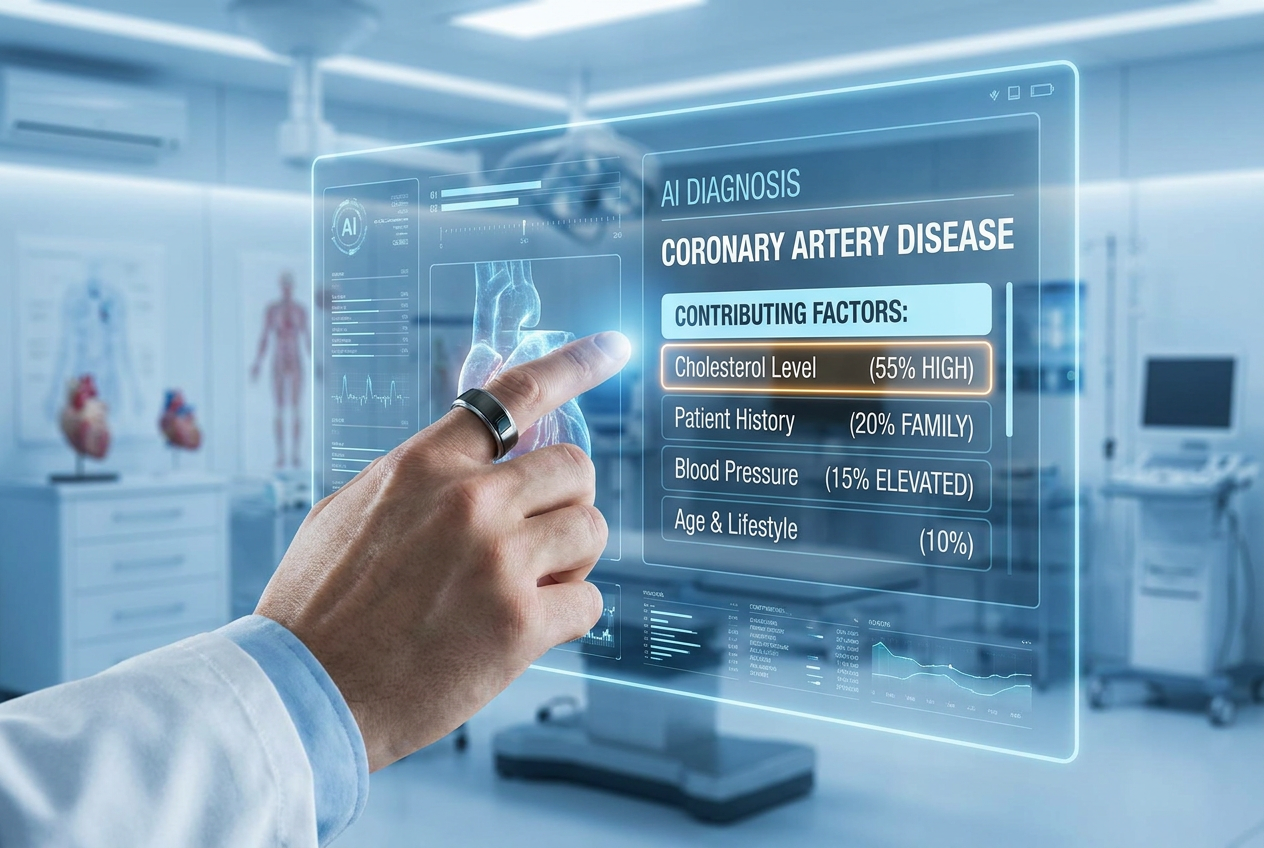
Саме тут ми хочемо зрозуміти, чому саме цей пацієнт отримав медичне сповіщення. Ключовими тут є значення Шеплі (засновані на теорії ігор), оскільки вони призначають певний внесок у кінцевий результат для кожної змінної. Це дозволяє лікарю побачити, що сповіщення було викликане переважно рівнем холестерину , а не віком пацієнта, що дає йому змогу діяти швидко та точно.

Ризики непрозорості та переваги прозорості
Сліпо довіряти чорній скриньці небезпечно. Найсерйозніший ризик — це упередженість та дискримінація ; якщо штучний інтелект навчається на історичних даних, де мали місце випадки сексизму чи расизму, алгоритм вивчить ці закономірності та відтворить їх, караючи резюме або відмовляючи у наданні кредитів без логічної причини. Крім того, відсутність прозорості створює вакуум юридичної відповідальності : якщо безпілотний автомобіль потрапляє в аварію, нам потрібно знати причину, щоб визначити, хто винен.
Впровадження XAI не лише запобігає катастрофам, але й забезпечує конкурентну перевагу . Це дозволяє швидко виявляти помилки, дотримуватися суворих правил, таких як Загальний регламент Європейського Союзу щодо захисту даних (GDPR) , і, перш за все, будує довіру. Коли користувач розуміє причини прийняття рішення, він набагато частіше приймає технологію та інтегрує її у своє повсякденне життя.
Проблеми та дилема точності
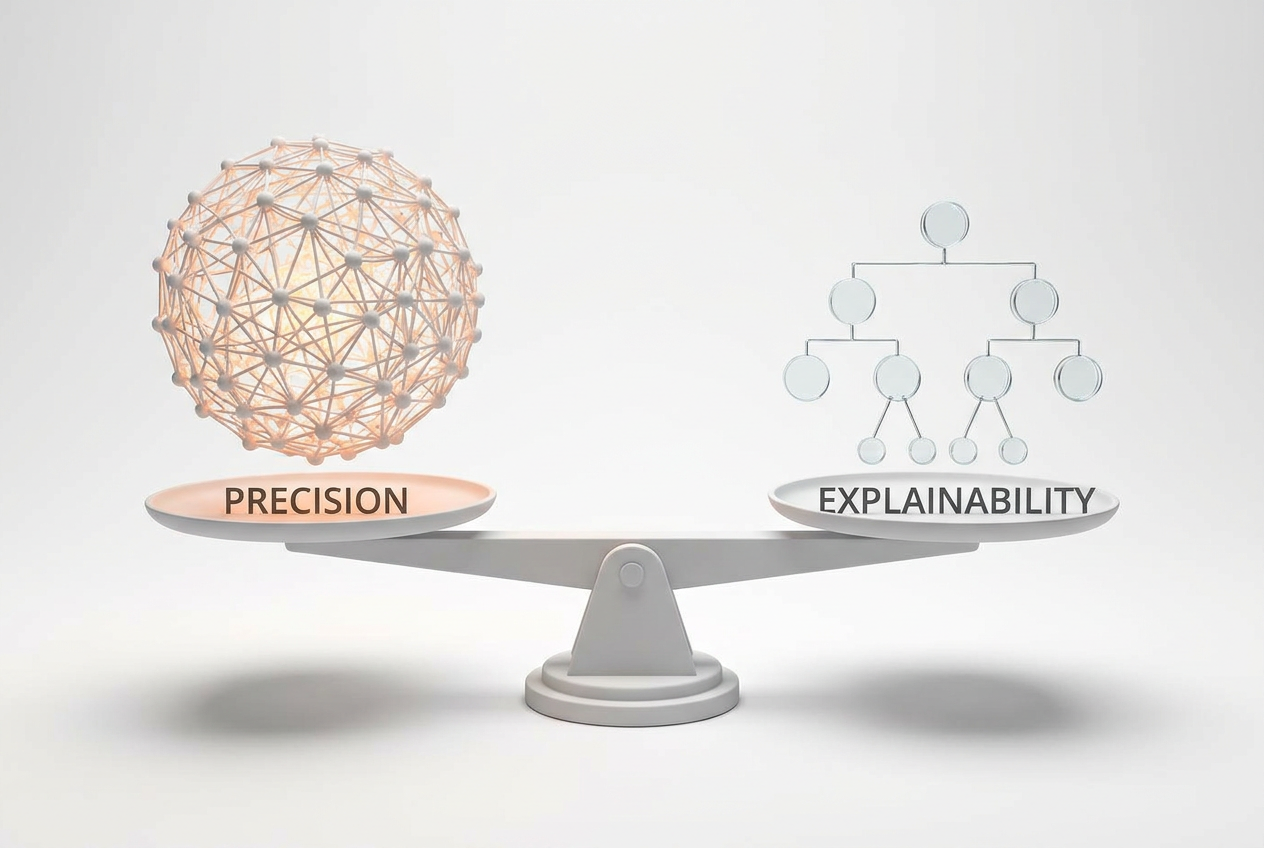
Не все йде гладко. Існує постійна напруга, відома як компроміс між точністю та пояснимістю . Як правило, найточніші моделі (такі як глибоке навчання) є найбільш непрозорими, тоді як найлегші для розуміння, як правило, менш потужні. Поточна проблема полягає в пошуку золотої середини, де система є достатньо ефективною, щоб бути корисною, але водночас достатньо зрозумілою, щоб її можна було перевірити та зрозуміти.

Крім того, існують обчислювальні витрати. Обчислення значень Шеплі для мільйонів прогнозів за секунду є надзвичайно дорогим з точки зору обчислювальної потужності. Тому розробляються механістичні (розуміння внутрішньої роботи) та постфактумні (пояснення після навчання) підходи до інтерпретації, щоб зробити процес ефективнішим.
Зрозумілий ШІ в критичних секторах
В охороні здоров'я XAI може стати вирішальним фактором, дозволяючи лікарям перевіряти пропозиції ШІ перед операцією. В освіті для вчителів вкрай важливо зберігати свою автономію та уникати перетворення на простих виконавців алгоритмічних інструкцій, сприяючи розвитку критичного мислення у студентів. У логістиці він допомагає керувати запасами, пояснюючи, чому найкраще переміщувати піддон на основі частоти комплектування та близькості до вантажних доків.
Повна прозорість, від джерела даних до логіки виведення, перетворює штучний інтелект на інструмент для співпраці людини та машини . Завдяки інтеграції людського контролю та зрозумілості, технологія гарантовано є етичною та безпечною підтримкою, уникаючи ілюзії розуміння та гарантуючи, що кожне рішення є справедливим, перевіреним і, перш за все, корисним для покращення суспільства.
