- Визначення базових моделей як навчених систем у великому масштабі, що слугують основою для виконання кількох конкретних завдань.
- Аналіз архітектури Transformer та процесу самоконтролю попереднього навчання та точного налаштування.
- Оцінка соціального впливу, етичних ризиків та обчислювальних труднощів його масового розгортання.
Якщо ви стежили за останнім ажіотажем навколо штучного інтелекту, ви, мабуть, чули про інструменти, які, здається, роблять усе: від написання віршів до програмування складного коду. За всією цією магією криється ключова концепція: фундаментальні моделі . По суті, вони схожі на шасі автомобіля; міцна, загальна конструкція, яку потім можна налаштувати, щоб вона стала спортивним автомобілем, вантажівкою або позашляховиком, залежно від того, що нам потрібно в будь-який момент часу.
Ці системи настільки революційні тому, що ми більше не розробляємо ШІ для одного завдання, а створюємо цифрового гіганта, навченого величезним обсягам даних, які ми потім можемо «формувати». Цей зсув парадигми дозволив ШІ еволюціонувати від чогось дуже жорсткого до гнучкого інструменту, який вивчає загальні закономірності світу, а потім застосовує їх до конкретних проблем, прискорюючи інновації з такою швидкістю, що, чесно кажучи, ніхто не може дати мовчання.
Що ж саме являє собою фундаментальна модель?
Простіше кажучи, базова модель ШІ – це будь-яка система ШІ, навчена на величезних обсягах даних (зазвичай шляхом самомоніторингу), яка може адаптуватися за допомогою процесу, який називається тонким налаштуванням, до величезної різноманітності застосувань. Вони не є абсолютно новими, оскільки спираються на глибоке навчання та передачу знань, але безпрецедентний масштаб даних та обчислювальної потужності призвів до появи можливостей, яких ніхто не передбачав.
Важливо не плутати їх з великими мовними моделями (LLM) . Хоча вони часто використовуються як взаємозамінні, між ними є зв'язок роду та виду: усі LLM є фундаментальними моделями, але не всі фундаментальні моделі є LLM. Хоча LLM зосереджені на тексті та коді, фундаментальні моделі можуть бути мультимодальними , обробляючи зображення, аудіо, відео або навіть сенсорні сигнали від роботів.

Технічні основи: трансформатор та навчання
Архітектура, яка зробила все це можливим, — це Transformer . Ця система використовує механізм під назвою «самостійна увага», який дозволяє моделі розуміти важливість різних частин послідовності, незалежно від їхньої відстані одна від одної. Зазвичай вона складається з кодера та декодера, які генерують векторні представлення (вбудовування), що фіксують основний зміст мови або зображень.
Процес створення зазвичай поділяється на кілька етапів:
- Перед тренуванням: Це найдорожчий етап. Модель «пожирає» інтернет, книги та бази даних, щоб вивчити загальну структуру інформації. Саме тут кількість параметрів, кількість токенів та контекстне вікно.
- Точне налаштування: Після того, як модель стає універсальною, її навчають на конкретних даних під наглядом людей, щоб вона стала експертом у певній галузі, такій як медицина чи право.
- Адаптація до завдання: Це останній крок, на якому модель оптимізується для дуже специфічної функції, такої як створення пошукова система судової практики або генератор технічних звітів.

Видатні моделі, що сформували історію
З 2018 року ми спостерігаємо низку моделей, які сколихнули світ. BERT був одним із піонерів, відомий своєю двонаправленою здатністю розуміти контекст. Потім з'явилося сімейство GPT від OpenAI , яке еволюціонувало від GPT-1 до GPT-4, демонструючи, що чим більший масштаб, тим більше можливостей з'являється, таких як навчання з нульовим шансом.
Але вони не самотні. У нас є Claude з Anthropic з такими версіями, як Sonnet, Opus та Haiku, які прагнуть балансу між інтелектом та швидкістю. Amazon Nova , з іншого боку, пропонує діапазон, який охоплює все: від мультимодального розуміння до креативної генерації відео. Не можна забувати про Stable Diffusion , який приніс силу фундаментальних моделей у світ зображень, або BLOOM , багатомовний та спільний проєкт, який демонструє, що відкритий код також має своє місце.
Можливості та реальне застосування
Ці моделі не просто пишуть електронні листи. Їхній вплив поширюється на критично важливі сектори:
- здоров'я: Вони допомагають у відкриття ліків та аналіз медичних зображень, хоча вони вимагають повної пояснень, щоб уникнути фатальних помилок.
- Праворуч: Вони сприяють перегляду контрактів та аналізу довгих юридичних документів, зменшуючи витрати на доступ до правосуддя.
- Освіта: Вони дозволяють a персоналізоване навчання та адаптивними, хоча вони створюють проблеми щодо плагіату та технологічного розриву.
- Робототехніка: Мета полягає у створенні роботів-універсалів, яких не потрібно програмувати з нуля для кожного завдання, а натомість використовувати базову модель для... взаємодіяти з навколишнім середовищем фізичні

Темна сторона: ризики, етика та довкілля
Не все так гладко та безхмарно. Гомогенізація створює серйозний ризик: якщо всі використовуватимуть одну й ту саму базову модель, будь-яка властива їй упередженість чи помилка поширюватиметься на всі похідні програми, створюючи «алгоритмічну монокультуру». Крім того, існують галюцинації — ті моменти, коли штучний інтелект створює дані з вражаючою впевненістю, що вимагає постійної перевірки людиною.
З етичної та юридичної точки зору, існує відкрита боротьба за інтелектуальну власність , оскільки багато моделей навчаються на даних без явної згоди їхніх творців. До цього додається екологічна шкода; навчання цих гігантів споживає величезну кількість енергії та води, що змушує шукати ефективніші архітектури та стійкі центри обробки даних.
Майбутнє та управління штучним інтелектом
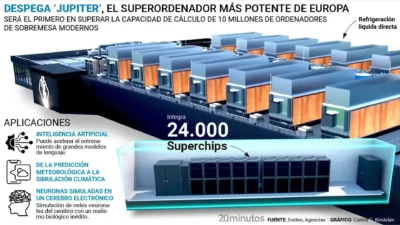
Шлях уперед лежить у демократизації доступу . Наразі навчання найпотужніших моделей централізоване в кількох компаніях через вартість апаратного забезпечення (графічних процесорів). Вкрай важливо, щоб університети та уряди інвестували в державну інфраструктуру, аби запобігти потраплянню можливостей штучного інтелекту до рук технологічної олігополії.
Ключем буде прозорість та незалежні аудити. Недостатньо, щоб компанія просто стверджувала, що її модель безпечна; нам потрібні регуляторні рамки (як-от Закон ЄС про штучний інтелект) та професійні стандарти, які гарантуватимуть використання цих інструментів для покращення суспільства, а не для сприяння масовому спостереженню чи дезінформації.
Екосистема штучного інтелекту змістилася в бік структури, де кілька основних моделей підтримують тисячі спеціалізованих програм, поєднуючи потужність масивної обробки з точністю налаштування на рівні людини. Цей прогрес, хоча й породжує глибокі етичні дилеми та стосується споживання енергії, переосмислює взаємозв'язок між людьми та машинами, перетворюючи ШІ на універсальну інфраструктуру, здатну міркувати, творити та навчатися одночасно в кількох сферах.