- VIF дозволяє виявляти мультиколінеарність у регресійних моделях, будучи критичним, коли значення перевищують поріг 5.
- Реалізація в C# вимагає стандартизації даних для забезпечення числової стабільності та уникнення помилок точності.
- Чистий дизайн коду повинен розділяти зовнішні ресурси, стан даних та поведінкову логіку для оптимізації продуктивності.
Якщо ви хоч раз занурювалися у світ аналізу даних, ви напевно стикалися з головним болем мультиколінеарності. По суті, це виникає, коли ваші незалежні змінні занадто тісно пов'язані, що може призвести до збоїв у роботі вашої регресійної моделі та отримання ненадійних результатів. Щоб упорядкувати цей хаос, в гру вступає коефіцієнт інфляції дисперсії (VIF) — ключовий інструмент для визначення того, які змінні спричиняють проблему.
Хоча потужні бібліотеки існують у таких мовах програмування, як R або Python, реалізація цієї концепції в C# вимагає ґрунтовного розуміння базової математики та структурування коду для зручності підтримки. Йдеться не лише про викидання функцій по одній, а й про організацію логіки програмування таким чином, щоб програмне забезпечення було читабельним та ефективним, запобігаючи тому, щоб код нагадував загадкове нагромадження літер.

Розуміння VIF та мультиколінеарності
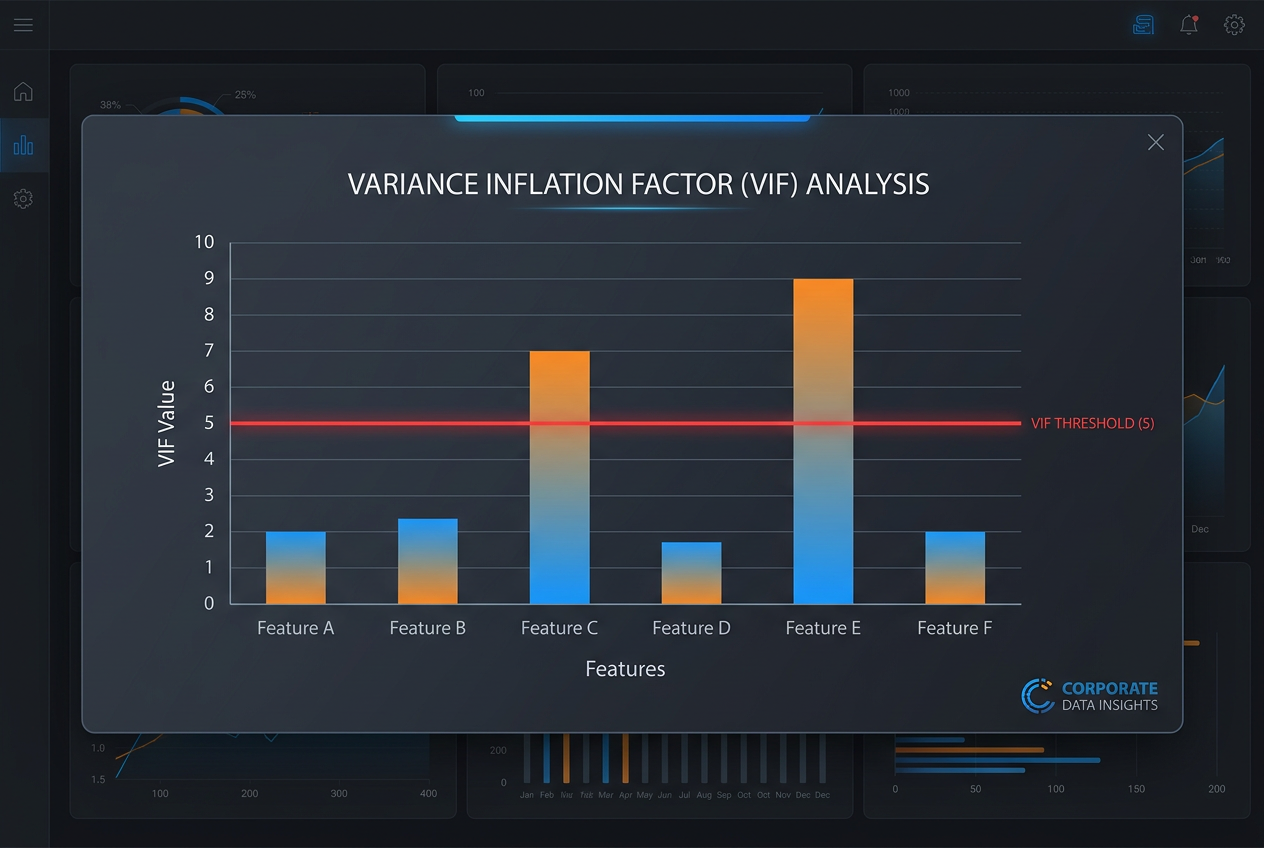
Коефіцієнт інфляції дисперсії (VIF) – це показник, який показує, наскільки збільшується дисперсія оціненого коефіцієнта через його кореляцію з іншими змінними в моделі. Простіше кажучи, якщо змінна має дуже високий VIF , це означає, що значна частина її інформації вже охоплена іншими змінними, що призводить до різкого зростання стандартних помилок і ускладнює визначення того, яка змінна фактично впливає на результат.
Емпіричне правило, якого дотримуються багато аналітиків, полягає в тому, що якщо значення VIF більше 5 , ми маємо справу з випадком мультиколінеарності. У більш екстремальних ситуаціях значення вище 10 є чіткою ознакою того, що змінну слід переглянути або видалити з набору даних, щоб очистити модель та покращити числову стабільність.
Технічна та логічна реалізація в C#
Щоб розрахувати VIF певної змінної в матриці дизайну, процес включає обробку цієї змінної як залежної змінної та виконання лінійної регресії з використанням усіх інших незалежних змінних як предикторів. Результатом є коефіцієнт детермінації R², а VIF розраховується за формулою 1 / (1 – R²).
Під час програмування цього на C# вкрай важливо звернути увагу на числову стабілізацію . Найкращою практикою є стандартизація стовпців матриці проектування, встановивши середнє значення на 0, а стандартне відхилення на 1. Це життєво важливо під час роботи з даними дуже різних масштабів або нелінійних перетворень, оскільки це запобігає збоям програми через помилки десяткової точності.
Принципи чистого дизайну коду
Окрім самої формули, спосіб написання коду на C# має вирішальне значення. Поширеною помилкою є створення об'єктів, які виконують дії, для яких вони не призначені; наприклад, клас "Ball" з методом "Throw()", що не має сенсу, оскільки м'яч сам себе не кидає. Код має читатися як добре написані речення , де суб'єкт виконує зв'язну дію над об'єктом.
- Зовнішні ресурси: Їх слід обробляти на окремому рівні абстракції, в ідеалі через впровадження залежностей.
- Статус та дані: Код, орієнтований на дані, повинен відповідати принципам об'єктно-орієнтованого програмування (ООП).
- Поведінка: Логіка та алгоритми повинні функціонувати як чисті функції, приймаючи дані та ресурси як параметри.
Для організації проєкту пропонується ієрархія, яка починається з простору імен, просувається через статичні класи в міру зростання складності та закінчується звичайними класами. Бажано групувати пов'язані класи в одному файлі, якщо вони мають спільну задачу, що допомагає компілятору оптимізувати бінарний файл та покращує продуктивність виконання завдяки кращому керуванню кешем та регістрами процесора.
Альтернативи та візуалізація даних
Хоча C# є надійною мовою для реалізації, такі інструменти, як R, часто використовуються в середовищах швидкого дослідження. У цій мові такі бібліотеки, як "car", дозволяють майже миттєво обчислювати VIF. Після отримання значень ідеально не покладатися виключно на числа, а використовувати стовпчасті діаграми для візуальної ідентифікації джерел мультиколінеарності.
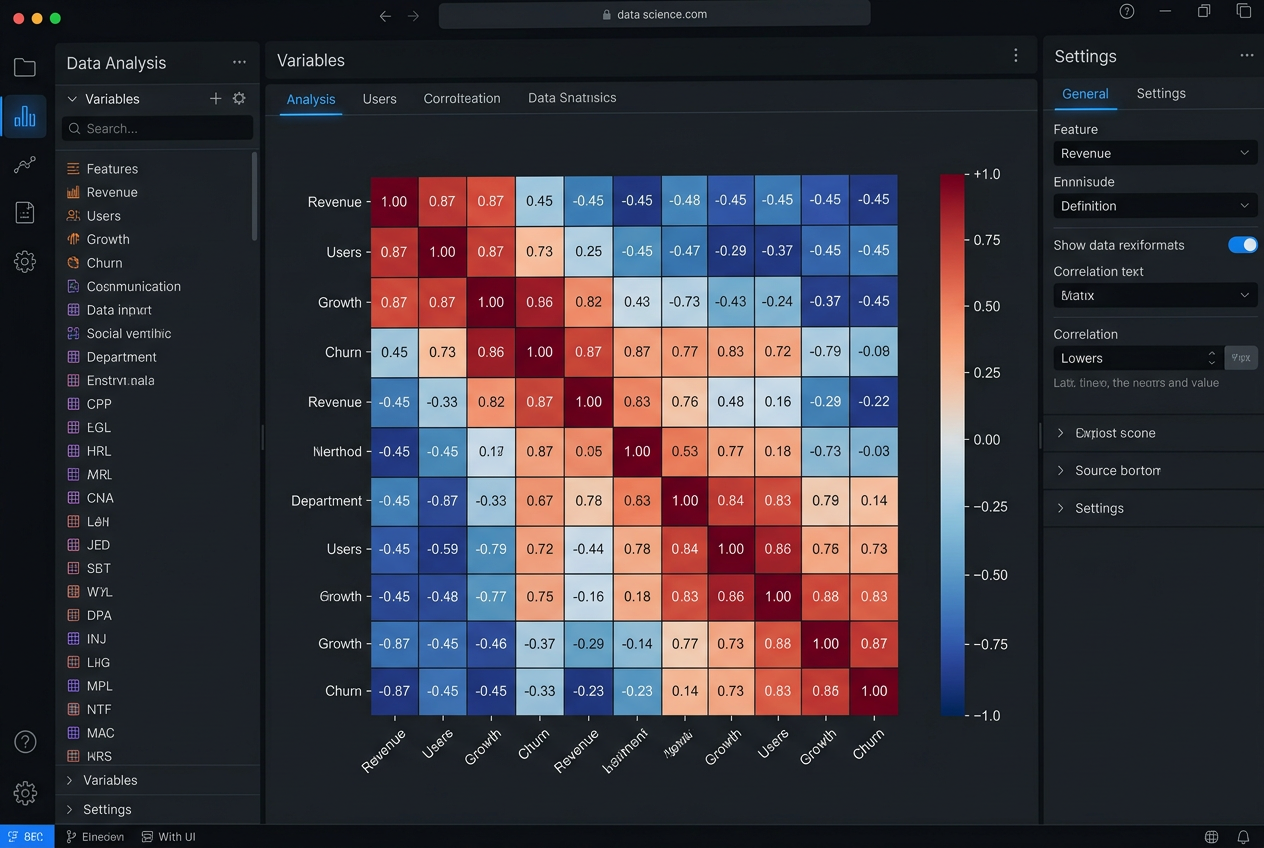
Доповнення аналізу матрицею кореляції є вирішальним кроком. Візуалізація того, як змінні пов'язані одна з одною за допомогою кольорів, дозволяє нам зрозуміти не лише наявність проблеми VIF, але й точно визначити, яка пара змінних викликає конфлікт. Таке поєднання статистичного аналізу та візуалізації гарантує, що кінцева модель буде точною, а не просто картковим будиночком.
Правильне управління VIF у поєднанні з архітектурою програмного забезпечення, що базується на єдиній відповідальності та стандартизованій структурі даних, дозволяє створювати інструменти аналізу C#, які є одночасно потужними та простими в обслуговуванні. Усуваючи надлишковість даних та застосовуючи узгоджені принципи проектування , ми перетворюємо загадковий код на професійне рішення, здатне обробляти складні регресії з повною надійністю.