- VibeVoice — це модель синтезу мовлення від Microsoft, здатна генерувати довгий, виразний звук для кількох динаміків, ідеальний для подкастів та аудіокниг.
- Його архітектура поєднує токенізатори мовлення, велику мовну модель та дифузію для досягнення природних голосів навіть в аудіозаписах тривалістю до 90 хвилин.
- Це дозволяє відповідати майже в режимі реального часу з незначними варіаціями, але вимагає відповідального використання через ризики клонування голосу та діпфейків.
- Він був випущений як дослідницький фреймворк з відкритим кодом, хоча Microsoft тимчасово обмежила репозиторій через побоювання щодо неправильного використання.

Поява VibeVoice від Microsoft революціонізує спосіб створення подкастів та довгоформатного аудіоконтенту за допомогою штучного інтелекту. Ця модель TTS (перетворення тексту на мовлення) з відкритим кодом не лише генерує гіперреалістичні голоси, але й дозволяє створювати розмови з кількома спікерами тривалістю до 90 хвилин без незручних обрізань або падіння якості.
Мета VibeVoice — надати будь-кому віртуальну кабіну для запису, здатну професійно створювати подкасти, аудіокниги або озвучування з комп’ютера. Все, що вам потрібно, це сценарій і деякі базові технічні знання для налаштування моделі, а штучний інтелект подбає про решту: інтонацію, природність, зміни голосу та безперервність протягом усього аудіо.
Що таке VibeVoice і чому він такий важливий для подкастів?
Модель базується на технології TTS (перетворення тексту на мовлення), тобто вона безпосередньо перетворює текст на мовлення , але з рівнем плавності та нюансів, що дуже нагадує людське мовлення. VibeVoice спочатку випускався у версіях з параметрами 1.5B та 7B , розроблених для поєднання якості та можливості генерувати довгі аудіопотоки без надмірного споживання ресурсів.
Однією з його найбільших переваг є здатність безперервно записувати до 90 хвилин аудіо , зберігаючи послідовність голосу та інтонацію протягом усього запису. Це робить його особливо корисним для повних подкастів, розділів аудіокниг або довгих епізодів освітнього контенту, де раніше було потрібно кілька сеансів запису з акторами озвучування.
Крім того, VibeVoice розроблений для обробки до чотирьох різних голосів в одному аудіозаписі , що дозволяє імітувати інтерв'ю, панельні дискусії, діалоги між персонажами або епізоди, озвучені різними акторами. Ця можливість роботи з кількома динаміками є ключовою для того, щоб зробити подкасти на базі штучного інтелекту більш динамічними та захопливими.
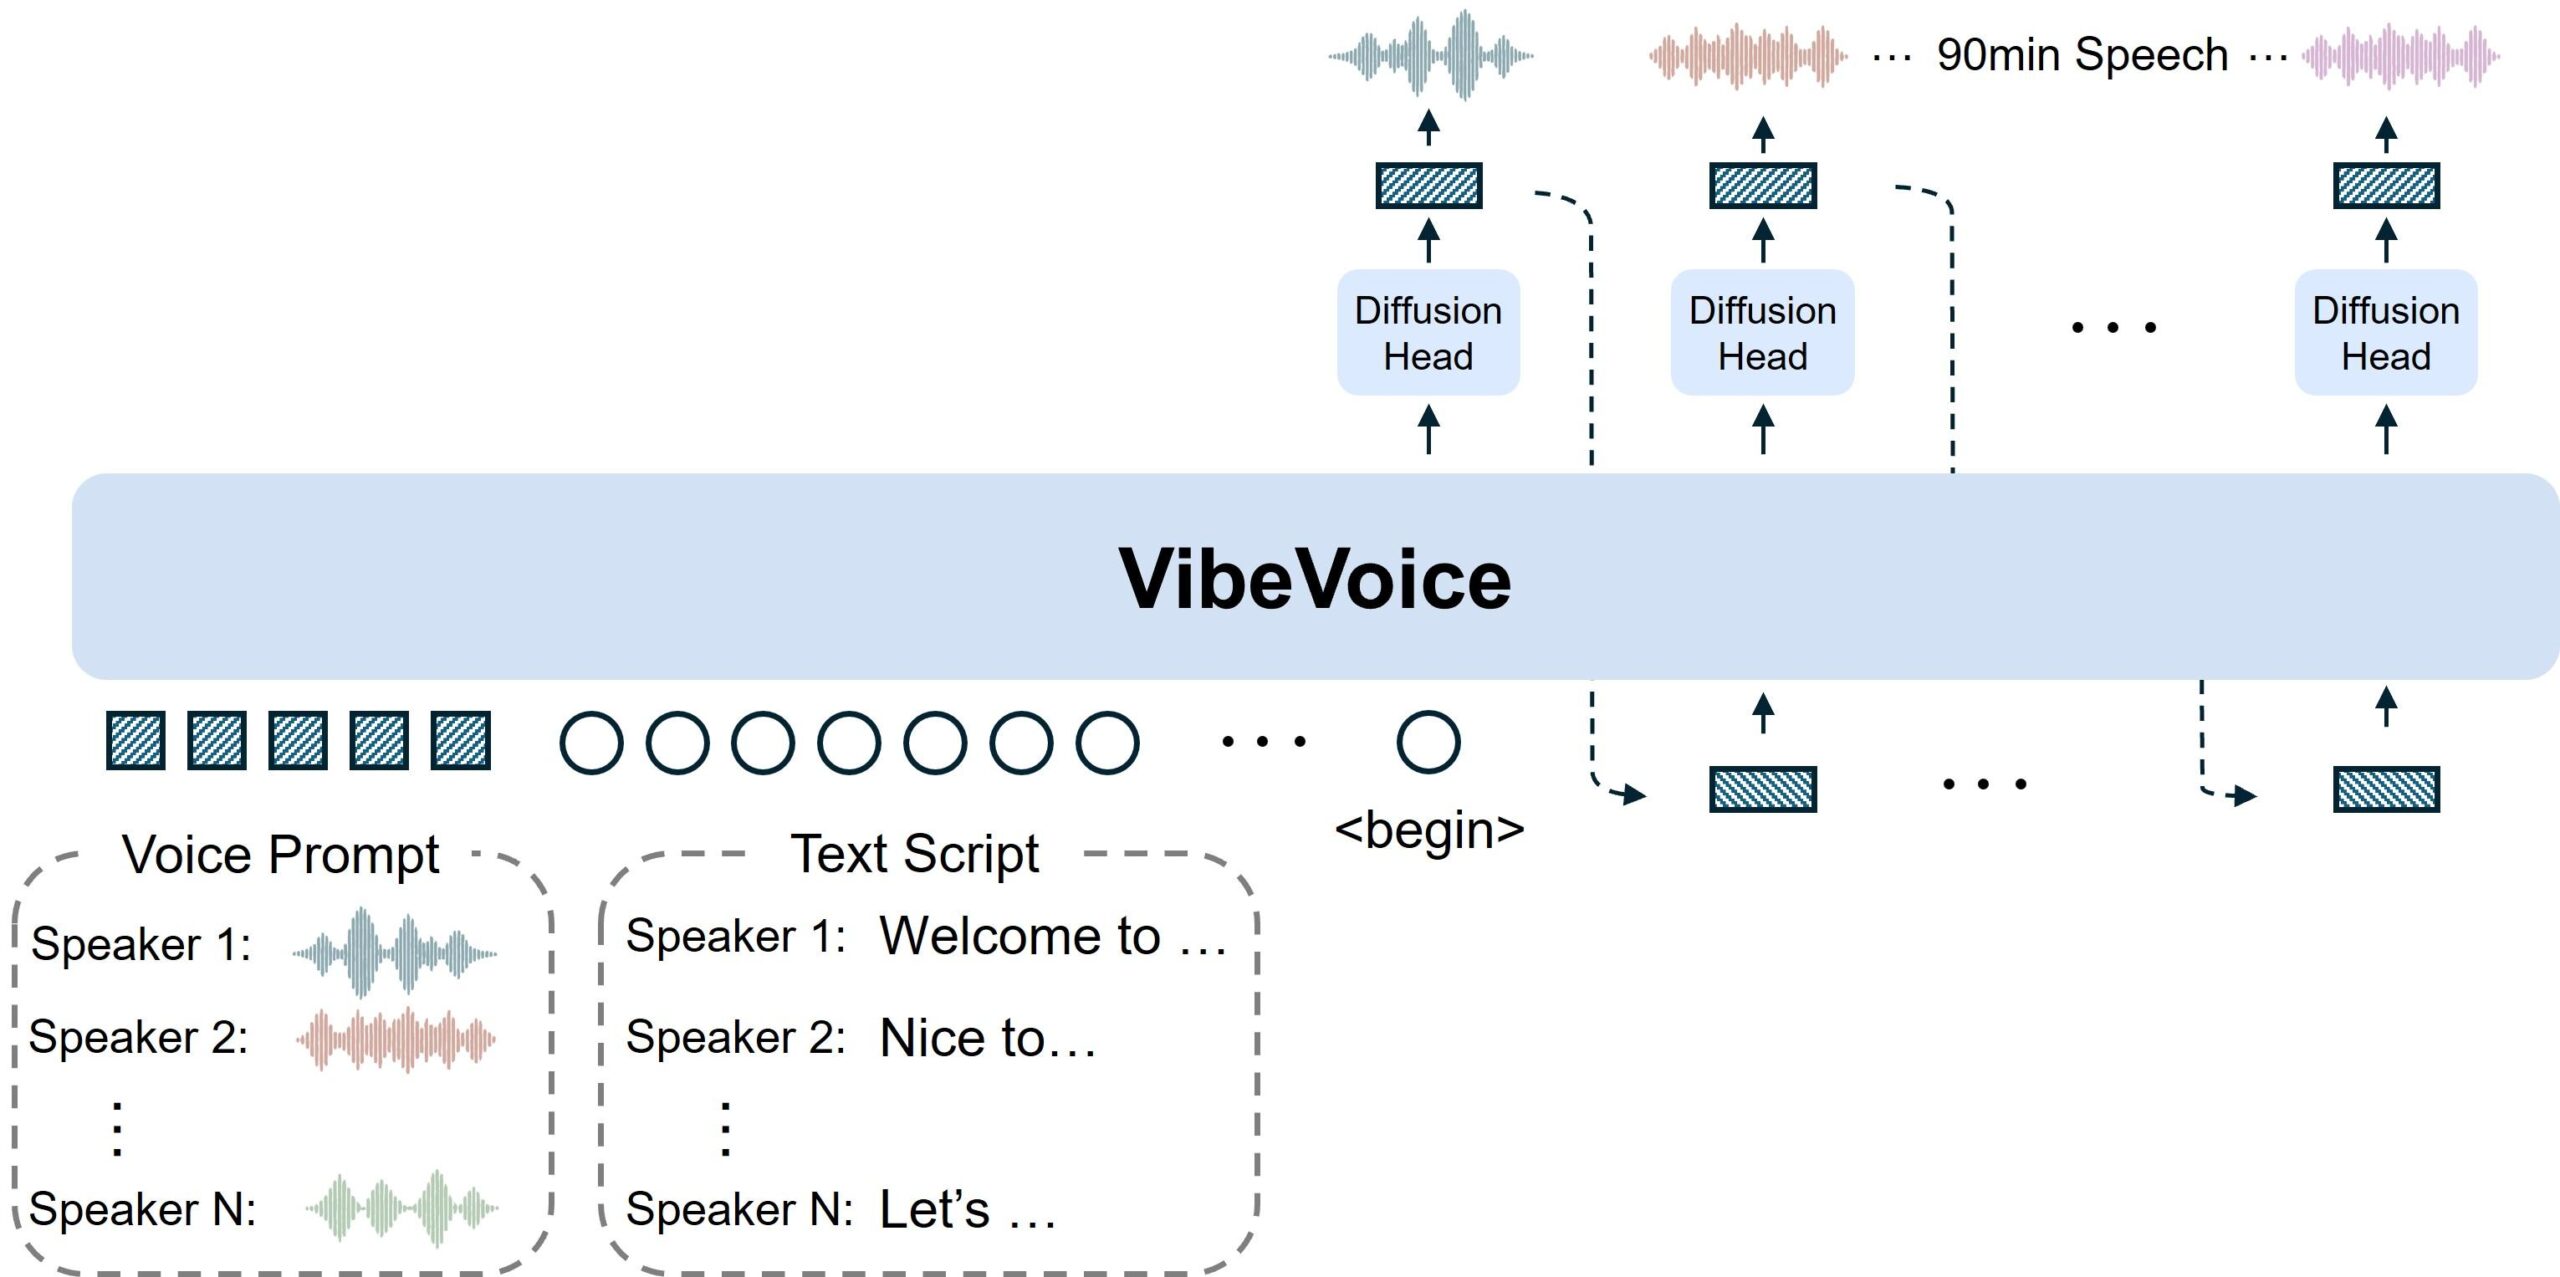
Як працює VibeVoice: розширений синтез мовлення та низька затримка
Окрім привабливого заголовка, особливістю VibeVoice є його технічна архітектура, розроблена для довгих аудіозаписів і розмов . Microsoft поєднує кілька компонентів, щоб голос звучав природно, адаптувався до тексту та генерувався в режимі реального часу або майже в режимі реального часу.
Система використовує безперервні акустичні та семантичні токенізатори мовлення , які працюють на дуже низькій частоті, близько 7,5 Гц. Це означає, що вона стискає аудіоінформацію до меншої кількості «кроків» за секунду, ніж інші моделі, зберігаючи точність звуку та значно зменшуючи обчислювальні витрати під час роботи з довгими послідовностями.
Окрім цього стиснутого представлення, в гру вступає велика мовна модель (LLM) , яка відповідає за інтерпретацію вмісту сценарію, перебігу розмови та того, хто говорить у будь-який момент. Таким чином, вона розуміє, чи це запитання, відповідь, іронічний коментар чи зміна теми, і відповідно адаптує голосовий вивід.
Зрештою, для реконструкції високоякісних акустичних деталей: тембру, вокальної текстури, ледь помітних дихань та інших нюансів використовується дифузійна головка . Ця комбінація LLM + дифузії гарантує, що отриманий звук буде послідовним, виразним та приємним для прослуховування протягом тривалого часу.
Паралельно Microsoft випустила спеціальний варіант під назвою VibeVoice-Realtime-0.5B , розроблений для надзвичайно швидкої реакції: ця модель може почати випромінювати голос приблизно через 300 мілісекунд після отримання тексту. Тобто практично в режимі реального часу, що ідеально підходить для голосових агентів, розмовних асистентів або програм, де затримка має бути мінімальною.
Доступні версії: моделі, параметри та рекомендоване використання
В екосистемі VibeVoice було представлено кілька версій з різними розмірами та орієнтаціями моделей , розроблених як для тривалого аудіо, так і для інтерактивних застосувань.
З одного боку, у нас є основні варіанти з параметрами 1.5 біт/с та 7 біт/с , призначені для обробки великого контенту, такого як повні подкасти, імітовані радіопрограми, розділи аудіокниг або аудіокурси. Більша кількість параметрів дозволяє краще вловлювати нюанси та керувати складними діалогами, хоча це також збільшує вимоги до обладнання.
З іншого боку, версія VibeVoice-Realtime-0.5B надає пріоритет швидкості відгуку над розміром моделі. Хоча вона має «лише» 0,5 млрд параметрів , що є скромною кількістю порівняно з такими гігантами, як ChatGPT або Gemini, саме це дозволяє їй генерувати до 90 хвилин безперервного аудіо, зберігаючи чіткий голос та стабільну інтонацію.
Цей варіант роботи в режимі реального часу особливо привабливий для голосових агентів, чат-ботів, віртуальних помічників та будь-яких програм, де користувач очікує негайної відповіді ШІ голосом, а не лише текстом. Зі затримками, близькими до 300 мс, враження дуже схоже на розмову з кимось на іншому кінці.
У всіх випадках модель призначена для використання в локальних або дослідницьких середовищах , оскільки Microsoft спочатку вирішила випустити її як проект з відкритим кодом, доступний з GitHub та платформ, таких як Hugging Face, що полегшить спільноті її тестування, адаптацію та створення інструментів на її основі.
Практичне застосування: як створити подкаст за допомогою VibeVoice
Одним із флагманських застосувань VibeVoice, безсумнівно, є створення подкастів без необхідності залучення акторів озвучування . Для тих, хто має ідеї, сценарії чи письмовий контент, але не наважується стати перед мікрофоном, ця модель відкриває величезні можливості.
Загальний робочий процес створення подкасту за допомогою VibeVoice зазвичай включає підготовку добре структурованого сценарію : вступ, блоки контенту, потенційні інтерв'ю (реальні чи вигадані), переходи та завершення. Чим чіткіший текст, тим краще модель може вловлювати зміни тону, паузи та ролі кожної «людини» в розмові.
Потім, використовуючи інструменти, побудовані на моделі (скрипти, графічні інтерфейси або інтеграції з іншими додатками), кожна частина тексту призначається одному з доступних спікерів . Ми можемо, наприклад, використовувати один голос для доповідача, інший для постійного гостя, ще один для запитань, що зачитуються з аудиторії, і четвертий для інформаційних нотаток або спонсорованих сегментів.
Модель генерує безперервний звук, дотримуючись порядку сценарію, голосових переходів та ритму розмови. Після цього результат можна вдосконалити в традиційному аудіоредакторі, додавши фонову музику, звукові ефекти, переходи або внісши незначні корективи в гучність та еквалайзер.
Завдяки можливості генерувати до 90 хвилин контенту без втрати зв'язності , ми можемо створити повноцінний епізод за один раз: немає потреби записувати невеликими блоками чи турбуватися про втому голосу, помилки дикції чи фоновий шум, що у фізичній кабіні є постійним головним болем.
Клонування голосу за допомогою штучного інтелекту та персоналізація голосу
Одним із найтонших, але водночас найпотужніших досягнень цієї технології є «клонування голосу» або клонування голосу за допомогою штучного інтелекту . Воно включає методи синтезу, засновані на глибокому навчанні, які дозволяють відтворювати тембр, мовленнєві патерни та нюанси певного голосу.
На практиці ці системи аналізують унікальні характеристики цільового голосу, такі як тембр, форманти, ритм мовлення та просодічні патерни (паузи, акценти, питальна інтонація тощо). Всього за кілька секунд семпла вони здатні генерувати синтетичний голос, який дуже нагадує оригінал.
У випадку з VibeVoice згадується, що можна досягти дуже точних симуляцій лише за 10 секунд оригінального аудіо , досить добре передаючи емоційний вплив і текстуру голосу. Для подкасту це відкриває такі можливості, як збереження «брендового голосу» навіть після того, як реальна людина припинила запис, або створення повторюваних персонажів з послідовною вокальною ідентичністю.
Однак ця можливість пов'язана з дуже серйозними етичними ризиками та необхідністю виявлення синтетичного аудіо :
З цієї причини Microsoft наголошує, що VibeVoice випускається в рамках досліджень та з чіткими застереженнями: його не слід використовувати для крадіжки особистих даних, шахрайства, маніпуляцій чи дезінформаційних кампаній. Відповідальне використання є ключовим компонентом усієї цієї екосистеми.
Переваги для творців контенту та невеликих проектів
Маючи комп’ютер, здатний запускати модель, та певний час для написання сценаріїв, можна конвертувати довгі тексти в професійний аудіозапис за лічені хвилини. Це стосується інформативних подкастів, новинних бюлетенів, художніх оповідань, серіалізованих романів або навіть озвучених технічних посібників.
Це також чудово допомагає у переробці існуючого письмового контенту : статті в блогах, розсилки, обговорення в соціальних мережах або звіти можна перетворити на аудіоепізоди, які розширюють охоплення повідомлення та пропонують зручніший спосіб для тих, хто віддає перевагу слуханню, а не читанню.
Ще однією перевагою є стабільність якості з часом . Хоча актор озвучування може змінювати свою енергію, інтонацію чи чіткість залежно від дня, штучний інтелект підтримує постійний рівень, що сприяє серійному виробництву: кілька епізодів, записаних за один дубль, збережуть однакову присутність та стиль голосу.
В освітній сфері VibeVoice ідеально підходить для аудіокурсів, керованих читань та доступних матеріалів для людей з вадами зору або тих, хто просто віддає перевагу навчанню, слухаючи під час виконання інших завдань. Можливість створювати усні версії уроків або довгих документів пропонує безліч можливостей.
Ризики, обмеження та рішення Microsoft щодо репозиторію
З іншого боку, штучний інтелект, здатний імітувати людські голоси та генерувати реалістичне мовлення, викликає серйозні етичні та безпекові проблеми. Ризик зловмисного використання є реальним, і великі технологічні компанії дедалі більше усвідомлюють його.
У самому тексті запуску Microsoft прямо зазначає, що VibeVoice не слід використовувати для діпфейків, крадіжки особистих даних або незаконної діяльності . Вона також прямо забороняє його використання в контексті дезінформації або шахрайства, саме тому, що його рівень реалізму може легко ввести в оману нічого не підозрюючих слухачів.
Хоча голос, який генерується моделлю, дуже переконливий, творці моделі зазначають, що вона все ще не передає всіх тонкощів справжнього людського голосу : вдихи, емоційні мікроваріації, певні природні паузи та зміни ритму все ще багатші у людини, ніж у штучному інтелекті. Ця «недосконалість» може частково допомогти виявити, що ми маємо справу із синтетичним голосом, але межа стає дедалі розмитішою.
Після випуску проєкту як дослідницької системи з відкритим кодом , Microsoft виявила випадки, коли модель використовувалася способами, що не відповідали її початковому наміру та принципам відповідального використання. У відповідь компанія оголосила, що була змушена тимчасово вимкнути репозиторій, доки не зможе переконатися, що таке використання поза межами сфери застосування більше не може відбуватися.
У заяві наголошується, що відповідальне використання штучного інтелекту є основним принципом для Microsoft , і що вони воліють призупиняти та переглядати інструмент, а не підтримувати його, оскільки він може сприяти серйозним зловживанням. Незважаючи на це, документація, демонстрації та технічні матеріали вже надихнули спільноту та продовжили розвиток галузі синтезу мовлення.
Інші застосування, окрім подкастингу
Хоча увага ЗМІ зосереджена переважно на подкастах, VibeVoice відкриває досить широкий спектр варіантів використання у світі аудіо, згенерованого штучним інтелектом. Багато з них також вписуються в стратегії цифрового контенту та автоматизації.
Одним із найочевидніших прикладів є аудіокниги та розповіді , де виразні голоси, здатні утримувати увагу протягом десятків хвилин, є надзвичайно важливими. Можливість використання кількох динаміків дозволяє кожному персонажу мати власний голос, що значно покращує враження від прослуховування порівняно з одним оповідачем.
У сфері голосових агентів та розмовних асистентів ідеально підходить версія VibeVoice для роботи в режимі реального часу . Бот, який відповідає із затримкою всього 300 мс, відчувається набагато природніше, ніж той, якому потрібно кілька секунд, щоб говорити, що робить взаємодію зі службою підтримки клієнтів, чат-ботами або голосовими інтерфейсами набагато плавнішою.
Ще однією дуже цікавою сферою є автоматизований контент : огляди новин, оновлення ринку, періодичні звіти або навіть читання електронної пошти та сповіщення можуть створюватися без втручання людини, зберігаючи тон, що відповідає іміджу бренду.
Зрештою, є й більш експериментальні застосування, такі як створення вигаданих діалогів, симульованих інтерв'ю або розважальних програм, повністю створених штучним інтелектом . Тут мовні моделі для написання сценаріїв поєднуються з VibeVoice для озвучування, в результаті чого створюються формати, які ще нещодавно здавалися науковою фантастикою.
Дивлячись на картину в цілому, VibeVoice виділяється як ключовий гравець у новій хвилі аудіо, згенерованого штучним інтелектом , здатний поєднувати природні голоси, розмови з кількома учасниками, дуже довгі аудіокліпи та майже миттєві відповіді. Використовуваний відповідально та в рамках встановлених етичних норм, він може стати неймовірно потужним інструментом для тих, хто хоче запустити або масштабувати подкаст, створювати аудіокниги або додавати професійне озвучування до своїх цифрових проектів, не завжди покладаючись на традиційну студію звукозапису.

Індекс
- 1 Що таке VibeVoice і чому він такий важливий для подкастів?
- 2 Як працює VibeVoice: розширений синтез мовлення та низька затримка
- 3 Доступні версії: моделі, параметри та рекомендоване використання
- 4 Практичне застосування: як створити подкаст за допомогою VibeVoice
- 5 Клонування голосу за допомогою штучного інтелекту та персоналізація голосу
- 6 Переваги для творців контенту та невеликих проектів
- 7 Ризики, обмеження та рішення Microsoft щодо репозиторію
- 8 Інші застосування, окрім подкастингу