- LiteRT thay thế TensorFlow Lite trở thành khung phần mềm đa năng của Google để chạy trí tuệ nhân tạo trên thiết bị di động, máy tính để bàn và thiết bị IoT.
- Nó tối ưu hóa quá trình suy luận bằng cách sử dụng NPU, GPU và CPU, đạt được tốc độ cải thiện lên đến 100 lần so với CPU truyền thống.
- LiteRT-LM chuyên về điều phối các mô hình LLM và mô hình tạo sinh như Gemma, cải thiện quản lý bộ nhớ và ngữ cảnh cục bộ.
- Nó cung cấp khả năng tương thích hoàn toàn với PyTorch, JAX và TensorFlow, giúp chuyển đổi mô hình sang định dạng .tflite một cách dễ dàng.

Trí tuệ nhân tạo tạo sinh đang có một bước tiến vượt bậc, và nó không còn chỉ đơn thuần là việc gửi dữ liệu lên đám mây và chờ phản hồi nữa. Giờ đây, bước đột phá là chạy mọi thứ trực tiếp trên thiết bị , cho dù đó là điện thoại di động hay môi trường biên, để trải nghiệm diễn ra tức thì và trên hết, để quyền riêng tư dữ liệu không phụ thuộc vào máy chủ bên ngoài.
Trong bối cảnh này, LiteRT xuất hiện, một tiêu chuẩn mới của Google được thiết kế để thay thế TensorFlow Lite đã có từ lâu. Đây không chỉ là một bản vá đơn giản, mà là một cơ sở hạ tầng phổ quát được thiết kế để cho phép các nhà phát triển triển khai các mô hình AI mạnh mẽ trên bất kỳ nền tảng nào, từ đồng hồ thông minh đến máy tính Windows, tối đa hóa việc sử dụng phần cứng hiện có.

LiteRT là gì và tại sao nó lại là một sản phẩm đột phá?
LiteRT về cơ bản là phiên bản kế nhiệm của TensorFlow Lite và được tạo ra để giải quyết những thách thức của sự phân mảnh phần cứng. Trong khi máy học truyền thống tập trung vào các tác vụ đơn giản như nhận dạng hình ảnh, thì trí tuệ nhân tạo thế hệ mới (GenAI) đòi hỏi quản lý tài nguyên mạnh mẽ hơn nhiều . Khung phần mềm này cho phép suy luận hiệu quả và có thể tái tạo, bất kể thiết bị là Android, iOS, macOS, Linux hay thậm chí là một ứng dụng web.
Đối với những người đang xây dựng công ty khởi nghiệp hoặc phát triển sản phẩm công nghệ, đây là một sự thay đổi hoàn toàn về mô hình. Bằng cách chạy các mô hình cục bộ, độ trễ được giảm đáng kể và chi phí API của bên thứ ba được loại bỏ, cho phép các ứng dụng hoạt động hoàn hảo ngay cả khi không có kết nối internet.
Bộ xử lý tăng tốc: Sức mạnh của CPU, GPU và NPU

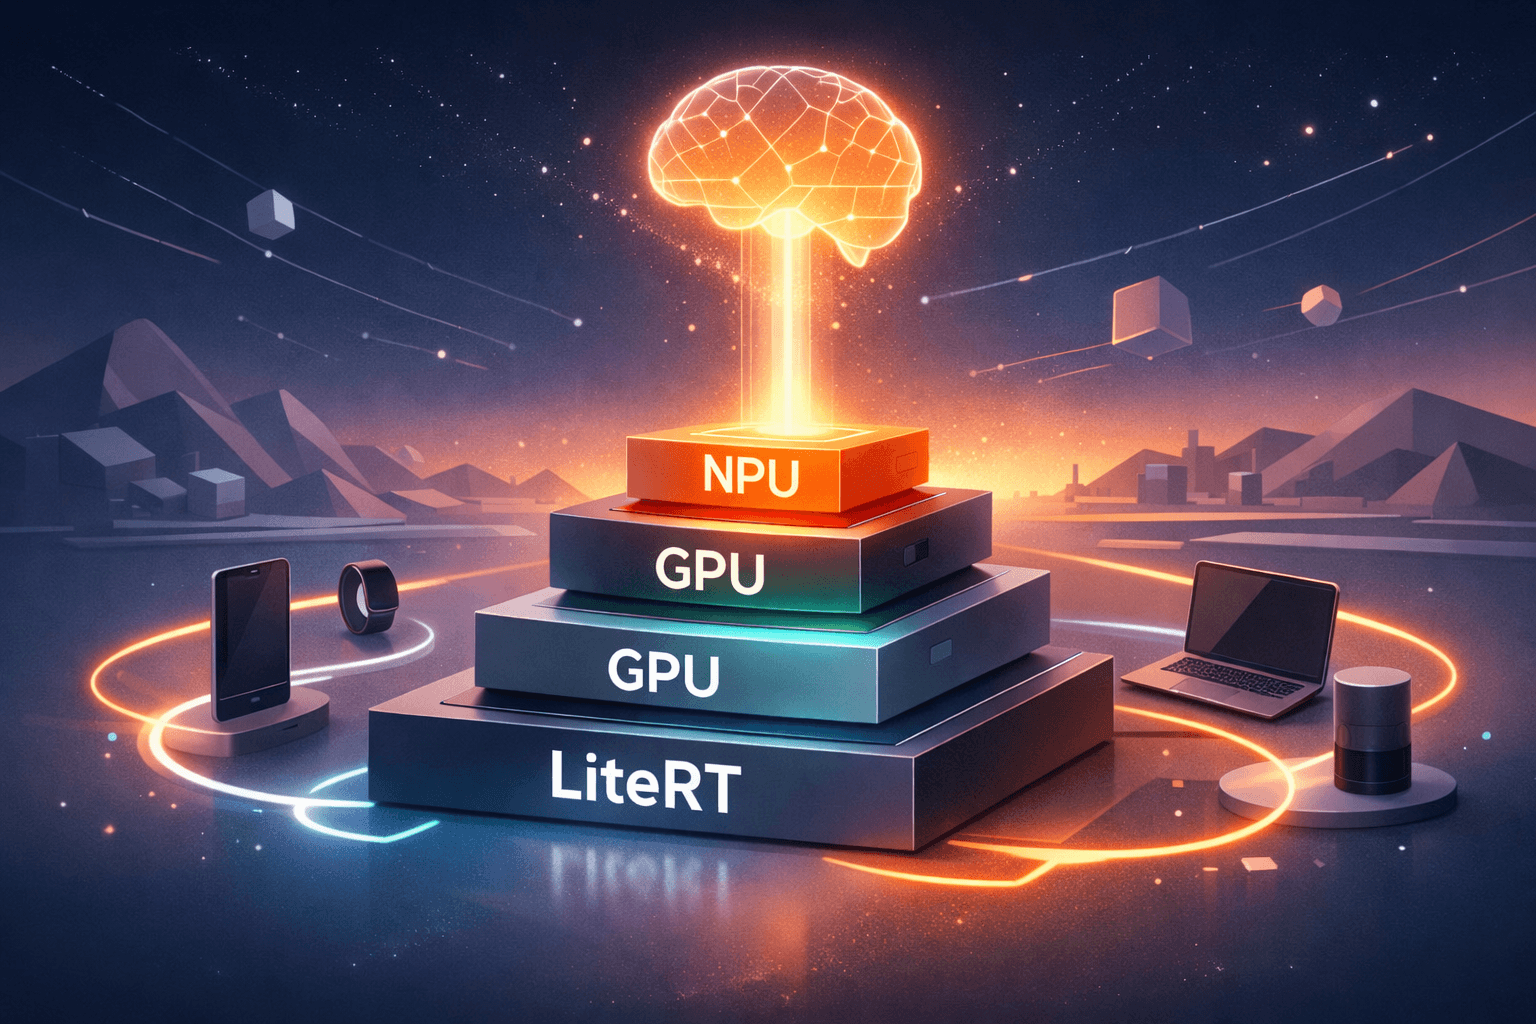
Sức mạnh thực sự của LiteRT nằm ở khả năng tận dụng tối đa hiệu năng của từng chip. Nhờ vào công nghệ ML Drift , hệ thống có thể quản lý khả năng tăng tốc GPU bằng nhiều API khác nhau như Metal, OpenCL, OpenGL và WebGPU. Trên thực tế, trên Android, hệ thống đủ thông minh để tự động ưu tiên OpenCL nếu có sẵn, chỉ sử dụng OpenGL như một phương án dự phòng.
Nhưng điểm mạnh thực sự của LiteRT nằm ở bộ xử lý thần kinh (NPU). Nhờ sự hợp tác với Qualcomm, bộ tăng tốc QNN cho phép cải thiện tốc độ lên đến 100 lần so với CPU và 10 lần so với GPU trong một số trường hợp nhất định. Điều này biến trí tuệ nhân tạo từ một thử nghiệm chậm chạp thành một công cụ sản xuất khả thi.
LiteRT-LM: Điều phối Trí tuệ nhân tạo tạo sinh và LLM
Khi nói về các mô hình ngôn ngữ lớn (LLM), mọi thứ trở nên phức tạp vì chúng không phải là những mô hình đơn giản, mà là những đường dẫn xử lý phức tạp. Đây là lúc LiteRT-LM phát huy tác dụng , một lớp điều phối chuyên dụng giúp quản lý hiệu quả bộ nhớ, bộ đệm và ngữ cảnh. Đây cũng chính là công nghệ được sử dụng trên Gemini Nano trên Pixel Watch và Chrome.

Để đơn giản hóa công việc cho các lập trình viên, Google đã tích hợp API LiteRT Torch Generative. Công cụ này cho phép chuyển đổi dễ dàng các mô hình dựa trên PyTorch, giúp các mô hình mã nguồn mở như Gemma chạy cực nhanh trên thiết bị. Trong các bài kiểm tra thực tế, LiteRT đã chứng minh hiệu năng vượt trội hơn llama.cpp về tốc độ điền trước và giải mã nhờ tận dụng phần cứng tốt hơn.
Những cải tiến kỹ thuật: Không sao chép dữ liệu và thực thi bất đồng bộ
Một trong những điểm nghẽn phổ biến trong AI di động là việc di chuyển dữ liệu giữa CPU và bộ tăng tốc. LiteRT giải quyết vấn đề này bằng cách quản lý bộ đệm không sao chép , ngăn chặn việc sao chép dữ liệu không cần thiết trong bộ nhớ. Điều này giống như thể mô hình đọc thông tin trực tiếp từ nơi nó được lưu trữ, giúp các tác vụ như phân đoạn nền nhanh hơn gấp đôi.
Hơn nữa, API CompiledModel mới cho phép khởi chạy các suy luận bất đồng bộ. Điều này có nghĩa là ứng dụng không bị treo trong khi AI xử lý dữ liệu, cải thiện độ mượt mà của giao diện người dùng. Hệ thống đánh giá phần cứng trong thời gian thực và chọn bộ tăng tốc tốt nhất mà không yêu cầu nhà phát triển phải viết mã cụ thể cho từng chip.
Tính linh hoạt của khung và triển khai chiến lược
Điều tuyệt vời nhất là nó không bắt buộc bạn phải chỉ sử dụng một ngôn ngữ duy nhất. LiteRT tương thích với PyTorch, JAX và TensorFlow . Nếu bạn đã có sẵn quy trình huấn luyện, bạn không cần phải bỏ nó đi; bạn có thể chuyển đổi mô hình của mình sang định dạng .tflite và triển khai chúng trên bất kỳ hệ điều hành nào được hỗ trợ.
Đối với các doanh nghiệp, việc triển khai điều này đòi hỏi một chiến lược rõ ràng. Chỉ riêng mô hình thôi là chưa đủ; nó phải được kết hợp với việc phát triển phần mềm tùy chỉnh và cơ sở hạ tầng điện toán đám mây để AI có thể mở rộng quy mô khi cần thiết. Hơn nữa, khi chuyển AI lên thiết bị, an ninh mạng trở nên cực kỳ quan trọng , vì điều cần thiết là phải đảm bảo rằng thông tin nhạy cảm không bao giờ rời khỏi phần cứng của người dùng.
Việc áp dụng tiêu chuẩn này cho phép tạo ra các tác nhân tự động phản hồi theo thời gian thực , giảm sự phụ thuộc vào các máy chủ đắt tiền. Các tổ chức tích hợp suy luận cục bộ ngày nay sẽ đạt được lợi thế cạnh tranh đáng kể về chi phí, quyền riêng tư và tốc độ phản hồi so với những tổ chức vẫn tiếp tục phụ thuộc hoàn toàn vào điện toán đám mây.

Index