- VibeVoice là một mô hình TTS của Microsoft có khả năng tạo ra âm thanh dài, biểu cảm, nhiều người nói, lý tưởng cho podcast và sách nói.
- Kiến trúc của nó kết hợp các bộ phân tách từ vựng giọng nói, một mô hình ngôn ngữ lớn và sự khuếch tán để đạt được giọng nói tự nhiên ngay cả trong các bản ghi âm dài đến 90 phút.
- Nó cho phép phản hồi gần như tức thời với một vài sai lệch nhỏ, nhưng cần được sử dụng một cách có trách nhiệm do nguy cơ sao chép giọng nói và deepfake.
- Nó đã được phát hành như một khung nghiên cứu mã nguồn mở, mặc dù Microsoft đã tạm thời hạn chế quyền truy cập vào kho lưu trữ do lo ngại về việc lạm dụng.

Sự xuất hiện của VibeVoice của Microsoft đang cách mạng hóa cách tạo ra podcast và nội dung âm thanh dài bằng trí tuệ nhân tạo. Mô hình chuyển văn bản thành giọng nói (TTS) mã nguồn mở này không chỉ tạo ra giọng nói siêu thực mà còn cho phép sản xuất các cuộc hội thoại với nhiều người nói và thời lượng lên đến 90 phút mà không bị cắt ghép khó chịu hoặc giảm chất lượng.
Mục tiêu của VibeVoice là cung cấp cho bất kỳ ai một phòng thu âm ảo có khả năng sản xuất podcast, sách nói hoặc thuyết minh chuyên nghiệp từ máy tính. Tất cả những gì bạn cần là một kịch bản và một số kiến thức kỹ thuật cơ bản để thiết lập mô hình, và trí tuệ nhân tạo (AI) sẽ lo phần còn lại: ngữ điệu, độ tự nhiên, thay đổi giọng nói và tính liền mạch xuyên suốt bản ghi âm.
VibeVoice là gì và tại sao nó lại quan trọng đối với podcast?
Mô hình này dựa trên công nghệ TTS (Text-to-Speech), nghĩa là nó trực tiếp chuyển đổi văn bản thành giọng nói , nhưng với độ trôi chảy và sắc thái gần giống với giọng nói của con người. VibeVoice ban đầu được phát hành với các phiên bản có 1.5 tỷ và 7 tỷ tham số , được thiết kế để cân bằng giữa chất lượng và khả năng tạo ra các luồng âm thanh dài mà không tiêu tốn quá nhiều tài nguyên.
Một trong những điểm mạnh lớn nhất của nó là khả năng ghi âm liên tục lên đến 90 phút , duy trì sự nhất quán về giọng nói và ngữ điệu xuyên suốt. Điều này làm cho nó đặc biệt hữu ích cho các podcast đầy đủ, các chương sách nói hoặc các tập nội dung giáo dục dài mà trước đây cần nhiều buổi ghi âm với người lồng tiếng.
Hơn nữa, VibeVoice được thiết kế để xử lý tối đa bốn giọng nói khác nhau trong một bản ghi âm duy nhất , cho phép mô phỏng các cuộc phỏng vấn, thảo luận nhóm, đối thoại giữa các nhân vật hoặc các tập được kể lại bởi các diễn viên lồng tiếng khác nhau. Khả năng đa người nói này là chìa khóa để làm cho podcast được hỗ trợ bởi AI trở nên năng động và hấp dẫn hơn.
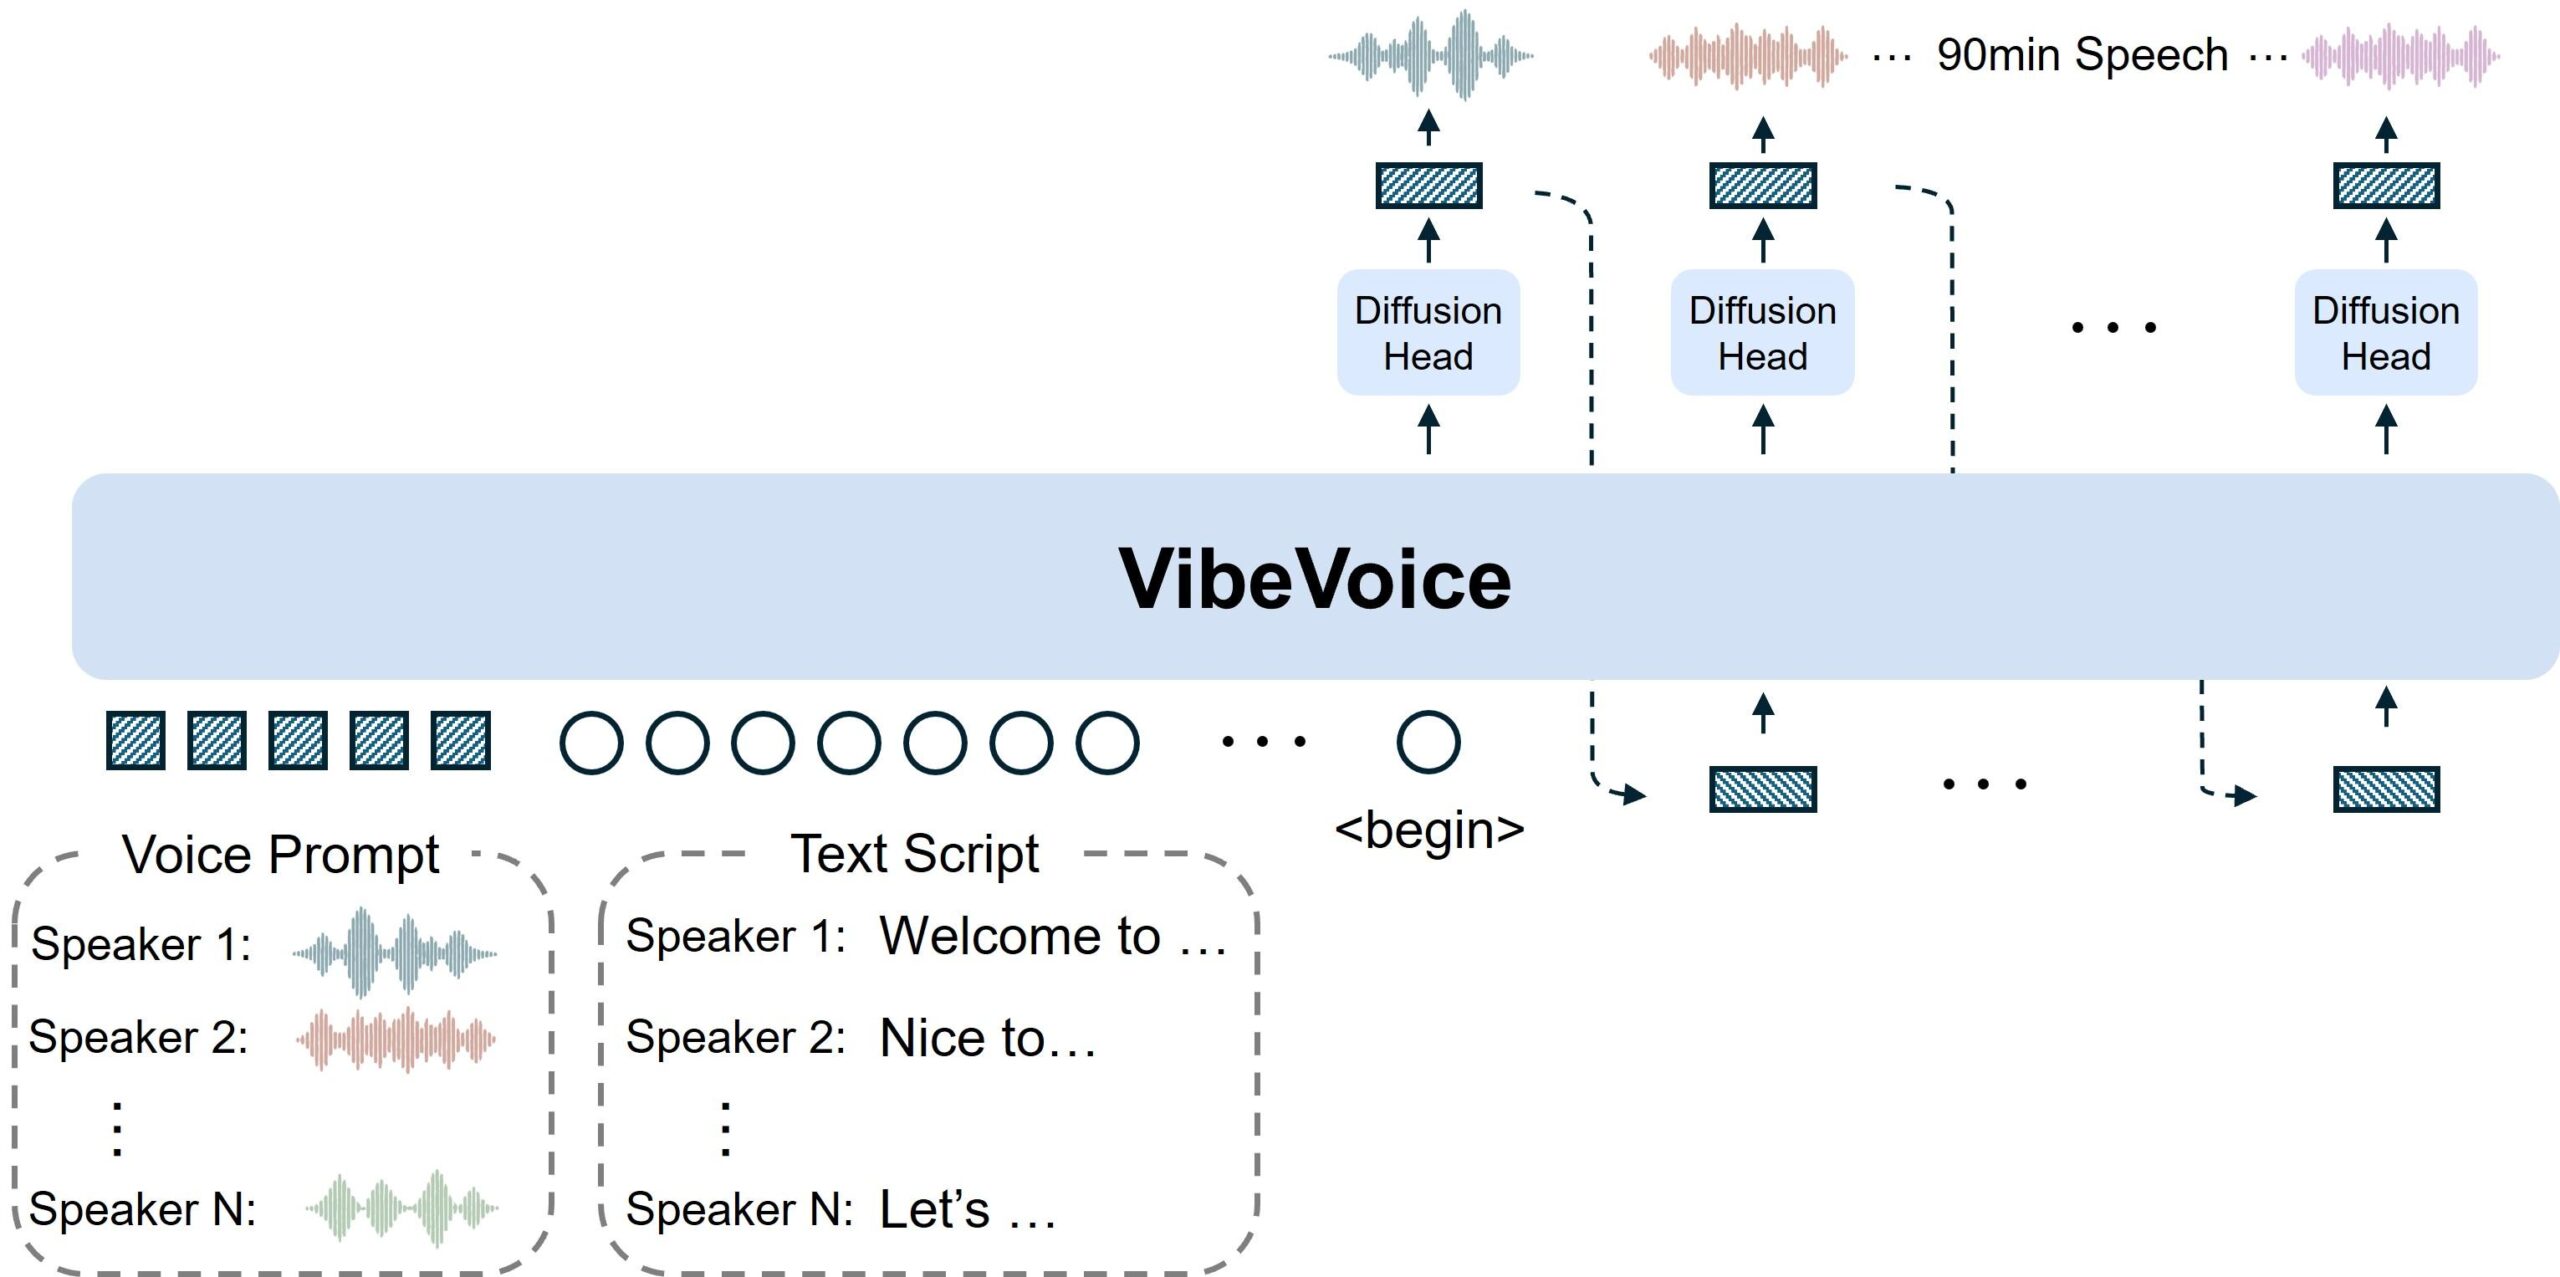
Cách thức hoạt động của VibeVoice: tổng hợp giọng nói tiên tiến và độ trễ thấp
Ngoài tiêu đề bắt mắt, điều làm nên sự đặc biệt của VibeVoice chính là kiến trúc kỹ thuật được thiết kế dành cho các bản ghi âm và hội thoại dài . Microsoft kết hợp nhiều thành phần để tạo ra giọng nói tự nhiên, thích ứng với văn bản và được tạo ra trong hoặc gần thời gian thực.
Hệ thống này sử dụng các bộ phân tách âm thanh và ngữ nghĩa liên tục hoạt động ở tần số rất thấp, khoảng 7,5 Hz. Điều này có nghĩa là nó nén thông tin âm thanh thành ít "bước" hơn mỗi giây so với các mô hình khác, bảo toàn độ trung thực của âm thanh đồng thời giảm đáng kể chi phí tính toán khi xử lý các chuỗi dài.
Trên nền tảng của dạng biểu diễn được nén này, một mô hình ngôn ngữ lớn (LLM) được sử dụng, chịu trách nhiệm diễn giải nội dung kịch bản, luồng hội thoại và người đang nói tại bất kỳ thời điểm nào. Bằng cách này, nó hiểu được đó là câu hỏi, câu trả lời, lời bình luận mỉa mai hay sự thay đổi chủ đề, và điều chỉnh đầu ra giọng nói cho phù hợp.
Cuối cùng, một đầu khuếch tán được sử dụng để tái tạo các chi tiết âm thanh chất lượng cao: âm sắc, kết cấu giọng nói, hơi thở tinh tế và các sắc thái khác. Sự kết hợp giữa LLM và khuếch tán này đảm bảo âm thanh thu được nhất quán, biểu cảm và dễ chịu khi nghe trong thời gian dài.
Song song đó, Microsoft đã ra mắt một biến thể đặc biệt có tên VibeVoice-Realtime-0.5B , được thiết kế để phản hồi cực nhanh: mô hình này có thể bắt đầu phát ra giọng nói khoảng 300 mili giây sau khi nhận được văn bản. Tức là, thực tế là trong thời gian thực, lý tưởng cho các trợ lý giọng nói, trợ lý đàm thoại hoặc các ứng dụng mà độ trễ phải ở mức tối thiểu.
Các phiên bản hiện có: kiểu máy, thông số và cách sử dụng được khuyến nghị.
Trong hệ sinh thái VibeVoice, nhiều phiên bản với kích thước và hướng đặt khác nhau đã được giới thiệu , được thiết kế cho cả các ứng dụng âm thanh dài và tương tác.
Một mặt, chúng ta có các biến thể chính với 1.5 tỷ và 7 tỷ tham số , được thiết kế để xử lý nội dung mở rộng như podcast đầy đủ, chương trình phát thanh mô phỏng, chương sách nói hoặc khóa học âm thanh. Số lượng tham số cao hơn cho phép khả năng nắm bắt các sắc thái và quản lý các đoạn hội thoại phức tạp tốt hơn, mặc dù điều này cũng làm tăng yêu cầu về phần cứng.
Mặt khác, phiên bản VibeVoice-Realtime-0.5B ưu tiên tốc độ phản hồi hơn kích thước mô hình. Mặc dù nó "chỉ" có 0,5 tỷ tham số , một con số khiêm tốn so với những "gã khổng lồ" như ChatGPT hay Gemini, nhưng chính điều này cho phép nó tạo ra tới 90 phút âm thanh liên tục trong khi vẫn duy trì giọng nói rõ ràng và ngữ điệu ổn định.
Biến thể thời gian thực này đặc biệt hấp dẫn đối với các tác nhân giọng nói, chatbot, trợ lý ảo và bất kỳ ứng dụng nào mà người dùng mong muốn AI phản hồi ngay lập tức bằng giọng nói thay vì chỉ bằng văn bản. Với độ trễ gần 300 ms, trải nghiệm rất giống với việc nói chuyện trực tiếp với người ở đầu dây bên kia.
Trong mọi trường hợp, mô hình này được thiết kế để sử dụng trong môi trường cục bộ hoặc nghiên cứu , vì ban đầu Microsoft quyết định phát hành nó như một dự án mã nguồn mở, có thể truy cập từ GitHub và các nền tảng như Hugging Face, giúp cộng đồng dễ dàng thử nghiệm, điều chỉnh và xây dựng các công cụ dựa trên nó.
Ứng dụng thực tiễn: cách tạo podcast bằng VibeVoice
Một trong những ứng dụng nổi bật nhất của VibeVoice chắc chắn là việc tạo podcast mà không cần đến người lồng tiếng . Đối với bất kỳ ai có ý tưởng, kịch bản hoặc nội dung viết sẵn, nhưng không dám đứng trước micro, mô hình này mở ra một cơ hội rất lớn.
Quy trình làm việc chung để sản xuất podcast với VibeVoice thường bao gồm việc chuẩn bị một kịch bản được cấu trúc tốt : phần giới thiệu, các khối nội dung, các cuộc phỏng vấn tiềm năng (thực tế hoặc hư cấu), các đoạn chuyển tiếp và phần kết thúc. Văn bản càng rõ ràng, mô hình càng có thể nắm bắt tốt hơn sự thay đổi về giọng điệu, các khoảng dừng và vai trò của mỗi "người" trong cuộc trò chuyện.
Sau đó, sử dụng các công cụ được xây dựng trên mô hình (kịch bản, giao diện đồ họa hoặc tích hợp với các ứng dụng khác), mỗi phần của văn bản được gán cho một trong những người nói có sẵn . Ví dụ, chúng ta có thể sử dụng một giọng nói cho người thuyết trình, một giọng khác cho khách mời thường xuyên, một giọng khác cho các câu hỏi được đọc từ khán giả và một giọng thứ tư cho các ghi chú thông tin hoặc các phần được tài trợ.
Mô hình này tạo ra âm thanh liên tục trong khi vẫn giữ nguyên thứ tự kịch bản, sự chuyển đổi giọng nói và nhịp điệu của cuộc hội thoại. Từ đó, kết quả có thể được tinh chỉnh trong trình chỉnh sửa âm thanh truyền thống, thêm nhạc nền, hiệu ứng âm thanh, chuyển tiếp hoặc thực hiện các điều chỉnh nhỏ về âm lượng và cân bằng âm thanh.
Nhờ khả năng tạo ra tới 90 phút nội dung mà không làm mất đi tính mạch lạc , chúng tôi có thể tạo ra một tập hoàn chỉnh chỉ trong một lần: không cần phải thu âm thành từng đoạn nhỏ hoặc lo lắng về tình trạng mệt mỏi giọng nói, lỗi phát âm hoặc tiếng ồn xung quanh, những vấn đề thường xuyên gây khó chịu khi thu âm trong phòng thu truyền thống.
Nhân bản giọng nói và cá nhân hóa giọng nói bằng AI
Một trong những tiến bộ tinh tế nhưng mạnh mẽ nhất trong công nghệ này là "nhân bản giọng nói" hay nhân bản giọng nói bằng trí tuệ nhân tạo . Nó liên quan đến các kỹ thuật tổng hợp dựa trên học sâu cho phép sao chép âm sắc, kiểu nói và sắc thái của một giọng nói cụ thể.
Trên thực tế, các hệ thống này phân tích các đặc điểm độc đáo của giọng nói mục tiêu, chẳng hạn như âm sắc, formant, nhịp điệu lời nói và các mẫu ngữ điệu (ngừng nghỉ, trọng âm, ngữ điệu câu hỏi, v.v.). Chỉ với vài giây mẫu, chúng có thể tạo ra một giọng nói tổng hợp gần giống với giọng nói gốc.
Trong trường hợp của VibeVoice, người ta đề cập rằng chỉ với 10 giây âm thanh gốc, họ có thể tạo ra những mô phỏng rất chính xác , nắm bắt được tác động cảm xúc và chất giọng khá tốt. Đối với podcast, điều này mở ra nhiều khả năng như duy trì "giọng nói thương hiệu" ngay cả sau khi người thật ngừng ghi âm, hoặc tạo ra các nhân vật định kỳ với giọng nói nhất quán.
Tuy nhiên, khả năng này đi kèm với những rủi ro đạo đức rất nghiêm trọng và cần phải phát hiện âm thanh tổng hợp :
Vì lý do này, Microsoft nhấn mạnh rằng VibeVoice được phát hành trong khuôn khổ nghiên cứu và kèm theo những cảnh báo rõ ràng: không được sử dụng cho mục đích đánh cắp danh tính, gian lận, thao túng hoặc các chiến dịch tung tin giả. Sử dụng có trách nhiệm là yếu tố then chốt của toàn bộ hệ sinh thái này.
Ưu điểm dành cho người sáng tạo nội dung và các dự án nhỏ
Với một máy tính đủ mạnh để chạy phần mềm và một chút thời gian để viết kịch bản, bạn có thể chuyển đổi các văn bản dài thành âm thanh chuyên nghiệp chỉ trong vài phút. Điều này áp dụng cho các podcast thông tin, bản tin thời sự, truyện hư cấu, tiểu thuyết dài kỳ, hoặc thậm chí cả các tài liệu hướng dẫn kỹ thuật được thuyết minh.
Nó cũng là một công cụ hỗ trợ tuyệt vời trong việc tái sử dụng nội dung văn bản hiện có : các bài viết trên blog, bản tin, bài đăng trên mạng xã hội hoặc báo cáo có thể được chuyển đổi thành các tập âm thanh, mở rộng phạm vi tiếp cận thông điệp và mang đến cách thức thuận tiện hơn cho những người thích nghe hơn là đọc.
Một ưu điểm khác là chất lượng luôn ổn định theo thời gian . Trong khi diễn viên lồng tiếng người có thể thay đổi năng lượng, ngữ điệu hoặc độ rõ ràng tùy thuộc vào từng ngày, AI duy trì một mức độ ổn định, điều này tạo điều kiện thuận lợi cho việc sản xuất hàng loạt: nhiều tập được ghi âm trong một lần thu sẽ duy trì cùng một chất giọng và phong cách.
Trong lĩnh vực giáo dục, VibeVoice là lựa chọn hoàn hảo cho các khóa học âm thanh, bài đọc hướng dẫn và tài liệu dễ tiếp cận dành cho người khiếm thị hoặc những người đơn giản là thích học bằng cách nghe trong khi làm các công việc khác. Khả năng tạo ra phiên bản giọng nói của các bài học hoặc tài liệu dài mang lại vô số khả năng.
Rủi ro, hạn chế và quyết định của Microsoft liên quan đến kho lưu trữ
Mặt khác, trí tuệ nhân tạo (AI) có khả năng bắt chước giọng nói con người và tạo ra lời nói chân thực lại đặt ra những lo ngại nghiêm trọng về đạo đức và an ninh. Nguy cơ bị lạm dụng là có thật, và các công ty công nghệ lớn ngày càng nhận thức rõ điều này.
Trong chính văn bản ra mắt sản phẩm, Microsoft đã nêu rõ rằng VibeVoice không nên được sử dụng cho mục đích tạo video giả mạo (deepfake), đánh cắp danh tính hoặc các hoạt động bất hợp pháp . Họ cũng trực tiếp cấm sử dụng ứng dụng này trong các bối cảnh phát tán thông tin sai lệch hoặc lừa đảo, chính vì mức độ chân thực của nó có thể dễ dàng đánh lừa những người nghe không nghi ngờ.
Mặc dù giọng nói mà mô hình này tạo ra rất thuyết phục, nhưng những người tạo ra nó chỉ ra rằng nó vẫn chưa thể nắm bắt hết tất cả những sắc thái tinh tế của giọng nói người thật : hơi thở, những biến đổi cảm xúc nhỏ, những khoảng dừng tự nhiên và sự thay đổi nhịp điệu vẫn phong phú hơn ở người thật so với trí tuệ nhân tạo. "Khiếm khuyết" này có thể giúp phát hiện ra rằng chúng ta đang nói về giọng nói tổng hợp, nhưng ranh giới giữa hai điều này ngày càng trở nên mờ nhạt.
Sau khi dự án được phát hành dưới dạng khung nghiên cứu mã nguồn mở , Microsoft đã phát hiện ra các trường hợp mô hình này được sử dụng theo những cách không phù hợp với mục đích ban đầu và các nguyên tắc sử dụng có trách nhiệm. Để đối phó, công ty đã thông báo rằng họ buộc phải tạm thời vô hiệu hóa kho lưu trữ cho đến khi có thể đảm bảo rằng những cách sử dụng ngoài phạm vi này sẽ không còn xảy ra nữa.
Tuyên bố nhấn mạnh rằng việc sử dụng AI một cách có trách nhiệm là nguyên tắc cốt lõi của Microsoft , và họ thích tạm dừng và xem xét hơn là duy trì một công cụ có thể tạo điều kiện cho việc lạm dụng nghiêm trọng. Mặc dù vậy, tài liệu, bản demo và tài liệu kỹ thuật đã góp phần truyền cảm hứng cho cộng đồng và tiếp tục thúc đẩy lĩnh vực tổng hợp giọng nói.
Các ứng dụng khác ngoài podcasting
Mặc dù sự chú ý của giới truyền thông chủ yếu tập trung vào podcast, VibeVoice mở ra một phạm vi ứng dụng khá rộng trong thế giới âm thanh do AI tạo ra. Nhiều ứng dụng trong số này cũng phù hợp với các chiến lược nội dung số và tự động hóa.
Một trong những ví dụ rõ ràng nhất là sách nói và truyện kể , nơi mà giọng nói truyền cảm, có khả năng thu hút sự chú ý trong hàng chục phút là vô cùng quan trọng. Khả năng đa người nói cho phép mỗi nhân vật có giọng nói riêng, cải thiện đáng kể trải nghiệm nghe so với chỉ một người kể chuyện.
Trong lĩnh vực trợ lý giọng nói và trợ lý đàm thoại, phiên bản thời gian thực của VibeVoice là lý tưởng. Một bot phản hồi với độ trễ chỉ 300 ms mang lại cảm giác tự nhiên hơn nhiều so với một bot mất vài giây để nói, giúp tương tác với dịch vụ khách hàng, chatbot hoặc giao diện giọng nói trở nên mượt mà hơn.
Một lĩnh vực rất thú vị khác là nội dung tự động : tóm tắt tin tức, cập nhật thị trường, báo cáo định kỳ hoặc thậm chí cả nội dung email và thông báo có thể được tạo ra mà không cần sự can thiệp của con người, duy trì giọng điệu nhất quán với hình ảnh thương hiệu.
Cuối cùng, có những ứng dụng mang tính thử nghiệm hơn, chẳng hạn như tạo ra các đoạn hội thoại hư cấu, các cuộc phỏng vấn mô phỏng hoặc các chương trình giải trí được tạo ra hoàn toàn bằng trí tuệ nhân tạo . Ở đây, các mô hình ngôn ngữ để viết kịch bản được kết hợp với VibeVoice để lồng tiếng, tạo ra các định dạng mà trước đây dường như chỉ có trong khoa học viễn tưởng.
Nhìn tổng thể, VibeVoice nổi bật như một nhân tố chủ chốt trong làn sóng âm thanh do AI tạo ra , có khả năng kết hợp giọng nói tự nhiên, các cuộc hội thoại nhiều người tham gia, các đoạn âm thanh rất dài và phản hồi gần như tức thì. Nếu được sử dụng một cách có trách nhiệm và trong khuôn khổ đạo đức, nó có thể trở thành một công cụ vô cùng mạnh mẽ cho bất kỳ ai muốn khởi động hoặc mở rộng quy mô podcast, sản xuất sách nói hoặc thêm giọng lồng tiếng chuyên nghiệp vào các dự án kỹ thuật số của họ mà không cần phải luôn dựa vào phòng thu âm truyền thống.

Index
- 1 VibeVoice là gì và tại sao nó lại quan trọng đối với podcast?
- 2 Cách thức hoạt động của VibeVoice: tổng hợp giọng nói tiên tiến và độ trễ thấp
- 3 Các phiên bản hiện có: kiểu máy, thông số và cách sử dụng được khuyến nghị.
- 4 Ứng dụng thực tiễn: cách tạo podcast bằng VibeVoice
- 5 Nhân bản giọng nói và cá nhân hóa giọng nói bằng AI
- 6 Ưu điểm dành cho người sáng tạo nội dung và các dự án nhỏ
- 7 Rủi ro, hạn chế và quyết định của Microsoft liên quan đến kho lưu trữ
- 8 Các ứng dụng khác ngoài podcasting