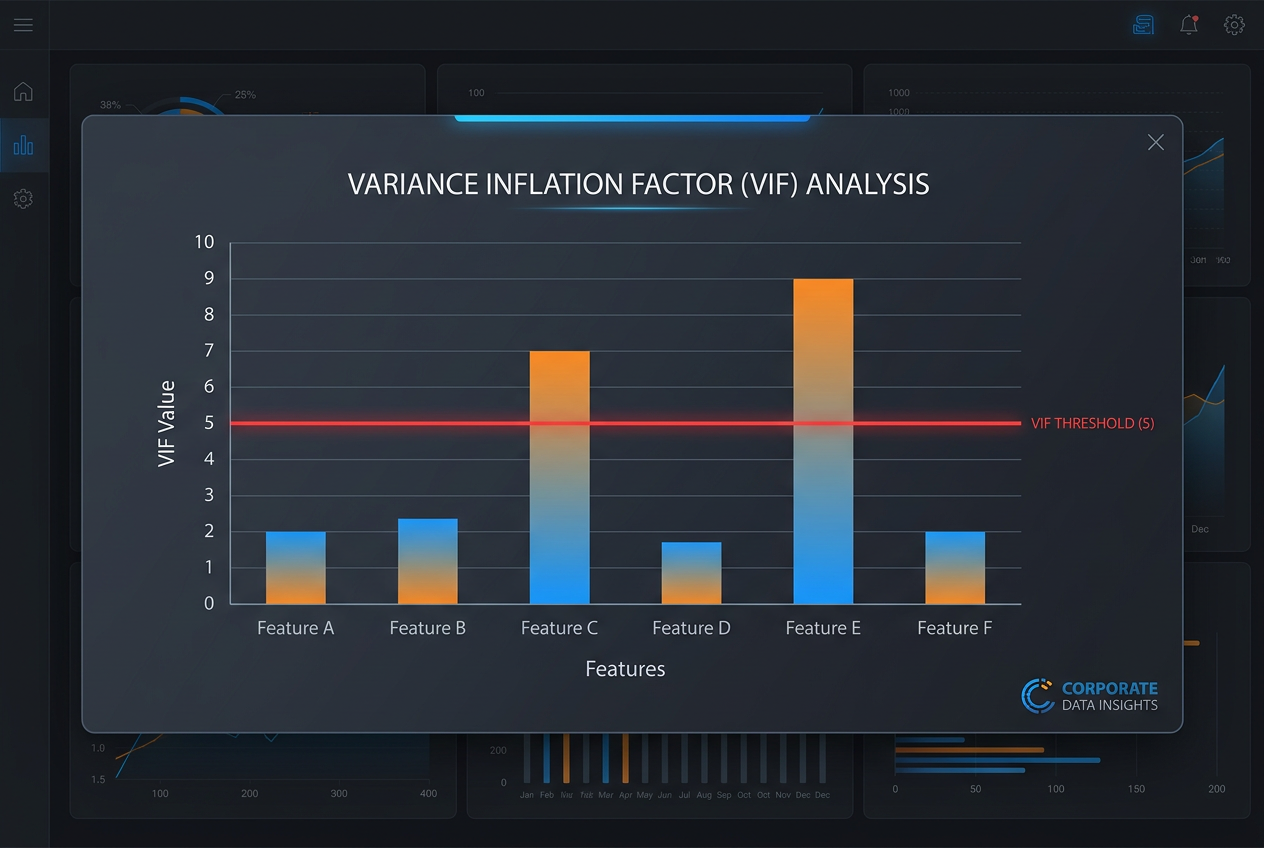
- Chỉ số VIF cho phép phát hiện hiện tượng đa cộng tuyến trong các mô hình hồi quy, và trở nên nghiêm trọng khi giá trị vượt quá ngưỡng 5.
- Việc triển khai trong C# yêu cầu chuẩn hóa dữ liệu để đảm bảo tính ổn định về mặt số học và tránh các lỗi về độ chính xác.
- Thiết kế mã nguồn sạch cần tách biệt các tài nguyên bên ngoài, trạng thái dữ liệu và logic hành vi để tối ưu hóa hiệu năng.
Nếu bạn đã từng dấn thân vào thế giới phân tích dữ liệu, chắc chắn bạn đã gặp phải vấn đề đau đầu về đa cộng tuyến. Về cơ bản, hiện tượng này xảy ra khi các biến độc lập của bạn có mối liên hệ quá chặt chẽ, điều này có thể khiến mô hình hồi quy của bạn hoạt động sai lệch và tạo ra kết quả không đáng tin cậy. Để giải quyết sự hỗn loạn này, Hệ số khuếch đại phương sai (VIF) sẽ được sử dụng — một công cụ quan trọng để xác định biến nào đang gây ra vấn đề.
Mặc dù các thư viện mạnh mẽ đã tồn tại trong các ngôn ngữ như R hoặc Python, việc triển khai khái niệm này trong C# đòi hỏi sự hiểu biết vững chắc về toán học cơ bản và cách cấu trúc mã để dễ bảo trì. Vấn đề không chỉ là viết từng hàm một, mà là tổ chức logic lập trình sao cho phần mềm dễ đọc và hiệu quả, tránh để mã trở nên khó hiểu và lộn xộn.

Hiểu về VIF và hiện tượng đa cộng tuyến
Hệ số khuếch đại phương sai (VIF) là một thước đo cho biết mức độ gia tăng phương sai của một hệ số ước lượng do sự tương quan của nó với các biến khác trong mô hình. Nói một cách đơn giản, nếu một biến có VIF rất cao , điều đó có nghĩa là phần lớn thông tin của nó đã được các biến khác bao phủ, khiến sai số chuẩn tăng vọt và gây khó khăn trong việc xác định biến nào thực sự ảnh hưởng đến kết quả.
Nguyên tắc chung mà nhiều nhà phân tích tuân theo là nếu giá trị VIF lớn hơn 5 , chúng ta đang đối mặt với trường hợp đa cộng tuyến đáng lo ngại. Trong những trường hợp nghiêm trọng hơn, giá trị trên 10 là dấu hiệu rõ ràng cho thấy biến đó cần được xem xét lại hoặc loại bỏ khỏi tập dữ liệu để làm sạch mô hình và cải thiện tính ổn định số học.
Triển khai kỹ thuật và logic trong C#
Để tính toán hệ số VIF của một biến cụ thể trong ma trận thiết kế, quy trình bao gồm việc coi biến đó như thể nó là biến phụ thuộc và thực hiện hồi quy tuyến tính sử dụng tất cả các biến độc lập khác làm biến dự báo. Kết quả là hệ số xác định R², và VIF được tính bằng công thức 1 / (1 – R²).
Khi lập trình điều này bằng C#, điều quan trọng là phải chú ý đến việc ổn định số học . Một phương pháp tốt nhất là chuẩn hóa các cột của ma trận thiết kế, đặt giá trị trung bình bằng 0 và độ lệch chuẩn bằng 1. Điều này rất quan trọng khi làm việc với dữ liệu trên các thang đo rất khác nhau hoặc các phép biến đổi phi tuyến tính, vì nó ngăn chương trình bị lỗi do sai số độ chính xác thập phân.
Nguyên tắc thiết kế mã sạch
Ngoài bản thân công thức, cách chúng ta viết mã trong C# mới là điều tạo nên sự khác biệt. Một lỗi thường gặp là tạo ra các đối tượng thực hiện những việc mà chúng không được thiết kế để làm; ví dụ, một lớp "Ball" lại có phương thức "Throw()", điều này không hợp lý vì một quả bóng không tự ném mình. Mã nên được viết như những câu văn mạch lạc , trong đó chủ ngữ thực hiện một hành động nhất quán trên đối tượng.
- Tài nguyên bên ngoài: Chúng nên được xử lý ở một cấp độ trừu tượng riêng biệt, lý tưởng nhất là thông qua Dependency Injection.
- Tình trạng và dữ liệu: Mã nguồn hướng dữ liệu cần tuân theo các nguyên tắc của Lập trình hướng đối tượng (OOP).
- Hành vi cư xử: Logic và thuật toán nên hoạt động như những hàm thuần túy, nhận dữ liệu và tài nguyên làm tham số.
Để tổ chức dự án, người ta đề xuất một cấu trúc phân cấp bắt đầu từ không gian tên, tiếp đến là các lớp tĩnh khi độ phức tạp tăng lên, và kết thúc bằng các lớp thông thường. Tốt hơn hết là nên nhóm các lớp liên quan vào cùng một tệp nếu chúng có cùng chức năng, điều này giúp trình biên dịch tối ưu hóa mã nhị phân và cải thiện hiệu suất thời gian chạy bằng cách quản lý bộ nhớ cache và các thanh ghi CPU tốt hơn.
Các giải pháp thay thế và trực quan hóa dữ liệu
Mặc dù C# mạnh mẽ trong việc lập trình, các công cụ như R thường được sử dụng trong môi trường khám phá nhanh. Trong ngôn ngữ này, các thư viện như "car" cho phép tính toán VIF gần như tức thời. Sau khi có được các giá trị, lý tưởng nhất là không chỉ dựa vào các con số mà còn sử dụng biểu đồ cột để trực quan hóa việc xác định các nguồn gây ra hiện tượng đa cộng tuyến.
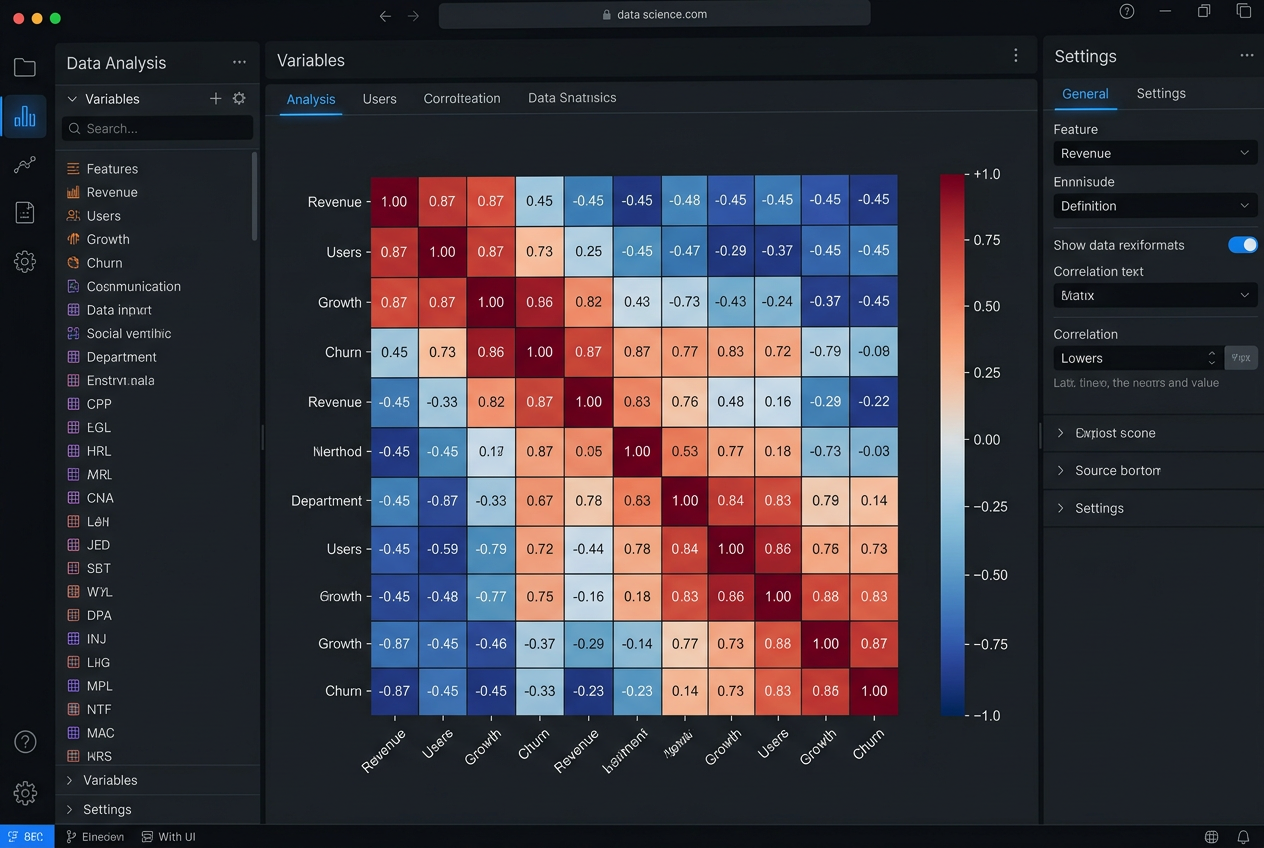
Việc bổ sung phân tích bằng ma trận tương quan là một bước quan trọng. Việc trực quan hóa mối quan hệ giữa các biến bằng màu sắc cho phép chúng ta hiểu không chỉ có vấn đề về VIF mà còn chính xác cặp biến nào đang gây ra xung đột. Sự kết hợp giữa phân tích thống kê và trực quan hóa này đảm bảo mô hình cuối cùng chính xác và không chỉ là một mô hình dễ sụp đổ.
Quản lý VIF hiệu quả, kết hợp với kiến trúc phần mềm dựa trên nguyên tắc trách nhiệm duy nhất và cấu trúc dữ liệu chuẩn hóa, cho phép tạo ra các công cụ phân tích C# mạnh mẽ và dễ bảo trì. Bằng cách loại bỏ sự dư thừa dữ liệu và áp dụng các nguyên tắc thiết kế nhất quán , chúng tôi chuyển đổi mã nguồn khó hiểu thành một giải pháp chuyên nghiệp có khả năng xử lý các bài toán hồi quy phức tạp với độ tin cậy tuyệt đối.