- 从根本上区分模型训练阶段和推理阶段,从而产生商业价值。
- 部署架构分析:从集中式云处理到边缘计算(边缘人工智能)。
- 评估技术硬件要求,特别是GPU中VRAM对模型执行的重要性。
- 优化策略,例如量化和使用小语言模型(SLM)来提高运营效率。

谈到人工智能,大多数人会想到大规模的学习过程和处理数万亿数据点的超级计算机。然而,真正为商业带来奇迹的环节其实在于推理。本质上,推理是人工智能停止学习、开始工作的时刻,它将所学知识应用于解决现实世界的问题,并基于从未见过的数据做出决策。
在当今形势下,企业已不再将人工智能视为实验室实验,而是将其融入日常运营的核心。这不再仅仅是创建最强大的模型,而是如何可靠、安全且最重要的是盈利地运行它,从而将工作负载从理论转移到混合环境中的实际生产环境中。

训练与推理:它们并不相同
为避免混淆,明确区分这两个阶段至关重要。训练阶段就像人工智能的求学阶段;这是一个密集的过程,模型需要分析历史数据和标签以发现规律。大型数据中心会使用GPU或TPU等强大的硬件加速器,由于训练过程可能需要数天甚至数周,因此响应时间并非首要考虑因素。
另一方面,推理是最终的实时测试。在这个执行过程中,模型接收输入(照片、文本或传感器读数)并立即返回结果。在这个阶段,延迟至关重要,效率是关键。训练奠定了基础,而推理则为组织创造直接的经济价值。
部署策略:云端、本地部署和边缘部署
推理方法并非只有一种。企业会根据数据的紧急程度和规模选择不同的方法。批量推理非常适合处理海量、非紧急任务,例如夜间财务分析或大规模文档分类,这类任务的数据在云端处理,结果稍后返回。

接下来是实时推理,这对于聊天机器人或欺诈检测系统至关重要,因为这类系统必须在毫秒内响应。尽管云计算凭借其可扩展性仍然是主流选择,但在处理TB级数据时,由于网络延迟和高昂的带宽成本,其局限性也开始显现。
这就是边缘推理或边缘人工智能发挥作用的地方。通过直接在设备(物联网传感器、机器人或智能手机)上处理数据,可以实现极低的延迟和显著更高的隐私保护,因为敏感信息无需传输到远程服务器。这在毫秒级延迟都至关重要的领域,例如自动驾驶或远程手术,尤为重要。
植物推断与工业4.0
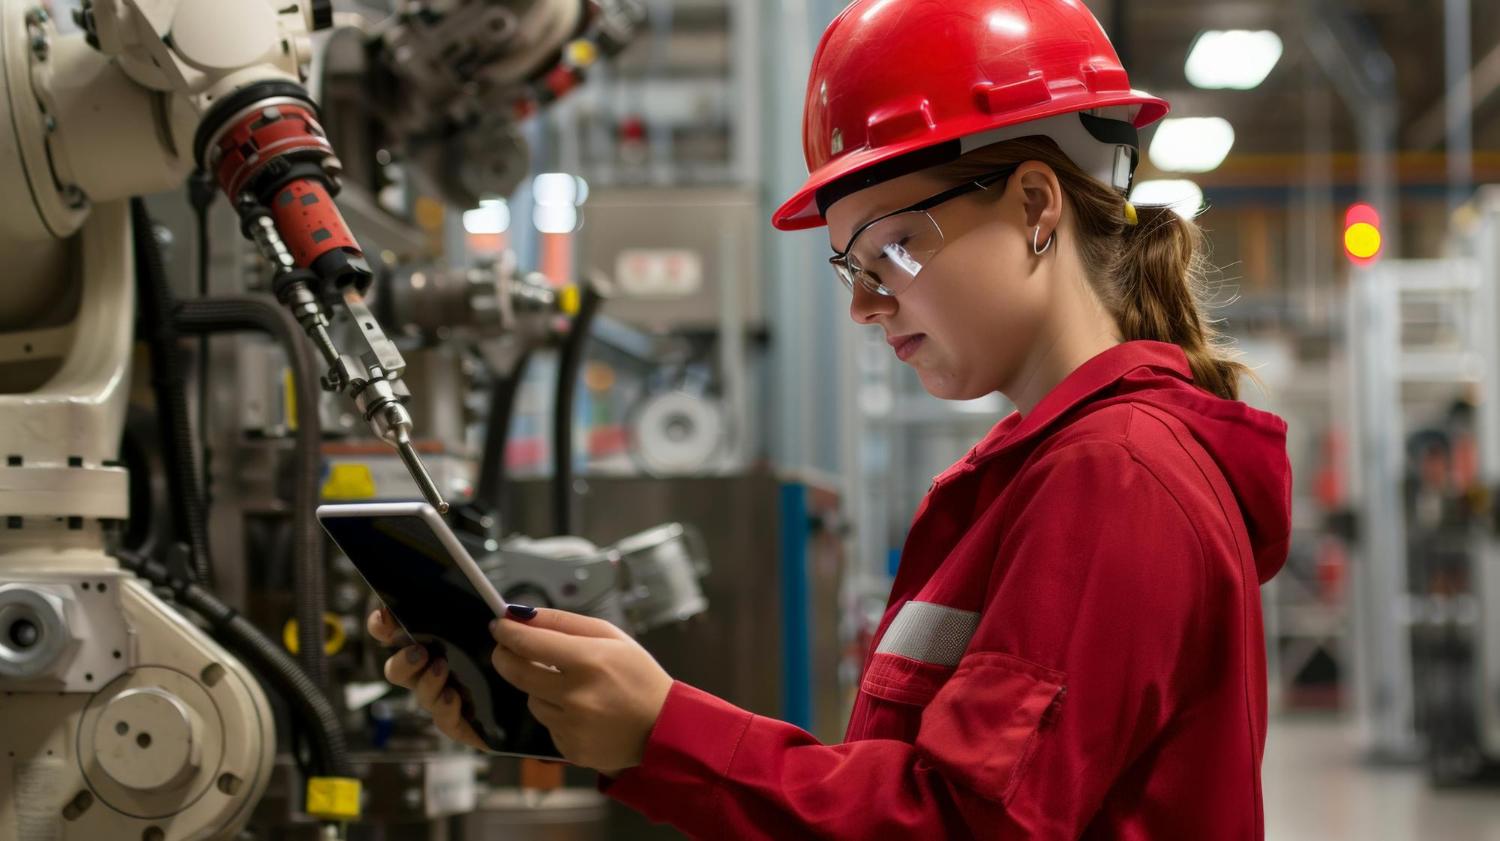
在制造业领域,推理技术堪称一项真正的瑰宝。它使机器无需依赖互联网连接即可即时做出智能决策。这意味着可以实现实时质量控制,在装配线上检测出缺陷零件,避免造成不必要的成本。

此外,它也是预测性维护的基础。人工智能模型实时分析设备运行状况,并在故障发生前发出预警,从而避免造成数千欧元的停产损失。在食品和电子行业,这确保了最终产品始终符合最严格的质量标准。
技术要求和模型优化
如果公司决定在本地运行推理,硬件至关重要。GPU由于其并行架构而必不可少。最关键的因素不仅是原始性能,还有显存(VRAM);如果模型完全可以加载到显存中,响应时间将大幅提升。否则,系统将依赖于传统内存(RAM),这将显著降低整体速度。
为了使这些模型能够在资源有限的设备上运行,需要采用优化技术。量化技术会降低模型权重的精度(例如,从 32 位降至 4 位),从而在不牺牲太多准确性的前提下,显著减小文件大小并提高运行速度。另一方面,低秩自适应 (LoRA) 技术允许大型模型适应特定任务,而无需重新训练整个模型,这大大降低了成本并提高了速度。

小型语言模型 (SLM)也正在迅速发展。与庞大的语言模型 (LLM) 不同,SLM 的设计目标是高效轻量,使其非常适合边缘硬件。为了解决硬件碎片化问题, SLM 采用了WebAssembly (Wasm)语言,这使得 AI 能够在任何设备上以接近原生速度运行,而无需考虑其处理器性能。
治理、安全和运营工具
将人工智能投入生产环境意味着它不再仅仅是游戏,而是一项至关重要的工作负载。许多公司已经在混合云或多云环境中运行,这就需要实施严格的路由和安全控制。治理的重点现在放在提示层、令牌层和 API 层,在这些层中,管理人工智能开发环境中的安全对于防止数据泄露至关重要。
对于那些想要尝试本地推理的用户来说,市面上有一些非常强大的工具可供选择。LM Studio是一个不错的选择,它拥有简洁的图形界面,并且兼容 Hugging Face 模型。对于开发者而言,Ollama是明星工具,因为它开源,并且可以通过 Docker 容器高效地在计算机上运行本地 AI 。

还有其他一些有趣的替代方案,例如支持广泛硬件的Llama.cpp ,或者优先考虑完全离线环境的用户可以使用Jan。甚至还有像 PocketPal 这样的智能手机应用,可以直接将推理功能带到你的口袋里,这表明人工智能不再一定需要超级计算机才能发挥作用。
趋势显而易见:人工智能正朝着分布式模型发展。未来不在于云端单一的中心化“大脑”,而在于分布于数据中心和本地设备的智能推理网络。这种混合架构能够在计算能力、即时响应需求和企业数据隐私保护之间取得平衡。
