- CPU 和 GPU 之间的架构差异使得大规模并行计算成为可能。
- 使用标准、竞价和灵活配置模型的云部署策略。
- 基于显存、带宽和延迟的硬件选择关键技术标准。
- 先进的编程和全球编排系统,以优化人工智能集群的使用。

当我们谈到处理海量数据的强大运算能力时,就不得不提及图形处理器(GPU)所发挥的关键作用。虽然GPU最初的设计目的是为了让电子游戏画面更加精美,但如今它已成为人工智能和海量数据分析的核心引擎,使得以往需要数周才能完成的任务,现在只需几个小时就能完成。
将这些工作负载迁移到云端,对开发人员和数据科学家来说意义非凡。我们不再需要花费巨资购买很快就会过时的硬件;相反,我们可以租用根据实际需求量身定制的计算能力,根据项目扩展资源,并优化基础设施上的每一分投资。

CPU 与 GPU:它们之间真正的区别是什么?
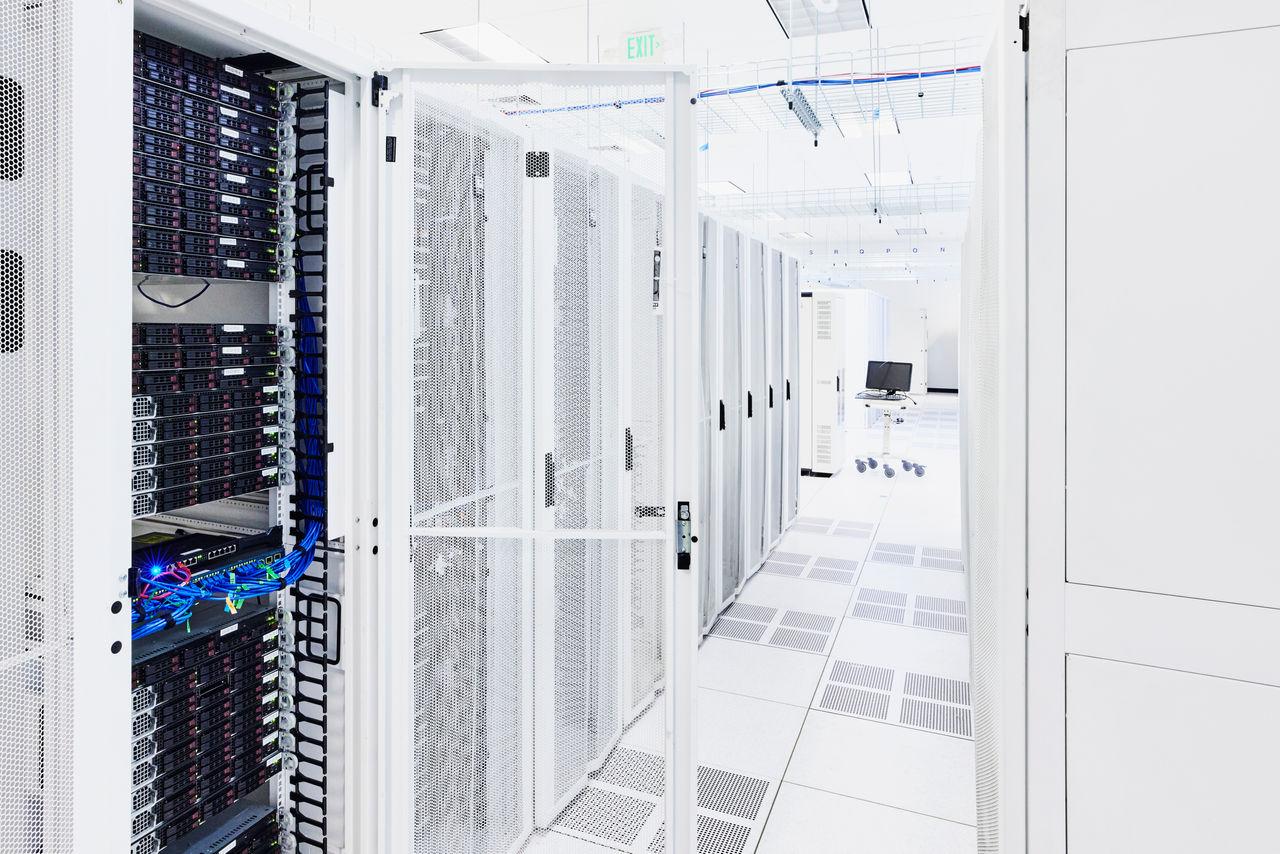
简单来说,CPU就像一位高智商的指挥家,它能完成所有任务,但只能逐一处理。相比之下,GPU就像一支由成千上万个工人组成的军队,它们专门负责反复执行相同的数学运算,但却是同时进行的。这就是我们所说的并行计算的基础。
CPU负责处理复杂的逻辑和系统控制,而GPU则擅长矩阵处理和图像渲染。GPU拥有成百上千个核心,类似于多核CPU架构,但规模更大,因此可以同时执行任务的多个子集——这对于训练神经网络或处理TB级数据而不导致系统崩溃至关重要。
批量和实时作业管理
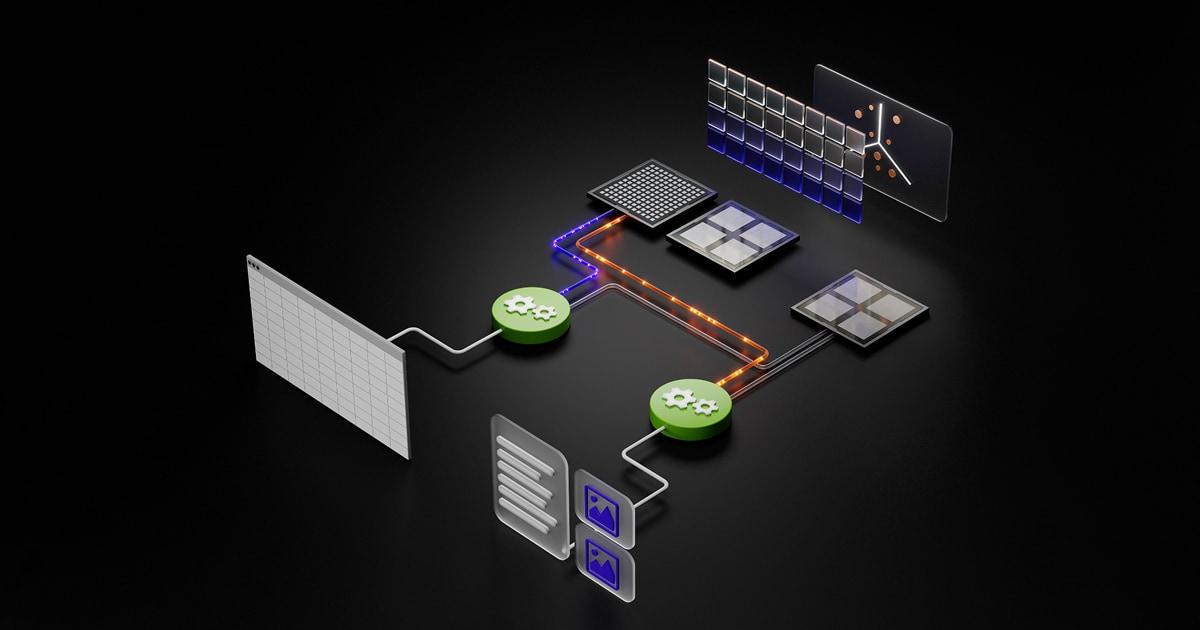
在云生态系统中,执行这些任务主要有两种方式。批处理非常适合那些不需要立即响应的作业,例如数据预处理或大规模推理。其目标是通过允许作业累积并在资源可用时运行,来最大限度地提高效率和整体系统性能。
另一方面,实时处理对于需要即时响应的应用至关重要,例如生成式人工智能聊天机器人或人脸识别。在这些情况下,绝对优先考虑的是低延迟和高可用性,以确保最终用户在模型处理信息时不会察觉到任何延迟。
要启动这样一个项目,需求规划至关重要。从选择合适的机器到安装驱动程序(可以是自动安装,也可以是使用自定义镜像手动安装),每一步都会影响项目的顺利进行,避免出现技术难题。
消费模型和成本优化
并非所有虚拟机都一样,价格也各不相同。对于想要节省成本的用户来说,竞价型虚拟机 ( Spot VM)是一个诱人的选择,它们提供大幅折扣,但同时也存在云服务随时可能收回虚拟机的风险。竞价型虚拟机非常适合对容错性要求高且成本优先的任务。
如果您需要更稳定但价格更低的方案,可以选择灵活的启动虚拟机,它允许您以优惠的价格使用 GPU 资源,但需要等待几天才能开始工作。对于关键任务项目,您可以选择标准的按需配置或计划预留,这两种方案都能确保硬件在您需要时精准可用。

区域成本套利是最大化预算利用的一种高级技巧。利用不同地理区域的价格差异或采用“追日”调度方式,可以让亚洲、欧洲和美洲的团队轮流使用集群,从而实现接近 100% 的硬件利用率。
如何为您的使用场景选择合适的 GPU

选择显卡的关键不在于最贵的显卡,而在于选择最适合任务的显卡。在大型语言模型(LLM)训练中,显存(VRAM)是主要瓶颈。如果显存不足,就必须减小批处理大小,这将显著增加执行时间和总体成本。
- 人工智能训练: 它需要混合精度(FP16/BF16)的高功率和充足的 VRAM 来处理梯度和优化器状态。
- 实时推理: 在此,网络延迟和软件堆栈稳定性是防止生产中断的关键。
- 数据科学: 需要在 CPU、RAM 和 GPU 之间寻求平衡,因为很多数据清理工作仍然是顺序执行的任务。
- 3D渲染和视觉特效: 它们严重依赖内存带宽来快速移动复杂的纹理和几何形状。
- 科学计算: 他们优先考虑 FP32 或 FP64 的准确性和通过固定驱动程序版本实现结果的精确可重复性。
监控系统数据流至关重要。如果 CPU 或存储速度慢,即使拥有超强大的 GPU 也毫无用处;在这种情况下,GPU 大部分时间都将处于空闲状态,等待数据,这被称为资源未充分利用。
高级编排与计算的未来
随着集群规模的扩大,简单的“先进先出”调度方式已不再适用。领先的公司正在实施多级调度层级结构,根据数据位置、业务优先级和所在区域的碳足迹来分配作业。

实时CPU/GPU切换等创新技术使系统能够根据每个线程的需要动态选择最高效的处理器。这通过优化每个可用的时钟周期,有效解决了全球硬件短缺的问题,使生成式人工智能和数字孪生技术能够不受芯片不足的制约而快速发展。
Kubernetes 与动态资源分配 (DRA)和多实例 GPU (MIG) 技术的结合使用,可以将单个物理显卡划分为多个虚拟实例。这使得高性能计算资源更加普及,允许多个用户共享同一块 GPU 而不会相互干扰。
只有制定清晰的策略,将合适的硬件、智能的支付模式和灵活的编排相结合,才能避免在云计算上浪费资金。从显存选择到竞价型实例部署,每一项技术决策都会直接影响任何高级计算项目的创新速度和盈利能力。
