- LiteRT 取代 TensorFlow Lite,成为谷歌用于在移动设备、桌面设备和物联网设备上运行 AI 的通用框架。
- 它利用 NPU、GPU 和 CPU 优化推理,与传统 CPU 相比,速度提升高达 100 倍。
- LiteRT-LM 专门用于协调 LLM 和 Gemma 等生成模型,从而改善内存管理和本地上下文。
- 它与 PyTorch、JAX 和 TensorFlow 完全兼容,可轻松将模型转换为 .tflite 格式。
生成式人工智能正在取得令人瞩目的飞跃,它不再仅仅是将数据发送到云端并等待响应。如今,最精妙之处在于所有操作都直接在设备(无论是移动设备还是边缘计算环境)上运行,从而实现即时体验,更重要的是,确保数据隐私不再依赖于外部服务器。
在此背景下,LiteRT应运而生。这是谷歌推出的全新标准,旨在取代老牌的TensorFlow Lite。它并非简单的补丁,而是一个通用基础架构,旨在让开发者能够在从智能手表到Windows PC的任何平台上部署强大的AI模型,从而最大限度地利用现有硬件。

LiteRT是什么?它为何能改变游戏规则?
LiteRT本质上是TensorFlow Lite的继任者,旨在解决硬件碎片化带来的挑战。传统的机器学习侧重于图像识别等简单任务,而GenAI则需要更高效的资源管理。无论设备是Android、iOS、macOS、Linux,甚至是Web应用程序,该框架都能实现可复现且高效的推理。
对于那些创建初创公司或开发技术产品的人来说,这完全是一次范式转变。通过在本地运行模型,延迟大幅降低,并消除了重复的第三方 API 费用,从而使应用程序即使在没有互联网连接的情况下也能完美运行。
加速引擎:CPU、GPU 和 NPU 的性能

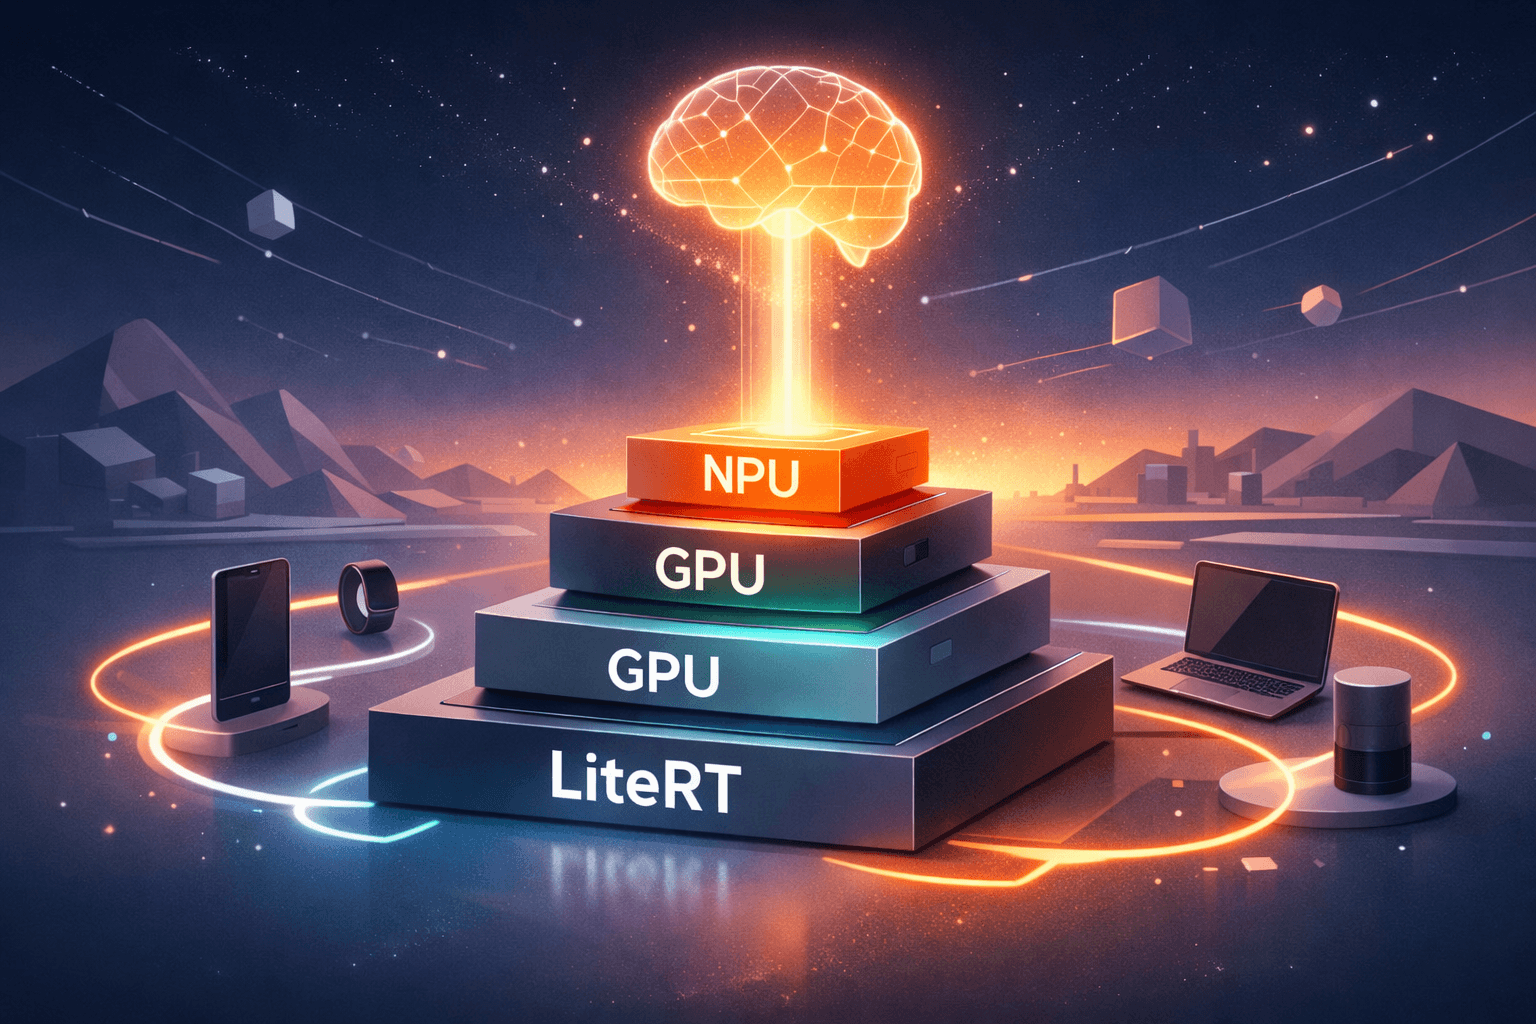
LiteRT 的真正优势在于它能够榨干每颗芯片的每一分性能。得益于名为ML Drift的引擎,该系统可以利用 Metal、OpenCL、OpenGL 和 WebGPU 等多种 API 来管理 GPU 加速。事实上,在 Android 平台上,运行时环境足够智能,能够自动优先使用 OpenCL(如果可用),仅在必要时才使用 OpenGL。
但LiteRT真正的亮点在于其NPU(神经处理单元)。得益于与高通的合作,QNN加速器在某些情况下能够实现比CPU快100倍、比GPU快10倍的速度提升。这使得人工智能从缓慢的实验阶段转变为切实可行的生产工具。
LiteRT-LM:协调生成式人工智能和LLM
当我们讨论大型语言模型(LLM)时,情况就变得复杂了,因为它们并非简单的模型,而是复杂的管道。LiteRT -LM正是为此而生,它是一个专门的编排层,能够高效地管理内存、缓冲区和上下文。这项技术也为 Pixel Watch和 Chrome 上的 Gemini Nano 提供支持。

为了方便程序员,谷歌集成了 LiteRT Torch 生成式 API。该工具可以轻松转换基于 PyTorch 的模型,使Gemma等开源模型能够在设备上超高速运行。在实际基准测试中,LiteRT通过更好地利用硬件,在预填充和解码速度方面都优于 llama.cpp 。
技术创新:零拷贝和异步执行
移动人工智能领域常见的瓶颈之一是CPU和加速器之间的数据传输。LiteRT通过零拷贝缓冲区管理解决了这个问题,避免了内存中不必要的数据重复。这相当于模型直接从数据所在位置读取信息,使得背景分割等任务的速度提升高达两倍。
此外,新的CompiledModel API支持异步启动推理。这意味着在 AI 处理数据时,应用程序不会卡顿,从而提升了用户界面的流畅度。系统能够实时评估硬件并选择最佳加速器,而无需开发人员为每个芯片编写特定的代码。
框架灵活性和战略部署
最棒的是,它并不强制你只使用一种语言。LiteRT 兼容PyTorch、JAX 和 TensorFlow 。如果你已经搭建好了训练流程,也不必放弃;你可以将模型转换为.tflite格式,并部署到任何受支持的操作系统上。
对于企业而言,实施这项技术需要清晰的战略。仅靠模型本身是不够的;它必须与定制软件开发和云计算基础设施相结合,以便在需要时扩展人工智能。此外,当人工智能部署到设备端时,网络安全变得至关重要,因为必须确保敏感信息永远不会离开用户的硬件。
采用此标准可以创建实时响应的自主代理,从而减少对昂贵服务器的依赖。与那些继续完全依赖云服务的组织相比,如今集成本地推理的组织将在成本、隐私和响应速度方面获得显著的竞争优势。
