- Microsoft Fabric 将数据、治理、人工智能和实时分析集中在 OneLake 上,并实现了统一的功能。
- 该平台通过 Purview、OneLake 安全、DLP、DSPM 以及与 Azure 成本管理的集成,加强了治理、安全性和成本控制。
- 数据工厂、数据流 Gen2 和迁移工具使迁移现有工作负载和协调复杂的管道变得容易。
- Copilot、数据代理、MCP 和 Fabric IQ 和实时智能等新工作负载推动了高级 AI 和自动化场景的发展。
如果您在微软生态系统中从事数据工作一段时间,就会发现Microsoft Fabric 已成为现代分析的核心枢纽,它将之前分散在 Power BI、Azure Synapse、Data Factory 和其他服务中的所有功能整合到一个统一的平台中。在本文中,我们将深入探讨 Fabric 的最新功能、发展路线图以及它在分析、治理、人工智能和实时分析方面的实际应用。
其理念是,读完本文后,您将清楚地了解Microsoft Fabric 目前提供的功能、发展方向以及它如何影响您组织的数据架构:通过 Purview 实现治理功能、通过 API 和 Git 实现自动化、新的 AI 功能、实时智能、OneLake 中的安全性、迁移、性能等等。
Microsoft Fabric 和云采用框架:治理、成本和自动化
在云采用框架 (CAF) 中,微软发布了一系列指南,旨在使Microsoft Fabric 的设计与着陆区的设计支柱保持一致。该系列的最新指南重点关注三个关键领域:治理、容量优化和自动化/DevOps。
在治理方面,Fabric 容量成本通过 Azure 成本管理公开。这使得 F 容量消耗(以及其他 SKU)能够原生集成到 Azure 成本仪表板、警报和支出分析中。这不仅仅意味着查看账单:您还可以将此信息与标签、订阅或资源组进行交叉引用,从而了解谁在花费什么以及原因。
Fabric 的技术架构和商业模式允许客户精细控制容量消耗,从而优化运营成本。在实践中,这体现在以下几个方面:
- 能力扩展 F根据可预测的高峰期(例如销售活动、会计截止日期或大量数据加载)增加或减少容量。
- 暂停和恢复功能Fabric 管理员可以在不需要时暂停 F 容量(例如,在非关键环境中,夜间或周末),以降低计算成本。
- 浪涌保护两个容量级别的参数控制后台作业的管理方式,以防止它们使环境饱和:后台拒绝阈值和后台恢复阈值。
- 容量预订如果对预期消耗量进行严格规划,则可以预留产能一段时间以获得折扣。
在数据治理领域,Fabric 依赖Microsoft Purview 作为其核心组件,用于编目、溯源和分类。Purview 允许用户应用敏感度标签、查看跨源、转换和使用的溯源信息、认证数据资产并开展数据质量活动,同时还能集成 Fabric 的各个组件(Lakehouse、Warehouse、KQL、Power BI 等)。
“平台自动化和DevOps”组件主要关注Git集成、部署管道和REST API。Fabric工作区可以链接到Git存储库,从而允许多个开发人员在同一个数据工程、数据科学或实时分析项目上进行协作,而不会出现工作重叠。
Git 和部署管道能够以可控的方式编排开发、测试和生产生命周期:内容发布、变更跟踪、工件同步和版本管理。自 2025 年 3 月起,这些管道(以常规或预览状态)已支持多种元素类型,包括触发器、仪表板、数据流、数据管道、数据集市、湖仓、数据仓库、KQL、笔记本、分页报表、组织应用程序等等。
同时,Fabric 还公开了一套非常广泛的 REST API,可以自动执行几乎任何管理或部署任务:创建工作区和文件夹、批量迁移项目、管理连接和网关、提取定义、激活管道或笔记本等等。
Microsoft Fabric 在分析、人工智能和治理方面的主要更新
Fabric 的发展历程以大量预览功能和新功能为标志,这些功能和功能几乎涵盖了平台的各个方面。以下将以结构化的方式对这些功能和功能进行分组和讨论,以全面展示它们的范围。
数据仓库和多模态功能中的人工智能功能
在关系型数据领域,Fabric 数据仓库将AI 功能直接集成到 T-SQL 中(预览版)。这使得:
- 对文本进行分类或归类。
- 分析情绪。
- 从自由文本中提取结构化信息。
- 在不同语言之间翻译文本。
- 语法正确。
目标是消除离开 SQL 上下文即可使用 AI 丰富数据的需要。这些功能与 Fabric AI 功能中更广泛的多模态支持相结合,现在可以处理图像(JPG/JPEG、PNG、GIF、WebP)、PDF 和常见文本格式,以及文件路径输入。
该软件包包含一些实用工具,例如用于将文件夹导入表并带有提示和模式选项的 aifunc.load、用于遍历文件路径的 aifunc.list_file_paths 以及用于推断与 ai.extract 兼容的模式的 ai.infer_schema 。所有这些工具使您无需从头构建复杂的管道即可转换和丰富数据。
OneLake、Delta、Apache Iceberg 和多平台访问
在存储层,OneLake 仍然是 Fabric 所有组件所在的统一存储湖。其中一项重大改进是能够将 Delta Lake 表作为 Apache Iceberg 表公开,而无需移动或复制数据,从而使兼容 Iceberg 的引擎可以直接读取 OneLake 中的内容。
此外,OneLake 现在支持Snowflake 直接写入 Apache Iceberg 数据,并通过无复制访问在 Fabric 中使用。这一策略增强了互操作性:Fabric 并非旨在成为一个孤立的系统,而是一个数据中心,其他引擎可以利用它而无需重复存储。
同样,OneLake 支持Azure Blob 存储、OneDrive 和 SharePoint 的快捷方式,并通过访问角色、文件夹、行和列级别的安全性以及第三方可以遵守的安全模型(由于授权引擎模型的扩展)来扩展安全性。
一项特别重要的功能是将 OneLake 目录与 Azure Databricks 联合起来,从而实现从 Unity Catalog 到 OneLake 表的零拷贝访问。这样,OneLake 仍然是数据源,而 Databricks 可以直接查询数据,仅同步元数据。
Fabric 上的 SQL 数据库:性能、安全性和虚拟化
Fabric 的 SQL 数据库正在不断增强自身功能:ALTER DATABASE SET 选项、排序规则支持以及预览版全文索引。在数据库性能和成本方面,也进行了多项改进:
- 自动索引压缩 减少存储、I/O 并缩短查询时间,而无需安排维护作业。
- 最大 vCore 限制 控制计算资源(4 或 32 个虚拟核心)的使用,旨在防止工作负载消耗过多的共享容量。
- 自定义 SQL 池 这使得工作区管理员能够按应用程序名称对资源分配和查询路由进行精细控制。
SQL 数据库也支持数据虚拟化,允许使用 T-SQL 查询存储在 OneLake 中的外部数据,使用连接将通用格式的文件与本地关系表连接起来,而无需物理导入数据。
在安全性方面,SQL 数据库支持租户级别的 Private Link(预览版),这使得以私密和受控的方式传输数据流量变得更加容易,并与 Fabric 的整体安全网络配置集成。
实时智能、Eventhouse、Eventstream 和 Activator
实时智能 (RTI) 模块已成为 Fabric 的关键差异化优势之一。Eventhouse 和 Eventstream 协同工作,实时接收、处理和触发来自各种来源的事件,而 Activator 则负责协调在特定条件下触发的操作。
其中最强大的新功能包括:
- 无需代码的异常检测 具备自动型号选择、简洁界面和灵活提醒功能。
- 商业活动它可以捕获从用户数据函数和笔记本生成的关键业务时刻,并允许您激活警报、自定义逻辑、流程、AI 模型或 Spark 作业。
- 激活器-用户数据功能集成这样,在 Fabric 中创建的函数就可以处理来自任何来源的事件,包括来自平台本身和 OneLake 的内部事件。
- 能够使用 SQL 处理事件(Eventstream 中的 SQL 运算符)允许使用已知的 SQL 语法转换实时流。
添加了相关连接器,例如Cribl(用于从多个来源提取日志和遥测数据)、Solace PubSub+ 连接器,以及通过 Azure 虚拟网络、VPN、ExpressRoute 或专用终结点在专用网络上进行流式传输的支持。
对于数据模式和契约,Eventstream 引入了模式注册表,用于定义和验证事件模式,以实现更强大的管道,并支持 Confluent 模式注册表,以便在遵守现有契约的同时连接到 Confluent Cloud 中的 Kafka。
平台的副驾驶和人工智能功能
Fabric 中的 Copilot 现已在全球范围内推出,支持Power BI、Data Factory、数据科学与数据工程以及 KQL 查询编写。此外,还新增了一些特定功能:
- 数据流 Gen2(现代获取数据)的 Copilot它能够根据自然语言指令摄取和转换数据。
- 数据仓库副驾驶(聊天)可通过功能区上的按钮访问,以通过对话框加速仓储任务。
- SQL 分析端点的 Copilot它可以根据业务描述生成和优化 SQL 查询。
- 笔记本电脑上的副驾驶 了解工作区上下文、Lakehouse、笔记本结构和执行环境后,能够生成多步骤代码、重构、总结复杂的笔记本,并使用“使用 Copilot 修复”选项诊断错误。
- 内联自动补全(内联代码补全)和 Notebook Copilot 内联代码补全(预览)以便更快地编写 Python 代码并减少错误。
此外,人工智能技术基础正在扩展,集成了预构建的 Foundry 工具(Azure OpenAI、Azure Language、Azure Translator)、Eventhouse 的 OpenAI 插件(ai_embed_text 和 ai_chat_completion),以及一系列代理和数据代理,使包括 Copilot Studio 在内的其他应用程序能够以协调的方式处理 Fabric 数据。
Fabric 数据代理、MCP 和开发者工具
Fabric 引入了能够协调数据访问的数据代理和AI 代理工具,并提供 Python SDK 和与 Microsoft Copilot Studio 的直接集成。这使得构建能够处理 Fabric 管理的企业数据的对话式助手变得轻而易举。
与此同时,模型上下文协议 (MCP)成为 AI 代理与 Fabric 服务集成的关键组件。Activator 和 Eventhouse 拥有专用的 MCP 服务器,而 Fabric 还拥有面向开发的 MCP,该 MCP:
- 它允许人工智能助手为 Fabric 商品生成代码和内容。
- 它与 VS Code 和 GitHub Codespaces 等开发工具集成。
- 它提供了在 Eventhouse 中查询和处理实时数据的工具。
对于开发人员的日常工作而言,有几个方面值得重点关注,包括开发环境:支持 Fabric SQL 数据库的 VS Code MSSQL 扩展、用于 Fabric 数据工程的 Microsoft ADO.NET 驱动程序和 ODBC 驱动程序(通过 Livy 连接到 Spark SQL),以及用于 SQL 数据库的 Spark 连接器,可简化从 Spark 到 Azure 和 Fabric 中 SQL 数据库的身份验证访问。
此外,还包括Fabric CLI,它作为 Azure DevOps 中的集成任务提供,可让您自动管理工作区、项目和部署,而无需手动安装外部工具。
Fabric 中的数据工厂、数据迁移和编排
Fabric 的数据集成层依赖于 Data Factory 和 Dataflow Gen2,它们正在获得一些功能,以使编排更智能、更自动化,并更容易从现有平台迁移。
数据流 Gen2:性能、公共 API 和诊断
Dataflow Gen2 中有几个功能处于预览阶段:
- 目标查询的高级编辑 直接从创作环境本身调整目标端的逻辑。
- 分区计算这样一来,数据流的部分内容就可以并行运行,从而减少总的评估时间。
- 下载诊断程序 在执行层面,提供结构化的日志包,用于性能分析和事件解决。
- 公共API 用于以编程方式创建、更新、删除、调度和监控数据流。
- 支持 CI/CD 的公共参数它允许通过从管道或其他来源传递值来刷新数据流。
- 最新数据 以便在 Power Query 功能区和“现代获取数据”中快速访问最近使用的项目。
所有这些都得益于通过 REST 以编程方式评估 Power Query 的能力,这为在自动化流程中运行 M 脚本、将其与 Spark、管道或外部工具集成以及利用 Power Query 连接器打开了大门。
数据工厂:自适应性能、连接性和 dbt
在更“经典”的集成部分,Fabric 中的数据工厂引入了:
- 自适应性能调优 对于复制活动,它会根据配置和执行上下文智能地调整性能参数。
- 复制作业中的变更数据捕获 (CDC) 支持仅持续复制更改(插入、更新、删除)。
- 具有手动升级选项的本地网关 可通过 Fabric 门户、API 或脚本进行管理。
- 最近连接它会向连接添加最后使用属性,以方便审计和生命周期管理。
- 原生 dbt 作业这使得可以在 Fabric 中运行 dbt 项目,并集成编排、测试、文档和治理功能。
- 调用 SSIS 包活动 在管道中,从 Fabric 中的编排本身运行 SSIS 包。
SharePoint 站点选择器增强了用户体验,无需手动输入 URL,并且 MCP 对数据工厂的支持使 AI 助手能够根据自然语言指令轻松创建和部署 Dataflow Gen2。
数据迁移和复制工具
微软正通过多种专用工具大力推广向 Fabric 的迁移:
- 数据工厂的架构迁移评估它会分析 ADF 管道的准备情况,并将受支持的管道迁移到带有连接映射的 Fabric 工作区。
- 数据仓库迁移助手现在可以直接连接到源仓库,将其迁移到 Fabric 数据仓库。
- SQL数据库迁移助手旨在迁移本地 SQL Server 工作负载,通过 DACPAC 导入架构,检测不兼容性并提供建议。
关于复制,Fabric 支持从各种操作源(Azure Database for MySQL、Google BigQuery、SQL Server 等)镜像数据,并能够控制要复制的表、通过 REST 重启镜像进程,以及(对于 Databricks)将 Unity Catalog 策略映射到 OneLake 安全性。
此外,还包括来自 Lakehouse 的复制连接器,该连接器使用Delta Change Data Feed,可将 Lakehouse Delta 表中的更改公开到兼容的目标,而无需使用自制的 CDC 解决方案重新发明轮子。
Fabric 中的安全性、高级治理和监控
任何分析平台面临的最大挑战之一是如何保障数据安全、管理使用情况以及监控资源消耗。Fabric 在这些方面正迅速走向成熟。
OneLake 的安全和数据保护
OneLake 增加了一个完整的数据访问安全模型,包括:
- 通过基于文件夹的安全界面,为 Lakehouse 提供可配置权限的数据访问角色。
- 为快捷方式提供安全支持,以便第三方能够遵守已定义的策略。
- OneLake 数据访问安全 API,可实现自动化权限管理。
- 将模型扩展到外部引擎(OneLake 第三方安全授权)。
同时,DLP 扩展了对OneLake 中所有结构化数据(SQL、KQL、数据仓库)的访问限制,并为 Fabric Copilots 和数据代理引入了 AI 的 DSPM,该功能可监控 AI 交互中的敏感信息和风险行为,并与 Purview Audit 和 eDiscovery 集成。
在身份平面中,出现了诸如通过 REST API 实现的项目关联身份(例如 Lakehouse 和 Eventstream)等功能,从而消除了某些操作的所有者依赖性,并通过工作区或服务主体身份对 OneDrive 和 SharePoint 快捷方式进行身份验证。
集中式治理和 OneLake 目录
OneLake 目录中新增的集中式仪表板增强了数据治理体验,数据所有者可以在这里查看他们创建的项目的汇总视图,接收治理行动建议,并访问所有可用的工具来提高安全性和合规性。
此外,还启用了OneLake 目录搜索 API和 MCP 工具,允许通过代码或 AI 代理,在一次调用中发现整个 Fabric 环境中的项目,同时尊重目录权限和元数据。
监测产能、消耗和工作
织物提供了多层可观察性:
- 工作区监控它会在 Fabric 中创建一个数据库,用于整合来自多个项目的日志和指标(包括带有详细监控的复制作业)。
- 工作区监控复制作业指标包括吞吐量、数据量、错误代码和时间,所有这些都旨在进行集中分析。
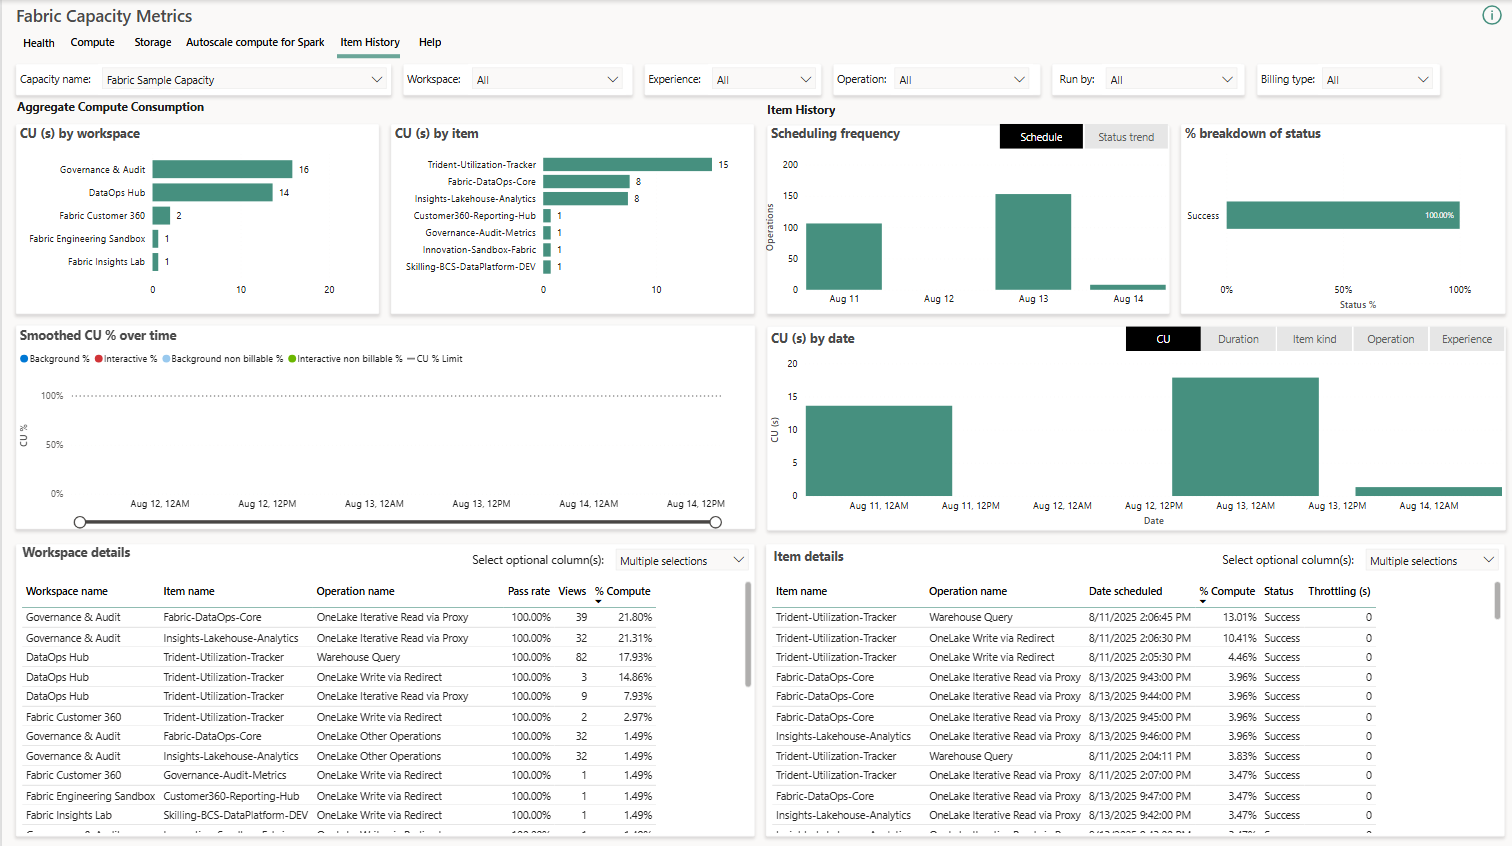
- 容量指标应用中的项目历史记录,提供每项商品 30 天的 CU 消耗量视图,可按工作区和类型进行筛选。
- 工作区级浪涌保护它允许在 24 小时滚动窗口中为每个工作区设置消耗阈值,自动阻止超过阈值的工作区,并将工作区标记为“关键任务”,以将其排除在限制之外。
与此同时,Fabric 管理 API的初始版本也已发布,其重点在于发现工作区、项目和用户访问详情,从而实现动态库存和定期访问控制。
业务建模、规划和新的工作量
除了技术层面,微软还在 Fabric 之上引入了面向业务的新型工作负载。其中最引人注目的是 Fabric IQ,它旨在统一业务语义、数据和模型,从而为智能代理提供基于组织整体视图进行决策的功能。
在 Fabric IQ 中,会显示以下内容:
- 本体(预览),这是一种根据公司业务语言定义实体、关系、属性和约束的项目类型。
- 计划(预览)一个用于规划、报告、分析、集成和协作管理的无代码平台。
在实时智能领域,数字孪生构建器也应运而生,它专门用于基于实时数据对数字孪生进行建模,目的是优化物理操作、监控状态和模拟场景。
另一方面, Fabric IQ 工作负载作为单独的工作负载引入,治理和语义对齐的支持工具不断扩展,从而在数据模型、业务逻辑和 AI/分析应用程序之间形成闭环。
性能、用户体验和生产力提升
最后,值得一提的是一系列跨领域的改进,这些改进虽然不常成为新闻头条,但却对团队的日常运作产生了重大影响。
在 Spark 和分布式计算部分,Fabric 引入了以下功能:
- Fabric Runtime 2.0(预览版) 采用 Apache Spark 4.0、Delta Lake 4.0、Java 21、Scala 2.13 和 Python 3.12,运行于 Azure Linux 3.0 上。
- Spark 应用比较工具它允许您并行选择和比较最多四个 Spark 执行。
- 火花诊断发射器它会从 Spark 应用程序收集日志、指标和事件,并将它们发送到 Event Hubs、存储或 Log Analytics 等目标位置。
- JobInsight 诊断库一个用于通过 API(查询、作业、阶段、任务、执行器、事件日志)分析已完成的 Spark 执行的库。
在仓库层,添加了数据聚类以提高性能并降低访问成本,添加了用于代理键的 IDENTITY 列,并通过 VS Code 中的 SQL 数据库项目(仓库源代码控制)实现了版本控制和 CI/CD 支持。
Fabric门户的用户体验也在不断改进,新增的标签式浏览和对象资源管理器使用户能够同时打开多个项目并快速切换。此外,诸如Git中的Lakehouse自动绑定以及用于Lakehouse维护(维护活动和SQL端点刷新)的一系列实用程序等改进,共同打造了一个更加用户友好且敏捷的平台。
最后,诸如批量导入/导出项目定义(用于迁移、模板和元数据备份)、文件夹的 REST、Activator 项目激活中的参数支持以及使用集成目录将 OneLake 数据加载到 Excel 等功能,完善了一个生态系统,开始涵盖现代数据团队几乎所有常见的需求。
凭借这套完整的功能——从集中式治理、细粒度安全控制和智能编排,到嵌入 SQL 的 AI、实时分析、数字孪生和 MCP 代理——Microsoft Fabric 正在将自身打造成为一个完整的数据平台。在这个平台上,关键不再仅仅是存储和可视化数据,而是治理、自动化数据,并利用 AI 来驱动数据生命周期的每个环节。这使得企业能够逐步演进其架构,迁移现有系统并启用新的解决方案,速度远超传统方法。