- VibeVoice 是微軟的 TTS 模型,能夠產生長時間、富有表現力的多說話者音頻,非常適合播客和有聲讀物。
- 它的架構結合了語音分詞器、大型語言模型和擴散技術,即使在長達 90 分鐘的錄音中也能實現自然的聲音。
- 它能夠實現近乎即時的回應,並略有變化,但由於語音克隆和深度偽造的風險,因此需要負責任地使用。
- 它已作為開源研究框架發布,但微軟由於擔心濫用而暫時限制了該儲存庫。
微軟VibeVoice的問世正在徹底改變利用人工智慧製作播客和長音訊內容的方式。這款開源的文字轉語音(TTS)模型不僅能產生高度逼真的語音,還能製作長達90分鐘的多對話內容,而不會出現突兀的剪輯或音質下降。
VibeVoice 的目標是為任何人提供一個虛擬錄音棚,讓他們能夠透過電腦專業地製作播客、有聲書或旁白。您只需要一份腳本和一些基本的技術知識來設定模型,剩下的工作就交給人工智慧來完成:語調、自然度、聲音變化以及音訊的連貫性。
VibeVoice是什麼?為什麼它對播客如此重要?
該模型基於文字轉語音(TTS)技術,這意味著它可以直接將文字轉換為語音,但其流暢度和細微差別都非常接近人類語音。 VibeVoice 最初發佈時包含1.5 億和 7 億個參數的版本,旨在平衡音質和產生長音訊串流的能力,同時避免過度消耗資源。
它最大的優勢之一是能夠連續錄製長達90分鐘的音頻,並始終保持聲音的一致性和語調。這使得它特別適用於完整的播客、有聲讀物章節或篇幅較長的教育內容,而以往這些都需要多次與真人配音演員進行錄音。
此外,VibeVoice 旨在處理單次音訊錄製中多達四種不同的聲音,從而實現模擬採訪、小組討論、角色對話或由不同配音演員旁白的劇集。這種多說話人功能是使人工智慧驅動的播客更具活力和吸引力的關鍵。
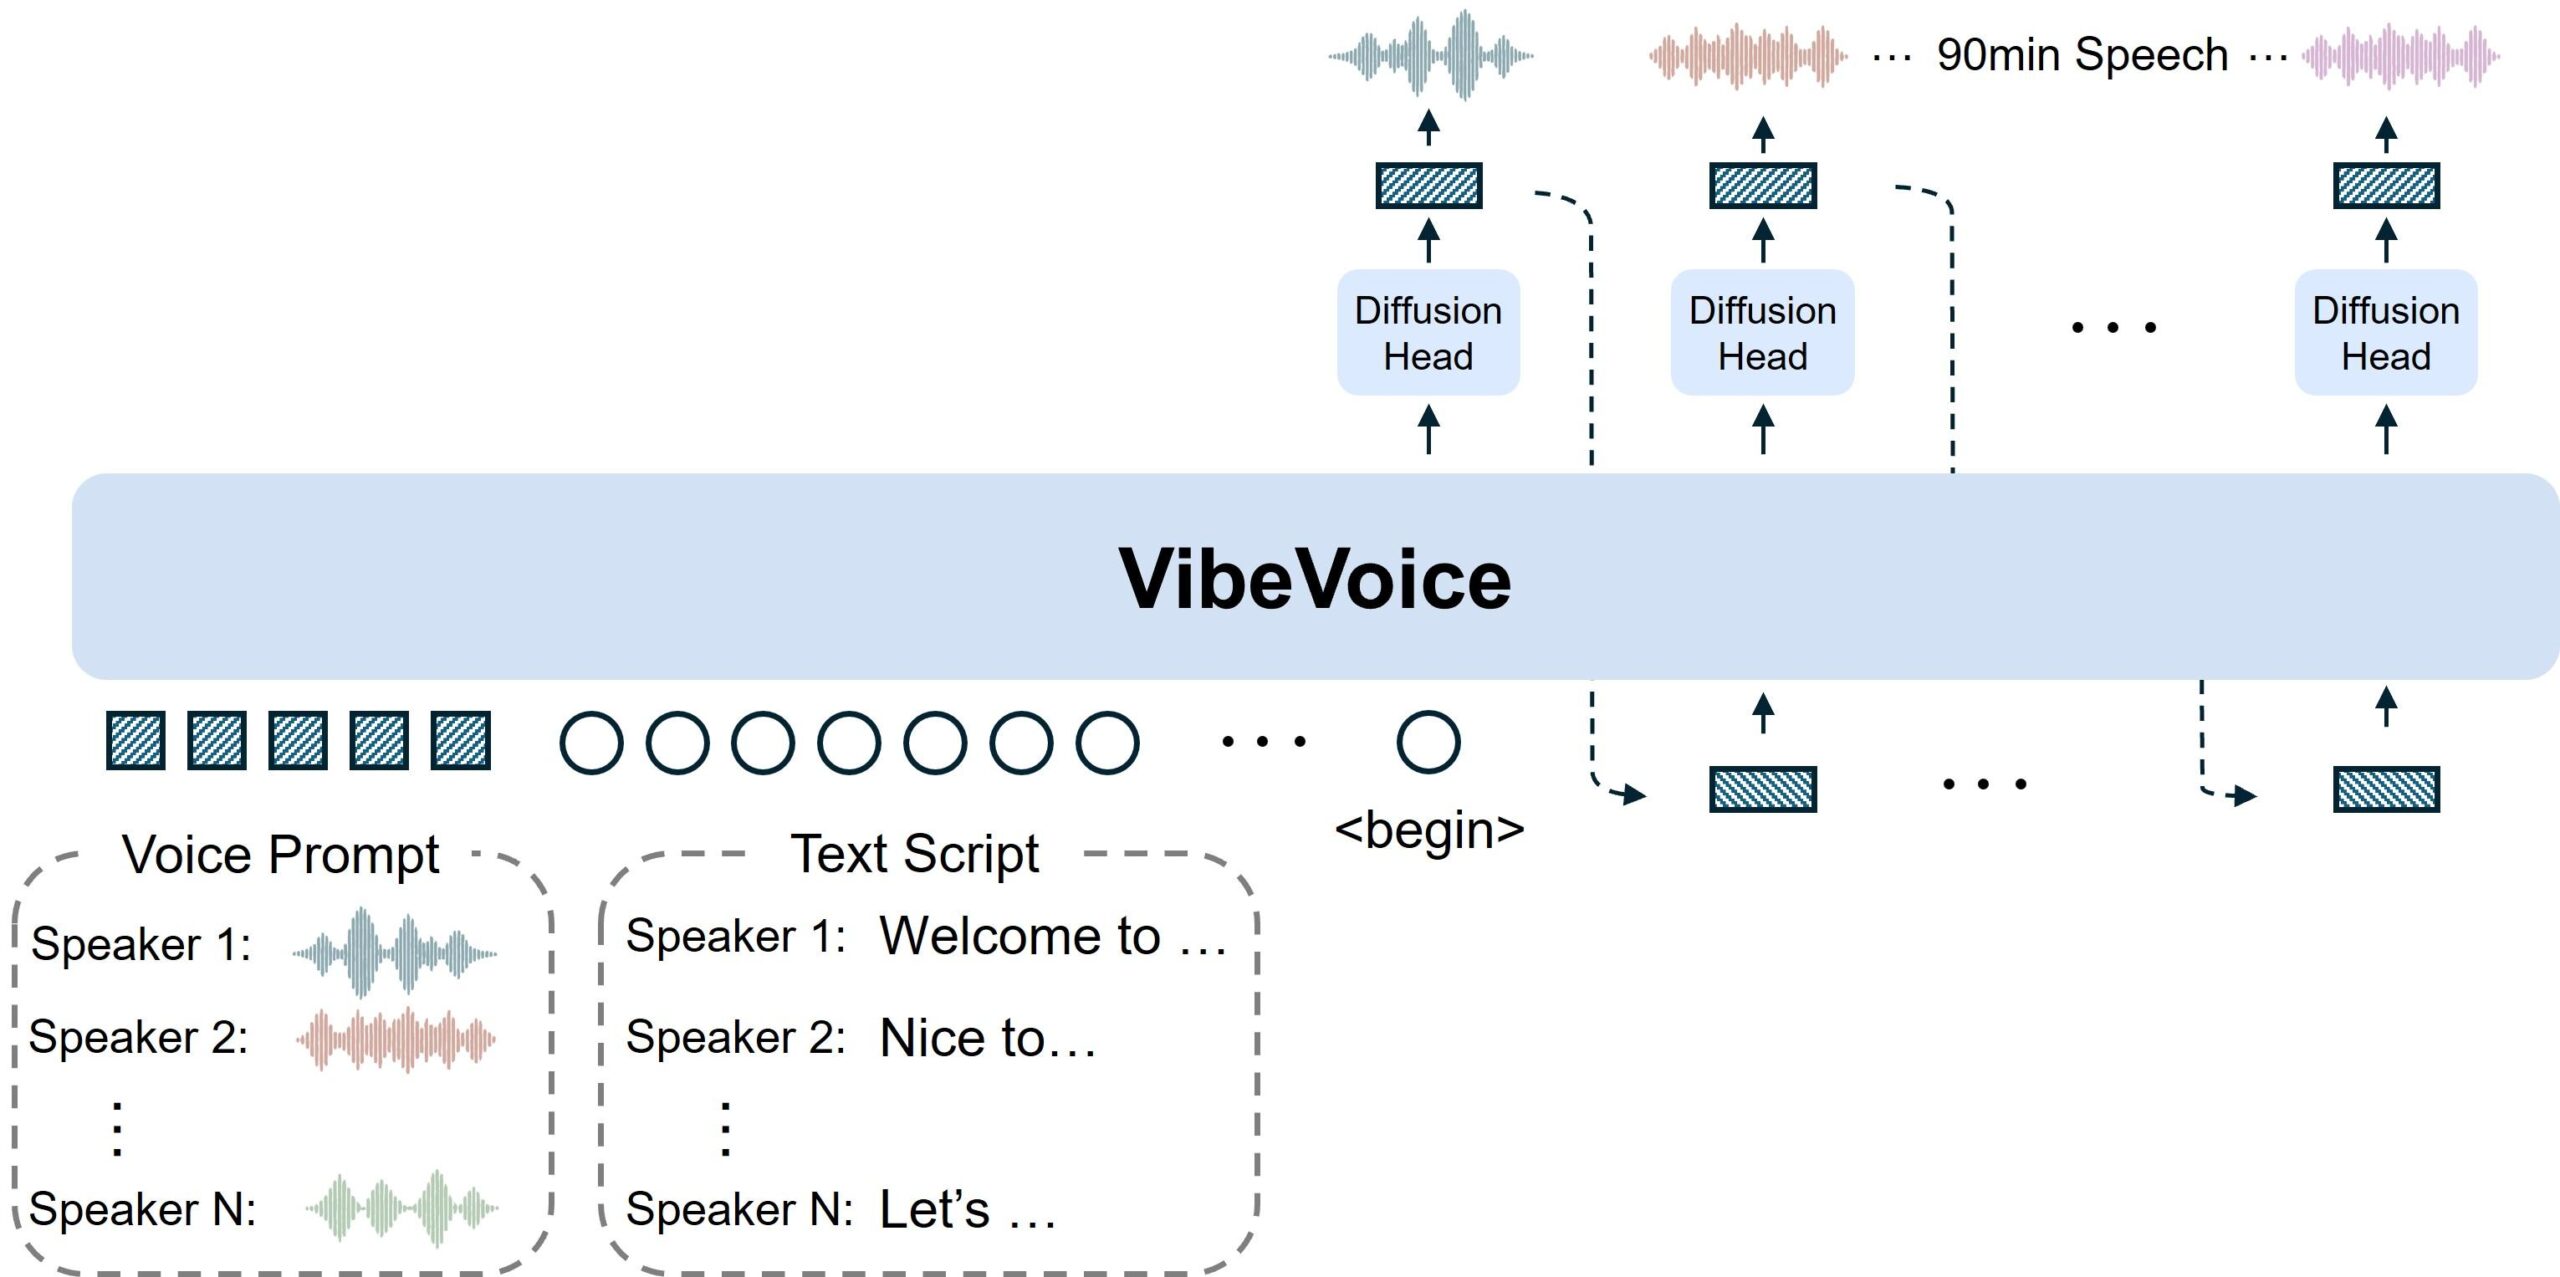
VibeVoice 的工作原理:先進的語音合成技術和低延遲
除了引人注目的標題之外,VibeVoice 的獨特之處在於其專為長時間錄音和對話而設計的技術架構。微軟整合了多個組件,使語音聽起來自然流暢,能夠根據文字內容進行自適應調整,並實現近乎即時的生成。
該系統採用連續聲學和語義語音分詞器,工作頻率非常低,約 7,5 Hz。這意味著與其他模型相比,它每秒將音訊資訊壓縮成更少的“步”,在處理長序列時,既能保持聲音保真度,又能顯著降低計算成本。
在這種壓縮表示的基礎上,還會引入一個大型語言模型(LLM) ,它負責解讀腳本內容、對話流程以及當前說話者的身份。這樣,它就能理解對話是提問、回答、諷刺評論還是話題轉換,並據此調整語音輸出。
最後,使用擴散頭來重建高品質的聲學細節:音色、人聲質感、細微的呼吸聲以及其他細微差別。這種 LLM 與擴散頭的組合確保了最終音訊的一致性、表現力,並且長時間聆聽也令人愉悅。
同時,微軟也推出了一款名為VibeVoice-Realtime-0.5B的特定版本,專為極速響應而設計:該型號可在接收到文字後約300 毫秒內開始發聲。也就是說,幾乎可以實現即時回應,非常適合語音代理、對話助理或對延遲要求極低的應用。
可用版本:模型、參數和建議用途
在 VibeVoice 生態系統中,已經推出了幾個不同型號尺寸和方向的版本,專為長時間音訊和互動式應用而設計。
一方面,我們有參數量分別為 1.5 億和 7 億的主要版本,旨在處理諸如完整播客、模擬廣播節目、有聲讀物章節或音頻課程等大型內容。參數量越多,捕捉細微差別和處理複雜對話的能力就越強,但同時也增加了對硬體的要求。
另一方面,VibeVoice-Realtime-0.5B 版本優先考慮響應速度而非模型大小。雖然它「僅」有0,5 億個參數,與 ChatGPT 或 Gemini 等大型模型相比數量不多,但這恰恰使其能夠在保持清晰語音和穩定語調的同時,產生長達 90 分鐘的連續音頻。
這種即時版本對語音代理、聊天機器人、虛擬助理以及任何用戶希望人工智慧立即以語音而非文字形式回應的應用都極具吸引力。延遲接近 300 毫秒,使用者體驗與面對面交談非常相似。
在所有情況下,該模型都旨在用於本地或研究環境,因為微軟最初決定將其作為開源專案發布,可透過 GitHub 和 Hugging Face 等平台訪問,從而使社區能夠輕鬆地對其進行測試、調整和在其基礎上構建工具。
實際應用:如何使用 VibeVoice 建立播客
VibeVoice 的旗艦應用之一無疑是無需真人配音即可創建播客。對於任何有創意、劇本或文字內容,但又不敢面對麥克風的人來說,這種模式提供了巨大的機會。
使用 VibeVoice 製作播客的一般工作流程通常包括準備一份結構清晰的腳本:引言、內容模組、可能的採訪(真實或虛構)、過渡和結尾。文字越清晰,模型就越能捕捉語氣、停頓以及對話中每個「人物」角色的變化。
然後,利用基於該模型建立的工具(腳本、圖形介面或與其他應用程式的整合),將文字的每個部分分配給一個可用的說話者。例如,我們可以用一個聲音代表主持人,另一個代表常駐嘉賓,一個代表朗讀觀眾提問,第四個代表訊息提示或贊助內容。
該模型能夠產生連續音頻,同時保持腳本順序、語音過渡和對話節奏。之後,可以使用傳統的音訊編輯器對結果進行精細化處理,例如添加背景音樂、音效、轉場效果,或對音量和均衡進行微調。
由於能夠一次生成長達 90 分鐘的內容而不會失去連貫性,我們可以一次製作出一整集節目:無需分段錄製,也無需擔心聲音疲勞、發音錯誤或背景噪音,而這些在實體錄音棚中卻是一個持續的難題。
人工智慧語音克隆與語音個性化
這項技術中最精妙也最強大的進步之一是「語音克隆」或人工智慧語音克隆。它利用基於深度學習的合成技術,可以複製特定聲音的音色、語調和細微差別。
實際上,這些系統會分析目標語音的獨特特徵,例如音色、共振峰、語速和韻律模式(停頓、重音、疑問語調等)。只需幾秒鐘的樣本,它們就能產生與原始語音高度相似的合成語音。
以 VibeVoice 為例,據稱只需 10 秒的原始音訊即可實現非常精準的模擬,能夠很好地捕捉聲音的情感衝擊力和質感。對於播客而言,這帶來了許多可能性,例如即使真人停止錄音也能保持“品牌聲音”,或者創建具有一致聲音特徵的常駐角色。
然而,這種能力也帶來了非常嚴重的倫理風險,並且需要對合成音訊進行檢測:
因此,微軟強調VibeVoice是在研究框架內發布的,並附有明確的警告:它不應用於身分盜竊、詐欺、操縱或虛假資訊傳播活動。負責任的使用是整個生態系統的關鍵組成部分。
對內容創作者和小型專案而言的優勢
只要擁有一台能夠運行該模型的電腦,再加上一些編寫腳本的時間,就可以在幾分鐘內將長篇文字轉換成專業的音訊。這適用於資訊類播客、新聞簡報、虛構故事、連載小說,甚至是配有旁白的科技手冊。
它還能極大地幫助回收現有的書面內容:部落格文章、新聞通訊、社交媒體貼文或報告可以轉換為音訊節目,從而擴大資訊的傳播範圍,並為那些喜歡聽而不是閱讀的人提供更方便的方式。
另一個優點是音質的長期穩定性。雖然人類配音演員的活力、語調或清晰度會因人而異,但人工智慧能夠保持穩定的音質,這有利於連續劇的製作:一次錄製的多集節目都能保持相同的聲音狀態和風格。
在教育領域,VibeVoice 非常適合用於音訊課程、導讀以及視障人士或喜歡邊聽邊做其他事情學習的人士的無障礙材料。它能夠產生課程或長篇文件的語音版本,提供了豐富的可能性。
風險、限制以及微軟關於儲存庫的決定
另一方面,能夠模仿人聲並產生逼真語音的人工智慧引發了嚴重的倫理和安全問題。惡意使用的風險真實存在,大型科技公司也日益意識到這一點。
在發布文本中,微軟明確指出VibeVoice不應用於深度偽造、身分盜竊或非法活動。微軟也直接禁止將其用於散佈虛假資訊或進行欺詐,正是因為其逼真的音效很容易欺騙毫無戒心的聽眾。
儘管該模型生成的聲音非常逼真,但其開發者指出,它仍然無法捕捉到真人聲音的所有細微之處:呼吸聲、情緒的細微變化、某些自然的停頓以及節奏的變化,這些在真人身上仍然比人工智慧表現得更加豐富。這種「缺陷」在某種程度上可以幫助我們辨識合成語音,但真假語音之間的界線越來越模糊。
在將該專案作為開源研究框架發布後,微軟發現該模型被用於一些不符合其最初意圖和負責任使用原則的方式。為此,該公司宣布已被迫暫時關閉該程式碼庫,直至確保此類超出範圍的使用不再發生。
該聲明強調,負責任地使用人工智慧是微軟的核心原則,他們寧願暫停並審查可能助長嚴重濫用的工具,而不是繼續維護它。即便如此,相關的文件、演示和技術資料已經激勵了社區,並持續推動語音合成領域的發展。
除了播客之外的其他應用
儘管媒體的焦點主要集中在播客領域,但VibeVoice在人工智慧音訊生成領域開闢了相當廣泛的應用場景。其中許多應用也適用於數位內容和自動化策略。
最明顯的例子之一就是有聲書和旁白故事,在這些作品中,擁有能夠吸引聽眾數十分鐘的富有表現力的聲音至關重要。多聲部配音功能可以讓每個角色擁有自己的聲音,與單一旁白相比,大大提升了聆聽體驗。
在語音代理和對話助理領域,VibeVoice 的即時版本堪稱理想之選。響應延遲僅為 300 毫秒的機器人比需要幾秒鐘才能說話的機器人感覺自然得多,這使得與客服、聊天機器人或語音介面的互動更加流暢。
另一個非常有趣的領域是自動化內容:新聞摘要、市場動態、定期報告,甚至電子郵件閱讀和通知都可以在無需人工幹預的情況下生成,從而保持與品牌形像一致的語氣。
最後,還有一些更具實驗性的應用,例如創作虛構對話、模擬訪談或完全由人工智慧製作的娛樂節目。在這些應用中,用於劇本創作的語言模型與用於配音的VibeVoice相結合,產生了以前還被認為是科幻小說裡才會出現的形式。
從整體來看,VibeVoice 是新一代人工智慧音訊技術中的關鍵參與者,它能夠將自然語音、多人對話、超長音訊片段和近乎即時的回應完美結合。如果使用得當,並遵守既定的倫理規範,它將成為任何希望創建或擴展播客、製作有聲讀物或為其數位專案添加專業配音,而無需總是依賴傳統錄音室的人的強大工具。
