- VIF 偵測迴歸模型中的多重共線性,以避免係數失真。
- 當模型包含具有多個層級的分類變數時,可以使用 GVIF。
- 技術實作可以基於 C# 函式庫,也可以透過整合專門的 R 套件來實現。
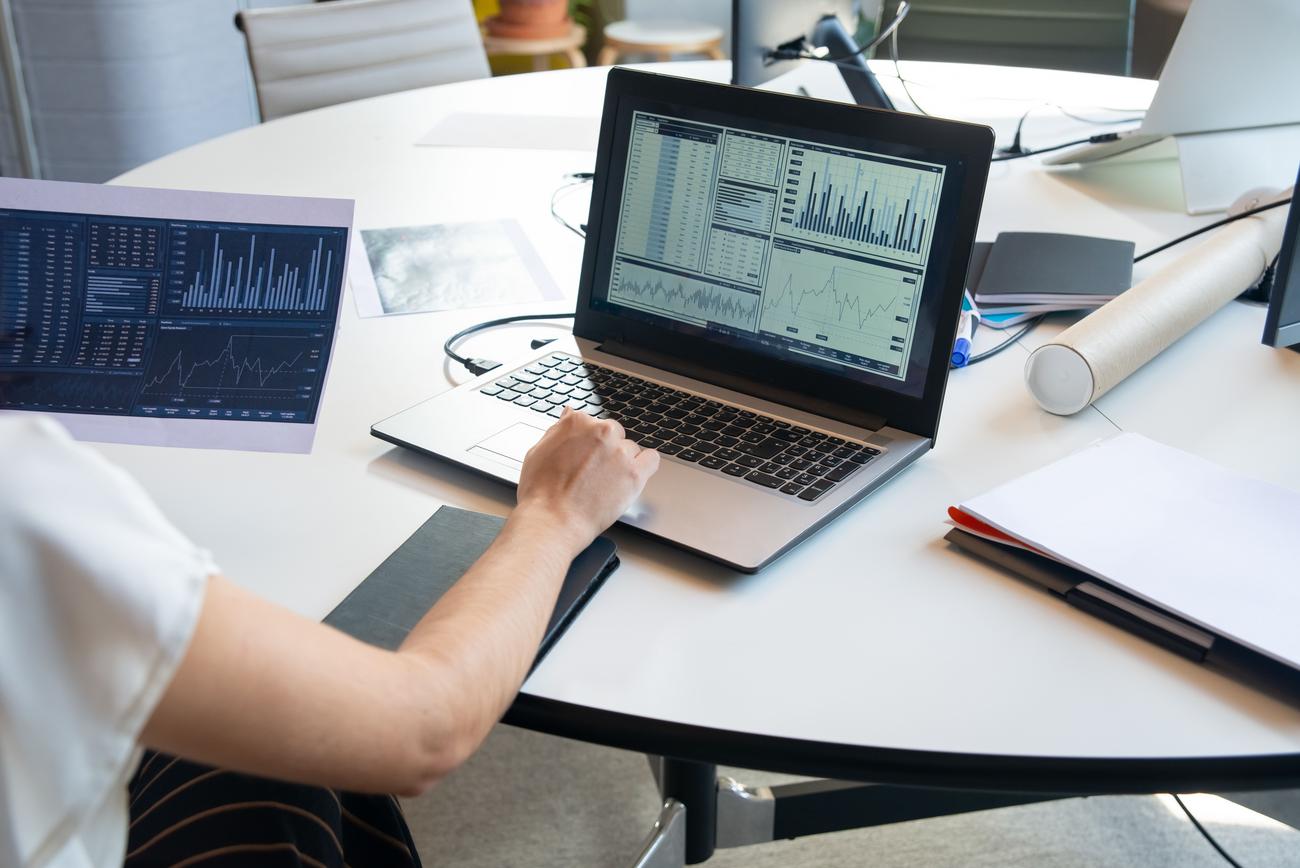
如果你正在學習數據分析和統計學,你可能已經接觸過多重共線性這個概念。簡單來說,當迴歸模型中的兩個或多個自變數之間的關聯過於密切時,就會發生多重共線性,導致系統無法確定哪個變數才是真正運作的因素,最終扭曲你的預測結果。
為了釐清這個混亂局面,變異數膨脹因子(簡稱 VIF)就派上了用場。這個指標可以幫助我們判斷一個變數是否冗餘,以及它是否會膨脹估計係數的變異數。簡單來說,它能告訴我們數據之間是否有重疊。
VIF究竟是什麼?它是如何運作的?
變異數膨脹因子 (VIF) 是一種診斷工具,用於衡量迴歸係數的變異數因模型中其他變數的相關性而增加的程度。從技術上講,它是通過執行線性回歸計算得出的,其中一個自變量作為因變量,與其他自變量進行比較。如果結果為 1,則表示不存在相關性;如果大於 10,通常表示有嚴重的共線性問題,則需要加以解決。
當處理具有兩個以上類別的分類變數時,標準的變異數膨脹因子(VIF)就顯得不足,我們必須改用廣義變異數膨脹因子(GVIF )。為了確保計算的一致性,這種調整至關重要。 GVIF 的標準化公式通常為:GVIF 的 1 次方除以自由度的兩倍。
實施和進階工具
儘管數學計算是通用的,但現有的數據分析工具可以自動完成此過程。例如,在 AlteryxOne(2025.1 及更高版本)等環境中,社區庫中提供了一個專門的 VIF 工具。該工具可以產生除截距之外的任何變數的詳細係數總計報告,因為截距的值始終為 1。
- 模型支援: 它可以應用於線性迴歸、邏輯迴歸、計數迴歸和伽瑪迴歸。
- 對 R 的依賴: 這些實作中有很多都使用了開源的 R 例程,特別是該軟體包。
vif處理數據。 - 技術限制: 值得注意的是,某些方法(例如 Revo ScaleR)不會儲存計算這些因素所需的信息,因此與這些巨集不相容。
在 C# 和其他程式語言中計算 VIF
要在 C# 中實作此功能,由於基礎語言本身沒有原生函數,因此我們必須依賴像 Math.NET Numerics 這樣的線性代數函式庫。該過程涉及建立相關矩陣並計算其逆矩陣,或對每個自變數執行輔助迴歸。
在 C# 中,邏輯流程如下:首先,分離每個預測變數;然後,將其作為線性迴歸的目標變量,與其他預測變數進行迴歸分析;接著,計算決定係數 R²;最後,應用公式 1 / (1 – R²)。如果程式設計師需要更健壯的實現,理想的解決方案是整合呼叫Python 進行資料分析或 R 腳本的封裝器,因為這些語言在矩陣處理和共線性驗證方面更加成熟。
嚴格控制 VIF 可以讓你透過消除冗餘變數來清理模型,這不僅可以提高準確性,還可以使模型更具可解釋性和計算效率,防止統計雜訊掩蓋資料之間的真實關係。
