- 開放取用模型和數據,使中小企業和非技術人員能夠開發具有競爭力的 AI 解決方案。
- 實現技術創造者多元化對於緩解演算法偏見和改善社會公平至關重要。
- 生成式人工智慧的部署能夠促進工作場所生產力和創造力的提升。
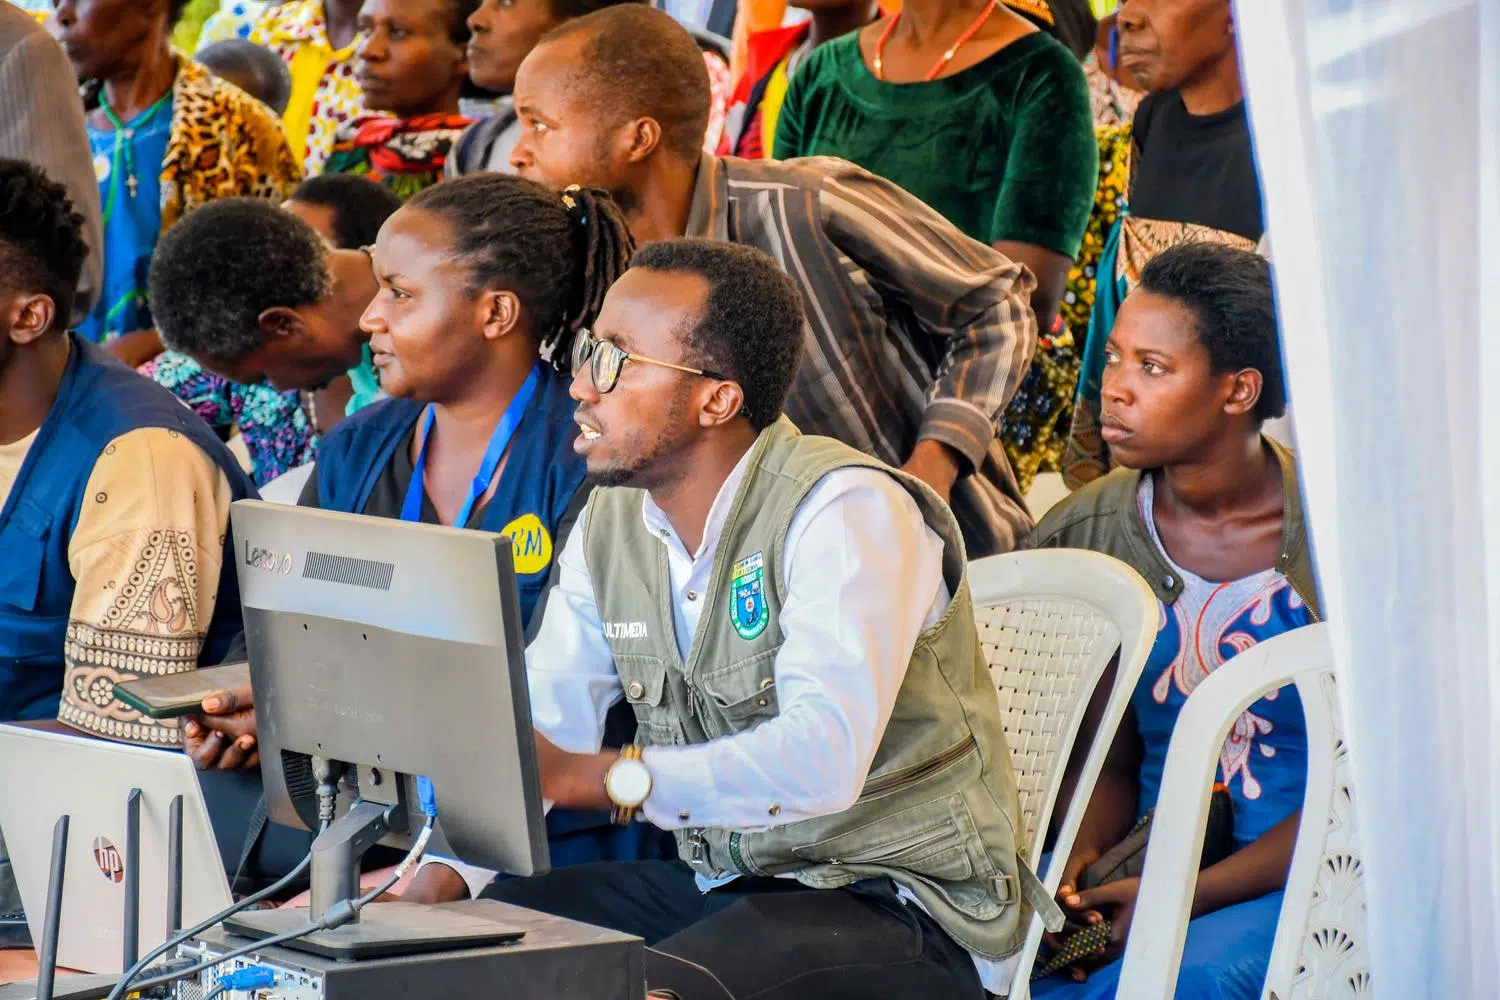
當我們談到人工智慧民主化時,我們指的並非投票制度,而是指開放開發大門,使其不再是少數人的專屬領域。本質上,這意味著要確保創建和使用這些工具的能力不再局限於大型科技公司的伺服器,而是惠及所有擁有好想法的人,無論其編程技能如何,甚至允許用戶無需創建帳戶即可使用人工智慧,從而消除准入門檻。
這項舉措至關重要,因為如果我們只允許少數人掌控方向,就有可能造成難以逾越的數位落差。透過普及技術,我們可以讓創新在各個意想不到的地方蓬勃發展,使人工智慧成為包容性進步的引擎,而不是少數特權階級的控制工具。

人工智慧民主化的真正意義是什麼?
這個概念包含多個層面。一方面是技術層面:為研究人員和資料科學家提供價格合理甚至免費的運算資源,消除目前只有大型科技公司才能輕鬆克服的經濟障礙。但更深層的意義在於:讓非技術使用者也能參與其中。這需要創建介面和工具,使不了解複雜演算法的人也能設計自己的人工智慧應用程式。
這種現象與企業資料民主化的過程非常相似,任何員工,無論其背景如何,現在都可以利用數據科學做出基於證據的決策,而不僅僅依賴直覺。本質上,這是一種從「專家閉關鎖國」模式轉向開放參與式共創模式的轉變。
開放資料和開源的關鍵作用
人工智慧要普及應用,就需要數據作為燃料。這正是開放資料倡議的意義所在,例如歐盟推廣的 data.europa.eu 等入口網站。當數據公開透明時,各組織無需投入數百萬美元從零開始收集信息,即可構建創新解決方案,從而促進數位經濟發展,並確保技術帶來的益處得到更公平的分配。

AI4EU計畫就是一個絕佳的例子,它創建了一個協作生態系統,旨在改進從醫療診斷到智慧製造等各個領域的技術。此外,開源模型的興起也功不可沒,例如Meta的Llama和Google的Gemma。這些工具允許任何開發者根據自身需求客製化AI,從而促進了一種無需依賴昂貴專有許可的快速實驗文化。
對工作世界和生成式人工智慧的影響
生成式人工智慧是這場變革的真正催化劑。它透過自然語言實現簡單的交互,使這項技術變得極其用戶友好。使用者不再需要編寫複雜的程式碼,只需知道如何提出需求即可。這正在改變整個行業:在法律領域,海量文件可在幾秒鐘內處理完畢;在醫療保健領域,診斷得以優化,前提是人工智慧是作為醫生的輔助工具而非替代品。
- 個人協助: 議程管理和快速文字寫作。
- 個人化教育: 為學生簡化複雜概念。
- 自動化支援: 針對企業常見問題提供即時解答。
- 生產力提高: 消除重複性工作,專注於創造力。
許多人擔心這將意味著他們工作的終結,但較為樂觀的觀點認為,正如工業革命時期一樣,我們只是提高了抽象層次。透過將日常任務委託給機器,人類可以專注於更具策略性和以人為本的工作,從而獲得更多知識,並提升專業能力。
倫理、偏見與反壟斷鬥爭
最關鍵的問題之一是消除人工智慧偏見。當技術始終由同一群體開發時,社會偏見就會滲透到演算法中,使弱勢群體處於不利地位。透過科技開發的民主化,我們可以納入多元化的視角,進而建構更公平、更公正的系統。防止技術助長歧視,關乎社會的存亡。
此外,開放市場可以防止市場形成寡占。如果中小企業能夠獲得強大的工具,它們就能與大型企業公平競爭。這不僅能促進經濟發展,也能使倫理問題成為核心議題,因為人工智慧的廣泛應用需要更嚴格的集體監管。
一路上的挑戰和風險
並非一切都盡如人意。資料的完全開放與隱私權直接衝突。雖然歐洲有《一般資料保護規範》(GDPR),但其他國家的法律法規卻各自為政,這使得全球監管標準制定變得複雜。開放資料要真正發揮作用,就必須切實保障隱私不會被出賣給出價最高的人;資料是燃料,但它不能踐踏個人自由,並且需要妥善管理資料安全。
另一方面,這些工具的普及也帶來了切實的風險,例如網路攻擊手段日益複雜,或人工智慧被用於製造虛假資訊和從事非法活動。如何在人人享有知識獲取權和防止這種獲取權被濫用以打開本應關閉的大門之間找到平衡,尤其是在數位時代網路安全風險日益嚴峻的背景下,是一項需要謹慎權衡的工作。
人工智慧普及化正在改變社會的各個層面,確保創造力和效率不再取決於公司預算規模。透過整合開放資料、協作模式以及消除偏見的倫理理念,我們正在建立一個創新能力不再是特權而是權利的未來,使科技真正能夠改善每個人的生活品質。