- LiteRT 取代 TensorFlow Lite,成為Google用於在行動裝置、桌面裝置和物聯網裝置上運行 AI 的通用框架。
- 它利用 NPU、GPU 和 CPU 最佳化推理,與傳統 CPU 相比,速度提升高達 100 倍。
- LiteRT-LM 專門用於協調 LLM 和 Gemma 等生成模型,從而改善記憶體管理和本地上下文。
- 它與 PyTorch、JAX 和 TensorFlow 完全相容,可輕鬆將模型轉換為 .tflite 格式。
生成式人工智慧正在取得令人矚目的飛躍,它不再只是將資料發送到雲端並等待回應。如今,最精妙之處在於所有操作都直接在設備(無論是行動裝置還是邊緣運算環境)上運行,從而實現即時體驗,更重要的是,確保資料隱私不再依賴外部伺服器。
在此背景下,LiteRT應運而生。這是Google推出的全新標準,旨在取代老牌的TensorFlow Lite。它並非簡單的補丁,而是通用基礎架構,旨在讓開發者能夠在從智慧手錶到Windows PC的任何平台上部署強大的AI模型,從而最大限度地利用現有硬體。

LiteRT是什麼?它為何能改變遊戲規則?
LiteRT本質上是TensorFlow Lite的繼任者,旨在解決硬體碎片化帶來的挑戰。傳統的機器學習著重於影像辨識等簡單任務,而GenAI則需要更有效率的資源管理。無論設備是Android、iOS、macOS、Linux,甚至是Web應用程序,該框架都能實現可複現且高效的推理。
對於那些創建新創公司或開發技術產品的人來說,這完全是一種範式轉移。透過在本地運行模型,延遲大幅降低,並消除了重複的第三方 API 費用,使應用程式即使在沒有網路連線的情況下也能完美運作。
加速引擎:CPU、GPU 與 NPU 的效能

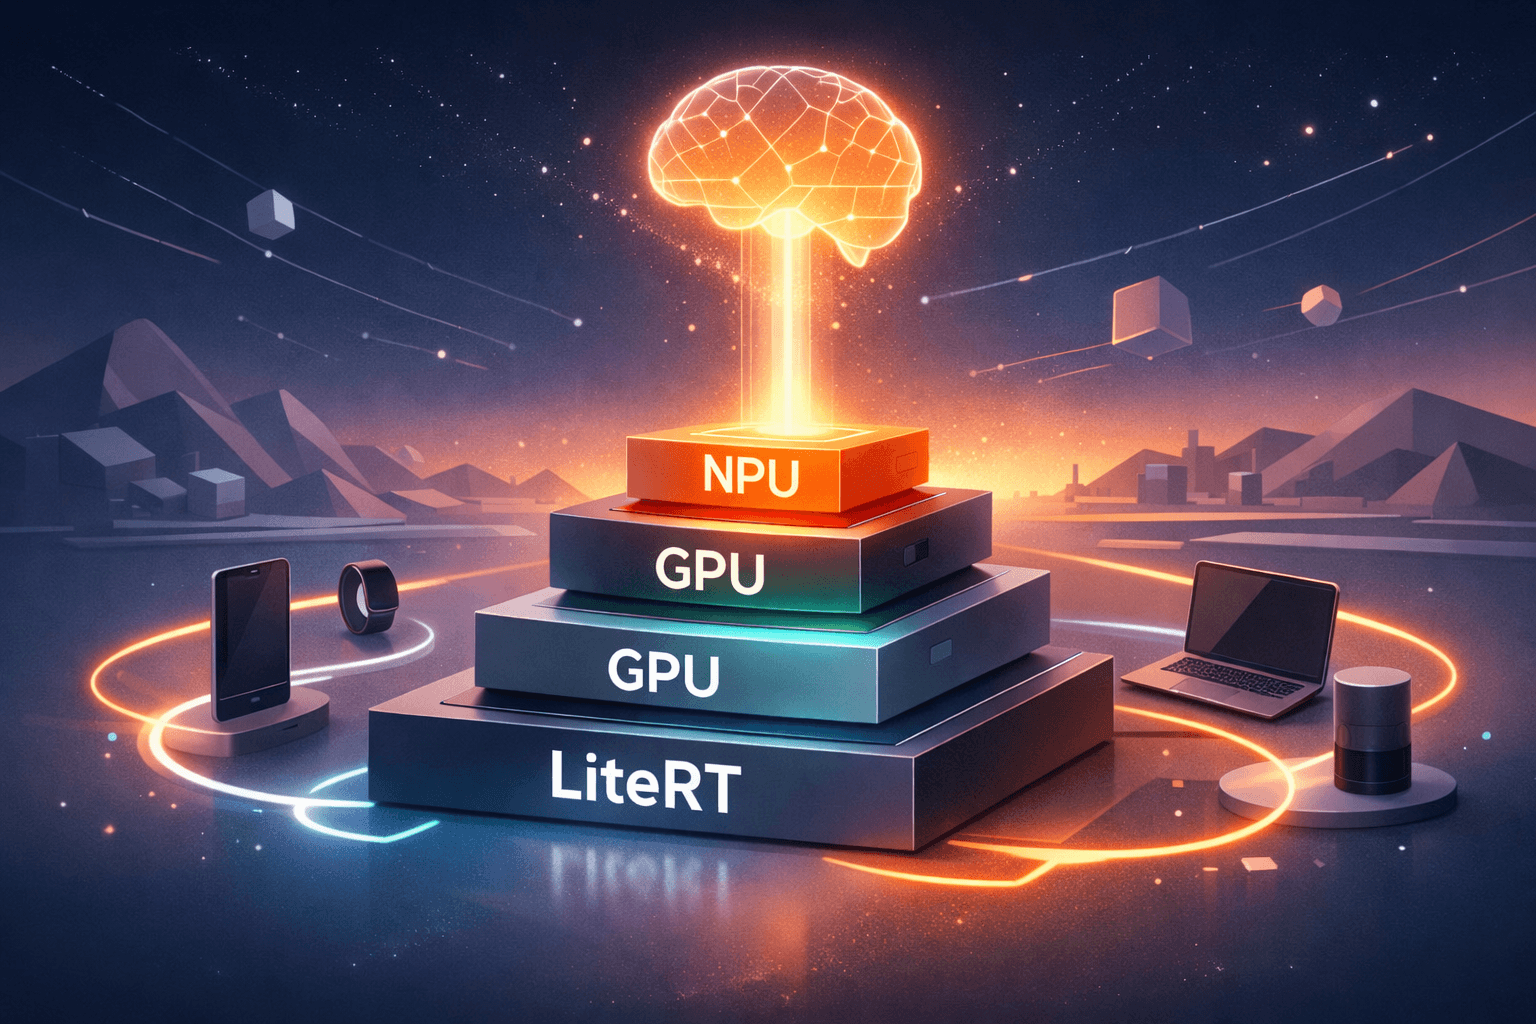
LiteRT 的真正優勢在於它能夠榨乾每顆晶片的每一個效能。由於名為ML Drift的引擎,該系統可以利用 Metal、OpenCL、OpenGL 和 WebGPU 等多種 API 來管理 GPU 加速。事實上,在 Android 平台上,運行時環境足夠智能,能夠自動優先使用 OpenCL(如果可用),僅在必要時才使用 OpenGL。
但LiteRT真正的亮點在於其NPU(神經處理單元)。由於與高通的合作,QNN加速器在某些情況下能夠達到比CPU快100倍、比GPU快10倍的速度提升。這使得人工智慧從緩慢的實驗階段轉變為切實可行的生產工具。
LiteRT-LM:協調生成式人工智慧和LLM
當我們討論大型語言模型(LLM)時,情況就變得複雜了,因為它們並非簡單的模型,而是複雜的管道。 LiteRT -LM正是為此而生,它是一個專門的編排層,能夠有效率地管理記憶體、緩衝區和上下文。這項技術也為 Pixel Watch和 Chrome 上的 Gemini Nano 提供支援。

為了方便程式設計師,Google整合了 LiteRT Torch 生成式 API。該工具可以輕鬆轉換基於 PyTorch 的模型,使Gemma等開源模型能夠在裝置上超高速運作。在實際基準測試中,LiteRT透過更好地利用硬件,在預填充和解碼速度方面都優於 llama.cpp 。
技術創新:零拷貝和非同步執行
在行動人工智慧領域常見的瓶頸之一是CPU和加速器之間的資料傳輸。 LiteRT透過零拷貝緩衝區管理解決了這個問題,避免了記憶體中不必要的資料重複。這相當於模型直接從資料所在位置讀取訊息,使得背景分割等任務的速度提升高達兩倍。
此外,新的CompiledModel API支援非同步啟動推理。這意味著在 AI 處理資料時,應用程式不會卡頓,從而提升了使用者介面的流暢度。系統能夠即時評估硬體並選擇最佳加速器,而無需開發人員為每個晶片編寫特定的程式碼。
框架靈活性和戰略部署
最棒的是,它並不會強迫你只使用一種語言。 LiteRT 相容於PyTorch、JAX 和 TensorFlow 。如果你已經搭建好了訓練流程,也不必放棄;你可以將模型轉換為.tflite格式,並部署到任何受支援的作業系統上。
對於企業而言,實施這項技術需要清晰的策略。僅靠模型本身是不夠的;它必須與客製化軟體開發和雲端運算基礎設施相結合,以便在需要時擴展人工智慧。此外,當人工智慧部署到設備端時,網路安全變得至關重要,因為必須確保敏感資訊永遠不會離開用戶的硬體。
採用此標準可以創建即時回應的自主代理,從而減少對昂貴伺服器的依賴。與那些繼續完全依賴雲端服務的組織相比,如今整合本地推理的組織將在成本、隱私和反應速度方面獲得顯著的競爭優勢。
